

As nuvens são como uma caixa mágica — você define o que precisa e os recursos simplesmente aparecem do nada. Máquinas virtuais, bancos de dados, redes — tudo isso pertence apenas a você. Existem outros inquilinos na nuvem, mas em seu próprio universo, você é o governante absoluto. Você tem certeza de que sempre receberá os recursos necessários, não precisa considerar ninguém e define sozinho como será a rede. Como funciona essa mágica que faz a nuvem alocar recursos de forma elástica e isolar completamente os inquilinos uns dos outros?
A nuvem AWS é um sistema mega-super complexo que vem evoluindo desde 2006. Parte dessa evolução foi testemunhada Vasily Pantyukhin — por Vasily, arquiteto da Amazon Web Services. Como arquiteto, ele vê não apenas o resultado final, mas também as complexidades que a AWS enfrenta. Quanto mais se entende como o sistema funciona, mais confiança se tem. Portanto, Vasily compartilhará os segredos dos serviços de nuvem da AWS. Abaixo, explicamos a estrutura dos servidores físicos da AWS, a escalabilidade elástica de bancos de dados, o banco de dados customizado da Amazon e métodos para melhorar o desempenho das máquinas virtuais, ao mesmo tempo que reduz seus custos. Conhecer as abordagens arquitetônicas da Amazon ajudará a usar os serviços da AWS de forma mais eficaz e, possivelmente, fornecerá novas ideias para a construção de suas próprias soluções.
Sobre o palestrante: Vasily Pantyukhin () começou como administrador Unix em empresas .ru, trabalhou por 6 anos com grandes equipamentos da Sun Microsystems e pregou a centralidade de dados no mundo por 11 anos na EMC. Evoluiu naturalmente para nuvens privadas e, em 2017, entrou no mercado de nuvens públicas. Agora, ele oferece conselhos técnicos para viver e desenvolver na nuvem AWS.
Aviso: tudo que segue é uma opinião pessoal de Vasily e pode não refletir a posição da Amazon Web Services. da palestra, na qual este artigo foi baseado, está disponível em nosso canal no YouTube.
Por que estou falando sobre a estrutura da Amazon
Meu primeiro carro tinha 'câmbio manual' — com transmissão manual. Era incrível por causa da sensação de que eu podia controlar o carro e tinha total domínio sobre ele. Também gostava de saber, pelo menos de forma aproximada, como ele funcionava. Naturalmente, eu tinha uma visão bastante primitiva do funcionamento da caixa de câmbio — mais ou menos como uma caixa de marchas de bicicleta.
Tudo foi incrível, exceto por uma coisa — ficar preso no trânsito. Parece que você está sentado e não fazendo nada, mas está constantemente trocando as marchas, pisando na embreagem, no acelerador, no freio — isso realmente cansa. O problema do trânsito foi parcialmente resolvido quando nossa família adquiriu um carro automático. Ao volante, passei a ter tempo para pensar em algo, ouvir um audiolivro.
Além disso, surgiu um enigma na minha vida, porque eu realmente parei de entender como meu carro funciona. Um carro moderno é um dispositivo complexo. Ele se adapta simultaneamente a dezenas de parâmetros diferentes: aceleração, frenagem, estilo de condução, qualidade da estrada. Eu já não entendo como isso funciona.
Quando comecei a trabalhar com a nuvem da Amazon, isso também era um mistério para mim. Só que esse mistério é muito mais complexo, porque em um carro há um motorista, enquanto na AWS há milhões. Todos os usuários dirigem ao mesmo tempo, acelerando e freando. É incrível que eles consigam ir para onde desejam — para mim, isso é um milagre! O sistema se adapta automaticamente, escalona e se ajusta elasticamente a cada usuário, de forma que ele sente que é o único neste universo.
A magia um pouco se dissipou quando, mais tarde, comecei a trabalhar como arquiteto na Amazon. Eu vi com quais problemas enfrentamos, como os resolvemos e como desenvolvemos os serviços. Com a crescente compreensão do funcionamento do sistema, a confiança no serviço aumenta. Por isso, quero compartilhar meu entendimento sobre o que acontece por trás do AWS cloud.
Sobre o que vamos falar
Escolhi uma abordagem diversificada — selecionei 4 serviços interessantes sobre os quais vale a pena falar.
Otimização de servidores. Nuvens efêmeras com uma manifestação física: data centers físicos, onde estão os servidores físicos que zumbem, esquentam e piscam as luzes.
Funções sem servidor (Lambda) — provavelmente, o serviço mais escalável na nuvem.
Escalonamento de banco de dados. Vou falar sobre como construímos nossos próprios bancos de dados escaláveis.
Escalonamento de rede. A última parte, na qual revelarei a estrutura da nossa rede. É uma coisa maravilhosa — cada usuário da nuvem acha que está sozinho na nuvem e não vê outros inquilinos.
Nota. Neste artigo, vamos falar sobre a otimização de servidores e escalonamento de bancos de dados. O escalonamento da rede será abordado no próximo artigo. E onde estão as funções serverless? Elas foram objeto de uma análise separada «». Esta análise apresenta várias maneiras diferentes de escalonamento e detalha a solução Firecracker — a simbiose das melhores características de máquinas virtuais e contêineres.
Servidores
A nuvem é efêmera. Mas essa efemeridade tem uma manifestação física — servidores. Sua arquitetura originalmente era clássica. Chipset x86 padrão, placas de rede, Linux, hipervisor Xen, sobre o qual as máquinas virtuais eram executadas.
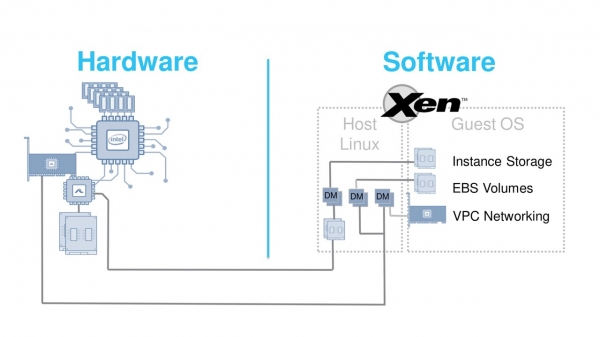
Em 2012, essa arquitetura cumpria suas funções. O Xen é um ótimo hipervisor, mas tem uma grande desvantagem. Ele apresenta custos elevados de sobrecarga na emulação de dispositivos. Com o surgimento de novas placas de rede mais rápidas ou discos SSD, esses custos tornam-se excessivos. Como lidar com esse problema? Decidiu-se atuar em duas frentes — otimizar tanto o hardware quanto o hipervisor. A tarefa é bastante desafiadora.
Otimização do hardware e do hipervisor
Não se consegue fazer tudo de uma vez e com excelência. O que significa «excelente» também não estava claro inicialmente.
Decidiu-se aplicar uma abordagem evolutiva — alterar um elemento importante da arquitetura e lançá-lo em produção.
Enfrentamos todos os desafios, ouvimos reclamações e sugestões. Depois, alteramos outro componente. Assim, com pequenos incrementos, transformamos toda a arquitetura baseada no feedback dos usuários e da equipe de suporte.
As transformações começaram em 2013, pelo mais difícil — a rede. No C3 as instâncias foram adicionadas a um cartão Network Accelerator especial em conjunto com o cartão de rede padrão. Ele era conectado literalmente com um cabo loopback curto no painel frontal. Não era bonito, mas na nuvem não era visível. No entanto, a interação direta com o hardware melhorou significativamente o jitter e a largura de banda da rede.
Após isso, decidimos melhorar o acesso ao armazenamento em bloco EBS — Elastic Block Storage. É uma combinação de rede e armazenamento. A dificuldade é que, enquanto já existiam cartões Network Accelerator no mercado, não havia a possibilidade de simplesmente comprar hardware Storage Accelerator. Portanto, nos dirigimos à startup Annapurna Labs, que desenvolveu para nós chips ASIC especiais. Eles permitiram conectar volumes EBS remotos como dispositivos NVMe.
Nas instâncias C4 resolvemos duas questões. A primeira — fizemos uma preparação para o futuro com uma tecnologia promissora, mas nova naquela época, a NVMe. A segunda — aliviamos significativamente a carga do processador central transferindo o processamento de solicitações para o EBS para um novo chip. A operação foi bem-sucedida, por isso agora a Annapurna Labs é parte da Amazon.
Em novembro de 2017, percebemos que era hora de trocar o hipervisor.
O novo hipervisor foi desenvolvido com base em módulos aprimorados do núcleo KVM.
Isso permitiu reduzir drasticamente as sobrecargas de emulação de dispositivos e trabalhar diretamente com os novos ASIC. As instâncias C5 foram as primeiras máquinas virtuais a implementar o novo hipervisor. Nós o chamamos de Nitro.
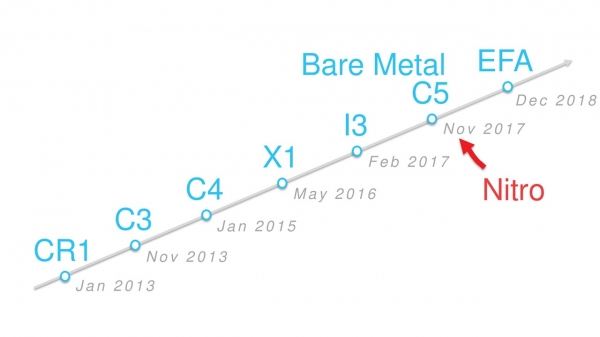 A evolução das instâncias na linha do tempo.
Todos os novos tipos de máquinas virtuais que surgiram desde novembro de 2017 operam nesse hipervisor. As instâncias Bare Metal não têm hipervisor, mas também são chamadas de Nitro, pois utilizam placas Nitro especializadas.
Nos dois anos seguintes, o número de tipos de instâncias Nitro ultrapassou duas dezenas: A1, C5, M5, T3 e outras.
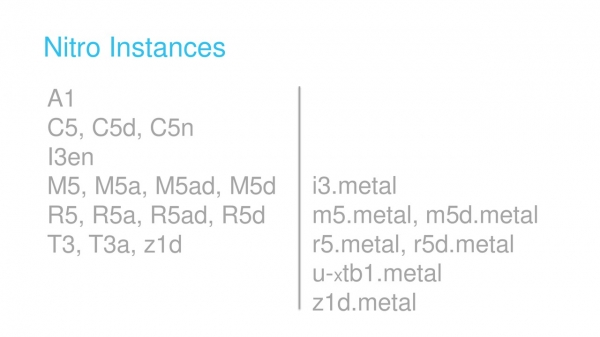
Tipos de instâncias.
Como são as modernas máquinas Nitro.
Elas possuem três componentes principais: o hipervisor Nitro (mencionado acima), um chip de segurança e as placas Nitro.
O chip de segurança está integrado diretamente na placa-mãe. Ele controla várias funções importantes, como o controle de inicialização do sistema operacional host.
As placas Nitro são de quatro tipos. Todas foram desenvolvidas pela Annapurna Labs e baseiam-se em ASICs comuns. Parte de seu firmware também é comum.
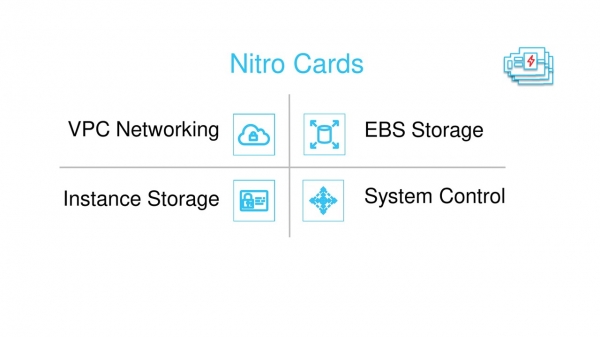
Quatro tipos de placas Nitro.
Uma das placas é destinada ao funcionamento com a redeVPC. Ela é visível nas máquinas virtuais como uma placa de rede ENA — Elastic Network Adaptor. Ela também encapsula o tráfego ao transmiti-lo pela rede física (sobre isso falaremos na segunda parte do artigo), controla o firewall Security Groups, é responsável pelo roteamento e outras funções de rede.
Placas separadas trabalham com armazenamento em bloco EBS e discos integrados ao servidor. Para a máquina virtual hospedeira, elas se apresentam como adaptadores NVMe. Elas também são responsáveis pela criptografia de dados e monitoramento de discos.
O sistema de placas Nitro, do hipervisor e do chip de segurança é integrado a uma rede SDN ou Software Defined Network. A gestão dessa rede (Control Plane) é responsabilidade controlador de mapa.
Claro, continuamos desenvolvendo novos ASIC. Por exemplo, no final de 2018, lançamos o chip Inferentia, que possibilita um trabalho mais eficiente em tarefas de aprendizado de máquina.
Processador de Aprendizado de Máquina Inferentia.
Banco de dados escalável
Um banco de dados tradicional possui uma estrutura em camadas. Simplificando bastante, os seguintes níveis podem ser destacados.
- SQL — é onde os gerenciadores de clientes e consultas operam.
- Garantias de transações — aqui tudo é claro, ACID e tudo mais.
- Cache, que é garantido por pools de buffer.
- Registro — garante a operação com logs de redo. No MySQL, eles são chamados de Bin Logs, no PostgreSQL — Write Ahead Logs (WAL).
- Armazenamento – gravação diretamente no disco.
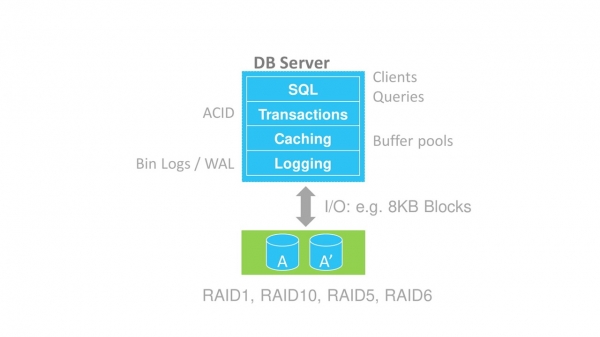
Estrutura em camadas do banco de dados.
Existem diferentes maneiras de escalar bancos de dados: sharding, arquitetura Shared Nothing, discos compartilhados.
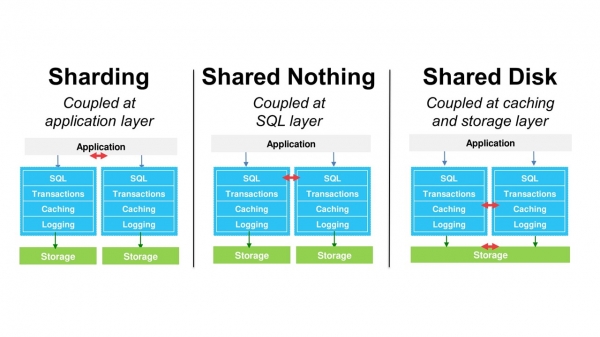
No entanto, todos esses métodos mantêm a mesma estrutura monolítica do banco de dados. Isso limita significativamente a escalabilidade. Para resolver esse problema, desenvolvemos nosso próprio banco de dados — Amazon Aurora. Ele é compatível com MySQL e PostgreSQL.
Amazon Aurora
A ideia arquitetônica principal — separar os níveis de armazenamento e registro do banco de dados principal.
Antecipando, posso dizer que também tornamos o nível de cache independente. A arquitetura deixa de ser um monólito, permitindo liberdade adicional na escalabilidade de blocos individuais.
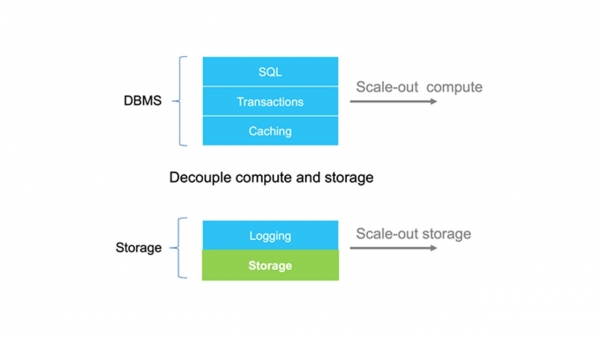
Os níveis de registro e armazenamento estão separados do banco de dados.
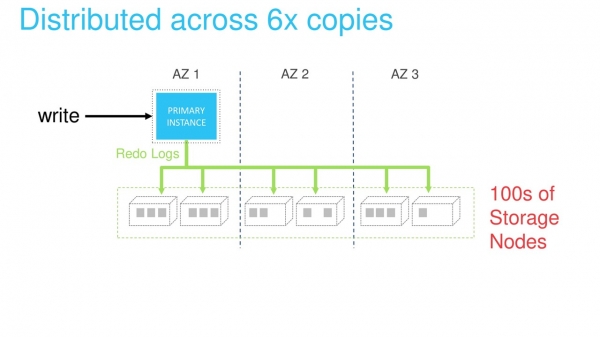
Um SGBD tradicional grava dados no sistema de armazenamento em forma de blocos. No Amazon Aurora, criamos um armazenamento 'inteligente' que pode se comunicar na linguagem dos logs de redo. Internamente, o armazenamento converte logs em blocos de dados, mantém sua integridade e faz backups automaticamente.
Essa abordagem permite implementar coisas interessantes, como clonagem. Ela funciona de forma significativamente mais rápida e econômica, já que não requer a criação de uma cópia completa de todos os dados.
O nível de armazenamento é implementado como um sistema distribuído. Ele consiste em um grande número de servidores físicos. Cada log de redo é processado e salvo simultaneamente por seis nós. Isso garante a proteção dos dados e a distribuição da carga.
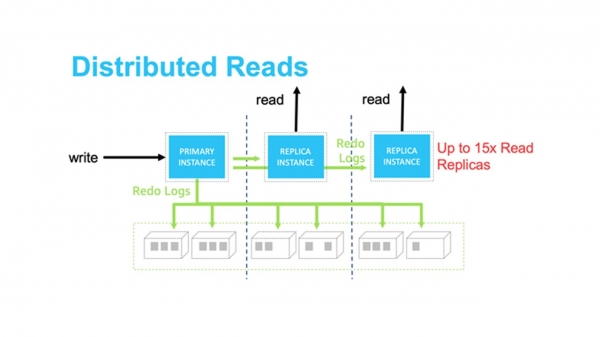
A escalabilidade de leitura pode ser garantida com as réplicas adequadas. O armazenamento distribuído elimina a necessidade de sincronização entre a instância principal do banco de dados, onde gravamos os dados, e as outras réplicas. Os dados atualizados estão garantidamente disponíveis para todas as réplicas.
O único problema é o cache de dados antigos nas réplicas de leitura. Mas essa tarefa pode ser resolvida com a transmissão de todos os logs redo para as réplicas através da rede interna. Se o log estiver no cache, ele é marcado como inválido e reescrito. Se não estiver no cache, ele simplesmente é descartado.
Já esclarecemos sobre o armazenamento.
Como escalar os níveis do SGBD
Aqui, a escalabilidade horizontal é muito mais difícil de fazer. Portanto, vamos seguir o caminho já trilhado da escalabilidade vertical clássica..
Suponha que temos um aplicativo que se comunica com o SGBD através da nó mestre.
Na escalabilidade vertical, alocamos um novo nó que terá mais processadores e memória.
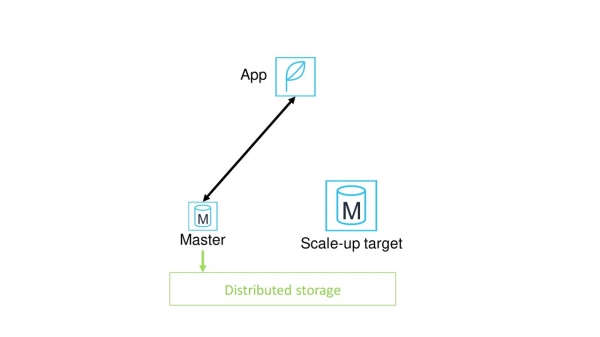
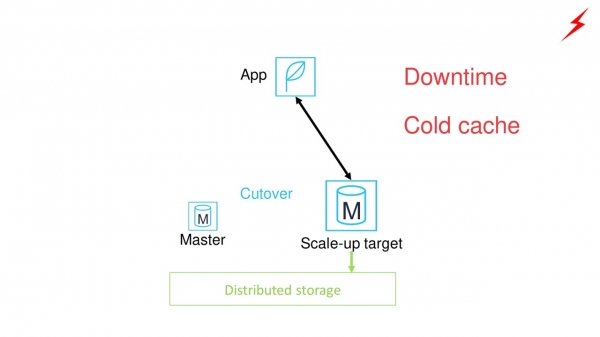
Depois, mudamos o aplicativo do antigo nó mestre para o novo. Isso causa problemas.
- Isso exigirá um tempo de inatividade significativo para o aplicativo.
- O novo nó mestre terá um cache frio. O desempenho do banco de dados será máximo apenas após o aquecimento do cache.
Como melhorar a situação? Colocar um proxy entre o aplicativo e o nó mestre.
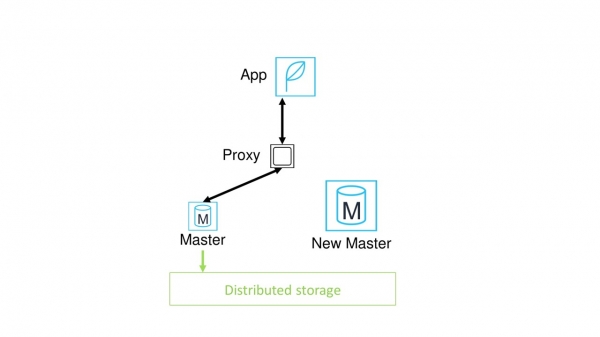
O que isso nos dará? Agora, todos os aplicativos não precisam ser redirecionados manualmente para o novo nó. A troca pode ser feita sob o proxy e, assim, será fundamentalmente mais rápida.
Parece que o problema está resolvido. Mas não, ainda estamos sofrendo com a necessidade de aquecer o cache. Além disso, surgiu um novo problema — agora o proxy é um ponto potencial de falha.
Solução final com Amazon Aurora serverless
Como resolvemos esses problemas?
Mantivemos o proxy. Não é uma instância separada, mas sim uma frota distribuída de proxies, através da qual os aplicativos se conectam ao banco de dados. Qualquer um dos nós que falhar pode ser substituído praticamente instantaneamente.
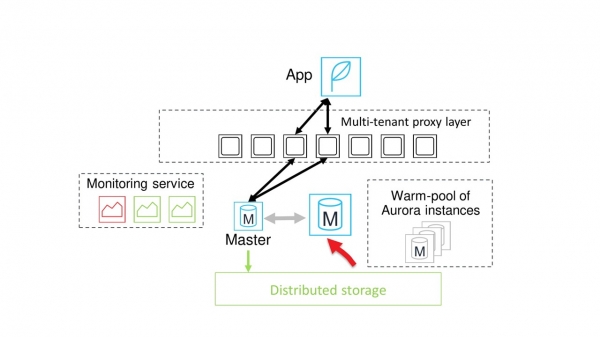
Adicionamos um pool de nós quentes de tamanhos variados. Portanto, ao precisar alocar um novo nó de maior ou menor tamanho, ele está imediatamente disponível. Não é necessário esperar que ele seja carregado.
Todo o processo de escalabilidade é controlado por um sistema de monitoramento especial. A monitor is constantly tracking the status of the current master node. If it detects that, for example, the CPU load has reached a critical level, it notifies the pool of warm instances to allocate a new node.
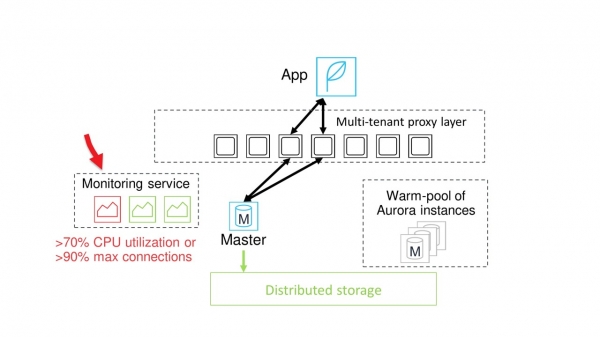
Proxies, warm instances, and monitoring.
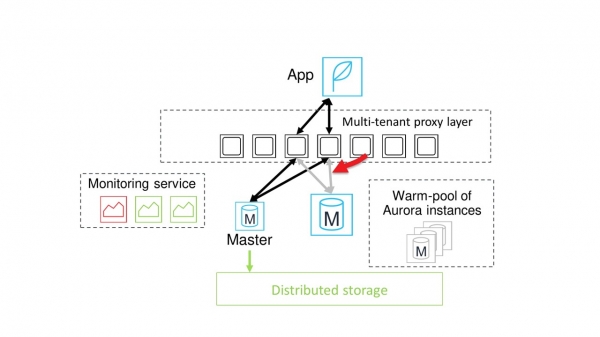
A node with the required capacity is available. Buffer pools are copied to it, and the system begins to wait for a safe moment to switch.
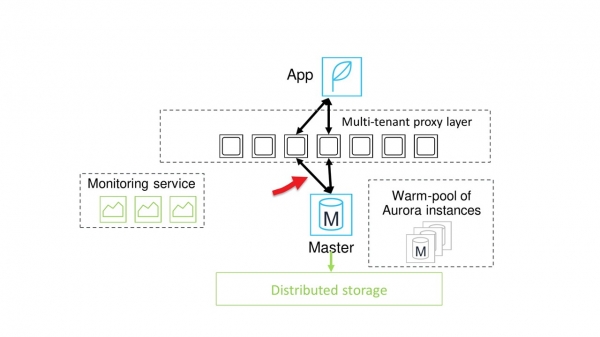
Usually, the moment for switching comes quite quickly. Then the communication between the proxy and the old master node is paused, and all sessions are switched to the new node.
Work with the database resumes.
The graph shows that the pause is indeed very short. The blue graph represents the load, while the red steps indicate the moments of scaling. The brief drops in the blue graph represent that short delay.
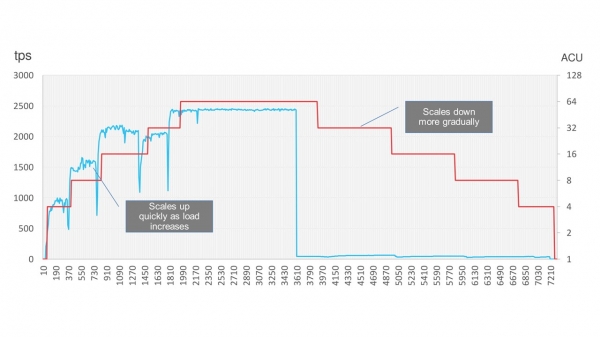
By the way, Amazon Aurora allows you to save costs by shutting down the database when it's not in use, for example, on weekends. After stopping, the database gradually reduces its capacity and disconnects for a while. When the load returns, it smoothly ramps back up.
In the next part of the story about Amazon's architecture, we will discuss network scaling. Subscribe and follow the updates so you don't miss the article.
Sobre Vasily Pantyukhin will present a talk titled "". What design patterns do Amazon developers use for distributed systems, what are the causes of service failures, what is Cell-based architecture, Constant Work, Shuffle Sharding — it will be interesting. Less than a month to the conference — . Prices will rise on October 24.
Fonte: habr.com
