

É importante para nós entender o que acontece com nossos estudantes durante o aprendizado e como esses eventos influenciam os resultados. Por isso, estamos construindo o Customer Journey Map — um mapa da experiência do cliente. O processo de aprendizado não é algo contínuo e coeso; é uma sequência de eventos e ações interconectadas do estudante, e essas ações podem variar significativamente entre diferentes alunos. Ele completou uma aula: o que ele fará a seguir? Fará a lição de casa? Usará o aplicativo móvel? Mudará de curso, pedirá para trocar de professor? Entrará imediatamente na próxima aula? Ou simplesmente sairá decepcionado? Podemos, ao analisar este mapa, identificar padrões que levam a uma conclusão bem-sucedida do curso ou, ao contrário, à desistência do estudante?
Normalmente, para construir o CJM, utilizam-se ferramentas especializadas, bastante caras, com código fechado. Mas queríamos inventar algo simples, que exigisse o mínimo de esforço e, se possível, fosse de código aberto. Assim surgiu a ideia de usar cadeias de Markov — e conseguimos. Construímos o mapa e interpretamos os dados de comportamento dos estudantes na forma de um grafo, encontrando respostas absolutamente não óbvias para questões globais do negócio e até mesmo descobrindo bugs profundamente escondidos. Tudo isso fizemos com soluções de código aberto do script Python. Neste artigo, contarei sobre dois casos com esses resultados não óbvios e compartilharei o script com todos os interessados.
Assim, as cadeias de Markov mostram a probabilidade de transições entre eventos. Aqui está um exemplo primário da Wikipédia:
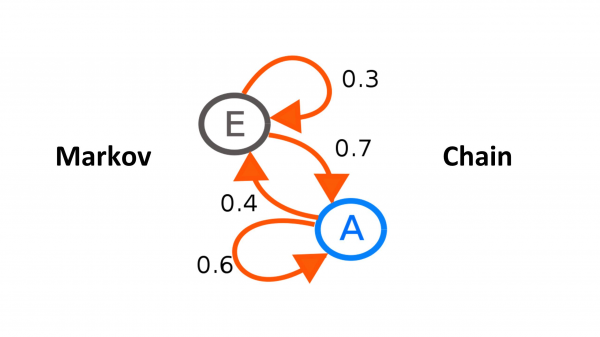
Aqui, "E" e "A" são eventos, as setas são as transições entre eles (incluindo a transição de um evento para ele mesmo), e os pesos das setas representam a probabilidade de transição ("grafo orientado ponderado").
O que foi utilizado
A cadeia foi treinada com a funcionalidade padrão do Python, que processou os logs de atividade dos estudantes. O grafo na matriz obtida foi construído com a biblioteca NetworkX.
O log se parece com isso:
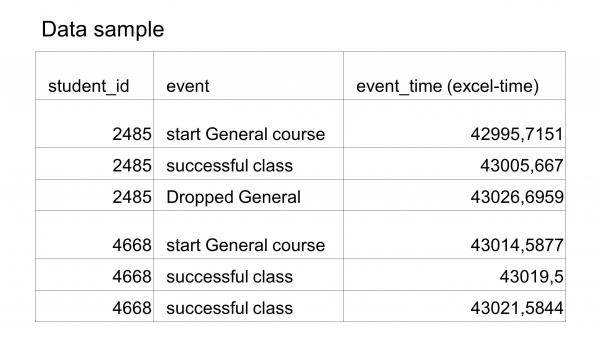
Este é um arquivo csv, contendo uma tabela com três colunas: id do estudante, nome do evento, e o tempo em que ocorreu. Esses três campos são suficientes para rastrear o movimento do cliente, construir o mapa e, por fim, obter a cadeia de Markov.
A biblioteca retorna grafos construídos nos formatos .dot ou .gexf. Para visualizar os primeiros, pode-se usar o pacote gratuito Graphviz (ferramenta gvedit). Trabalhamos com .gexf e com o Gephi, que também é gratuito.
Em seguida, quero apresentar dois exemplos de uso das cadeias de Markov, que nos permitiram olhar de forma diferente para nossos objetivos, processos de aprendizado e o próprio ecossistema da Skyeng. E também corrigir alguns bugs.
Primeiro caso: aplicativo móvel
Para começar, estudamos o caminho do estudante em nosso produto mais popular — o curso General. Naquele momento, eu trabalhava no departamento infantil da Skyeng e queríamos ver quão eficaz era o aplicativo móvel com nosso público infantil.
Pegando os logs e passando-os por um script, obtive algo assim:
O nó inicial — Start General, e na parte inferior três nós finais: o aluno 'dormiu', mudou de curso, terminou o curso.
- Fell asleep, 'Dormiu' — significa que ele não está mais participando das aulas, provavelmente se afastou. Chamamos otimisticamente esse estado de 'dormiu', pois, em teoria, ele ainda pode retomar os estudos. É o pior resultado para nós.
- Dropped general, Mudou de curso — mudou de General para algo diferente e se perdeu na nossa cadeia de Markov.
- Finished course, Terminou o curso — é o estado ideal, a pessoa completou 80% das aulas (nem todas as aulas são obrigatórias).
Chegar ao nó successful class significa que a aula foi concluída com sucesso em nossa plataforma junto com o professor. Isso registra o progresso no curso e a aproximação do resultado desejado — 'Terminou o curso'. É importante para nós que os estudantes frequente-o o máximo possível.
Para obter conclusões quantitativas mais precisas sobre o aplicativo móvel (nó app session), construímos cadeias separadas para cada um dos nós finais e depois comparamos os pesos das arestas em pares:
- de app session de volta para ela mesma;
- de app session para successful class;
- de successful class para app session.
À esquerda — estudantes que concluíram o curso, à direita — 'dormindo'
Essas três arestas mostram a relação entre o sucesso do aluno e o uso do aplicativo móvel. Esperávamos ver que os alunos que concluíram o curso teriam uma conexão mais forte com o aplicativo do que os 'dormindo'. No entanto, na prática, obtivemos exatamente os resultados opostos:
- nos certificamos de que diferentes grupos de usuários interagem de maneira diferente com o aplicativo móvel;
- estudantes bem-sucedidos usam o aplicativo móvel de forma menos intensa;
- estudantes adormecendo usam o aplicativo móvel com mais frequência.
Isso significa que os estudantes "adormecendo" começam a passar cada vez mais tempo no aplicativo móvel e, eventualmente, nele permanecem para sempre.
No início, ficamos surpresos, mas, ao pensar sobre isso, percebemos que é um efeito bastante natural. Na minha época, estudei francês sozinho, usando duas ferramentas: um aplicativo móvel e aulas de gramática no YouTube. No começo, eu dividia meu tempo entre eles na proporção de 50 a 50. Mas o aplicativo é mais divertido, tem gamificação, tudo é simples, rápido e claro, enquanto nas aulas é necessário se aprofundar, anotar algo, praticar no caderno. Gradualmente, comecei a passar mais tempo no smartphone, até que sua proporção atingiu 100%: se passar três horas nele, cria-se uma falsa sensação de trabalho concluído, a qual me impede de ir ouvir alguma coisa.
Mas como assim? Afinal, criamos o aplicativo móvel especialmente para isso, , gamificamos, tornamos atraente, para que as pessoas passassem tempo nele, e parece que ele só as distrai? Na verdade, a razão é que a equipe do aplicativo móvel fez um trabalho tão bom que ele se tornou um produto autossuficiente incrível e começou a se descolar do nosso ecossistema.
Como resultado da pesquisa, chegamos à conclusão de que o aplicativo móvel precisa de alguma mudança, para que ele não desvie tanto do curso principal de aprendizado. Isso se aplica tanto a crianças quanto a adultos. Este trabalho está em andamento agora.
Segundo caso: bugs na integração
O onboarding é um procedimento adicional opcional durante o registro de um novo aluno, que elimina potenciais problemas técnicos no futuro. O cenário básico pressupõe que a pessoa se registrou na landing page, obteve acesso ao painel pessoal, é contatada e participa de uma aula introdutória. Nesse processo, observamos uma alta porcentagem de dificuldades técnicas durante a aula introdutória: versão errada do navegador, o microfone ou som não funcionando, o professor não consegue apontar uma solução imediatamente, e tudo isso é especialmente complicado quando se trata de crianças. Portanto, desenvolvemos um aplicativo adicional no painel pessoal, onde é possível realizar quatro passos simples: verificar o navegador, câmera, microfone e confirmar que os pais estarão por perto durante a aula introdutória (pois são eles que pagam pela educação das crianças).
Estas algumas páginas de onboarding demonstraram o seguinte funil:
1: bloco inicial com três formulários de login-senha ligeiramente diferentes (dependendo do cliente).
2: checkbox de aceitação do procedimento adicional de onboarding.
2.1-2.3: verificação da presença do pai, versão do Chrome e som.
3: bloco final.
Ele parece muito natural: nos dois primeiros passos, a maioria dos visitantes desiste, percebendo que precisa preencher algo, verificar, mas não tem tempo. Se o cliente chega até o terceiro passo, é quase certo que ele chegará ao final. No funil, não há nenhuma razão para suspeitar de algo.
Decidimos analisar nosso onboarding não em um funil unidimensional clássico, mas usando uma cadeia de Markov. Incluímos um pouco mais de eventos, rodamos um script e obtivemos o seguinte:
É possível entender uma coisa neste caos: algo deu errado. O processo de onboarding é linear, isso é como foi projetado, e não deveria haver uma teia de conexões. Aqui, é evidente que o usuário está sendo jogado entre passos, entre os quais não deveria haver transições.
As causas dessa imagem estranha podem ser duas:
- falhas no banco de logs;
- falhas estão presentes no próprio produto — no onboarding.
A primeira razão, provavelmente, está presente, mas verificá-la é bastante trabalhoso, e corrigir os logs não ajudará em nada na melhoria da experiência do usuário. Já em relação à segunda, se houver, era necessário agir rapidamente. Então, fomos explorar os nós, identificar as arestas que não deveriam estar lá, e buscar as causas de seu surgimento. Percebemos que alguns usuários estavam presos em um ciclo, outros saíam do meio para o início, e alguns simplesmente não conseguiam sair das duas primeiras etapas. Enviamos os dados para QA — e sim, descobrimos que havia muitos bugs no onboarding: é um produto meio improvisado, que não foi testado profundamente, pois não esperávamos problemas. Agora, todo o processo de registro foi alterado.
Essa história nos mostrou uma aplicação inesperada das cadeias de Markov na área de QA.
Experimente você mesmo!
Eu disponibilizei meu de forma aberta — sintam-se à vontade. A documentação está no GitHub, e dúvidas podem ser enviadas aqui, farei o possível para responder a todas.
Além disso, links úteis: , . E aqui sobre cadeias de Markov. Os gráficos no artigo foram feitos com .
Fonte: habr.com
