

Olá, Habr!
Após as festas de Ano Novo, relançamos a nuvem de alta disponibilidade, baseada em dois locais. Hoje vamos explicar como isso funciona e mostrar o que acontece com as máquinas virtuais dos clientes em caso de falha de componentes individuais do cluster e queda de todo o local (spoiler – tudo ficará bem com elas).
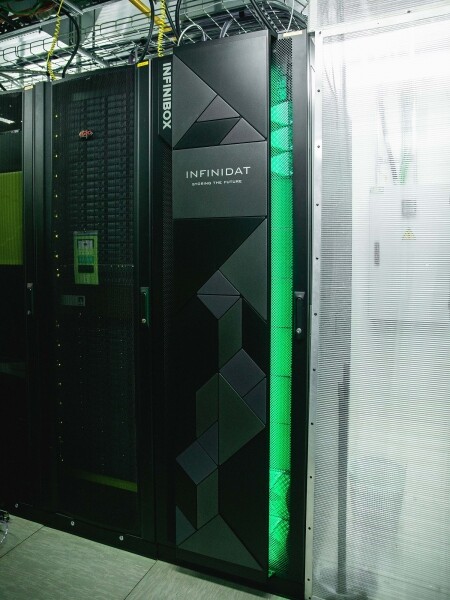
Solução de armazenamento da nuvem de alta disponibilidade no local OST.
O que há dentro
Sob o capô do cluster, estão servidores Cisco UCS com hipervisor VMware ESXi, dois sistemas de armazenamento INFINIDAT InfiniBox F2240, equipamentos de rede Cisco Nexus e também switches SAN Brocade. O cluster está distribuído em dois locais – OST e NORD, ou seja, em cada data center há um conjunto idêntico de equipamentos. Isso é o que o torna altamente disponível.
Dentro de um único local, os elementos principais também são duplicados (hosts, switches SAN, rede).
Os dois locais estão conectados por rotas de fibra óptica dedicadas, também redundantes.
Um pouco sobre o sistema de armazenamento. A primeira versão da nuvem de alta disponibilidade foi construída com NetApp. Aqui escolhemos INFINIDAT, e aqui está o porquê:
- A opção de replicação Active-Active. Ela permite que a máquina virtual permaneça operante mesmo com a falha total de um dos sistemas de armazenamento. Eu falarei mais sobre replicação adiante.
- Três controladores de disco para aumentar a resiliência do sistema. Normalmente, há apenas dois.
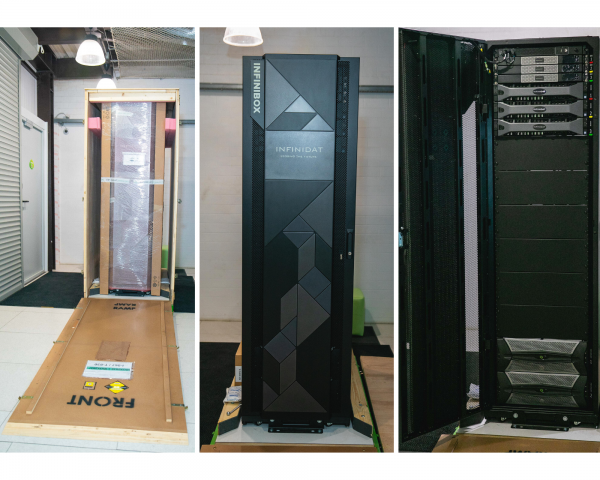
- Solução pronta. Recebemos um rack já montado, que apenas precisa ser conectado à rede e configurado.
- Suporte técnico atencioso. Os engenheiros da INFINIDAT analisam constantemente os logs e eventos do sistema de armazenamento, instalam novas versões de firmware e ajudam com a configuração.
Aqui estão algumas fotos do unpacking:
Como funciona
A nuvem já é resiliente internamente. Ela protege os clientes contra falhas de hardware e software isoladas. A alta disponibilidade, por sua vez, ajuda a se proteger contra falhas massivas dentro de um único local: por exemplo, a falha do sistema de armazenamento (ou do cluster SDS, que acontece com frequência 🙂), erros massivos na rede de armazenamento e assim por diante. E o mais importante: essa nuvem salva quando um local inteiro se torna indisponível devido a incêndios, blackouts, invasões de mercenários ou até mesmo invasões alienígenas.
Em todos esses casos, as máquinas virtuais dos clientes continuam funcionando, e aqui está o porquê.
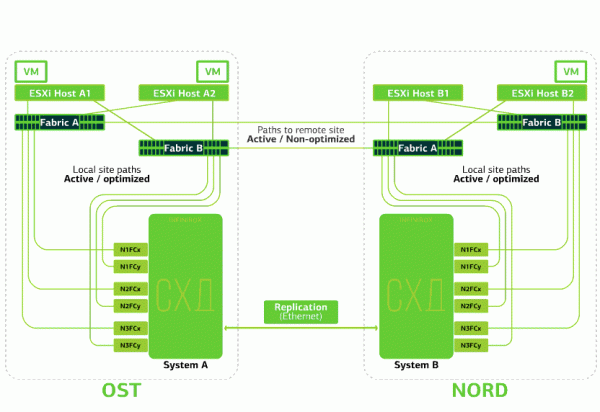
O esquema do cluster é projetado de forma que qualquer host ESXi com máquinas virtuais de clientes possa acessar qualquer um dos dois storage arrays. Se o storage array no local OST falhar, as máquinas virtuais continuarão operando: os hosts nos quais elas estão rodando irão acessar os dados do storage array no NORD.
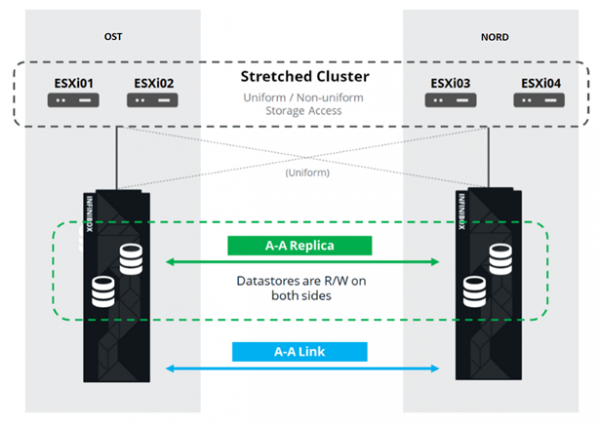
Este é o diagrama de conexão no cluster.
Isso é possível graças ao fato de que entre os switches SAN dos dois sites está configurado o Inter-Switch Link: o switch SAN Fabric A OST está conectado ao switch SAN Fabric A NORD, da mesma forma vale para os switches SAN Fabric B.
E para que toda essa complexidade dos switches SAN faça sentido, entre os dois storage arrays está configurada a replicação ativa-ativa: as informações são gravadas quase simultaneamente no storage array local e no remoto, RPO=0. Assim, em um storage array está a original dos dados, enquanto no outro está a réplica. Os dados são replicados no nível dos volumes do storage array, e nelas são armazenados os dados das VMs (seus discos, arquivo de configuração, arquivo swap etc.).
O host ESXi vê o volume principal e sua réplica como um único dispositivo de armazenamento (Storage Device). Existem 24 caminhos do host ESXi para cada dispositivo de armazenamento:
12 caminhos conectam o dispositivo ao storage array local (caminhos otimizados), enquanto os outros 12 se conectam ao remoto (caminhos não otimizados). Em uma situação normal, o ESXi acessa os dados no storage array local usando os "caminhos otimizados". Quando o storage array falha, o ESXi perde os caminhos otimizados e muda para os "não otimizados". Veja como isso se parece no diagrama.
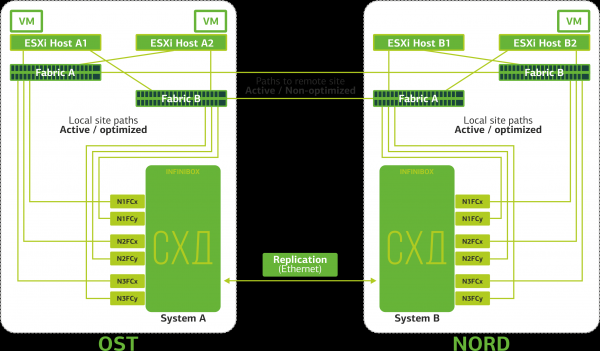
Diagrama de cluster de alta disponibilidade.
Todas as redes de clientes estão conectadas a ambos os sites através de uma única rede. Em cada site, um Provider Edge (PE) opera, onde as redes dos clientes são terminadas. Os PEs estão interconectados em um cluster comum. Se um PE falhar em um site, todo o tráfego é redirecionado para o segundo site. Isso garante que as máquinas virtuais do site que ficou sem PE, permaneçam acessíveis pela rede para o cliente.
Agora vamos ver o que acontece com as máquinas virtuais do cliente em diferentes cenários de falha. Começaremos com as situações mais leves e terminaremos com a mais grave - a falha de todo o site. Nos exemplos, o site principal será o OST, e o site de backup, com as réplicas de dados, será o NORD.
O que acontece com a máquina virtual do cliente se…
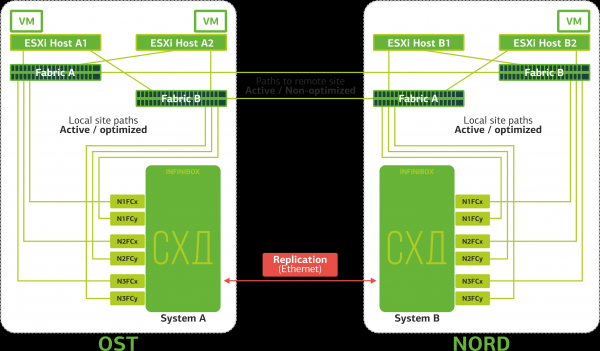
O enlace de replicação falhar. A replicação entre os storage arrays dos dois sites é interrompida.
O ESXi funcionará apenas com dispositivos de armazenamento local (pelos caminhos otimizados).
As máquinas virtuais continuam operando.
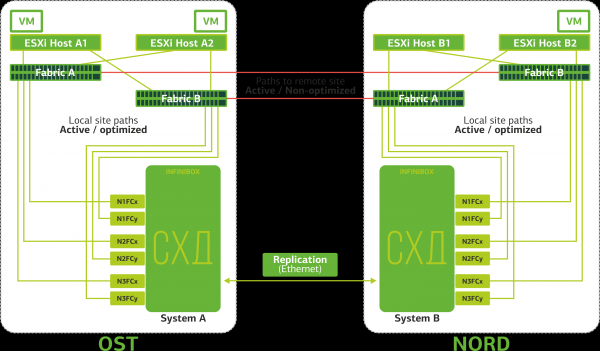
Ocorre a interrupção do ISL (Inter-Switch Link). Um caso pouco provável. A menos que algum escavador maluco cave várias rotas ópticas ao mesmo tempo, que passam por caminhos independentes e são conectadas aos locais através de diferentes entradas. Mas ainda assim. Nesse caso, os hosts ESXi perderão metade dos caminhos e poderão acessar apenas seus próprios armazenamento local. As réplicas são reunidas, mas os hosts não conseguirão acessá-las.
As máquinas virtuais estão funcionando normalmente.
Falha no switch SAN em um dos locais. Os hosts ESXi perdem parte dos caminhos para o armazenamento. Nesse caso, os hosts no local onde o switch falhou funcionarão apenas através de seu único HBA.
As máquinas virtuais continuam funcionando normalmente.
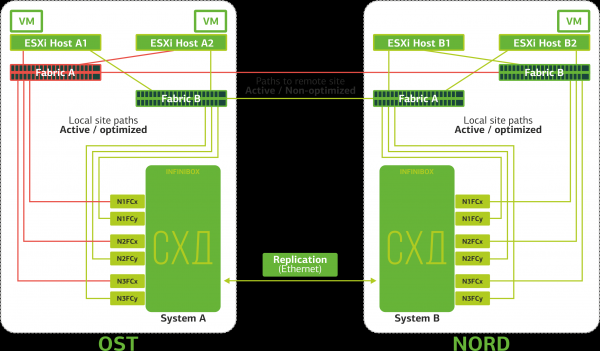
Todos os switches SAN falham em um dos locais. Suponha que esse problema ocorreu no local OST. Nesse caso, os hosts ESXi nesse local perderão todos os caminhos para seus dispositivos de armazenamento. O mecanismo padrão do VMware vSphere HA entra em ação: ele reiniciará todas as máquinas virtuais do local OST no NORD em no máximo 140 segundos.
As máquinas virtuais que operam nos hosts do local NORD estão funcionando normalmente.
Falha no host ESXi em um local. Aqui novamente o mecanismo vSphere HA entra em ação: as máquinas virtuais do host com falha são reiniciadas em outros hosts - no mesmo local ou em um local remoto. O tempo de reinício da máquina virtual é de até 1 minuto.
Se todos os hosts ESXi do local OST falharem, não há opções: as VMs serão reiniciadas em outro local. O tempo de reinício permanece o mesmo.
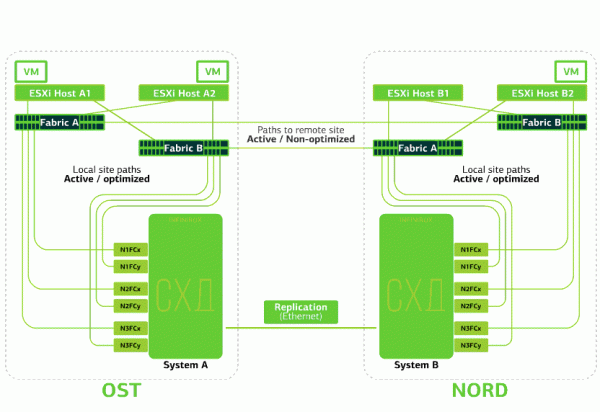
Falha no armazenamento em um local. Suponha que o armazenamento falhou no local OST. Nesse caso, os hosts ESXi do local OST alternam para trabalhar com réplicas de armazenamento no NORD. Após a recuperação do armazenamento falho, ocorrerá uma replicação forçada, e os hosts ESXi OST voltarão a acessar o armazenamento local.
As máquinas virtuais funcionam normalmente durante todo esse tempo.
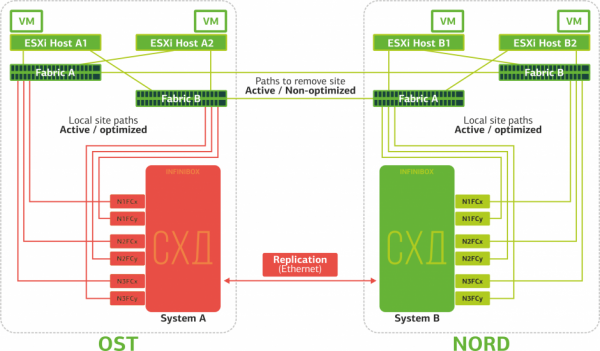
Falha em um dos locais. Nesse caso, todas as máquinas virtuais serão reiniciadas no local de backup através do mecanismo vSphere HA. O tempo de reinício das VMs é de 140 segundos. Durante isso, todas as configurações de rede da máquina virtual serão mantidas, e ela continuará acessível para o cliente pela rede.
Para que a reinicialização das máquinas no local de backup ocorra sem problemas, cada local deve estar preenchido apenas na metade. A segunda metade é uma reserva para caso todas as máquinas virtuais sejam transferidas do segundo local, que foi afetado.
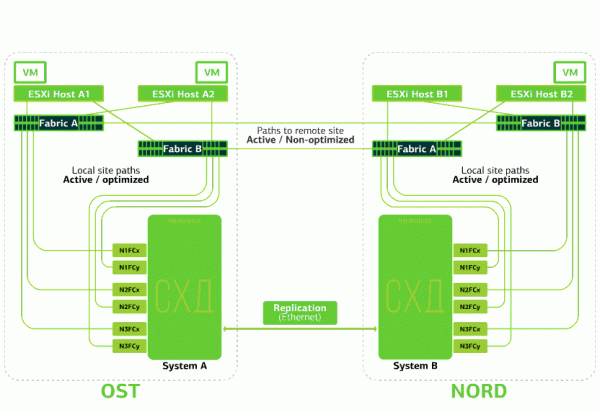
É isso que a nuvem de resistência a desastres protege contra, com base em dois data centers.
Esse prazer não é barato, pois, além dos recursos principais, é necessária uma reserva no segundo local. Portanto, serviços críticos para os negócios que podem sofrer grandes perdas financeiras e reputacionais durante longos períodos de inatividade são alocados nessa nuvem, ou quando o sistema de informação possui requisitos de resistência a desastres impostos por reguladores ou regulamentos internos da empresa.
Fontes:
Fonte: habr.com
