

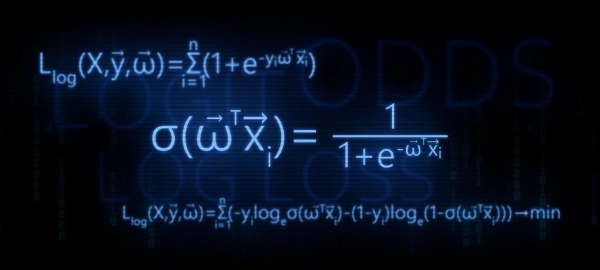
Neste artigo, vamos analisar as deduções teóricas da transformação da função de regressão linear em a função de transformação logit inversa (também chamada de função de resposta logística). Em seguida, utilizando o arsenal do método da máxima verossimilhança, de acordo com o modelo de regressão logística, derivaremos a função de perda Logistic Loss, ou, em outras palavras, vamos definir a função com a qual na modelagem de regressão logística os parâmetros do vetor de pesos são ajustados  .
Estrutura do artigo:
- Vamos revisar a relação linear entre duas variáveis
- Identificaremos a necessidade de transformação da função de regressão linear
 em da função de resposta logística
- Faremos as transformações e derivaremos da função de resposta logística
- Tentaremos entender por que o método dos mínimos quadrados é inadequado na estimação de parâmetros funções Logistic Loss
- Usaremos o método da máxima verossimilhança para definir a função de ajuste de parâmetros :
5.1. Caso 1: função Logistic Loss para objetos com classificação de classes 0 e 1:
5.2. Caso 2: função Logistic Loss para objetos com classificação de classes -1 e +1:
 em da função de resposta logística

 funções Logistic Loss
 :


O artigo está repleto de exemplos simples, onde todos os cálculos podem ser facilmente realizados mentalmente ou no papel; em alguns casos, pode ser necessário um calculador. Então, prepare-se 🙂
Este artigo é principalmente voltado para cientistas de dados com conhecimentos iniciais sobre os fundamentos de aprendizado de máquina.
O artigo também incluirá código para a plotagem de gráficos e cálculos. Todo o código foi escrito na linguagem python 2.7. Antecipadamente explico sobre a 'novidade' da versão utilizada — este é um dos requisitos para passar pelo famoso curso de Yandex na não menos famosa plataforma de educação online Coursera, e, como pode ser adivinhado, o material foi preparado com base nesse curso.
01. Dependência linear
É bastante razoável perguntar — qual a relação entre a dependência linear e a regressão logística?
É simples! A regressão logística é um dos modelos que pertencem ao classificador linear. Em termos simples, a tarefa de um classificador linear é prever os valores-alvo  a partir das variáveis (regressores)
 . Considera-se que a dependência entre as características
 e os valores-alvo
 linear. Daí o próprio nome do classificador - linear. Se generalizarmos de forma bastante ampla, a base do modelo de regressão logística é a suposição de uma relação linear entre as características
 e os valores-alvo
 . Aqui está - a conexão.
No estúdio, o primeiro exemplo, e ele, corretamente, sobre a dependência linear das grandezas estudadas. Durante a preparação do artigo, encontrei um exemplo que já se tornou bastante conhecido por muitos - a dependência da corrente elétrica da tensão ('Análise de Regressão Aplicada', N. Draper, G. Smith). Aqui também o abordaremos.
De acordo com a lei de Ohm:
 , onde
 – corrente elétrica,
 – tensão,
 – resistência.
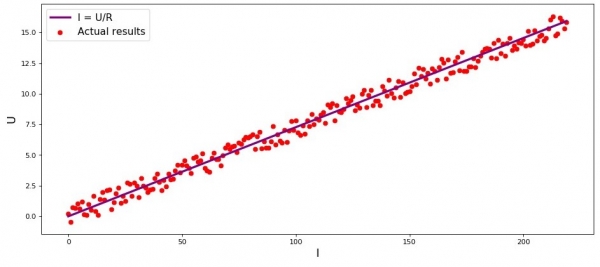
Se não soubéssemos a lei de Ohm, poderíamos encontrar a dependência empiricamente, alterando  e medindo
 , mantendo ao mesmo tempo
 fixo. Então veríamos que o gráfico da dependência
 de
 formaria uma linha mais ou menos reta que passa pela origem. Dissemos 'mais ou menos' porque, embora a dependência seja, de fato, precisa, nossas medições podem conter pequenos erros, e, portanto, os pontos no gráfico podem não cair exatamente na linha, mas estarem distribuídos ao redor dela aleatoriamente.
Gráfico 1 'Dependência  de
 »
Código para desenhar o gráfico
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Resultados reais')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. A necessidade de transformações na equação da regressão linear
Vamos considerar mais um exemplo. Imaginem que estamos trabalhando em um banco e a tarefa diante de nós é determinar a probabilidade de um devedor pagar um empréstimo com base em alguns fatores. Para simplificar a tarefa, consideremos apenas dois fatores: o salário mensal do devedor e o valor mensal do pagamento do empréstimo.
A tarefa é muito hipotética, mas com este exemplo conseguiremos entender por que a aplicação de da função de regressão linear, por si só, não é suficiente, além de descobrir quais transformações devem ser feitas na função.
Voltamos ao exemplo. É claro que quanto maior o salário, mais o mutuário poderá direcionar mensalmente para a quitação do empréstimo. No entanto, para um determinado intervalo de salários, essa dependência será bastante linear. Por exemplo, vamos considerar um intervalo de salários de 60.000R a 200.000R e supor que, dentro desse intervalo, a relação entre o valor da prestação mensal e o salário seja linear. Suponha que, nesse intervalo de salários, foi identificado que a proporção entre o salário e a prestação não pode ser inferior a 3, e ainda deve restar 5.000R para o mutuário. E somente assim consideraremos que o mutuário devolverá o empréstimo ao banco. Portanto, a equação da regressão linear terá a seguinte forma:

onde  ,
 ,
 ,
 — salário
 do mutuário,
 — prestação do empréstimo
 do mutuário.
Substituindo na equação o salário e a prestação do empréstimo com parâmetros fixos  pode-se tomar uma decisão sobre a concessão ou recusa do empréstimo.
Antecipando, vale ressaltar que, com os parâmetros dados,  a função de regressão linear, aplicada na função de resposta logística , irá gerar valores elevados, dificultando os cálculos para determinar as probabilidades de quitação do empréstimo. Portanto, propõe-se reduzir nossos coeficientes, digamos, em 25.000 vezes. Essa transformação nos coeficientes não alterará a decisão sobre a concessão do empréstimo. Vamos lembrar desse ponto no futuro, e agora, para tornar ainda mais claro sobre o que se fala, vejamos a situação com três potenciais mutuários.
Tabela 1 "Potenciais mutuários"
Código para formação da tabela
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'O mutuário':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Salário':np.array([120000,180000,210000]),
       'Pagamento':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Salário']*w_1 + df['Pagamento']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Aprovado'
        decision.append(dec)
    else:
        dec = 'Recusa'
        decision.append(dec)

df['Decisão'] = decision

df[['O mutuário', 'Salário', 'Pagamento', 'f(w,x)', 'Decisão']]
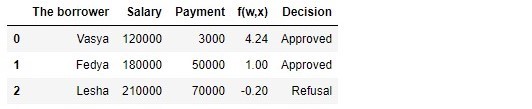
De acordo com os dados da tabela, Vasya, com um salário de 120.000R, deseja obter um empréstimo que possa ser quitado mensalmente com 3.000R. Determinamos que, para a aprovação do empréstimo, o salário de Vasya deve exceder três vezes o valor da prestação e ainda restar 5.000R. Esse requisito é atendido por Vasya:  Ainda resta até 106.000R. Apesar de termos reduzido os coeficientes
 em 25.000 vezes, o resultado foi o mesmo – o crédito pode ser aprovado. O Fedya também receberá o crédito, enquanto o Lesha, apesar de ganhar mais que todos, terá de moderar suas expectativas.
 Vamos desenhar um gráfico para essa situação.
Gráfico 2 "Classificação dos tomadores"
Código para desenhar o gráfico
salary = np.arange(60000,240000,20000) payment = (-w_0-w_1*salary)/w_2fig, axes = plt.subplots(figsize=(14,6), dpi=80) plt.plot(salary, payment, color='grey', lw=2, label='$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$') plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'], 'o', color='green', markersize=12, label='Decisão - Crédito aprovado') plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'], 's', color='red', markersize=12, label='Decisão - Crédito recusado') plt.xlabel('Salário', size=16) plt.ylabel('Pagamento', size=16) plt.legend(prop={'size': 14}) plt.show()
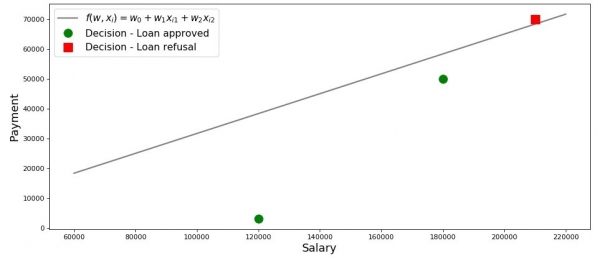
Assim, nossa linha, construída de acordo com a função, separa os "maus" tomadores dos "bons". Aqueles tomadores cujos desejos não coincidem com suas possibilidades estão acima da linha (Lesha), enquanto os que são capazes, de acordo com os parâmetros do nosso modelo, de devolver o crédito, estão abaixo da linha (Vasya e Fedya). Em outras palavras, nossa linha divide os tomadores em duas classes. Vamos designá-las da seguinte forma: a classe  será composta por aqueles tomadores que provavelmente devolverão o crédito, e a classe
 será composta por aqueles tomadores que provavelmente não conseguirão devolver o crédito.
 ou
 Vamos generalizar as conclusões deste exemplo simples. Pegaremos o ponto
e, substituindo as coordenadas do ponto na correspondente equação da linha  , consideraremos três variantes:
 Se o ponto estiver abaixo da linha e o classificarmos na classe
- , então o valor da função será positivo a partir de . Isso significa que podemos considerar que a probabilidade de pagamento do crédito está dentro dos limites até . Quanto maior o valor da função, maior a probabilidade. Se o ponto estiver acima da linha e o classificarmos na classe
- , então o valor da função será negativo a partir de ou . Então, acreditaremos que a probabilidade de pagamento da dívida está dentro dos limites até e quanto maior for o módulo do valor da função, maior nossa confiança. O ponto está sobre a linha, na fronteira entre as duas classes. Nesse caso, o valor da função
- será igual a e a probabilidade de pagamento do crédito é igual a Agora, vamos imaginar que temos não dois fatores, mas dezenas, e que os tomadores não são três, mas milhares. Então, em vez de uma linha, teremos .
 será positivo a partir de
 . Isso significa que podemos considerar que a probabilidade de pagamento do crédito está dentro dos limites
 até
 . Quanto maior o valor da função, maior a probabilidade.
 Se o ponto estiver acima da linha e o classificarmos na classe
 ou
 . Então, acreditaremos que a probabilidade de pagamento da dívida está dentro dos limites
 até
 e quanto maior for o módulo do valor da função, maior nossa confiança.
 O ponto está sobre a linha, na fronteira entre as duas classes. Nesse caso, o valor da função
 e a probabilidade de pagamento do crédito é igual a
 Agora, vamos imaginar que temos não dois fatores, mas dezenas, e que os tomadores não são três, mas milhares. Então, em vez de uma linha, teremos
 .
Теперь, представим, что у нас не два фактора, а десятки, заемщиков не три, а тысячи. Тогда вместо прямой у нас будет m-мерная plano e coeficientes  nós não vamos adotá-los aleatoriamente, mas sim baseados em todas as regras, utilizando dados coletados sobre os mutuários que pagaram ou não retornaram o crédito. E de fato, note que estamos selecionando mutuários com os coeficientes já conhecidos
 . Na verdade, a tarefa do modelo de regressão logística é exatamente determinar os parâmetros
 , nos quais o valor da função de perda Logistic Loss tende a ser o mínimo. Mas sobre como calcular o vetor
 , ainda vamos aprender na seção 5 do artigo. Por enquanto, vamos voltar à terra prometida — ao nosso banqueiro e seus três clientes.
Graças à função  , sabemos a quem podemos conceder crédito e a quem devemos negar. Mas com essa informação, não podemos ir ao diretor, pois queriam que apresentássemos a probabilidade de retorno do crédito de cada mutuário. O que fazer? A resposta é simples — precisamos de alguma forma converter a função
 , cujos valores estão no intervalo
 , em uma função cujos valores estejam no intervalo
 . E essa função existe, chamada de função de resposta logística ou transformação logit inversa. Conheça:

Vamos ver passo a passo como é obtida a função de resposta logística. Notemos que estamos indo na direção oposta, ou seja, vamos supor que sabemos o valor da probabilidade, que está entre  até
 , e então 'desvendaremos' esse valor em toda a área de números de
 até
 .
03. Vamos derivar a função de resposta logística
Passo 1. Transformaremos os valores de probabilidade para o intervalo

Durante a transformação da função  em da função de resposta logística
 , vamos deixar nosso analista de crédito de lado, e em vez disso, vamos dar uma olhada nas casas de apostas. Não, claro, não vamos fazer apostas, tudo o que nos interessa lá é o significado da expressão, por exemplo, uma chance de 4 para 1. As odds, conhecidas por todos que fazem apostas, são a razão entre 'sucessos' e 'fracassos'. Do ponto de vista das probabilidades, a odds é a probabilidade de um evento ocorrer, dividida pela probabilidade de que o evento não ocorra. Vamos escrever a fórmula da chance de ocorrência de um evento
 :

, onde  — a probabilidade do evento ocorrer,
 — a probabilidade de o evento NÃO ocorrer
Por exemplo, se a probabilidade de que um jovem, forte e ágil cavalo chamado "Vento" ultrapasse uma velha e cansada senhora chamada "Matilda" em uma corrida for  , então as chances de sucesso do "Vento" serão
 para

 e vice-versa, sabendo as chances, podemos facilmente calcular a probabilidade
 :

Assim, aprendemos a "traduzir" probabilidade em chances, que assumem valores de  até
 . Vamos dar mais um passo e aprender a "traduzir" probabilidade em toda a linha numérica de
 até
 .
Passo 2. Vamos converter valores de probabilidade para o intervalo

Esse passo é muito simples — vamos usar o logaritmo das chances na base do número de Euler  e obteremos:

Agora sabemos que se  , calcular o valor de
 será muito simples e, mais importante, ele deve ser positivo:
 . E assim é.
Por curiosidade, vamos verificar que se  , então esperamos ver um valor negativo
 . Vamos verificar:
 . Tudo certo.
Agora sabemos como converter o valor da probabilidade de  até
 em toda a linha numérica de
 até
 . No próximo passo, faremos tudo ao contrário.
Mas por enquanto, vamos observar que, de acordo com as regras de logaritmização, sabendo o valor da função  , podemos calcular as chances:

Esse método para determinar as chances será útil no próximo passo.
Passo 3. Vamos derivar a fórmula para determinar

Então, aprendemos que, sabendo  , encontramos os valores da função
 . No entanto, na verdade, precisamos de tudo exatamente ao contrário — sabendo o valor
 encontrar
 . Para isso, vamos nos referir ao conceito de função inversa das chances, de acordo com a qual:

Neste artigo, não iremos derivar a fórmula mencionada acima, mas vamos verificar com os números do exemplo anterior. Sabemos que com chances iguais a 4 para 1 ( ), a probabilidade de um evento ocorrer é 0.8 (
 ). Vamos fazer a substituição:
 . Isso coincide com nossos cálculos anteriores. Vamos em frente.
No passo anterior, derivamos que  , então podemos substituir na função inversa das chances. Obtivemos:

Vamos dividir tanto o numerador quanto o denominador por  , então:

Por precaução, para garantir que não cometemos nenhum erro, vamos fazer mais uma pequena verificação. No passo 2, nós definimos que  . Então, ao substituir o valor
 na função de resposta logística, esperamos obter
 . Fazemos a substituição e obtemos:
 . Подставляем и получаем:

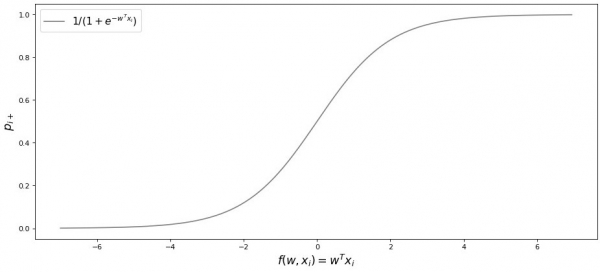
Parabéns, caro leitor, acabamos de derivar e testar a função de resposta logística. Vamos dar uma olhada no gráfico da função.
Gráfico 3 "Função de Resposta Logística"
salary = np.arange(60000,240000,20000) payment = (-w_0-w_1*salary)/w_2fig, axes = plt.subplots(figsize=(14,6), dpi=80) plt.plot(salary, payment, color='grey', lw=2, label='$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$') plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'], 'o', color='green', markersize=12, label='Decisão - Crédito aprovado') plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'], 's', color='red', markersize=12, label='Decisão - Crédito recusado') plt.xlabel('Salário', size=16) plt.ylabel('Pagamento', size=16) plt.legend(prop={'size': 14}) plt.show()
import math

def logit(f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize=(14,6), dpi=80)
plt.plot(f, p, color='grey', label='$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size=16)
plt.ylabel('$p_{i+}$', size=16)
plt.legend(prop={'size': 14})
plt.show()
Na literatura, também se pode encontrar o nome dessa função como função sigmoide. Pelo gráfico, é claramente visível que a principal alteração na probabilidade de pertencimento de um objeto a uma classe ocorre em um intervalo relativamente pequeno  , em torno de
 até
 .
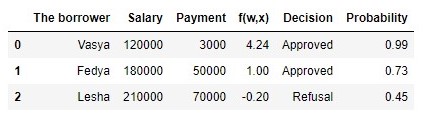
Vamos voltar ao nosso analista de crédito e ajudá-lo a calcular a probabilidade de pagamento de empréstimos, caso contrário, ele corre o risco de ficar sem bônus 🙂
Tabela 2 "Potenciais Tomadores de Empréstimos"
Código para formação da tabela
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i), 2))

df['Probability'] = proba

df[['O tomador', 'Salário', 'Pagamento', 'f(w,x)', 'Decisão', 'Probabilidade']]
Assim, a probabilidade de retorno do empréstimo foi determinada. De modo geral, isso parece verdade.
De fato, a probabilidade de que Vasya, com um salário de 120.000R, consiga pagar mensalmente ao banco 3.000R está próxima de 100%. A propósito, devemos entender que o banco pode conceder um empréstimo a Lesha caso a política do banco preveja, por exemplo, financiar clientes com uma probabilidade de retorno de crédito superior a 0,3. Nesse caso, o banco simplesmente formará uma maior reserva para possíveis perdas.
Também deve-se notar que a relação salário/pagamento de pelo menos 3 e com uma margem de 5.000R foi escolhida arbitrariamente. Portanto, não poderíamos usar em sua forma original o vetor de pesos  . Precisávamos reduzir drasticamente os coeficientes e, nesse caso, dividimos cada coeficiente por 25.000, ou seja, na verdade, ajustamos o resultado. Mas isso foi feito intencionalmente para simplificar a compreensão do material inicialmente. Na prática, precisamos não inventar e ajustar os coeficientes, mas encontrá-los. Justamente nas próximas seções do artigo, deduziremos as equações que nos ajudam a determinar os parâmetros
 .
04. Método dos Mínimos Quadrados na Determinação do Vetor de Pesos na Função de Resposta Logística
 na Função de Resposta Logística
Já conhecemos tal método de ajuste do vetor de pesos  , como método dos mínimos quadrados (MMQ) E, de fato, por que não usar isso em tarefas de classificação binária? Realmente, nada impede de usar Mínimos Quadrados Não Lineares, só que esse método em tarefas de classificação gera resultados menos precisos do que Logistic Loss. Isso possui uma justificativa teórica. Vamos começar analisando um exemplo simples.
Suponha que nossos modelos (usando MSE e Logistic Loss) já iniciaram a seleção do vetor de pesos  e interrompemos o cálculo em algum passo. Não importa se no meio, no fim ou no começo, o importante é que já temos alguns valores do vetor de pesos e supomos que nesse passo, os vetores de pesos
 para ambos os modelos não têm diferenças. Então, pegaremos os pesos obtidos e os aplicaremos em da função de resposta logística (
 ) para algum objeto que pertence à classe
 . Vamos examinar dois casos, quando de acordo com o vetor de pesos ajustado nosso modelo erra gravemente e, ao contrário, o modelo está muito confiante de que o objeto pertence à classe
 . Vamos ver quais penalizações serão "aplicadas" ao usar Mínimos Quadrados Não Lineares e Logistic Loss.
Código para calcular penalizações dependendo da função de perda utilizada
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Caso de erro grosseiro — o modelo classifica o objeto na classe  com uma probabilidade de 0,01
A penalização ao usar Mínimos Quadrados Não Lineares será:

A penalização ao usar Logistic Loss será:

Caso de forte confiança — o modelo classifica o objeto na classe  com uma probabilidade de 0,99
A penalização ao usar Mínimos Quadrados Não Lineares será:

A penalização ao usar Logistic Loss será:

Este exemplo ilustra bem que em um erro grosseiro, a função de perda Log Loss penaliza o modelo significativamente mais do que MSE. Agora vamos entender quais são as premissas teóricas para usar a função de perda Log Loss em tarefas de classificação.
05. Método da máxima verossimilhança e regressão logística
Como prometido no início, o artigo está repleto de exemplos simples. No estúdio, mais um exemplo e os antigos convidados — os tomadores de empréstimos do banco: Vasya, Fedya e Lesha.
Para não nos esquecermos, antes de desenvolver o exemplo, lembro que na vida real lidamos com um conjunto de dados de milhares ou milhões de objetos com dezenas ou centenas de características. No entanto, aqui os números foram escolhidos para que fossem fáceis de entender para um iniciante em ciência de dados.
Voltando ao exemplo. Suponha que o diretor do banco decidiu conceder crédito a todos os necessitados, apesar de o algoritmo ter indicado que não deveria conceder a Alex. E assim passou tempo suficiente para que soubéssemos quem dos três heróis pagou o crédito e quem não pagou. Como era de se esperar: Vasya e Fedya pagaram o crédito, enquanto Alex não. Agora, vamos imaginar que esse resultado se tornará um novo conjunto de dados de treinamento e, ao mesmo tempo, que aparentemente todos os dados sobre os fatores que influenciam a probabilidade de pagamento do crédito (o salário do tomador, o valor da parcela mensal) desapareceram. Então, intuitivamente, podemos supor que um em cada três tomadores não devolve o crédito ao banco, ou, em outras palavras, a probabilidade de devolução do crédito pelo próximo tomador  . Esta suposição intuitiva tem confirmação teórica e é baseada em método de máxima verossimilhança, frequentemente referido na literatura como princípio da máxima verossimilhança.
Para começar, familiarizemo-nos com a terminologia.
A verossimilhança da amostra é a probabilidade de obter exatamente essa amostra, de obter exatamente essas observações/resultados, ou seja, o produto das probabilidades de obter cada um dos resultados da amostra (por exemplo, se o crédito foi pago ou não por Vasya, Fedya e Alex simultaneamente).
A função de verossimilhança relaciona a verossimilhança da amostra com os valores dos parâmetros da distribuição.
No nosso caso, o conjunto de dados de treinamento representa uma generalização do esquema de Bernoulli, onde a variável aleatória assume apenas dois valores:  ou
 . Portanto, a verossimilhança da amostra pode ser registrada como uma função de verossimilhança em relação ao parâmetro
 da seguinte forma:


A representação acima pode ser interpretada da seguinte maneira. A probabilidade conjunta de que Vasya e Fedya paguem o crédito é igual a  , a probabilidade de que Alex NÃO pague o crédito é igual a
 uma vez que ocorreu exatamente o NÃO pagamento do crédito, portanto, a probabilidade conjunta de todos os três eventos é igual a
 .
Método de máxima verossimilhança é um método de estimativa de um parâmetro desconhecido através da maximização da função de verossimilhança. No nosso caso, é necessário encontrar tal valor  , onde
 atinge o máximo.
De onde vem, na verdade, a ideia de buscar o valor de um parâmetro desconhecido, no qual a função de verossimilhança atinge o máximo? As origens da ideia decorrem da percepção de que a amostra é a única fonte de conhecimento disponível sobre a população total. Tudo o que sabemos sobre a população total está representado na amostra. Portanto, tudo o que podemos dizer é que a amostra é o reflexo mais preciso da população total que temos. Assim, precisamos encontrar um parâmetro em que a amostra existente se torna a mais provável.
Evidentemente, estamos lidando com um problema de otimização, onde é necessário encontrar o ponto de extremum da função. Para encontrar o ponto de extremum, é necessário considerar a condição de primeira ordem, ou seja, igualar a derivada da função a zero e resolver a equação em relação ao parâmetro procurado. No entanto, buscar a derivada de um produto de muitos fatores pode ser demorado, e para evitar isso, existe uma técnica especial — a transição para o logaritmo. da função de verossimilhança. Por que essa transição é possível? Vamos notar que estamos buscando não o próprio extremum da função , mas o ponto de extremum, ou seja, aquele valor do parâmetro desconhecido
 , onde
 atinge o máximo. Ao fazer a transição para o logaritmo, o ponto de extremum não muda (embora o próprio extremum seja diferente), já que o logaritmo é uma função monótona.
Assim, de acordo com o que foi exposto, continuaremos a desenvolver nosso exemplo com os créditos de Vassya, Fedya e Alyosha. Para começar, vamos passar para o logaritmo da função de verossimilhança.:

Agora podemos facilmente derivar a expressão em relação a  :

E, finalmente, consideramos a condição de primeira ordem — igualamos a derivada da função a zero:

Assim, nossa estimativa intuitiva da probabilidade de pagamento do empréstimo  foi teoricamente fundamentada.
Ótimo, mas o que devemos fazer agora com essa informação? Se considerarmos que um em cada três mutuários não devolverá o dinheiro ao banco, o banco inevitavelmente irá à falência. Assim é, mas ao avaliar a probabilidade de pagamento do empréstimo como igual a  não levamos em conta os fatores que afetam o retorno do empréstimo: o salário do tomador e o valor da parcela mensal. Lembremos que anteriormente calculamos a probabilidade de retorno do empréstimo por cada cliente considerando esses mesmos fatores. É lógico que as probabilidades resultantes não são uma constante igual a
 .
Vamos definir a verossimilhança das amostras:
Código para cálculos de verossimilhança das amostras
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Verossimilhança da amostra quando p=2/3 constante:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Verossimilhança da amostra quando calculada com p:', round(likelihood(y,p_log_response),3)
Verossimilhança da amostra com valor constante  :

Verossimilhança da amostra ao calcular a probabilidade de pagamento do empréstimo considerando os fatores  :


A verossimilhança da amostra com a probabilidade calculada dependendo dos fatores foi maior do que a verossimilhança com o valor constante da probabilidade. O que isso significa? Isso significa que o conhecimento sobre os fatores permitiu ajustar mais precisamente a probabilidade de pagamento do empréstimo para cada cliente. Portanto, ao conceder um novo empréstimo, o mais correto seria usar o modelo de avaliação da probabilidade de pagamento da dívida proposto no final do 3º capítulo do artigo.
Mas então, se precisamos maximizar a função de verossimilhança da amostra, por que não usar algum algoritmo que fornecerá probabilidades para Vasya, Fedya e Lesha, por exemplo, iguais a 0.99, 0.99 e 0.01, respectivamente. Talvez tal algoritmo funcione bem no conjunto de treinamento, pois aproximará o valor da verossimilhança da amostra  , mas, em primeiro lugar, tal algoritmo provavelmente enfrentará dificuldades em termos de capacidade de generalização, e em segundo lugar, esse algoritmo não será linear de modo algum. E se os métodos para combater o sobreajuste (ou seja, a fraca capacidade de generalização) claramente não estão incluídos no escopo deste artigo, então vamos abordar o segundo ponto com mais detalhes. Para isso, basta responder a uma pergunta simples. A probabilidade de um empréstimo ser pago por Vasya e Fedya pode ser a mesma considerando os fatores que conhecemos? Do ponto de vista da lógica saudável, com certeza não pode. Assim, Vasya pagará 2,5% de seu salário por mês para o empréstimo, enquanto Fedya pagará quase 27,8%. Além disso, no gráfico 2 'Classificação de Clientes' vemos que Vasya está significativamente mais distante da linha que separa as classes do que Fedya. E, finalmente, sabemos que a função
 para Vasya e Fedya assume valores diferentes: 4,24 para Vasya e 1,0 para Fedya. Se Fedya, por exemplo, ganhasse significativamente mais ou pedisse um empréstimo menor, então as probabilidades de pagamento do empréstimo de Vasya e Fedya seriam semelhantes. Em outras palavras, a dependência linear não pode ser enganada. E se realmente tivéssemos calculado os coeficientes
 , e não os tivéssemos tirado do nada, poderíamos afirmar com confiança que nossos valores
 são os melhores para avaliar a probabilidade de pagamento do empréstimo por cada mutuário, mas como concordamos em considerar que a determinação dos coeficientes
 foi realizada de acordo com todas as regras, então devemos considerar — nossos coeficientes permitem fornecer a melhor estimativa da probabilidade 🙂
No entanto, nos desviamos do assunto. Neste episódio, precisamos entender como o vetor de pesos  , que é necessário para avaliar a probabilidade de retorno do empréstimo por cada mutuário, é determinado.
Resumindo de forma breve, com qual arsenal estamos indo em busca dos coeficientes  :
1. Supomos que a dependência entre a variável-alvo (o valor previsto) e o fator que influencia o resultado é linear. Por essa razão, aplicamos a função de regressão linear do tipo  , cuja linha divide os objetos (clientes) em classes
 e
 ou
 (clientes capazes de pagar o empréstimo e aqueles que não são capazes). No nosso caso, a equação tem a forma
 .
2. Usamos a função de transformação logit inversa do tipo  para determinar a probabilidade de pertencimento de um objeto à classe
 .
3. Consideramos nossa amostra de treinamento como uma realização generalizada esquemas de Bernoulli, ou seja, para cada objeto é gerada uma variável aleatória que com probabilidade  (sua para cada objeto) assume o valor 1 e com probabilidade
 – 0.
4. Sabemos que precisamos maximizar a função de verossimilhança da amostra considerando os fatores aceitos para que a amostra existente se torne a mais plausível. Em outras palavras, precisamos ajustar os parâmetros para que a amostra seja a mais plausível possível. No nosso caso, o parâmetro ajustado é a probabilidade de amortização do crédito  , que, por sua vez, depende de coeficientes desconhecidos
 . Então, precisamos encontrar o vetor de pesos
 , para o qual a verossimilhança da amostra será máxima.
5. Sabemos que para maximizar a função de verossimilhança da amostra podemos usar o método da máxima verossimilhança. E sabemos todos os truques para trabalhar com esse método.
Aí está, um verdadeiro quebra-cabeça 🙂
E agora, vamos recordar que no início do artigo queríamos derivar dois tipos de função de perda Logistic Loss dependendo de como as classes de objetos são designadas. É comum que em tarefas de classificação com duas classes, as classes sejam designadas como  e
 ou
 . Dependendo da designação, a função de perda correspondente será gerada.
Caso 1. Classificação de objetos em e
 e

Anteriormente, ao determinar a verossimilhança da amostra, na qual a probabilidade de amortização da dívida pelo tomador de crédito era calculada com base em fatores e coeficientes definidos  , aplicamos a fórmula:

Na verdade  é o valor da função de resposta logística
 com um vetor de pesos definido

Então, nada nos impede de escrever a função de verossimilhança da amostra assim:

Às vezes, é difícil para alguns analistas iniciantes entender como essa função funciona. Vamos considerar 4 exemplos curtos que irão esclarecer tudo:
1. Se  (ou seja, de acordo com a amostra de treinamento, o objeto pertence à classe +1), enquanto nosso algoritmo
 determina a probabilidade de atribuição do objeto à classe
 igual a 0.9, então essa parte da verossimilhança da amostra será calculada assim:

2. Se  , e
 , então o cálculo será assim:

3. Se  , e
 , então o cálculo será assim:

4. Se  , e
 , então o cálculo será assim:

É evidente que a função de verossimilhança será maximizada nos casos 1 e 3 ou, em geral, quando os valores de probabilidade de atribuição do objeto à classe forem acertados  .
Em razão de que, ao determinar a probabilidade de atribuição do objeto à classe  não conhecemos apenas os coeficientes
 , então vamos procurá-los. Como mencionado anteriormente, essa é uma tarefa de otimização, na qual primeiro precisamos encontrar a derivada da função de verossimilhança em relação ao vetor de pesos
 . No entanto, é sensato simplificar a tarefa: vamos buscar a derivada do logaritmo da função de verossimilhança.

Por que após o logaritmo, em função de erro logístico, trocamos o sinal de  para
 . É simples, pois nas tarefas de avaliação da qualidade do modelo é comum minimizar o valor da função, então multiplicamos a parte direita da expressão por
 e, portanto, ao invés de maximizar, agora estamos minimizando a função.
Na verdade, agora, diante de vocês, foi elaborada de forma dolorosa a função de perda — Logistic Loss para um conjunto de dados de treinamento com duas classes:  e
 .
Agora, para encontrar os coeficientes, precisamos apenas calcular a derivada função de erro logístico e, em seguida, usando métodos numéricos de otimização, como o gradiente descendente ou o gradiente estocástico, ajustar os coeficientes mais otimizados  . Mas, considerando o já considerável volume do artigo, sugiro que façam a diferenciação por conta própria ou, talvez, isso seja tema para o próximo artigo com mais aritmética sem exemplos tão detalhados.
Caso 2. Classificação de objetos em e
 e

A abordagem será a mesma que com as classes  e
 , mas a própria trilha para deduzir a função de perda Logistic Loss, será mais tortuosa. Vamos lá. Usaremos para a função de verossimilhança o operador «se…, então…». Ou seja, se
 -ésimo objeto pertence à classe
 , então para calcular a verossimilhança da amostra, usamos a probabilidade
 , se o objeto pertence à classe
 , então substituímos na verossimilhança
 . Assim é como a função de verossimilhança se apresenta:

Vamos explicar de forma simples como isso funciona. Vamos considerar 4 casos:
1. Se  e
 , então a verossimilhança da amostra «irá»

2. Se  e
 , então a verossimilhança da amostra «irá»

3. Se  e
 , então a verossimilhança da amostra «irá»

4. Se  e
 , então a verossimilhança da amostra «irá»

É evidente que nos casos 1 e 3, quando as probabilidades eram corretamente determinadas pelo algoritmo, a função de verossimilhança será maximizada, ou seja, era exatamente isso que queríamos obter. No entanto, essa abordagem é bastante volumosa e em seguida veremos uma notação mais compacta. Mas primeiro, logarítmamos a função de verossimilhança, trocando o sinal, pois agora vamos minimizar.

Substituímos em vez de  a expressão
 :

Vamos simplificar o termo à direita do logaritmo, utilizando técnicas aritméticas simples, e obteremos:

Agora é hora de nos livrarmos do operador «se…, então…». Observe que quando o objeto  pertence à classe
 , então na expressão sob o logaritmo, no denominador,
 é elevado à potência
 , se o objeto pertence à classe
 , então $e$ é elevado à potência
 . Portanto, podemos simplificar a escrita da potência — combinando ambos os casos em um só:
 . Então a função de erro logístico assumirá a forma:

De acordo com as regras de logaritmização, invertemos a fração e retiramos o sinal " " (menos) para fora do logaritmo, obtendo:

Você está diante da função de perda logistic Loss, que é aplicada em conjuntos de treinamento com objetos pertencentes às classes:  e
 .
Bem, nesse momento me despeço e concluímos o artigo.
O trabalho anterior do autor — "Colocando a equação de regressão linear em forma matricial"
Materiais auxiliares
1. Literatura
1) Análise de Regressão Aplicada / N. Draper, G. Smith – 2ª ed. – Moscovo: Finanças e Estatística, 1986 (tradução do inglês)
2) Teoria das Probabilidades e Estatística Matemática / V.E. Gmurrman – 9ª ed. – Moscovo: Escola Superior, 2003
3) Teoria das Probabilidades / N.I. Chernova – Novosibirsk: Universidade Estadual de Novosibirsk, 2007
4) Análise de Negócios: dos dados ao conhecimento / Paklin N. B., Oreshkov V. I. – 2ª ed. – São Petersburgo: Piter, 2013
5) Ciência de Dados: A Ciência dos Dados do zero / Joel Gras – São Petersburgo: BKH Petersburgo, 2017
6) Estatística Prática para Especialistas em Ciência de Dados / P.Bruce, E.Bruce – São Petersburgo: BKH Petersburgo, 2018
2. Aulas, cursos (vídeos)
1)
2)
3)
4)
5)
3. Fontes da Internet
1)
2)
3)
4)
5)
6)
7)
8)
Fonte: habr.com
