

Este artigo foi escrito para ajudar a escolher a solução mais adequada e entender as diferenças entre SDS como Gluster, Ceph e Vstorage (Virtuozzo).
O texto utiliza links para artigos com uma descrição mais detalhada de certos problemas, portanto, as descrições serão o mais concisas possível, utilizando os pontos-chave sem enrolações e informações introdutórias, que você poderá, se desejar, buscar na internet.
Na verdade, os temas abordados requerem um tom textual adequado, mas no mundo moderno, cada vez mais pessoas não gostam de ler muito))), então pode-se ler rapidamente e fazer uma escolha, e se algo não estiver claro, percorrer os links ou pesquisar as palavras desconhecidas))), e este artigo atua como uma embalagem transparente para esses temas profundos, mostrando o conteúdo – os principais pontos-chave de cada solução.
Gluster
Vamos começar com Gluster, que é amplamente utilizado por fabricantes de plataformas hiperconvergentes com SDS baseado em open source para ambientes virtuais e pode ser encontrado no site da RedHat, na seção de armazenamento, onde é oferecido escolher entre duas opções de SDS: Gluster ou Ceph.
Gluster é composto por uma pilha de tradutores – serviços que realizam todas as tarefas de distribuição de arquivos, etc. Brick – é o serviço que gerencia um disco, Volume – é o volume (pool) que agrupa esses bricks. Em seguida, há o serviço de distribuição de arquivos por grupos, através da função DHT (tabela hash distribuída). Não vamos incluir o serviço de Sharding na descrição, pois nas links abaixo haverá uma descrição dos problemas relacionados a ele.
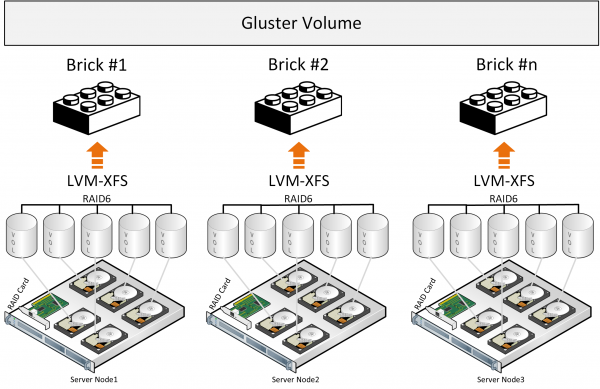
Ao gravar, o arquivo inteiro é armazenado em um brick e sua cópia é escrita paralelamente em um brick em um segundo servidor. Em seguida, o segundo arquivo será gravado em um segundo grupo de dois bricks (ou mais) em diferentes servidores.
Se os arquivos forem aproximadamente do mesmo tamanho e o volume consistir apenas em um grupo, tudo funciona bem, mas sob outras condições surgirão os seguintes problemas descritos:
- o espaço nos grupos é utilizado de forma desigual, dependendo dos tamanhos dos arquivos; se não houver espaço suficiente em um grupo para gravar um arquivo – você receberá um erro, o arquivo não será gravado e não será redistribuído para outro grupo;
- ao gravar um único arquivo, a IO é direcionada apenas para um grupo, os outros ficam ociosos;
- não é possível obter a IO de todo o volume ao gravar um único arquivo;
- e o conceito geral parece menos eficiente devido à falta de distribuição de dados em blocos, onde é mais fácil realizar o balanceamento e resolver o problema da distribuição uniforme, ao invés de como agora o arquivo é colocado em um bloco inteiro.
Da descrição oficial também vem a compreensão de que o Gluster funciona como um armazenamento de arquivos sobre um RAID de hardware clássico. Houve tentativas de desenvolver a divisão (Sharding) de arquivos em blocos, mas tudo isso é um acréscimo que impõe perdas de desempenho ao já existente modelo arquitetônico, além do uso de componentes de código aberto com limitações de desempenho como o Fuse. Não há serviços de metadados, o que restringe as capacidades de desempenho e resiliência do armazenamento ao distribuir arquivos em blocos. Melhores índices de desempenho podem ser observados na configuração “Distributed Replicated” e o número de nós deve ser de pelo menos 6 para organizar uma réplica confiável 3 com uma distribuição de carga otimizada.
Essas conclusões também estão relacionadas à descrição da experiência de uso e ao comparar com , e também há uma descrição da experiência que leva à compreensão dessa configuração mais eficiente e mais confiável
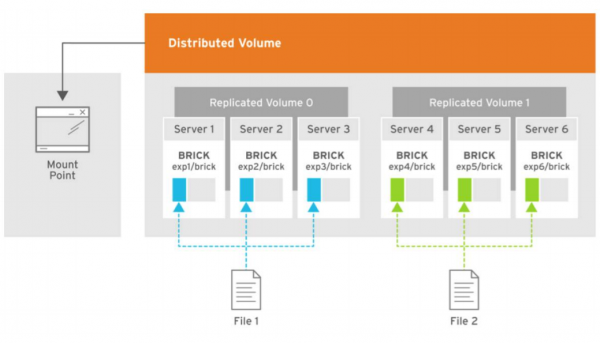
Na imagem, é mostrado o balanceamento de carga ao gravar dois arquivos, onde as cópias do primeiro arquivo são distribuídas entre os três primeiros servidores, que estão agrupados no volume 0, e as três cópias do segundo arquivo são colocadas no segundo grupo volume1 de três servidores. Cada servidor tem um disco.
A conclusão geral é que o Gluster pode ser usado, mas com a compreensão de que existem limitações em desempenho e resiliência, que criam dificuldades em certas condições de soluções hiperconvergentes, onde os recursos também são necessários para cargas computacionais de ambientes virtuais.
Existem também alguns índices de desempenho do Gluster que podem ser alcançados sob certas condições, limitando-se em
Ceph
Agora vamos considerar o Ceph a partir das descrições da arquitetura que consegui Também há uma comparação entre , onde se pode entender imediatamente que o Ceph é preferível para ser implantado em servidores separados, pois seus serviços precisam de todos os recursos de hardware sob carga.
Arquitetura é mais complexo que o Gluster e inclui serviços como serviços de metadados, mas todo o conjunto de componentes é bastante complicado e não muito flexível para ser utilizado em soluções de virtualização. Os dados são organizados em blocos, o que parece mais eficiente, mas existem perdas e latência na hierarquia de todos os serviços (componentes) em determinadas cargas e condições de falha, como no exemplo a seguir.
Pela descrição da arquitetura, o CRUSH é o coração do sistema, responsável por determinar a localização dos dados. Em seguida, temos os PGs — a abstração mais complexa (grupo lógico) para entendimento. Os PGs são necessários para que o CRUSH seja mais eficaz. A principal função dos PGs é agrupar objetos para reduzir o consumo de recursos, aumentar o desempenho e a escalabilidade. Abordar objetos individualmente, sem agrupá-los em PGs, seria muito dispendioso. OSD é o serviço para cada disco individual.
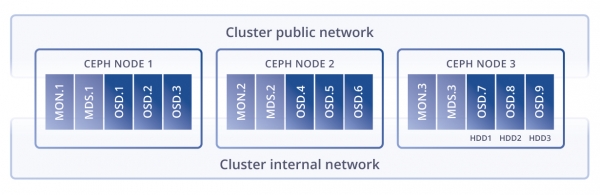
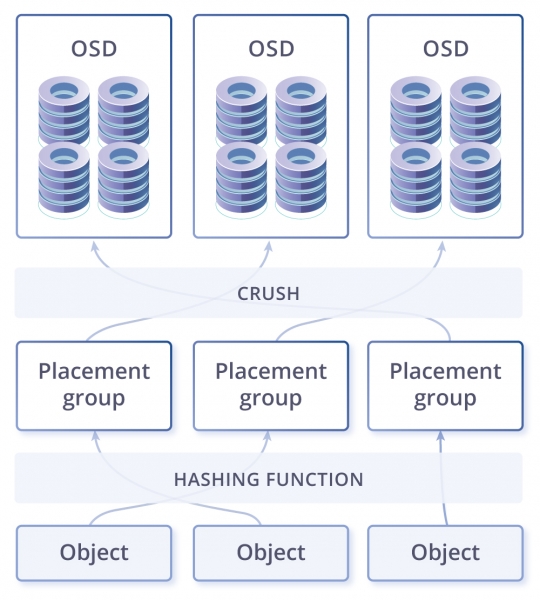
Um cluster pode ter um ou mais pools de dados com diferentes finalidades e configurações. Os pools são divididos em grupos de colocação. Os grupos de colocação armazenam objetos que os clientes acessam. Nesse nível lógico, a estrutura termina e começa o nível físico, pois cada grupo de colocação está vinculado a um disco principal e vários discos de réplica (a quantidade depende do fator de replicação do pool). Em outras palavras, em nível lógico, um objeto é armazenado em um grupo de colocação específico, enquanto, no nível físico, é armazenado nos discos a ele vinculados. Esses discos podem fisicamente estar em diferentes nós ou até mesmo em diferentes datacenters.
Neste esquema, os grupos de placement aparecem como um nível necessário para a flexibilidade de toda a solução, mas ao mesmo tempo, como um elo desnecessário nessa cadeia, o que inevitavelmente suscita preocupações sobre a perda de desempenho. Por exemplo, ao gravar dados, o sistema precisa dividi-los nesses grupos e, em seguida, no nível físico, nos discos principais e nas réplicas. Isso significa que a função hash opera durante a busca e a inserção do objeto, mas há um efeito colateral – é uma despesa muito grande e limitações na reconstrução do hash (quando um disco é adicionado ou removido). Outro problema do hash é a localização fixa dos dados, que não pode ser alterada. Ou seja, se um disco em particular estiver sob uma carga elevada, o sistema não tem a possibilidade de não gravar nele (escolhendo outro disco); a função hash obriga a distribuir os dados de acordo com a regra, independentemente de quão mal o disco está se saindo. Por isso, o Ceph consome muita memória durante a reestruturação dos PG em caso de auto-recuperação ou aumento do armazenamento. Portanto, a conclusão é que o Ceph funciona bem (embora lentamente), mas apenas na ausência de escalabilidade, situações de emergência e atualizações.
Existem, é claro, opções para aumentar o desempenho por meio de cache e cache-tiering, mas isso requer hardware de qualidade e ainda assim haverá perdas. No geral, o Ceph parece mais atraente do que o Gluster para produtividade. Além disso, ao usar esses produtos, é necessário considerar um fator importante – o alto nível de competências, experiência e profissionalismo com grande ênfase em Linux, já que é crucial configurar, ajustar e manter tudo corretamente, o que impõe ainda mais responsabilidade e carga ao administrador.
Vstorage
A arquitetura se apresenta ainda mais interessante em , que pode ser usada conjuntamente com o hypervisor nos mesmos nós, no mesmo , mas é muito importante configurá-la corretamente para obter um bom desempenho. Ou seja, implementar um produto desse tipo de forma padrão em qualquer configuração, sem levar em consideração as recomendações de acordo com a arquitetura, será muito fácil, mas não produtivo.
O que pode coexistir para armazenamento ao lado dos serviços do hipervisor kvm-qemu, que é apenas alguns serviços onde se encontrou uma hierarquia de componentes compacta e otimizada: serviço do cliente montado via FUSE (modificado, não open source), serviço de metadados MDS (Metadata service), serviço de blocos de dados Chunk service, que no nível físico é igual a um disco e isso é tudo. Em termos de velocidade, é claro que o ideal é usar um esquema de alta disponibilidade com duas réplicas, mas se forem utilizados armazenamento em cache e logs em discos SSD, a codificação à prova de falhas (erase coding ou raid6) pode ser bastante acelerada em um esquema híbrido ou ainda melhor em all flash. Com EC (erase coding), existe uma desvantagem: ao modificar um bloco de dados, é necessário recalcular as somas de paridade. Para evitar perdas nessa operação, o Ceph escreve em EC de forma adiada e problemas de desempenho podem ocorrer em determinados pedidos, quando, por exemplo, é necessário calcular todos os blocos, ao passo que no caso do Virtuozzo Storage, a gravação dos blocos alterados é feita usando a abordagem de “sistema de arquivos estruturado em logs”, o que minimiza os custos com cálculos de paridade. Para estimar aproximadamente as opções de aceleração de desempenho com EC e sem, existe Os números podem ser aproximados, dependendo do coeficiente de precisão do fabricante do hardware, mas o resultado dos cálculos ajuda bastante na configuração planejada.
Um esquema simples de componentes de armazenamento não significa que esses componentes não consomem mas se todos os custos forem calculados com antecedência, é possível contar com o funcionamento conjunto ao lado do hipervisor.
Há um esquema de comparação do consumo de recursos de hardware pelos serviços do Ceph e do Virtuozzo Storage.
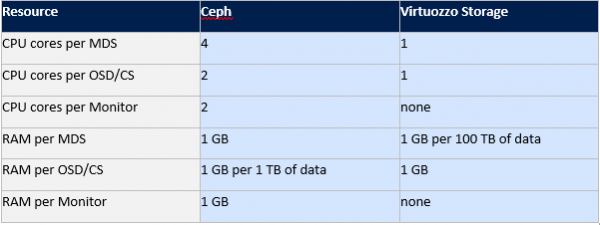
Se anteriormente era possível comparar Gluster e Ceph por meio de artigos antigos, usando as linhas mais importantes deles, com o Virtuozzo é mais complicado. Não há muitos artigos sobre esse produto e a informação pode ser obtida apenas na documentação sobre ou em russo se considerarmos o Vstorage como um armazenamento utilizado em algumas soluções hiperconvergentes em empresas como e Acronis.
Vou tentar ajudar com a descrição dessa arquitetura, portanto o texto será um pouco mais extenso, mas para entender a documentação é necessário muito tempo, e a documentação existente pode ser usada apenas como um manual através da revisão do índice ou busca por palavras-chave.
Vamos considerar o processo de gravação em uma configuração híbrida de hardware com os componentes acima descritos: a gravação começa no nó de onde foi iniciada pelo cliente (serviço de ponto de montagem FUSE), mas o componente do serviço mestre de metadados (MDS) certamente direcionará o cliente diretamente para o serviço de chunk necessário (serviço de armazenamento de blocos CS), ou seja, o MDS não participa do processo de gravação, apenas direciona para o serviço de chunk necessário. De maneira geral, pode-se fazer uma analogia com a gravação sendo semelhante ao derramamento de água em barris. Cada barril representa um bloco de dados de 256MB.
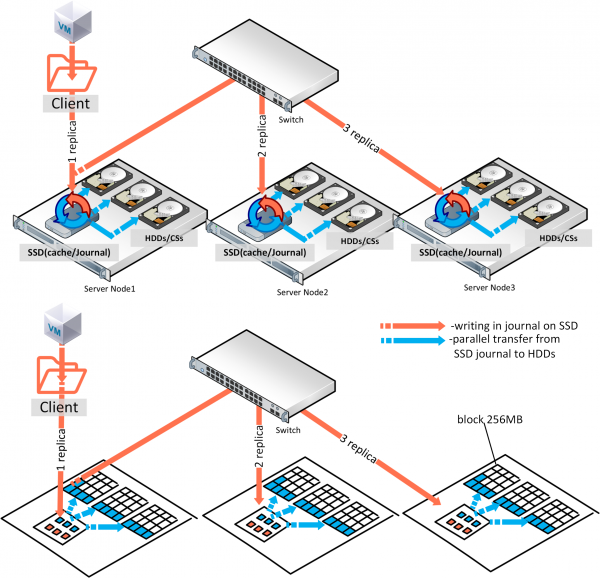
Ou seja, um disco é uma certa quantidade desses barris, ou seja, o volume do disco dividido por 256MB. Cada cópia é distribuída em um nó, a segunda praticamente em paralelo já em outro nó, e assim por diante… Se temos três réplicas e discos SSD para cache (para leitura e logs de gravação), a confirmação de gravação ocorrerá após a gravação do log no SSD, enquanto o descarregamento paralelo do SSD continuará no HDD, como que em segundo plano. No caso de três réplicas, o commit de gravação será após a confirmação do SSD do terceiro nó. Pode parecer que a soma da velocidade de gravação dos três SSDs pode ser dividida por três e obteremos a velocidade de gravação de uma réplica, mas a gravação das cópias ocorre em paralelo e a latência da rede geralmente é mais alta do que a dos SSDs, e de fato, o desempenho da gravação dependerá da rede. Portanto, para ver IOPS reais, é necessário sobrecarregar corretamente todo o Vstorage de acordo com , ou seja, testando a carga real, e não a memória e o cache, onde é preciso considerar o tamanho correto do bloco de dados, o número de fluxos, etc.
O diário de registro mencionado acima no SSD funciona de forma que, assim que os dados são gravados nele, são imediatamente lidos pelo serviço e escritos no HDD. Existem vários serviços de metadados (MDS) por cluster, e sua quantidade é determinada pelo quórum que opera com o algoritmo Paxos. Do ponto de vista do cliente, o ponto de montagem FUSE é uma pasta de armazenamento em cluster, que é visível simultaneamente para todos os nós do cluster, cada nó monta o cliente desse modo, portanto, esse armazenamento está acessível para cada nó.
Para o desempenho de qualquer uma das abordagens mencionadas acima, é muito importante, na fase de planejamento e implantação, configurar corretamente a rede, onde haverá balanceamento por meio da agregação e uma largura de banda de canal de rede adequadamente escolhida. Na agregação, é fundamental escolher corretamente o modo de hash e os tamanhos dos quadros. Também há uma diferença significativa em relação aos SDS mencionados acima: é o fuse com a tecnologia fast path no Virtuozzo Storage. Que, além do fuse modernizado, ao contrário de outras soluções open source, aumenta significativamente os IOPS e permite não se limitar à escalabilidade horizontal ou vertical. Em geral, em comparação com as arquiteturas mencionadas, esta parece ser mais robusta, mas para tal prazer, é claro que é necessário adquirir licenças, ao contrário do Ceph e do Gluster.
Em resumo, pode-se destacar os três principais: o primeiro lugar em termos de desempenho e confiabilidade da arquitetura é ocupado pelo Virtuozzo Storage, o segundo pelo Ceph e o terceiro pelo Gluster.
Os critérios pelos quais o Virtuozzo Storage foi escolhido são: um conjunto otimizado de componentes da arquitetura, o fuse modernizado com fast path, um conjunto flexível de configuração de hardware, menor consumo de recursos e a possibilidade de compartilhamento com computação (virtualização), ou seja, é completamente adequado para uma solução hiperconvergente, da qual ele faz parte. O segundo lugar é do Ceph, pois esta é uma arquitetura mais produtiva em relação ao Gluster, devido à operação com blocos, assim como cenários mais flexíveis e a possibilidade de trabalhar em clusters mais escaláveis.
Nos planos está a vontade de escrever uma comparação entre vSAN, Space Direct Storage, Vstorage e Nutanix Storage, testando o Vstorage em equipamentos da HPE, Huawei, bem como cenários de integração do Vstorage com sistemas de armazenamento externo, portanto, se você gostou do artigo, seria bom receber seu feedback, que poderia aumentar a motivação para novos artigos considerando suas observações e sugestões.
Fonte: habr.com
