

Olá, Habr.
Meu nome é Misha Butrimov e eu gostaria de falar um pouco sobre Cassandra. Minha explicação será útil para aqueles que nunca trabalharam com bancos de dados NoSQL, pois ela possui muitas particularidades e armadilhas que você precisa conhecer. E se você só conheceu bancos de dados relacionais como o Oracle, essas informações poderão salvá-lo.
O que torna Cassandra boa? É um banco de dados NoSQL projetado sem um único ponto de falha, que escala muito bem. Se você precisar adicionar alguns terabytes a algum banco, você simplesmente adiciona nós ao cluster. Expandir para mais um data center? Adiciona nós ao cluster. Aumentar as requisições por segundo (RPS) que está sendo processado? Adiciona nós ao cluster. É recíproco também.
Quais são suas outras qualidades? A capacidade de processar muitas requisições. Mas o que significa 'muitas'? 10, 20, 30, 40 mil requisições por segundo é pouco. 100 mil requisições por segundo para gravação também é. Existem empresas que afirmam que conseguem suportar 2 milhões de requisições por segundo. Essas devem ser acreditadas.
E no geral, Cassandra tem uma grande diferença em relação aos dados relacionais — ela não se parece com eles de forma alguma. E isso é algo muito importante a se lembrar.
Nem tudo que parece igual funciona da mesma forma.
Certa vez, um colega veio até mim e perguntou: 'Aqui está a linguagem de consulta SQL do Cassandra, contém instruções select, where e and. Estou digitando e não funciona. Por quê?'. Se você tratar Cassandra como um banco de dados relacional, estará se direcionando para um autoesquartejamento brutal. E não estou promovendo isso, isso é proibido na Rússia. Você simplesmente projetará algo errado.
Por exemplo, um cliente vem até nós e diz: 'Vamos construir um banco de dados para séries, ou um banco de dados para um guia de receitas. Teremos pratos com ingredientes ou uma lista de séries e os atores nelas'. Nós respondemos com entusiasmo: 'Vamos lá!'. São só dois bytes para transferir, algumas tabelas e tudo pronto, funcionará rápido e de forma confiável. E tudo vai muito bem, até que os clientes aparecem e dizem que as donas de casa também estão tentando resolver o inverso: elas têm uma lista de ingredientes e querem saber qual prato podem cozinhar. Você está ferrado.
Tudo isso porque Cassandra é um banco de dados híbrido: ele é ao mesmo tempo um key value e armazena dados em colunas largas. Se falarmos na linguagem Java ou Kotlin, isso poderia ser descrito assim:
Map<RowKey, SortedMap<ColumnKey, ColumnValue>>
Ou seja, um mapa, dentro do qual existe também um mapa ordenado. A primeira chave deste mapa é a Row key ou Partition key — a chave de partição. A segunda chave, que é a chave para o mapa já ordenado, é a Clustering key.
Para ilustrar a distribuição do banco de dados, vamos desenhar três nós. Agora precisamos entender como distribuir os dados entre os nós. Porque se formos colocar tudo em um só (podendo haver mil, duas mil, cinco — quantas quisermos), isso não é realmente sobre distribuição. Portanto, precisamos de uma função matemática que retorne um número. Apenas um número, um inteiro longo, que cairá em algum intervalo. E teremos um nó responsável por um intervalo, o segundo — por outro, e assim por diante.
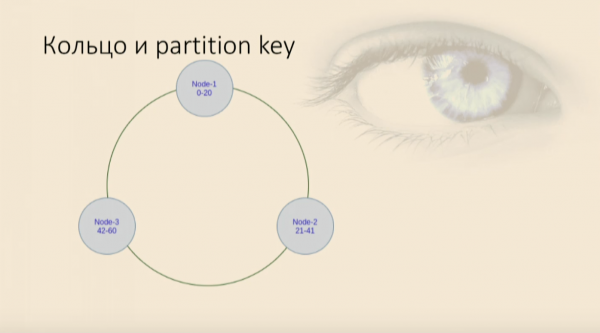
Esse número é obtido através de uma função hash, que é aplicada exatamente sobre o que chamamos de Partition key. Esta é a coluna indicada na diretiva Primary key, e esta é a coluna que será a primeira e mais importante chave do mapa. Ela determina quais dados vão para qual nó. A tabela é criada no Cassandra quase com a mesma sintaxe que no SQL:
CREATE TABLE users (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY(user_id)

)
A chave primaria, neste caso, consiste em uma coluna, e ela também é a chave de partição.
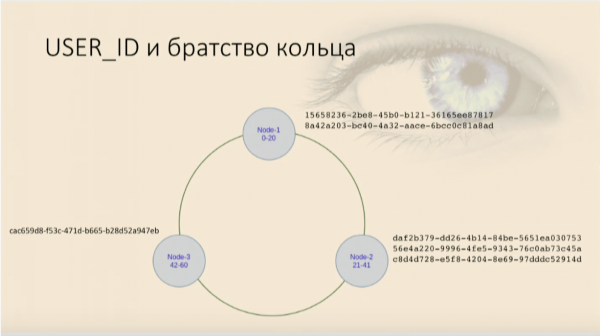
Como os usuários estarão distribuídos? Parte irá para um nó, parte para outro e parte para o terceiro. Isso resulta em uma tabela hash comum, que também é um mapa, que em Python é um dicionário, que também é uma estrutura simples Key value, da qual podemos ler todos os valores, lendo e escrevendo por chave.
Select: quando allow filtering se transforma em full scan, ou como não fazer
Vamos escrever alguma instrução select: select * from users where userid = . Parece que estamos lidando com o Oracle: escrevemos um select, especificamos as condições e tudo funciona, os usuários são obtidos. Mas se escolhermos, por exemplo, um usuário com um determinado ano de nascimento, o Cassandra reclama que não consegue executar a consulta. Porque ele não sabe nada sobre como estão distribuídos os dados do ano de nascimento — tem apenas uma coluna como chave. Então ele diz: "Está bem, ainda posso executar essa consulta. Adicione allow filtering". Nós adicionamos a diretiva, tudo funciona. E nesse momento, algo terrível acontece.
Quando estamos rodando com dados de teste, tudo está perfeito. Mas quando você executa a consulta em produção, onde temos, por exemplo, 4 milhões de registros, a situação não é tão boa. Porque allow filtering é uma diretiva que permite ao Cassandra coletar todos os dados dessa tabela de todos os nós, todos de data centers (se houver muitos nesse cluster), e só depois filtrar. Isso é análogo a uma varredura completa, e duvido que alguém fique empolgado com isso.
Se precisássemos de usuários apenas por identificadores, isso seria aceitável. Mas às vezes precisamos escrever outras consultas e impor outras restrições na seleção. Portanto, lembramos: tudo isso é um mapa, que tem uma chave de particionamento, mas dentro dele — um mapa ordenado.
E ele também tem uma chave, que chamamos de Clustering Key. Essa chave, que por sua vez, é composta por colunas que escolhemos, permite que o Cassandra entenda como os dados serão fisicamente ordenados e armazenados em cada nó. Ou seja, para uma determinada Partition key, a Clustering key dirá exatamente como inserir os dados nessa árvore, qual espaço eles ocuparão.
É realmente uma árvore, onde apenas chamamos um comparador, no qual passamos um conjunto de colunas em forma de objeto, e este também é definido como uma enumeração de colunas.
CREATE TABLE users_by_year_salary_id (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY((year), salary, user_id)
Preste atenção na diretiva Primary key, onde o primeiro argumento (neste caso, o ano) sempre é o Partition key. Ele pode consistir em uma ou várias colunas, isso não importa. Se houver várias colunas, elas devem ser colocadas entre parênteses novamente para que o pré-processador da linguagem entenda que isso é de fato a Primary key, seguidas por todas as outras colunas — Clustering key. Essas colunas serão passadas no comparador na ordem em que aparecem. Ou seja, a primeira coluna é mais significativa, a segunda — menos significativa, e assim por diante. Como fazemos para data classes, por exemplo, listamos os campos no equals: indicando quais têm maior peso e quais têm menor. Em Cassandra, isso é, por assim dizer, os campos da data class, aos quais o equals escrito será aplicado.
Definimos a ordenação, impomos restrições
É importante lembrar que a ordem de ordenação (decrescente, crescente, não importa) é definida no mesmo momento em que a chave é criada, e não poderá ser alterada depois. Ela determina fisicamente como os dados serão organizados e como eles estarão armazenados. Se precisar mudar o Clustering key ou a ordem de ordenação, será necessário criar uma nova tabela e transferir os dados para ela. Não será possível fazer isso com a tabela existente.
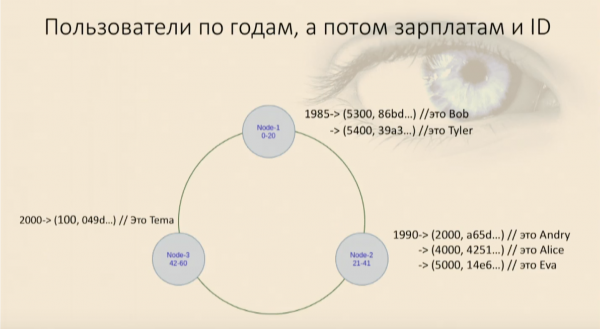
Preenchemos nossa tabela com usuários e vimos que eles foram organizados inicialmente por ano de nascimento e, em seguida, dentro de cada nó, por salário e ID de usuário. Agora podemos realizar a seleção, aplicando restrições.
Aqui está novamente o nosso funcionando onde, e, os usuários nos são fornecidos, e tudo está novamente bem. Mas se tentarmos usar apenas parte do Clustering key, sendo menos significativa, Cassandra terá um erro imediatamente, pois não consegue encontrar em nosso mapa onde está esse objeto, cujos campos para o comparador são null, e onde aquele que acabamos de definir — onde ele está. Eu terei que levantar todos os dados desse nó novamente e filtrá-los. Isso é análogo a um Full Scan dentro do nó, o que não é bom.
Em qualquer situação confusa, crie uma nova tabela
Se quisermos poder recuperar usuários por ID, idade ou salário, o que devemos fazer? Nada. Apenas use duas tabelas. Se for necessário recuperar usuários de três maneiras diferentes, teremos três tabelas. Passaram-se os tempos em que economizávamos espaço no disco rígido. Este é o recurso mais barato. Custa muito menos do que o tempo de resposta, que pode ser fatal para o usuário. É muito mais agradável para o usuário receber algo em um segundo do que em 10 minutos.
Trocamos o espaço ocupado em excesso, dados desnormalizados, pela capacidade de escalar bem e operar de forma confiável. Na verdade, um cluster que consiste em três data centers, cada um com cinco nós, com um nível aceitável de preservação de dados (onde nada é perdido), pode sobreviver à perda total de um data center. E ainda ficarão dois nós em cada um dos dois restantes. E somente após isso é que os problemas começarão. É uma boa reserva, custa alguns SSDs extras e processadores. Portanto, para usar o Cassandra, que não é SQL, e onde não há relações ou chaves externas, é preciso saber as regras simples.
Projetamos tudo a partir da consulta. O que se torna importante não são os dados, mas como o aplicativo irá trabalhar com eles. Se ele precisar acessar diferentes dados de maneiras diferentes ou os mesmos dados de maneiras variadas, devemos organizá-los da forma que seja conveniente para o aplicativo. Caso contrário, nos veremos em um Full Scan e nenhuma vantagem do Cassandra nos ajudará.
Desnormalizar dados é a norma. Esquecer as formas normais, não temos mais bancos de dados relacionais. Vamos armazenar algo 100 vezes, estará lá 100 vezes. Isso ainda é mais barato do que causar lentidão.
Escolhemos chaves para particionamento de forma que sejam bem distribuídas. Não precisamos que o hash de nossas chaves caia em um intervalo muito restrito. Ou seja, o ano de nascimento no exemplo acima é um mau exemplo. Na verdade, é um bom exemplo se os usuários por ano de nascimento estiverem bem distribuídos, e ruim se estivermos falando sobre alunos da 5ª série — não será uma boa particionamento.
A ordenação é escolhida uma vez na etapa de criação da Chave de Clusterização. Se precisar ser alterada, será necessário migrar nossa tabela com outra chave.
E o mais importante: se precisamos recuperar os mesmos dados de 100 maneiras diferentes, teremos 100 tabelas distintas.
Fonte: habr.com
