

Este artigo é sobre o Python Gateway — um projeto comunitário de código aberto para a plataforma de dados InterSystems IRIS. Este projeto permite orquestrar quaisquer algoritmos de aprendizado de máquina criados na linguagem Python (o ambiente principal para muitos Cientistas de Dados), utilizando inúmeras bibliotecas prontas para a criação rápida de soluções analíticas adaptativas e automatizadas de AI/ML na plataforma InterSystems IRIS. Neste artigo, mostrarei como o InterSystems IRIS pode orquestrar processos em Python, realizar transferência de dados bidirecional de forma eficiente e criar processos de negócios inteligentes.
Plano
- Introdução.
- Ferramentas.
- Instalação.
- API.
- Interoperabilidade.
- Jupyter Notebook.
- Conclusões.
- Links.
- MLToolkit.
Introdução
Python é uma linguagem de programação de alto nível, de propósito geral, voltada para aumentar a produtividade do desenvolvedor e a legibilidade do código. Nesta série de artigos, falarei sobre as possibilidades de aplicação da linguagem Python na plataforma InterSystems IRIS, com o foco principal deste artigo sendo a utilização do Python como linguagem para a criação e aplicação de modelos de aprendizado de máquina.
Aprendizado de máquina (ML) é uma classe de métodos de inteligência artificial, cuja característica é não resolver a tarefa diretamente, mas aprender ao resolver muitas tarefas semelhantes.
Os algoritmos e modelos de aprendizado de máquina estão se tornando cada vez mais comuns. Há muitas razões para isso, mas tudo se resume à acessibilidade, simplicidade e à obtenção de resultados práticos. A clusterização ou até mesmo a modelagem por rede neural é uma nova tecnologia?
Claro que não, mas atualmente não é necessário escrever centenas de milhares de linhas de código para executar um único modelo, e os custos para criar e aplicar modelos estão diminuindo cada vez mais.
As ferramentas estão evoluindo — enquanto não temos ferramentas de AI/ML totalmente orientadas para GUI, o progresso que observamos em muitas outras classes de sistemas de informação, como BI (desde a codificação até o uso de frameworks e soluções configuráveis orientadas a GUI), também está presente nas ferramentas de criação de AI/ML. Já passamos pela fase de codificação e hoje utilizamos frameworks para construir e treinar modelos.
Outras melhorias, como a capacidade de distribuir um modelo pré-treinado, onde o usuário final precisa apenas concluir o treinamento do modelo com seus dados específicos, também simplificam o início da aplicação de aprendizado de máquina. Essas conquistas tornam o aprendizado de máquina muito mais acessível, tanto para especialistas quanto para empresas em geral.
Por outro lado, estamos coletando cada vez mais dados. Graças a uma plataforma de dados unificada, como o InterSystems IRIS, toda essa informação pode ser imediatamente preparada e utilizada como dados de entrada para modelos de aprendizado de máquina.
Com a migração para a nuvem, iniciar projetos de IA/ML se torna mais fácil do que nunca. Podemos consumir apenas os recursos de que precisamos. Além disso, graças à paralelização oferecida pelas plataformas em nuvem, podemos economizar tempo.
Mas e quanto aos resultados? Aqui as coisas se complicam. Há uma variedade de ferramentas para construção de modelos, das quais falarei a seguir. Construir um bom modelo não é simples, mas e depois? Extração de valor do uso do modelo por parte das empresas também é uma tarefa não trivial. A raiz do problema está na separação entre cargas analíticas e transacionais, e nos modelos de dados. Quando treinamos um modelo, geralmente o fazemos com dados históricos. Mas o lugar para o modelo construído está no processamento de transações. De que adianta ter o melhor modelo de detecção de transações fraudulentas se o executamos uma vez por dia? Os fraudadores já se foram com o dinheiro. Precisamos treinar o modelo com dados históricos, mas também devemos aplicá-lo em tempo real com novos dados que chegam, para que nossos processos de negócios possam agir de acordo com as previsões feitas pelo modelo.
O ML Toolkit é um conjunto de ferramentas que tem exatamente esse objetivo: integrar modelos e ambientes transacionais, para que os modelos construídos possam ser facilmente usados diretamente em seus processos de negócios. O Python Gateway faz parte do ML Toolkit e oferece integração com a linguagem Python (da mesma forma que o R Gateway, que é parte do ML Toolkit, oferece integração com a linguagem R).
Ferramentas
Antes de prosseguirmos, gostaria de descrever algumas ferramentas e bibliotecas para Python que vamos usar mais tarde.
Tecnologias
- Python é uma linguagem de programação interpretada e de alto nível, voltada para propósitos gerais. A principal vantagem da linguagem é a vasta biblioteca de bibliotecas matemáticas, de ML e AI. Assim como o ObjectScript, é uma linguagem orientada a objetos, mas tudo é definido dinamicamente, e não estaticamente. Também, tudo é um objeto. Artigos posteriores pressupõem um conhecimento superficial da linguagem. Se você deseja começar a aprender, recomendo iniciar com .
- Para nossos próximos exercícios, instale .
- IDE: Eu uso , mas na verdade existem . Se você usa o Atelier, há um plugin do Eclipse para desenvolvedores Python. Se você usa o VS Code, há uma extensão para Python.
- Notebook: em vez de uma IDE, você pode escrever e compartilhar seus scripts em notebooks online. O mais popular deles é .
Bibliotecas
Aqui está uma lista (não completa) de bibliotecas para aprendizado de máquina:
- — um pacote fundamental para cálculos precisos.
- — estruturas de dados e ferramentas de análise de dados de alto desempenho.
- — criação de gráficos.
- — visualização de dados baseada em matplotlib.
- — métodos de aprendizado de máquina.
- — algoritmos de aprendizado de máquina dentro da metodologia de boosting de gradiente (Gradient Boosting).
- — NLP.
- — redes neurais.
- — plataforma para criação de modelos de aprendizado de máquina.
- — plataforma para criação de modelos de aprendizado de máquina, voltada para Python.
- — PMML de vários modelos.
As tecnologias AI/ML permitem que os negócios sejam mais eficientes e adaptáveis. Além disso, hoje essas tecnologias estão se tornando mais fáceis de desenvolver e implementar. Comece a aprender sobre tecnologias AI/ML e como elas podem ajudar sua organização a crescer.
Instalação
Existem várias maneiras de instalar e usar o Python Gateway:
- sistemas operacionais
- Windows
- Linux
- Mac
- Docker
- Use uma imagem do DockerHub
- Crie sua própria imagem
Independentemente do método de instalação, você precisará do código-fonte. O único lugar para baixar o código é . Ela contém lançamentos estáveis testados, é só pegar o mais recente. Até o momento, é 0.8, mas novos virão com o tempo. Não clone/carregue o repositório, baixe o último lançamento.
sistemas operacionais
Se você estiver instalando o Python Gateway no sistema operacional, primeiro (independentemente do sistema operacional) você precisa instalar o Python. Para isso:
- . É recomendado instalar o Python no diretório padrão.
- Instale o módulo
dill:pip install dill. - Baixe o código ObjectScript (ou seja,
do $system.OBJ.ImportDir("C:InterSystemsReposPythoniscpy", "*.cls", "c",,1)) em qualquer namespace com produtos. Caso você queira que um namespace existente suporte produtos, execute:write ##class(%EnsembleMgr).EnableNamespace($Namespace, 1). - Coloque para a pasta
binda sua instância InterSystems IRIS. O arquivo da biblioteca deve estar disponível no caminho retornadowrite ##class(isc.py.Callout).GetLib().
Windows
- Verifique se a variável de ambiente
PYTHONHOMEaponta para o Python 3.6.7. - Verifique se a variável de ambiente do sistema
caminhoscontém a variávelPYTHONHOME(ou o diretório para o qual ela aponta).
Linux (Debian/Ubuntu)
- Verifique se a variável de ambiente
caminhoscontém/usr/libe/usr/lib/x86_64-linux-gnu. Use o arquivo/etc/environmentpara definir as variáveis de ambiente. - Em caso de erros
undefined symbol: _Py_TrueStructdefina a configuraçãoPythonLib. Também na há uma seção de Solução de Problemas.
Mac
- Atualmente, apenas Python 3.6.7 do . Verifique a variável
caminhos.
Se você alterou as variáveis de ambiente, reinicie seu produto InterSystems.
Docker
O uso de contêineres tem várias vantagens:
- Portabilidade
- Eficiência
- Isolamento
- Leveza
- Imutabilidade
Consulte esta para obter mais informações sobre o uso do Docker com produtos InterSystems.
Todas as compilações do Python Gateway atualmente são baseadas em contêineres 2019.4.
Imagem pronta
Execute: docker run -d -p 52773:52773 --name irispy intersystemscommunity/irispy-community:latest, para baixar e iniciar o Python Gateway com a Edição Comunitária do InterSystems IRIS. E é isso.
Crie sua própria imagem
Para construir a imagem do docker, execute na raiz do repositório: docker build --force-rm --tag intersystemscommunity/irispy:latest ..
Por padrão, a imagem é construída com base na imagem store/intersystems/iris-community:2019.4.0.383.0, mas você pode alterar isso definindo a variável IMAGE.
Para construir a partir do InterSystems IRIS, execute: `docker build —build-arg IMAGE=store/intersystems/iris:2019.4.0.383.0 —force-rm —tag intersystemscommunity/irispy:latest`.
Depois disso, você pode iniciar a imagem do docker:
docker run -d
  -p 52773:52773
  -v //:/mount
  --name irispy
  intersystemscommunity/irispy:latest
  --key /mount/iris.key
Se você estiver usando uma imagem baseada na Edição Comunitária do InterSystems IRIS, pode não precisar especificar a chave.
Comentários
- O processo de teste
isc.py.test.Processsalva uma série de imagens em um diretório temporário. Você pode querer alterar esse caminho para um diretório montado. Para isso, edite a configuraçãoWorkingDirespecificando o diretório montado. - Para acessar o terminal, execute:
docker exec -it irispy sh. - Acesso ao Portal de Gerenciamento do Sistema com login
SuperUser/SYS. - Para parar o contêiner, execute:
docker stop irispy && docker rm --force irispy.
Verificação de instalação
Depois de instalar o Python Gateway, vale a pena verificar se ele está funcionando. Execute este código no terminal InterSystems IRIS:
set sc = ##class(isc.py.Callout).Setup()
set sc = ##class(isc.py.Main).SimpleString("x='HELLO'", "x", , .var).
write var
O resultado deve ser HELLO — valor da variável Python x. Se o status retornado sc é um erro ou var vazio, verifique .
API
Python Gateway está instalado, e você confirmou que ele está funcionando. Agora é hora de começar a usá-lo!
A interface principal para o Python é isc.py.Main. Ela oferece os seguintes grupos de métodos (todos retornam %Status):
- Execução de código
- Transmissão de dados
- Auxiliares
Execução de código
Esses métodos permitem executar código Python arbitrário.
SimpleString
SimpleString — é o método principal. Ele aceita 4 argumentos opcionais:
code— string de código a ser executada. O símbolo de nova linha:$c(10).returnVariable— nome da variável para retornar.serialization— como serializarreturnVariable. 0 — string (padrão), 1 — repr.result— referência ByRef para a variável na qual o valor é gravadoreturnVariable.
Acima, executamos:
set sc = ##class(isc.py.Main).SimpleString("x='HELLO'", "x", , .var).Neste exemplo, estamos atribuindo à variável Python x valor Olá e queremos retornar o valor da variável Python x para a variável ObjectScript var.
ExecuteCode
ExecuteCode é uma alternativa mais segura e menos restritiva SimpleString.
Strings na plataforma InterSystems IRIS têm um limite de 3.641.144 caracteres, e se você quiser executar um trecho mais longo de código, precisará usar streams.
Aceita dois argumentos:
code— string ou stream de código Python para execução.variable— (opcional) atribui o resultado da execuçãocodepara essa variável Python.
Exemplo de uso:
set sc = ##class(isc.py.Main).ExecuteCode("2*3", "y").Neste exemplo, multiplicamos 2 por 3 e gravamos o resultado na variável Python y.
Transmissão de dados
Envie dados para o Python e de volta.
Python -> InterSystems IRIS
Existem 4 maneiras de obter o valor da variável Python no InterSystems IRIS, dependendo da serialização que você precisa:
Stringpara tipos de dados simples e depuração.Reprpara armazenamento de objetos simples e depuração.JSONpara manipulação fácil de dados no lado do InterSystems IRIS.Picklepara salvar objetos.
Esses métodos permitem obter variáveis do Python como strings ou fluxos.
GetVariable(variable, serialization, .stream, useString)— obterserializationvariávelvariableemstream. SeuseStringé igual a 1 e a serialização é colocada em uma string, então retorna uma string e não um fluxo.GetVariableJson(variable, .stream, useString)— obter a serialização JSON da variável.GetVariablePickle(variable, .stream, useString, useDill)— obter a serialização Pickle (ou Dill) da variável.
Vamos tentar obter nossa variável y.
set sc = ##class(isc.py.Main).GetVariable("y", , .val, 1)
write val
>6
InterSystems IRIS -> Python
Carregando dados do InterSystems IRIS para Python.
ExecuteQuery(query, variable, type, namespace)— cria um conjunto de dados (pandasdataframeoulist) a partir de uma consulta sql e o define em uma variável do Pythonvariable. O pacoteisc.pydeve estar acessível no namespacenamespace— onde a consulta será executada.ExecuteGlobal(global, variable, type, start, end, mask, labels, namespace)— carrega dados do globalglobalde um subscriptstartatéendpara o Python como uma variável do tipotipo:list, ou pandasdataframe. A descrição dos argumentos opcionaismaskelabelsestá disponível na documentação da classe e no repositório .ExecuteClass(class, variable, type, start, end, properties, namespace)— carrega dados da classeclassede idstartatéendpara o Python como uma variável do tipotipo:list, ou pandasdataframe.properties— lista (separador - vírgula) de propriedades da classe que precisam ser carregadas no conjunto de dados. Máscaras são suportadas.*e?. Por padrão —*(todas as propriedades). A propriedade%%CLASSNAMEé ignorado.ExecuteTable(table, variable, type, start, end, properties, namespace)— carrega dados da tabelatablede idstartatéendpara o Python.
ExecuteQuery — é universal (qualquer consulta SQL válida será enviada para o Python). No entanto, ExecuteGlobal e suas envoltórias ExecuteClass e ExecuteTable funcionam com uma série de restrições. Eles são muito mais rápidos (3 a 5 vezes mais rápidos que o driver ODBC e 20 vezes mais rápidos ExecuteQuery). Mais informações em .
Todos esses métodos suportam a transferência de dados de qualquer namespace. O pacote isc.py deve estar acessível no namespace de destino.
ExecuteQuery
ExecuteQuery(request, variable, type, namespace) — transferência dos resultados de qualquer consulta SQL válida para o Python. Este é o método mais lento de transferência de dados. Use-o se ExecuteGlobal e suas envoltórias não estiverem disponíveis.
Argumentos:
query— consulta sql.variable— nome da variável Python para a qual os dados são gravados.tipo—listou Pandasdataframe.namespace— namespace onde a consulta será executada.
ExecuteGlobal
ExecuteGlobal(global, variable, type, start, end, mask, labels, namespace) — transferência do global para o Python.
Argumentos:
global— nome do global sem^variable— nome da variável Python para a qual os dados são gravados.tipo—listou Pandasdataframe.start— primeiro subscript do global. Obrigatório%Integer.end— último subscript do global. Obrigatório%Integer.mask— máscara de valores do global. A máscara pode ser mais curta do que o número de campos no global (neste caso, os campos no final serão ignorados). Como formatar a máscara:+passar o valor como está.-pular o valor.b— Tipo lógico (0—False, tudo o mais —Verdadeiro).d— Data (de $horolog, no Windows a partir de 1970, no Linux a partir de 1900).t— Hora ($horolog, segundos após a meia-noite).m— Timestamp (string no formato ANO-MÊS-DIA HORA:MINUTO:SEGUNDO).
labels— %Lista de nomes de colunas. O primeiro elemento — o nome do subscript.namespace— namespace onde a consulta será executada.
ExecuteClass
Wrapper sobre ExecuteGlobal. Com base na definição da classe, prepara a chamada ExecuteGlobal e a invoca.
ExecuteClass(class, variable, type, start, end, properties, namespace) — passagem de dados da classe em Python.
Argumentos:
classe— nome da classevariable— nome da variável Python para a qual os dados são gravados.tipo—listou Pandasdataframe.start— Id inicial.end— Id finalproperties— lista (separador - vírgula) de propriedades da classe que precisam ser carregadas no conjunto de dados. Máscaras são suportadas.*e?. Por padrão —*(todas as propriedades). A propriedade%%CLASSNAMEé ignorado.namespace— namespace onde a consulta será executada.
Todas as propriedades são passadas como estão, exceto as propriedades dos tipos te, %Hora, %Booleano e %Timestamp — eles são convertidos nas respectivas classes do Python.
ExecuteTable
Wrapper sobre ExecuteClass. Transforma o nome da tabela no nome da classe e invoca ExecuteClass. Assinatura:
ExecuteTable(table, variable, type, start, end, properties, namespace) — passagem de dados da tabela em Python.
Argumentos:
table— nome da tabela.
Todos os outros argumentos são passados como estão emExecuteClass.
Notas
ExecuteGlobal,ExecuteClasseExecuteTablefuncionam igualmente rápido.ExecuteGlobal20 vezes mais rápido do queExecuteQueryem grandes conjuntos de dados (tempo de passagem superior a >0.01 segundo).ExecuteGlobal,ExecuteClasseExecuteTablefuncionam em globals com esta estrutura:^global(chave) = $lb(prop1, prop2, ..., propN)ondekey— número inteiro.- Para
ExecuteGlobal,ExecuteClasseExecuteTableintervalo de valores suportadotecorresponde ao intervalomktimee depende do SO (: 1970-01-01, 1900-01-01, ). Use%Timestamppara passar dados fora deste intervalo ou use pandas dataframe, pois essa é uma limitação apenas para listas. - Para
ExecuteGlobal,ExecuteClasseExecuteTabletodos os argumentos, exceto a fonte de dados (global, classe ou tabela) e a variável, são opcionais.
Exemplos
Classe de teste contém um método que demonstra todas as opções de passagem de dados:
definir global = "isc.py.test.PersonD"
definir classe = "isc.py.test.Person"
definir tabela = "isc_py_test.Person"
definir consulta = "SELECT * FROM isc_py_test.Person"

// Argumentos gerais
definir variável = "df"
definir tipo = "dataframe"
definir início = 1
definir fim = $g(^isc.py.test.PersonD, início)

// Método 0: ExecuteGlobal sem argumentos
definir sc = ##class(isc.py.Main).ExecuteGlobal(global, variável _ 0, tipo)

// Método 1: ExecuteGlobal com argumentos
// Ao passar global, os nomes dos campos são definidos manualmente
// globalKey - nome do subscript
definir rotulos = $lb("globalKey", "Nome", "DOB", "TS", "RandomTime", "IdadeAnos", "IdadeDecimal", "IdadeDouble", "Bool")

// máscara contém 1 elemento a menos que rotulos porque "globalKey" é o nome do subscript
// Ignoramos %%CLASSNAME
definir máscara = "-+dmt+++b"

definir sc = ##class(isc.py.Main).ExecuteGlobal(global, variável _ 1, tipo, início, fim, máscara, rotulos)

// Método 2: ExecuteClass
definir sc = ##class(isc.py.Main).ExecuteClass(classe, variável _ 2, tipo, início, fim)

// Método 3: ExecuteTable
definir sc = ##class(isc.py.Main).ExecuteTable(tabela, variável _ 3, tipo, início, fim)

// Método 4: ExecuteTable
definir sc = ##class(isc.py.Main).ExecuteQuery(consulta, variável _ 4, tipo)
Chame o método do ##class(isc.py.test.Person).Test() para ver como todos os métodos de transferência de dados funcionam.
Métodos auxiliares
GetVariableInfo(variável, serialização, .definido, .tipo, .comprimento)— obtenha informações sobre a variável: se está definida, a classe e o comprimento da serialização.GetVariableDefined(variável, .definido)— se a variável está definida.GetVariableType(variável, .tipo)— obtenha a classe da variável.GetStatus()— obtenha e remova a última exceção do lado Python.GetModuleInfo(módulo, .importado, .alias)— obtenha a variável do módulo e o status da importação.GetFunctionInfo(função, .definido, .tipo, .docs, .assinatura, .argumentos)— obtenha informações sobre a função.
Interoperabilidade
Você aprendeu a chamar o Python Gateway a partir do terminal, agora vamos começar a usá-lo em produção. A base da interação com Python neste modo é isc.py.ens.Operation. Ele nos permite:
- Executar código em Python
- Salvar/Restaurar o contexto do Python
- Carregar e obter dados do Python
Basicamente, a operação Pyhton é uma camada sobre isc.py.Main. A operação isc.py.ens.Operation oferece a possibilidade de interagir com o processo Python a partir de produtos InterSystems IRIS. Cinco solicitações são suportadas:
isc.py.msg.ExecutionRequestpara executar código Python. Retornaisc.py.msg.ExecutionResponsecom o resultado da execução e os valores das variáveis solicitadas.isc.py.msg.StreamExecutionRequestpara executar código Python. Retornaisc.py.msg.StreamExecutionResponsecom o resultado da execução e os valores das variáveis solicitadas. Semelhanteisc.py.msg.ExecutionRequest, mas aceita e retorna streams em vez de strings.isc.py.msg.QueryRequestpara transferir o resultado da execução de uma consulta SQL. RetornaEns.Response.isc.py.msg.GlobalRequest/isc.py.msg.ClassRequest/isc.py.msg.TableRequestpara a transmissão de dados global/classe/tabela. RetornaEns.Response.isc.py.msg.SaveRequestpara salvar o contexto Python. RetornaEns.StringResponsecom o identificador de contexto.isc.py.msg.RestoreRequestpara restaurar o contexto Python.Além disso,
isc.py.ens.Operationpossui duas configurações:Initializer— escolha da classe que implementa a interfaceisc.py.init.Abstract. Pode ser usado para carregar funções, módulos, classes, etc. É executado uma vez ao iniciar o processo.PythonLib— (apenas para Linux) se você ver erros ao carregar, defina seu valor comolibpython3.6m.soou até mesmo o caminho completo para a biblioteca Python.
Criação de processos de negócios
Estão disponíveis duas classes que facilitam o desenvolvimento de processos de negócios:
isc.py.ens.ProcessUtilspermite extrair anotações de atividades com substituição de variáveis.isc.py.util.BPEmulatorfacilita o teste de processos de negócios com Python. Pode executar um processo de negócios (partes em linguagem Python) no processo atual.
Substituição de variáveis
Todos os processos de negócios herdados de isc.py.ens.ProcessUtils, podem usar o método GetAnnotation(name) para obter o valor da anotação da atividade pelo seu nome. A anotação da atividade pode conter variáveis, que serão calculadas do lado do InterSystems IRIS antes de serem passadas para o Python. Aqui está a sintaxe de substituição de variáveis:
${class:method:arg1:...:argN}— chamar o método#{expr}— executar código na linguagem ObjectScript.
Um exemplo está disponível no processo de negócios de teste isc.py.test.Process, por exemplo, na atividade Correlation Matrix: Graph: f.savefig(r'#{process.WorkDirectory}SHOWCASE${%PopulateUtils:Integer:1:100}.png'). Neste exemplo:
#{process.WorkDirectory}retorna a propriedade WorkDirectory do objetoprocesso, que é uma instância da classeisc.py.test.Processou seja, do processo de negócios atual.${%PopulateUtils:Integer:1:100}chama o métodoInteiroclasse%PopulateUtils, passando argumentos1e100, retornando um número inteiro aleatório no intervalo1...100.
Processo de negócios de teste
Produto de teste e processo de negócios de teste estão disponíveis por padrão como parte do Gateway Python. Para usá-los:
- No terminal do SO, execute:
pip install pandas matplotlib seaborn. - No terminal do InterSystems IRIS, execute:
do ##class(isc.py.test.CannibalizationData).Import()para preencher os dados de teste. - Inicie o produto
isc.py.test.Production. - Enviar um pedido do tipo
Ens.Requestemisc.py.test.Process.
Vamos ver como tudo isso funciona junto. Abra isc.py.test.Process no editor BPL:
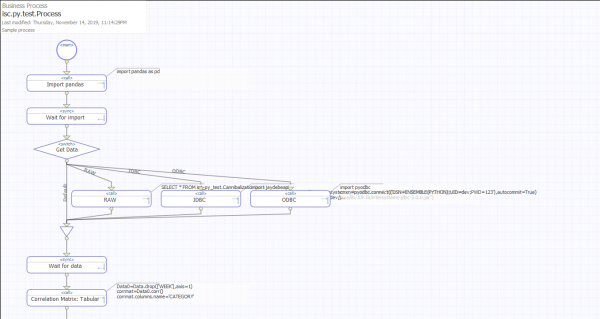
Execução de código
A chamada mais importante é a execução do código Python:
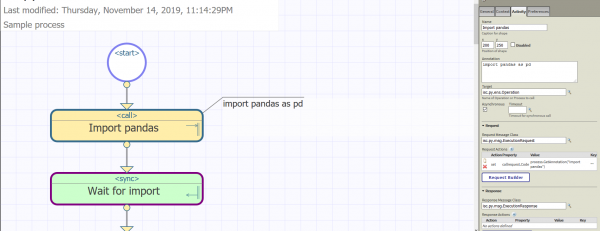
Usa a solicitação isc.py.msg.ExecutionRequest, aqui estão suas propriedades:
Código— código Python.SeparateLines— separar o código em linhas para execução.$c(10)(n) é usado para separar linhas. Observe que NÃO é recomendável processar a mensagem inteira de uma só vez, esta função é destinada apenas para processamentodefe expressões multilinha semelhantes. Por padrão0.Variáveis— uma lista de variáveis separadas por vírgulas que serão adicionadas à resposta.Serialização— Como serializar as variáveis que queremos retornar. Opções:Str,Repr,JSON,PickleeDill, por padrãoStr.
No nosso caso, estamos apenas definindo a propriedade Código, para que todas as outras propriedades usem os valores padrão. Estamos definindo isso chamando process.GetAnnotation("Import pandas"), que durante a execução retorna a anotação após a substituição de variáveis. No final, o código import pandas as pd será passado para o Python. GetAnnotation pode ser útil para obter scripts Python multilinha, mas não há restrições para esse método de obtenção de código. Você pode definir a propriedade Código de qualquer maneira que lhe convier.
Obtenção de variáveis
Mais um chamado interessante usando isc.py.msg.ExecutionRequest — Matriz de Correlação: Tabular:
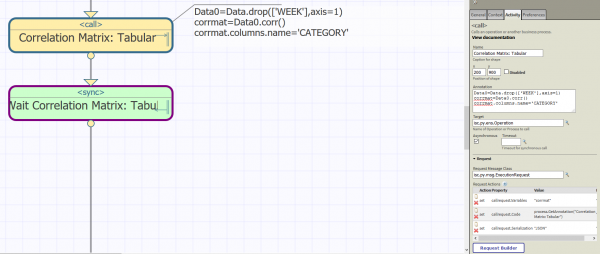
Ele calcula a Matriz de Correlação no lado do Python e extrai a variável corrmat de volta ao InterSystems IRIS no formato JSON, configurando as propriedades da requisição:
Variáveis:"corrmat"Serialização:"JSON"
Podemos ver os resultados no Visual Trace:
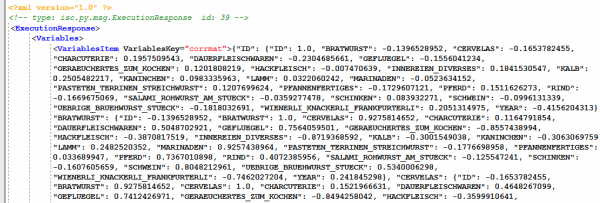
E se precisarmos desse valor no BP, ele pode ser obtido assim: callresponse.Variables.GetAt("corrmat").
Transmissão de dados
Agora vamos falar sobre a transferência de dados do InterSystems IRIS para o Python, todas as requisições de transferência de dados implementam a interface isc.py.msg.DataRequest, que fornece as seguintes propriedades:
Variável— a variável Python para a qual os dados são escritos.Tipo— o tipo de variável:dataframe(dataframe pandas) oulist.Namespace— o escopo do qual obtemos os dados. O pacoteisc.pydeve estar disponível nesse escopo. Pode ser um escopo sem suporte a produtos.
Com base nessa interface, 4 classes de requisições foram implementadas:
isc.py.msg.QueryRequest— defina a propriedadeQuerypara passar uma consulta SQL.isc.py.msg.ClassRequest— defina a propriedadeClassepara passar dados de classe.isc.py.msg.TableRequest— defina a propriedadeTabelapara passar dados da tabela.isc.py.msg.GlobalRequest— defina a propriedadeGlobalpara passar dados globais.
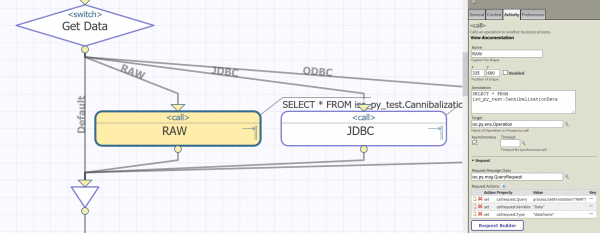
No processo de teste, observe a atividade RAW, onde isc.py.msg.QueryRequest mostra em ação.
Salvamento/restauração do contexto Python
Finalmente, podemos salvar o contexto Python no InterSystems IRIS, para fazer isso, enviaremos isc.py.msg.SaveRequest com os argumentos:
Máscara— Somente as variáveis que atendem à máscara são salvas. São suportadas*e?. Exemplo:"Data*, Figura?". Por padrão,*.ComprimentoMáximo— Comprimento máximo da variável armazenada. Se a serialização da variável for mais longa, ela será ignorada. Defina 0 para permitir variáveis de qualquer comprimento. Por padrão$$$MaxStringLength.Nome— Nome do contexto (opcional).Descrição— Descrição do contexto (opcional).
Retorna Ens.StringResponse com Id do contexto salvo. No processo de teste, observe a atividade Salvar Contexto.
A solicitação correspondente isc.py.msg.RestoreRequest carrega o contexto do InterSystems IRIS para o Python:
ContextId— identificador do contexto.Limpar— limpar o contexto antes da restauração.
Jupyter Notebook
— é um aplicativo web de código aberto que permite criar notebooks contendo código, visualizações e texto e publicá-los. O Python Gateway permite visualizar e editar processos BPL como Jupyter Notebooks. Observe que atualmente está sendo usado o executor padrão do Python 3.
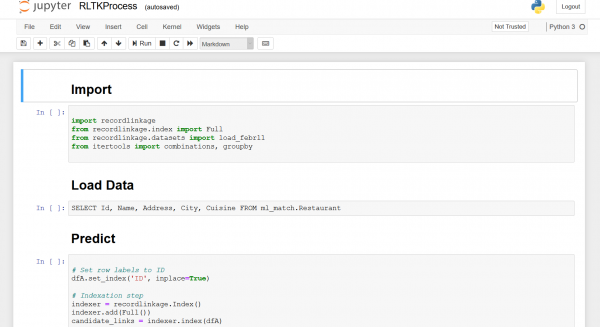
Esta extensão presume que as anotações contêm código Python e usam nomes de atividades como cabeçalhos anteriores. Agora é possível desenvolver processos de negócios PythonGateway no Jupyter Notebook. Aqui está o que é possível:
- Criar novos processos de negócios
- Excluir processos de negócios
- Criar novas atividades
- Modificar atividades
- Excluir atividades
Aqui . E algumas capturas de tela:
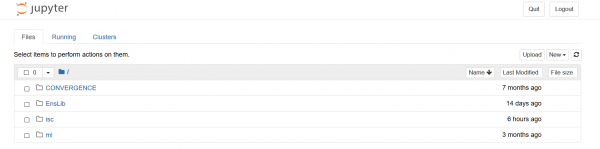
Explorador de Processos
Editor de Processos
Instalação
- Você precisará do InterSystems IRIS 2019.2+.
- Instale o PythonGateway v0.8+ (somente necessário
isc.py.util.Jupyter,isc.py.util.JupyterCheckpointseisc.py.ens.ProcessUtils). - Atualize o código ObjectScript do repositório.
- Execute
do ##class(isc.py.util.Jupyter).Install()e siga as instruções.
.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
MLToolkit é um conjunto de ferramentas cujo objetivo é integrar modelos e ambientes de transação, permitindo que os modelos construídos sejam facilmente utilizados diretamente em seus processos de negócios. O Python Gateway é parte do MLToolkit e fornece integração com a linguagem Python, permitindo orquestrar quaisquer algoritmos de aprendizado de máquina criados em Python (o ambiente principal para muitos Cientistas de Dados), utilizando inúmeras bibliotecas prontas para a construção rápida de soluções analíticas de IA/ML adaptativas e automatizadas na plataforma InterSystems IRIS.
Links
MLToolkit
O grupo de usuários do MLToolkit é um repositório privado do GitHub, criado como parte da organização corporativa do GitHub InterSystems. Ele é destinado a usuários externos que instalam, estudam ou já utilizam componentes do MLToolkit, incluindo o Python Gateway. O grupo disponibiliza uma série de casos implementados (com código-fonte e dados de teste) nas áreas de marketing, produção, medicina e muitas outras indústrias. Para se juntar ao grupo de usuários do ML Toolkit, por favor, envie uma mensagem curta por e-mail para o seguinte endereço: e indique em seu e-mail os seguintes dados:
- Nome de usuário do GitHub
- Organização (onde você trabalha ou estuda)
- Cargo (sua posição real na sua organização, ou "Estudante", ou "Freelancer").
- País
Para aqueles que leram o artigo e estão interessados nas possibilidades do InterSystems IRIS como plataforma para desenvolvimento ou hospedagem de mecanismos de inteligência artificial e aprendizado de máquina, oferecemos a discussão sobre possíveis cenários de interesse para sua empresa. Estamos dispostos a analisar as necessidades da sua empresa e definir um plano de ação conjunto; o endereço de contato do nosso grupo de especialistas em AI/ML é .
Fonte: habr.com
