

Olá, Habr! Apresento a vocês a tradução do artigo
.
Quando se trata de bancos de dados relacionais, não posso deixar de pensar que algo está faltando. Eles são utilizados em todo lugar. Existem muitos tipos diferentes de bancos de dados: desde o pequeno e útil SQLite até o poderoso Teradata. Mas existem apenas alguns artigos que explicam como um banco de dados funciona. Você pode procurar você mesmo pela consulta "howdoesarelationaldatabasework" ("como funcionam os bancos de dados relacionais") para ver como os resultados são escassos. Além disso, esses artigos são curtos. Se você estiver procurando as últimas tecnologias da moda (Big Data, NoSQL ou JavaScript), encontrará mais artigos aprofundados explicando como elas funcionam.
Os bancos de dados relacionais são muito antigos e muito chatos para serem explicados fora de cursos universitários, trabalhos de pesquisa e livros?
Como desenvolvedor, eu odeio usar o que não entendo. E se bancos de dados têm sido utilizados por mais de 40 anos, deve haver uma razão. Ao longo desses anos, passei centenas de horas tentando realmente entender essas estranhas caixas pretas que uso todos os dias. Bancos de dados relacionais são muito interessantes porque são baseados em conceitos úteis e reutilizáveis. Se você está interessado em entender bancos de dados, mas nunca teve tempo ou desejo de se aprofundar nesse amplo tema, você deve gostar deste artigo.
Embora o título deste artigo seja explícito, o objetivo deste artigo não é entender como usar um banco de dados. Portanto, você já deve saber como escrever uma consulta simples de junção e consultas básicas CRUD; caso contrário, você pode não entender este artigo. Isso é tudo o que você precisa saber, eu explicarei o restante.
Começarei com alguns fundamentos de ciência da computação, como a complexidade temporal de algoritmos (Big O). Eu sei que alguns de vocês odeiam esse conceito, mas sem ele você não conseguirá entender as nuances dentro de um banco de dados. Como este é um tema gigantesco, eu me concentrarei no que acho importante: como um banco de dados processa SQL pedido. Eu apresentarei apenas os conceitos básicos de bancos de dados, para que ao final do artigo você tenha uma noção do que acontece nos bastidores.
Como este é um artigo longo e técnico, que inclui muitos algoritmos e estruturas de dados, não se apresse em lê-lo. Alguns conceitos podem ser difíceis de entender; você pode pular alguns deles e ainda obter uma ideia geral.
Para aqueles que estão mais informados, este artigo está dividido em 3 partes:
- Visão geral dos componentes de banco de dados de baixo e alto nível
- Visão geral do processo de otimização de consultas
- Visão geral do gerenciamento de transações e do buffer
Voltando ao básico
Há muitos anos (em uma galáxia muito, muito distante…), os desenvolvedores precisavam saber exatamente quantas operações estavam codificando. Eles conheciam seus algoritmos e estruturas de dados de cor, pois não podiam se dar ao luxo de desperdiçar CPU e memória de seus computadores lentos.
Nesta parte, eu vou relembrá-lo sobre alguns desses conceitos, pois são necessários para entender o banco de dados. Eu também introduzirei o conceito de índice de banco de dados.
O(1) vs O(n²)
Atualmente, muitos desenvolvedores não se preocupam com a complexidade temporal dos algoritmos... e eles estão certos!
Mas quando você lida com uma grande quantidade de dados (não estou falando em milhares) ou se está competindo por milissegundos, torna-se criticamente importante entender esse conceito. E como você deve saber, os bancos de dados precisam lidar com ambas as situações! Não vou fazer você gastar mais tempo do que o necessário para entender a essência. Isso nos ajudará mais tarde a entender o conceito de otimização baseada em custos (cost based optimization).
Conceito
A complexidade temporal de um algoritmo é usada para ver quanto tempo levará para a execução de um algoritmo para uma determinada quantidade de dados. Para descrever essa complexidade, utiliza-se notação matemática de grandes O. Essa notação é utilizada com uma função que descreve quantas operações um algoritmo precisa para uma certa quantidade de dados de entrada.
Por exemplo, quando eu digo "este algoritmo tem complexidade O (some_function())", isso significa que para processar uma certa quantidade de dados, o algoritmo requer some_function(a_certain_amount_of_data) operações.
Ao mesmo tempo, importa não apenas a quantidade de dados**, mas sim como ** o número de operações aumenta à medida que aumenta a quantidade de dados. A complexidade temporal não fornece um número exato de operações, mas é uma boa forma de estimar o tempo de execução.
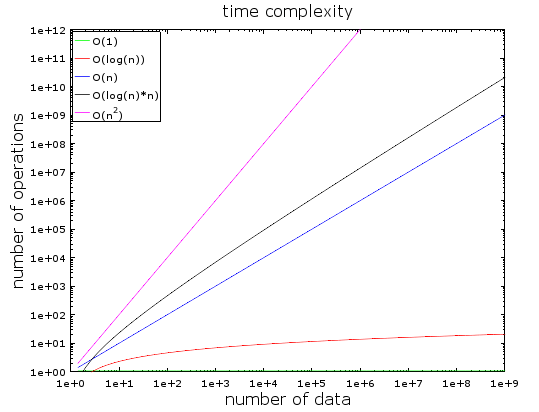
Neste gráfico, você pode ver a relação entre o número de operações e o volume de dados de entrada para diferentes tipos de complexidades temporais de algoritmos. Eu usei uma escala logarítmica para visualizá-los. Em outras palavras, a quantidade de dados aumenta rapidamente de 1 a 1 bilhão. Podemos ver que:
- O(1) ou complexidade constante permanece constante (caso contrário, não seria chamada de complexidade constante).
- O(registro(n)) permanece baixa mesmo com bilhões de dados.
- A pior complexidade é O(n2), onde o número de operações cresce rapidamente.
- As outras duas complexidades também aumentam rapidamente.
Exemplos
Com uma pequena quantidade de dados, a diferença entre O(1) e O(n2) é insignificante. Por exemplo, suponha que você tenha um algoritmo que precisa processar 2000 elementos.
- Um algoritmo O(1) custará 1 operação
- Um algoritmo O(log(n)) custará 7 operações
- Um algoritmo O(n) custará 2.000 operações
- Um algoritmo O(n * log(n)) custará 14.000 operações
- Um algoritmo O(n2) custará 4.000.000 operações
A diferença entre O(1) e O(n2) parece grande (4 milhões de operações), mas você vai perder no máximo 2 ms, apenas o tempo de piscar os olhos. Na verdade, processadores modernos podem lidar com . É por isso que desempenho e otimização não são problemas em muitos projetos de TI.
Como eu já disse, ainda é importante entender esse conceito ao trabalhar com grandes volumes de dados. Se desta vez o algoritmo precisa processar 1.000.000 elementos (o que não é muito para um banco de dados):
- Um algoritmo O(1) custará 1 operação
- Um algoritmo O(log(n)) custará 14 operações
- Um algoritmo O(n) custará 1.000.000 operações
- Um algoritmo O(n * log(n)) custará 14.000.000 operações
- Um algoritmo O(n2) custará 1.000.000.000.000 operações
Eu não fiz os cálculos, mas diria que com um algoritmo O(n2) você tem tempo para tomar um café (até dois!). Se você adicionar mais 0 ao volume de dados, terá tempo para cochilar.
Vamos mais fundo
Para referência:
- A busca em uma boa tabela hash encontra um elemento em O(1).
- A busca em uma árvore bem balanceada fornece o resultado em O(log(n)).
- A busca em um array fornece o resultado em O(n).
- Os melhores algoritmos de ordenação têm complexidade O(n * log(n)).
- Um algoritmo de ordenação ruim tem complexidade O(n2).
Nota: nas próximas partes, veremos esses algoritmos e estruturas de dados.
Existem vários tipos de complexidade temporal de um algoritmo:
- cenário do caso médio
- melhor caso possível
- e o pior cenário
A complexidade temporal é frequentemente a pior situação.
Eu falei apenas sobre a complexidade temporal do algoritmo, mas a complexidade também se aplica a:
- uso de memória pelo algoritmo
- uso de E/S de disco pelo algoritmo
Claro, existem complexidades piores que n², por exemplo:
- n⁴: isso é terrível! Alguns dos algoritmos mencionados têm essa complexidade.
- 3n: isso é ainda pior! Um dos algoritmos que veremos no meio deste artigo tem essa complexidade (e ele realmente é usado em muitos bancos de dados).
- fatorial de n: você nunca obterá seus resultados, mesmo com um pequeno conjunto de dados.
- nⁿ: se você encontrar essa complexidade, deve se perguntar se realmente é a sua área de atuação…
Nota: eu lhe dei não uma definição real da notação «grande O», mas apenas uma ideia. Você pode ler este artigo em para uma definição real (assintótica).
MergeSort (Classificação por Mistura)
O que você faz quando precisa classificar uma coleção? O quê? Você chama a função sort()… Ok, boa resposta… Mas para um banco de dados, você precisa entender como essa função sort() funciona.
Existem vários bons algoritmos de classificação, então vou me concentrar no mais importante: classificação por mistura. Talvez você não entenda agora por que classificar dados é útil, mas você precisará compreender isso depois da parte dedicada à otimização de consultas. Além disso, entender a classificação por mistura nos ajudará mais tarde a entender a operação de junção de bancos de dados, chamada mesclar join (junção por mistura).
Merge (Mistura)
Como muitos algoritmos úteis, a classificação por mistura se baseia em um truque: mesclar 2 arrays ordenados de tamanho N/2 em um array ordenado de N elementos custa apenas N operações. Essa operação é chamada de mistura.
Vamos ver o que isso significa em um exemplo simples:
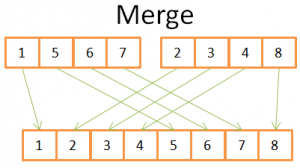
Nesta ilustração, você pode ver que para construir o array ordenado final de 8 elementos, você só precisa iterar uma vez em 2 arrays de 4 elementos. Como ambos os arrays de 4 elementos já estão ordenados:
- 1) você compara os dois elementos atuais em ambos os arrays (no início atual = o primeiro)
- 2) em seguida, pegue o menor para colocá-lo em um array de 8 elementos
- 3) e passe para o próximo elemento no array, onde você pegou o menor elemento
- e repita 1, 2, 3, até chegar ao último elemento de um dos arrays.
- Depois, você pega os outros elementos do outro array para colocá-los em um array de 8 elementos.
Isso funciona porque ambos os arrays de 4 elementos estão ordenados, e por isso você não precisa "voltar" nesses arrays.
Agora que entendemos esse truque, aqui está meu pseudocódigo para merge:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   // chamadas recursivas
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   // mesclando os 2 pequenos arrays ordenados em um grande
   array result := merge(new_left_array,new_right_array);
   return result;
A ordenação por mistura divide a tarefa em tarefas menores e, em seguida, encontra os resultados dessas tarefas menores para obter o resultado da tarefa original (observação: esse tipo de algoritmo é chamado de dividir e conquistar). Se você não entender esse algoritmo, não se preocupe; eu não entendi na primeira vez que vi. Se isso ajudar, vejo esse algoritmo como um algoritmo em duas fases:
- Fase de divisão, onde o array é dividido em arrays menores
- Fase de ordenação, onde os pequenos arrays são mesclados (usando a mesclagem) para formar um array maior.
Fase de divisão
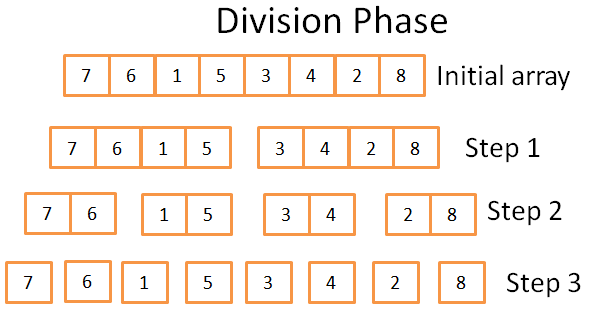
Na fase de divisão, o array é dividido em arrays unitários em 3 etapas. O número formal de etapas é log(N) (já que N=8, log(N) = 3).
Como eu sei disso?
Eu sou um gênio! Em uma palavra — matemática. A ideia é que cada passo divide o tamanho do array original por 2. O número de etapas é quantas vezes você pode dividir o array original em dois. Essa é a definição exata de logaritmo (com base 2).
Fase de ordenação
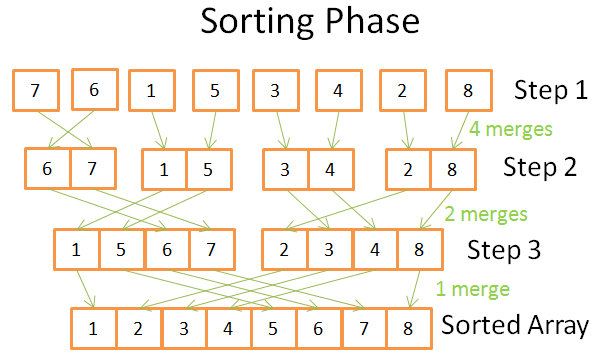
Na fase de ordenação, você começa com arrays unitários (de um elemento). A cada etapa, você aplica várias operações de mesclagem, e o custo total é N = 8 operações:
- Na primeira etapa, você tem 4 mesclagens que custam 2 operações cada
- Na segunda etapa, você tem 2 mesclagens que custam 4 operações cada
- Na terceira etapa, você tem 1 mesclagem que custa 8 operações
Como existem log(N) etapas, o custo total é N * log(N) operações.
Vantagens da ordenação por mistura
Por que este algoritmo é tão poderoso?
Porque:
- Você pode modificá-lo para reduzir o uso de memória, de modo que você não crie novos arrays, mas altere diretamente o array de entrada.
Nota: esse tipo de algoritmo é chamado de (classificação sem memória adicional).
- Você pode adaptá-lo para usar simultaneamente espaço em disco e uma quantidade reduzida de memória sem grandes custos de entrada/saída em disco. A ideia é carregar na memória apenas as partes que estão sendo processadas no momento. Isso é importante quando você precisa classificar uma tabela de vários gigabytes com apenas um buffer de memória de 100 megabytes.
Nota: esse tipo de algoritmo é chamado de .
- Você pode modificá-lo para ser executado em vários processos / threads / servidores.
Por exemplo, a classificação distribuída por mesclagem é um dos componentes chave (que é uma estrutura em big data).
- Este algoritmo pode transformar chumbo em ouro (é verdade!).
Este algoritmo de classificação é utilizado na maioria (senão em todas) as bases de dados, mas não é o único. Se você quiser saber mais, pode ler este , que discute os prós e contras dos algoritmos de classificação comuns em bancos de dados.
Array, Árvore e Tabela Hash
Agora que entendemos a ideia de complexidade temporal e classificação, devo falar sobre 3 estruturas de dados. Isso é importante, pois elas são a base dos bancos de dados modernos. Também irei introduzir o conceito de índice de banco de dados.
Array
Array bidimensional — a estrutura de dados mais simples. Uma tabela pode ser vista como um array. Por exemplo:
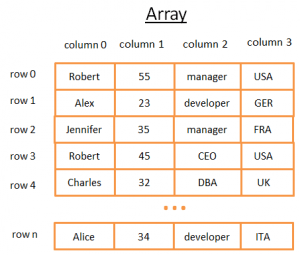
Este array 2D representa uma tabela com linhas e colunas:
- Cada linha representa uma entidade
- As colunas armazenam propriedades que descrevem a entidade.
- Cada coluna armazena dados de um tipo específico (inteiro, string, data ...).
É muito conveniente armazenar e visualizar dados, no entanto, quando você precisa encontrar um valor específico, isso não é adequado.
Por exemplo, se você quiser encontrar todos os caras que trabalham no Reino Unido, você precisará percorrer cada linha para determinar se essa linha pertence ao Reino Unido. Isso vai custar a você N operações, onde N — o número de linhas, o que não é ruim, mas pode haver um caminho mais rápido? Agora é hora de nos familiarizarmos com as árvores.
Nota: a maioria dos bancos de dados modernos fornece arrays expandidos para um armazenamento eficiente de tabelas: tabelas organizadas em heaps e tabelas organizadas em índices. Mas isso não muda o problema da busca rápida de uma determinada condição em um grupo de colunas.
Árvore e índice de banco de dados
Uma árvore binária de busca é uma árvore binária com uma propriedade especial: a chave em cada nó deve ser:
- maior do que todas as chaves armazenadas no subárvore esquerda
- menor do que todas as chaves armazenadas no subárvore direita
Vamos ver o que isso significa visualmente
Ideia
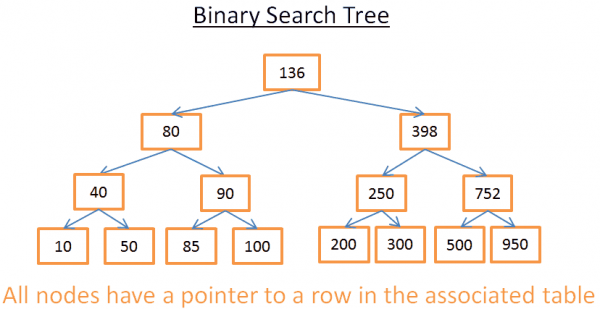
Esta árvore tem N = 15 elementos. Suponha que estou procurando 208:
- Começo pela raiz, cuja chave é 136. Como 136<208, olho para o subárvore direita do nó 136.
- 398>208, portanto, olho para o subárvore esquerda do nó 398
- 250>208, portanto, olho para o subárvore esquerda do nó 250
- 200<208, portanto, olho para o subárvore direita do nó 200. Mas 200 não tem subárvore direita, o valor não existe (porque, se existisse, estaria no subárvore direita de 200).
Agora, digamos que estou procurando 40
- Começo pela raiz, cuja chave é 136. Como 136 > 40, olho para o subárvore esquerda do nó 136.
- 80 > 40, portanto, olho para o subárvore esquerda do nó 80
- 40= 40, o nó existe. Extraio o identificador da linha dentro do nó (isso não está na imagem) e procuro na tabela para esse identificador da linha.
- Conhecer o identificador da linha me permite saber exatamente onde os dados estão na tabela, e assim posso acessá-los instantaneamente.
No final, ambas as buscas custarão-me o número de níveis dentro da árvore. Se você ler atentamente a parte sobre ordenação por mesclagem, você deve ver que aqui há log(N) níveis. Portanto, o custo da busca é log(N), não é ruim!
Voltando ao nosso problema
Mas isso é muito abstrato, então vamos voltar ao nosso problema. Em vez de um simples inteiro, imagine uma string que representa o país de alguém na tabela anterior. Suponha que você tenha uma árvore que contém o campo "country" (coluna 3) da tabela:
- Se você quiser saber quem trabalha no Reino Unido
- você olha para a árvore para obter o nó que representa o Reino Unido
- dentro do "UKnode" você encontrará a localização dos registros dos trabalhadores no Reino Unido.
Esta pesquisa custará log(N) operações em vez de N operações se você usar o array diretamente. O que você acabou de apresentar foi um índice de banco de dados.
Você pode construir uma árvore de índice para qualquer grupo de campos (texto, número, 2 textos, número e texto, data…) desde que você tenha uma função para comparar as chaves (ou seja, grupos de campos) para que você possa estabelecer a ordem entre as chaves (o que é aplicável a quaisquer tipos primitivos no banco de dados).
B+TreeIndex
Embora esta árvore funcione bem para obter um valor específico, há um GRANDE problema quando você precisa obter vários elementos entre dois valores. Isso custará O(N) porque você terá que verificar cada nó na árvore e verificar se ele está entre esses dois valores (por exemplo, com uma travessia ordenada da árvore). Além disso, essa operação não é conveniente para entrada e saída em disco, pois você terá que ler a árvore inteira. Precisamos encontrar uma maneira eficiente de realizar uma consulta de intervalo. Para resolver esse problema, bancos de dados modernos utilizam uma versão modificada da árvore anterior chamada B+Tree. Na árvore B+Tree:
- somente os nós mais baixos (folhas) armazenam informações (localização de linhas na tabela associada)
- os outros nós estão aqui para o roteamento para o nó correto durante a busca.
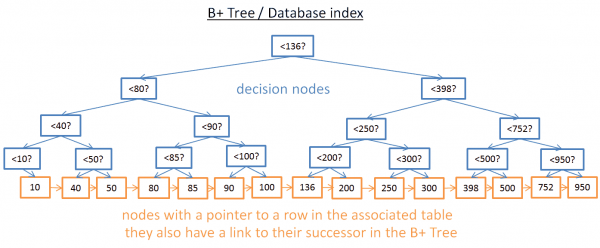
Como você pode ver, aqui há mais nós (o dobro). De fato, há nós adicionais, 'nós de decisão', que ajudam você a encontrar o nó correto (que armazena a localização das linhas na tabela associada). Mas a complexidade de busca ainda é O(log(N)) (apenas há mais um nível). A grande diferença é que os nós na camada inferior estão conectados aos seus sucessores.
Com essa B+Tree, se você estiver procurando por valores de 40 a 100:
- Você só precisa procurar 40 (ou o valor mais próximo após 40, se 40 não existir), como você fez com a árvore anterior.
- Depois, reúna os sucessores de 40, usando referências diretas aos sucessores, até alcançar 100.
Suponha que você encontrou M sucessores e a árvore tem N nós. Buscar um nó específico custa log(N) assim como na árvore anterior. Mas, ao obter esse nó, você receberá M sucessores em M operações com referências a seus sucessores. Essa busca custa apenas M+log(N) operações em comparação com N operações na árvore anterior. Além disso, você não precisa ler a árvore inteira (apenas M + log (N) nós), o que significa menor uso de disco. Se M for pequeno (por exemplo, 200 linhas) e N grande (1.000.000 linhas), isso fará uma GRANDE diferença.
Mas aqui surgem novos problemas (novamente!). Se você adicionar ou remover uma linha do banco de dados (e, portanto, do índice B+Tree relacionado):
- você deve manter a ordem entre os nós dentro da árvore B+Tree, caso contrário, você não conseguirá encontrar os nós dentro da árvore não ordenada.
- você deve manter o número mínimo possível de níveis na B+Tree, caso contrário, a complexidade de tempo em O(log(N)) se tornará O(N).
Em outras palavras, a B+Tree deve ser autoordenada e balanceada. Felizmente, isso é possível com operações inteligentes de remoção e inserção. Mas isso tem um custo alto: inserir e remover na árvore B+ custa O(log(N)). É por isso que alguns de vocês ouviram que usar muitos índices não é uma boa ideia. De fato, você desacelera a inserção/atualização/remoção rápida de uma linha na tabela, uma vez que o banco de dados precisa atualizar os índices da tabela com a operação cara O(log(N)) para cada índice. Além disso, adicionar índices significa uma maior carga para o gerenciador de transações (será descrito no final do artigo).
Para mais informações, você pode conferir o artigo na Wikipedia sobre . Se você quiser um exemplo de implementação de B+Tree em um banco de dados, veja e do desenvolvedor líder do MySQL. Ambos se concentram em como o InnoDB (motor do MySQL) lida com os índices.
Nota: o leitor me disse que, devido a otimizações de baixo nível, a árvore B+ deve estar totalmente balanceada.
Hashtable (Tabela Hash)
Nossa última estrutura de dados importante é a tabela hash. Isso é muito útil quando você deseja buscar valores rapidamente. Além disso, entender a tabela hash nos ajudará mais tarde a compreender a operação de junção em banco de dados, chamada junção hash ( hash join). Essa estrutura de dados também é utilizada pelo banco de dados para armazenar algumas coisas internas (por exemplo, tabela de bloqueio ou pool de buffers, veremos ambos esses conceitos mais tarde).
Uma tabela de hash é uma estrutura de dados que encontra rapidamente um elemento pelo seu chave. Para construir uma tabela de hash, você precisa definir:
- chave para seus elementos
- função de hash para as chaves. Os hashes calculados das chaves fornecem a localização dos elementos (chamados de segmentos ).
- função para comparar as chaves. Assim que você encontrar o segmento correto, deve localizar o elemento que está procurando dentro do segmento, usando essa comparação.
Um exemplo simples
Vamos pegar um exemplo visual:
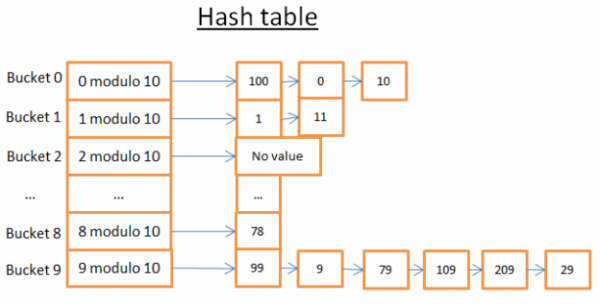
Esta tabela de hash tem 10 segmentos. Como eu sou preguiçoso, desenhei apenas 5 segmentos, mas sei que vocês são inteligentes e deixarei vocês imaginarem os 5 outros. Eu usei uma função de hash de módulo 10 da chave. Em outras palavras, mantenho apenas o último dígito da chave do elemento para encontrar seu segmento:
- se o último dígito for 0, o elemento cai no segmento 0,
- se o último dígito for 1, o elemento cai no segmento 1,
- se o último dígito for 2, o elemento cai na área 2,
- …
A função de comparação que usei é simplesmente a igualdade entre dois números inteiros.
Vamos supor que você queira obter o elemento 78:
- A tabela de hash calcula o hash para 78, que é igual a 8.
- A tabela de hash olha no segmento 8, e o primeiro elemento que encontra é 78.
- Ela retorna o elemento 78
- A busca custou apenas 2 operações (uma para calcular o valor da função de hash e outra para buscar o elemento dentro do segmento).
Agora, suponha que você queira obter o elemento 59:
- A tabela de hash calcula o hash para 59, que é igual a 9.
- A tabela de hash busca no segmento 9, o primeiro elemento encontrado é 99. Como 99!=59, o elemento 99 não é o elemento correto.
- Usando essa mesma lógica, é pego o segundo elemento (9), o terceiro (79), …, o último (29).
- Elemento não encontrado.
- A busca custou 7 operações.
Uma boa função de hash
Como você pode ver, dependendo do valor que você está buscando, o custo não é o mesmo!
Se eu agora mudar a função de hash para o módulo 1 000 000 da chave (ou seja, pegando os últimos 6 dígitos), a segunda busca custará apenas 1 operação, já que no segmento 000059 não há elementos. O verdadeiro desafio é encontrar uma boa função de hash que crie segmentos com muito poucos elementos..
No meu exemplo, encontrar uma boa função de hash é fácil. Mas este é um exemplo simples; encontrar uma boa função de hash é mais difícil quando a chave:
- é uma string (por exemplo, sobrenome)
- são 2 strings (por exemplo, sobrenome e nome)
- são 2 strings e uma data (por exemplo, sobrenome, nome e data de nascimento)
- …
Com uma boa função de hash, a busca em uma tabela hash é O(1).
Array vs Tabela Hash
Por que não usar um array?
Hmm, boa pergunta.
- Uma tabela hash pode ser parcialmente carregada na memória, enquanto os outros segmentos podem permanecer no disco.
- Com um array, você precisa utilizar um espaço contínuo na memória. Se você carregar uma tabela grande, é muito difícil encontrar espaço contínuo suficiente.
- Para uma tabela hash, você pode escolher a chave desejada (por exemplo, o país e o sobrenome da pessoa).
Para mais informações, você pode ler o artigo sobre , que é uma implementação eficiente de tabela hash; você não precisa entender Java para compreender os conceitos apresentados neste artigo.
Fonte: habr.com
