

A questão de "como implementar DevOps em sua empresa" já é debatida há alguns anos, mas não há muitos materiais bons disponíveis. Às vezes, você se torna vítima da propaganda de consultores não muito inteligentes, que só querem vender seu tempo, independente de como. Outras vezes, são palavras obscuras e extremamente genéricas sobre como os navios de megacorporações navegam pelos vastos espaços do universo. Surge a questão: e nós, o que ganhamos com isso? Prezado autor, poderia resumir suas ideias de forma clara e em forma de lista?
Tudo isso se deve ao fato de que a prática real e a compreensão dos resultados das transformações culturais nas empresas são escassas. Mudanças na cultura são processos de longo prazo, cujos resultados não aparecerão em uma semana ou um mês. Precisamos de alguém com bastante experiência, que tenha visto como empresas foram criadas e destruídas ao longo dos anos.
John Willis é um dos pais do DevOps. John tem décadas de experiência colaborando com inúmeras empresas. Recentemente, ele começou a notar padrões específicos que se manifestam no trabalho com cada uma delas. Usando esses arquétipos, John guia as empresas no verdadeiro caminho da transformação DevOps. Mais informações sobre esses arquétipos estão na tradução de sua apresentação na conferência DevOops 2018.
Sobre o palestrante:
Mais de 35 anos em gestão de TI, participou da criação do predecessor do OpenCloud na Canonical, esteve envolvido em 10 startups, duas das quais foram vendidas para a Dell e Docker. Atualmente, é Vice-Presidente de DevOps e Práticas Digitais na SJ Technologies.
A seguir, um relato na voz de John.
Meu nome é John Willis, e você pode me encontrar facilmente no Twitter, . Esse é o mesmo apelido que uso no Gmail e no GitHub. E você pode encontrar os vídeos das minhas palestras e suas respectivas apresentações.
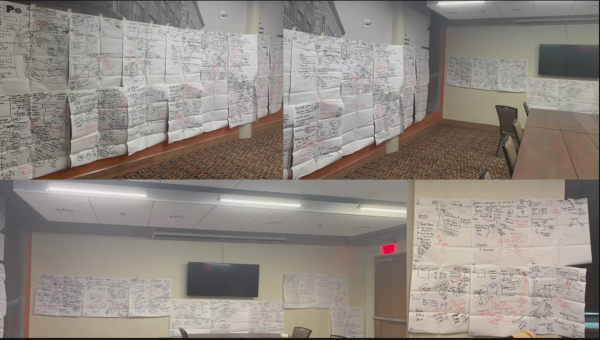
Tenho muitas reuniões com CIOs de grandes empresas. Eles frequentemente reclamam que não entendem o que é DevOps, e todos que tentam explicar falam sobre algo próprio. Outra reclamação comum é que o DevOps não funciona, embora pareça que os diretores fazem tudo conforme explicado. Refiro-me a grandes empresas que existem há mais de cem anos. Depois de conversar com eles, cheguei à conclusão de que para muitos problemas, soluções de tecnologia relativamente simples são mais adequadas do que alta tecnologia. Passei semanas apenas conversando com pessoas de diferentes departamentos. O que você vê na primeira imagem do post foi meu último projeto, a sala parecia assim após três dias de trabalho.
O que é DevOps?
De fato, se perguntar a 10 pessoas diferentes, elas darão 10 respostas diferentes. Mas o interessante é que todas essas dez respostas estarão corretas. Não há resposta errada aqui. Tenho me aprofundado no DevOps por cerca de 10 anos, fui o primeiro americano no primeiro DevOpsDay. Não vou dizer que sou mais inteligente do que todos que trabalham com DevOps, mas é difícil encontrar alguém que tenha investido tanto esforço nisso. Acredito que o DevOps surge quando o capital humano se une à tecnologia. Muitas vezes esquecemos a dimensão humana, mesmo falando muito sobre diversos tipos de cultura.
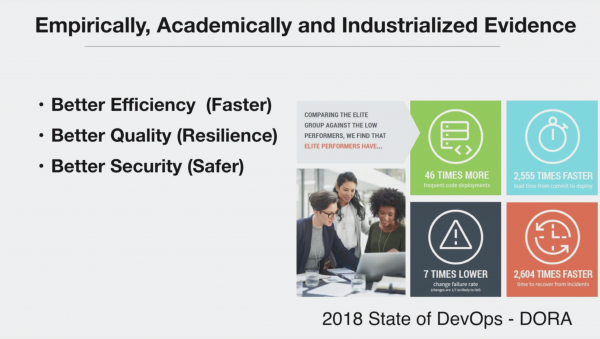
Atualmente, temos muitos dados, cinco anos de pesquisas acadêmicas, a verificação de teorias foi estabelecida em larga escala. Essas pesquisas nos dizem o seguinte: se em uma cultura organizacional combinarmos alguns padrões de comportamento, podemos alcançar um aumento de 2000 vezes. Esse aumento corresponde a uma melhoria semelhante na resiliência. Esta é uma medida quantitativa da vantagem que o DevOps pode oferecer a qualquer empresa. Alguns anos atrás, falei sobre DevOps para o CEO de uma empresa da lista Fortune 5000. Quando me preparei para a apresentação, fiquei muito nervoso, pois precisava resumir anos de experiência em 5 minutos.
No final, eu dei a seguinte definição de DevOps: é um conjunto de práticas e padrões que permite transformar o capital humano em capital organizacional de alto desempenho. Um exemplo é a maneira como a Toyota opera há 50 ou 60 anos.
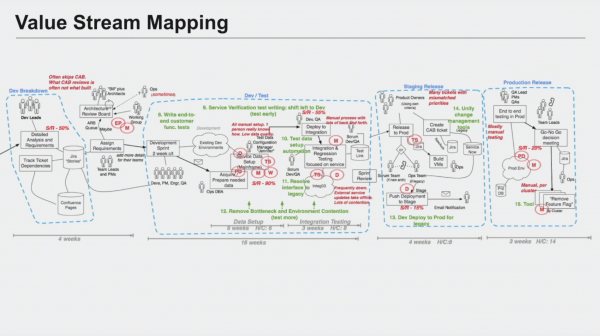
(Aqui e adiante, tais esquemas são apresentados não como material de referência, mas como ilustrações. Seu conteúdo diferirá para cada nova empresa. No entanto, a imagem pode ser visualizada e ampliada separadamente
Uma das práticas mais bem-sucedidas é mapeamento do fluxo de valor. Várias boas obras foram escritas sobre isso, com o autor mais bem-sucedido sendo Karen Martin. Mas, no último ano, cheguei à conclusão de que até mesmo essa abordagem é tecnicamente excessiva. Ela, sem dúvida, possui muitas vantagens, das quais me beneficiei bastante. Mas quando o CEO pergunta por que sua empresa não pode mudar de foco, ainda é cedo para discutir o mapeamento do fluxo de valor. Existem muitas questões muito mais fundamentais que precisam ser respondidas anteriormente.
Creio que o erro de muitos dos meus colegas é dar à empresa um guia de cinco pontos e depois voltar seis meses depois para ver o que aconteceu. Mesmo um bom esquema como o mapeamento do fluxo de valor tem, digamos, zonas mortas. Após centenas de entrevistas com diretores de várias empresas, desenvolvi um padrão que permite decompor o problema em partes e agora discutiremos cada uma dessas partes com calma. Antes de aplicar qualquer solução tecnológica, utilizo esse padrão, e o resultado é que todas as minhas paredes acabam cobertas de esquemas. Recentemente, trabalhei com um fundo mútuo, e acabei tendo 100-150 desses esquemas.
Uma cultura ruim consome boas abordagens no café da manhã
A ideia principal é a seguinte: nenhum Lean, Agile, SAFE ou DevOps ajudará se a cultura da organização for ruim. É como mergulhar em profundidade sem um cilindro de oxigênio ou operar sem uma radiografia. Em outras palavras, parafraseando Drucker e Deming: uma cultura organizacional ruim absorverá qualquer bom sistema e não se engasgará.
Para resolver esse problema principal, é necessário tomar as seguintes medidas:
- Tornar Todo o Trabalho Visível: é preciso tornar todo o trabalho visível. Não no sentido de que ele deva obrigatoriamente ser exibido em alguma tela, mas no sentido de que ele deve ser observável.
- Consolidar Sistemas de Gestão do Trabalho: é necessário consolidar os sistemas de gestão. No problema do conhecimento 'tribal' e do conhecimento institucional, em 9 casos de 10, o gargalo são as pessoas. No livro o problema estava em uma única pessoa, Brent, cuja ausência levou o projeto a um atraso de três anos. E encontro 'Brents' por toda parte. Para desfazer esses gargalos, utilizo os seguintes dois pontos na nossa lista.
- Metodologia da Teoria das Restrições: teoria das restrições.
- Truques de colaboração: truques de colaboração.
- Toyota Kata (): não vou falar muito sobre Toyota Kata. Se você estiver interessado, no meu GitHub quase sobre cada um desses temas.
- Organização Orientada ao Mercado: organização orientada para o mercado.
- Auditores Shift-left: auditoria nas fases iniciais do ciclo.
Começo a trabalhar com a organização de uma forma muito simples: vou à empresa e converso com os funcionários. Como vemos, não são necessárias tecnologias avançadas. Tudo que preciso é ter algo para escrever. Reúno algumas equipes em uma sala e analiso o que me dizem sob a perspectiva dos meus 7 arquétipos. Depois, dou a eles um marcador e peço que escrevam no quadro tudo o que já disseram em voz alta. Geralmente, em reuniões desse tipo, há uma pessoa que anota tudo e, na melhor das hipóteses, ela consegue registrar 10% da discussão. Com meu método, essa taxa pode ser aumentada para cerca de 40%.
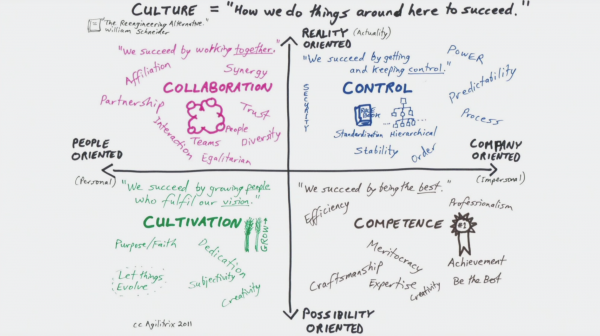
(Separadamente, esta ilustração pode )
Meu enfoque é baseado no trabalho de William Schneider (William Schneider, ). A base do enfoque é a ideia de que qualquer organização pode ser desmembrada em quatro quadrantes. Este esquema é geralmente o resultado do trabalho com aquelas centenas de outros esquemas que surgem durante a análise da organização. Suponha que temos uma organização com alto nível de controle, mas com baixa competência. Esta é uma situação extremamente indesejável: quando todos seguem as regras, mas ninguém sabe o que deve ser feito.
Uma opção muito melhor com um alto nível de controle e competência. Se uma empresa é lucrativa, talvez ela não precise de DevOps. É mais interessante trabalhar em uma empresa que tenha um nível alto de controle, baixa competência e colaboração, mas ao mesmo tempo uma alta cultura (cultivation). Isso significa que há muitas pessoas na empresa que gostam de trabalhar lá, e a rotatividade de funcionários é baixa.
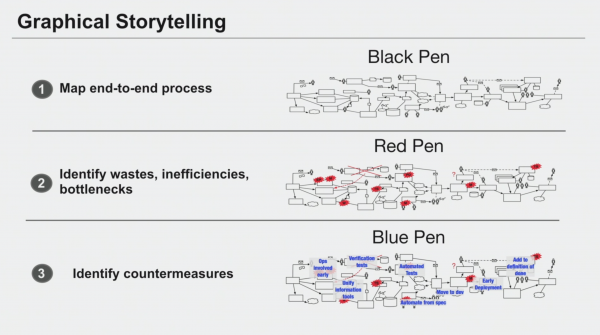
(Separadamente, esta ilustração pode )
Acredito que os métodos com recomendações rígidas acabam por atrapalhar a busca pela verdade. Em particular, no value stream mapping, existem muitas regras sobre como estruturar a informação. Nos estágios iniciais de trabalho que menciono, essas regras não são necessárias. Quando uma pessoa com um marcador na mão descreve em uma lousa a situação real da empresa — esse é o melhor modo de entender a situação. Essa informação não chega até os diretores. Nesse momento, é tolo interromper a pessoa e dizer que ela desenhou uma seta de forma errada. Nessa fase, é melhor usar regras simples, por exemplo: uma abstração em múltiplos níveis pode ser criada simplesmente usando marcadores coloridos.
Reitero, nada de alta tecnologia. Com um marcador preto, a realidade objetiva é desenhada, como tudo funciona. Com um marcador vermelho, as pessoas marcam o que não gostam na situação atual. O importante é que isso está sendo escrito por elas, e não por mim. Quando após a reunião vou até o diretor de tecnologia da informação, não ofereço uma lista de 10 coisas que precisam ser corrigidas. Busco encontrar conexões entre o que as pessoas da empresa dizem e os padrões já testados existentes. Finalmente, com um marcador azul, são sugeridas soluções possíveis para o problema.
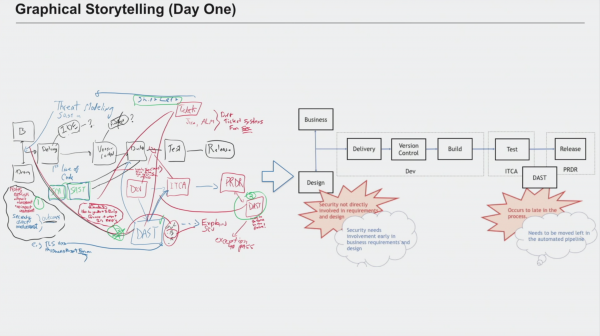
(Separadamente, esta ilustração pode )
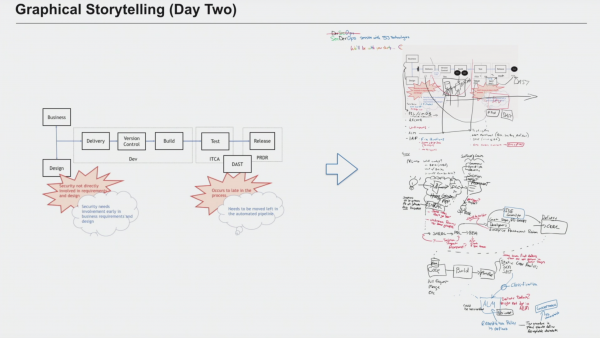
Um exemplo desse enfoque está ilustrado acima. No início deste ano, trabalhei com um banco. Os funcionários do departamento de segurança estavam convencidos de que não deveriam participar das avaliações de requisitos e projetos (design and requirement reviews).
(Separadamente, esta ilustração pode )
Então, conversamos com pessoas de outros departamentos e descobrimos que, cerca de 8 anos atrás, os desenvolvedores de software excluíram os trabalhadores de segurança porque eles estavam atrasando o trabalho. E depois isso se transformou em uma proibição que foi encarada como um fato consumado. Embora na realidade não houvesse nenhuma proibição.
A nossa reunião seguiu um rumo extremamente confuso: por cerca de três horas, cinco equipes diferentes não conseguiam me explicar o que estava acontecendo entre o código e a construção. E isso deveria ser a coisa mais simples. A maioria dos consultores de DevOps presume que isso já é do conhecimento de todos.
Depois, a pessoa responsável pela governança de TI, que havia permanecido em silêncio por quatro horas, de repente se animou quando chegamos ao seu tema, e nos manteve ocupados por bastante tempo. No final, eu perguntei o que ele achava da reunião, e nunca esquecerei sua resposta. Ele disse: "Antes eu pensava que no nosso banco havia apenas duas maneiras de entregar software, mas agora sei que existem cinco, e eu nem suspeitava de três delas."
(Separadamente, esta ilustração pode )
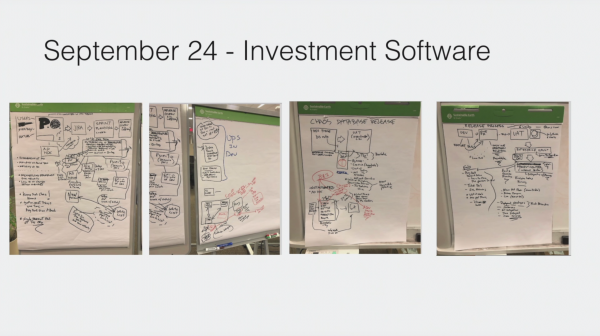
A última reunião neste banco foi com a equipe que lida com software para investimentos. Foi com eles que ficou claro que é melhor escrever esquemas com um marcador em uma folha do que em uma lousa, e até melhor do que em um quadro inteligente.
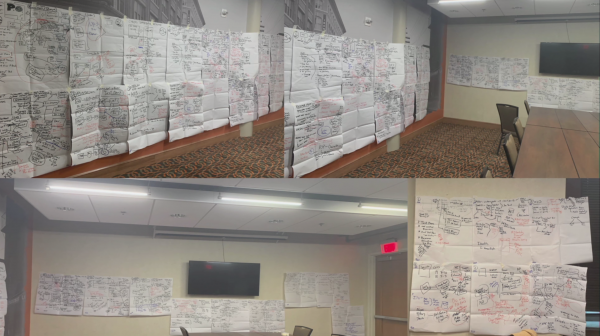
As fotos que você vê são como a sala de conferências do hotel parecia no quarto dia da nossa reunião. E esses esquemas foram usados para procurar padrões, ou seja, arquétipos.
Então, eu faço perguntas aos funcionários, e eles anotam as respostas com marcadores de três cores (preto, vermelho e azul). Eu analiso suas respostas em busca de arquétipos. Agora vamos discutir todos os arquétipos na ordem.
1. Make All Work Visible: Tornar Todo Trabalho Visível
Na maioria das empresas com as quais trabalho, há uma alta porcentagem de trabalho desconhecido. Por exemplo, isso acontece quando um funcionário se aproxima de outro e simplesmente pede algo. Em grandes organizações, até 60% do trabalho é não planejado. E até 40% do trabalho não é documentado de forma alguma. Se fosse a Boeing, eu nunca mais entraria em um de seus aviões. Se apenas metade do trabalho é documentada, não se sabe se esse trabalho está sendo feito corretamente ou não. Todos os outros métodos se tornam inúteis — não faz sentido tentar automatizar qualquer coisa, porque os 50% conhecidos podem ser a parte mais organizada e clara do trabalho, cuja automação não trará grandes resultados, enquanto o que há de pior está na metade invisível. Sem documentação, é impossível encontrar todos os tipos de gambiarras e trabalho oculto, não encontrar gargalos, aqueles . Ela identifica cinco diferentes "vazamentos de tempo" (thieves of time):
- Muita Trabalho em Processo (WIP)
- Dependências Desconhecidas
- Trabalho Não Planejado
- Prioridades Conflitantes
- Trabalho Negligenciado
Essa é uma análise muito valiosa, e o livro é excelente, mas todas essas dicas são inúteis se apenas 50% dos dados estão visíveis. Aplicar os métodos sugeridos por Dominica só é viável se a precisão for superior a 90%. Estou falando de situações em que um chefe dá a um subordinado uma tarefa de 15 minutos, mas ela leva três dias; mas o chefe realmente não sabe que esse subordinado depende de mais quatro ou cinco pessoas.
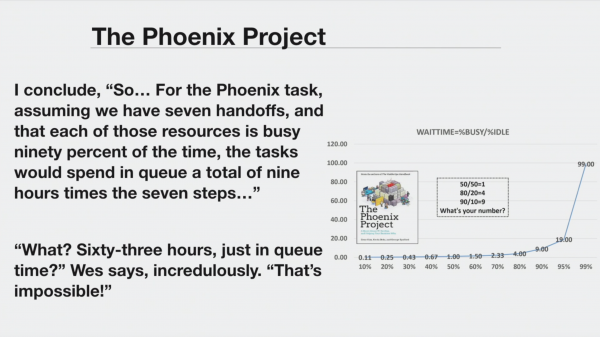
Phoenix Project — é uma história fascinante sobre um projeto que atrasou três anos. Um dos personagens corre o risco de ser demitido por causa disso, e ele se encontra com outro personagem, que é apresentado como uma espécie de Sócrates. Este ajuda a entender o que exatamente deu errado. Descobre-se que na empresa há um administrador de sistemas chamado Brent, e todo o trabalho passa, de alguma forma, por ele. Em uma das reuniões, um dos subordinados pergunta: por que cada tarefa de meia hora leva uma semana? A resposta é uma explicação muito simplificada da teoria das filas e da Lei de Little, que revela que, com 90% de ocupação, cada hora de trabalho consome 9 horas. Cada tarefa precisa ser enviada para sete outras pessoas, então essa hora se transforma em 63 horas, 7 multiplicado por 9. Estou dizendo isso para enfatizar que, para usar a Lei de Little ou qualquer teoria complexa de filas, é preciso ter dados.
Portanto, quando falo sobre visibilidade, não me refiro apenas a ter tudo na tela, mas sim à necessidade de ter, pelo menos, dados. Quando eles estão disponíveis, frequentemente se descobre que há um grande volume de trabalho não planejado que, por algum motivo, é direcionado a Brent, embora não haja necessidade. E Brent é um cara ótimo, ele nunca dirá "não", mas, ao mesmo tempo, ele não conta a ninguém como faz seu trabalho.
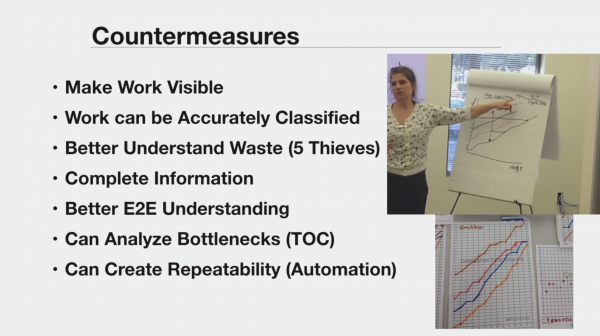
Quando o trabalho é visível, é possível classificar os dados de maneira organizada (é isso que Domínica faz na foto), aplicar a abstração das cinco vazamentos de tempo e automatizar.
2. Consolidar Sistemas de Gestão de Trabalho: Gestão de Tarefas
Os arquétipos de que estou falando representam uma espécie de pirâmide. Se o primeiro for executado corretamente, o segundo já é uma espécie de superestrutura. Muitos deles não funcionam para startups, mas devem ser considerados em empresas maiores, como as que estão na lista Fortune 5000. Na última empresa em que trabalhei, havia 10 sistemas de rastreamento de erros (sistema de tickets). Uma equipe usava o Remedy, outra criou seu próprio sistema, a terceira utilizava o Jira, enquanto alguns se viravam apenas com e-mails. O mesmo problema surge se uma empresa tiver 30 pipelines diferentes, mas não tenho tempo para discutir todas essas situações.
Eu discuto com as pessoas como os tickets são criados, o que acontece com eles depois, como eles são ignorados. O mais interessante é que as pessoas em nossas reuniões falam de forma bastante sincera. Perguntei quantas pessoas marcam como "menor / sem impacto" os tickets que realmente deveriam ser considerados "maior impacto". Descobri que quase todos fazem isso. Não estou aqui para denunciar ninguém e sempre procuro não identificar as pessoas. Quando alguém se abre sinceramente comigo, não revelo quem é. Mas quando quase todos ignoram o sistema, isso significa que toda a segurança, na verdade, é apenas uma fachada. Portanto, não se pode tirar conclusões com os dados desse sistema.
Para resolver o problema dos tickets, é necessário escolher um sistema principal. Se você está usando o Jira, que seja apenas o Jira. Se houver alguma alternativa, que seja apenas ela. A ideia é que os tickets precisam ser vistos como mais uma etapa do processo de desenvolvimento. Toda ação deve ter um ticket, que deve passar pelo fluxo do processo de desenvolvimento. Os tickets são enviados para a equipe, que os coloca no storyboard, e depois é responsável por eles.
Isso se aplica a todos os departamentos, incluindo o de infraestrutura e o operacional. Nesse caso, é possível criar uma representação razoavelmente precisa da situação. Quando esse processo está estabelecido, de repente, fica fácil identificar quem é responsável por cada aplicação. Porque agora estamos recebendo não 50%, mas 98% dos novos serviços. Se esse processo principal funciona, a precisão aumenta em todo o sistema.
Pipeline de serviços
Isso se aplica novamente apenas a grandes corporações. Se você é uma nova empresa em um novo campo, arregaçe as mangas e trabalhe com o seu Travis CI ou CircleCI. No que diz respeito às empresas da lista Fortune 5000, um caso notável é o de um banco onde trabalhei. Eles receberam a visita do Google, que mostrou gráficos com sistemas antigos da IBM. Os funcionários do Google, surpresos, perguntaram: onde está o código-fonte para isso? E não havia código-fonte, nem mesmo uma interface gráfica. Essa é a realidade com a qual as grandes organizações têm que lidar: registros bancários de 40 anos em um antigo mainframe. Um dos meus clientes utiliza contêineres Kubernetes com padrões de Circuit Breaker, além do Chaos Monkey, tudo isso para o aplicativo KeyBank. Mas, no final, esses contêineres se conectam a um aplicativo em COBOL.
Os funcionários do Google estavam completamente confiantes de que resolveriam todos os problemas do meu cliente, e então começaram a fazer perguntas: o que é um IBM datapipe? Eles responderam: é um conector. Conecta-se a quê? Ao sistema Sperry. E isso, o que é? E assim por diante. À primeira vista, parece: como pode haver DevOps aqui? Mas, na verdade, isso é possível. Existem sistemas de entrega que permitem transferir o fluxo de trabalho para equipes de entrega.
3. Teoria das Restrições: Teoria das Restrições
Vamos passar para o terceiro arquétipo: conhecimento institucional / "tribal". Normalmente, em qualquer organização, há algumas pessoas que sabem tudo e gerenciam todos. São aquelas que estão há mais tempo na organização e conhecem todos os caminhos alternativos.
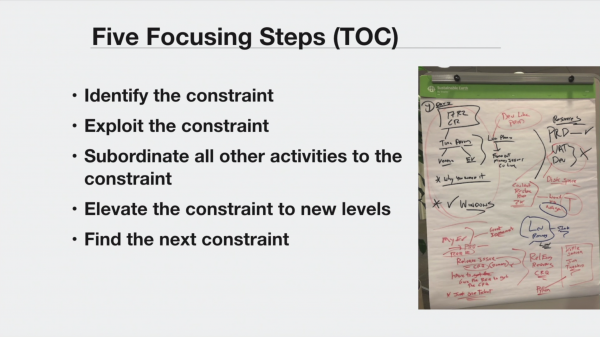
Quando isso é identificado no gráfico, eu faço questão de marcar essas pessoas com um marcador: por exemplo, fica claro que um certo Lou está presente em todas as reuniões. E para mim, está claro: ele é o Brent local. Quando o diretor de tecnologia da informação precisa escolher entre mim, vestindo uma camiseta e tênis, e um rapaz da IBM, vestido de terno, eles me escolhem porque eu posso contar ao diretor sobre coisas que o outro rapaz não dirá e que podem ser desagradáveis para o diretor ouvir. Eu digo a eles que em sua empresa há um ponto crítico, uma pessoa chamada Fred e outra chamada Lou. Essa restrição precisa ser desfeita, seu conhecimento precisa ser obtido de alguma forma.
Para resolver esse tipo de problema, eu poderia, por exemplo, sugerir o uso do Slack. Um diretor esperto perguntaria — por quê? Normalmente, em tais casos, consultores de DevOps respondem: porque todos fazem assim. Se o diretor realmente for esperto, ele dirá: e daí. E assim a conversa termina. E eu respondo: porque na empresa existem quatro gargalos, Fred, Lou, Suzie e Jane. Para institucionalizar o conhecimento deles, é necessário, em primeiro lugar, implementar o Slack. Todos os seus wikis são uma completa besteira, porque ninguém sabe que eles existem. Se a equipe de engenheiros está trabalhando em desenvolvimentos interno e externo, todos devem saber que podem entrar em contato com a equipe de desenvolvimento externo ou com a equipe de infraestrutura com perguntas. É nesse momento que provavelmente Lou ou Fred terão tempo para acessar o wiki. E então, no Slack, alguém pode perguntar por que, digamos, o passo 5 não está funcionando. E aí Lou ou Fred corrigirão a instrução no wiki. Se esse processo for estabelecido, muitas outras coisas se encaixarão sozinhas.
Aqui está minha ideia principal: para recomendar algumas tecnologias avançadas, é preciso, primeiro, colocar a fundação em ordem, e isso pode ser feito com as soluções de baixo custo que acabei de descrever. Se começarmos com tecnologias avançadas e não explicarmos por que são necessárias, geralmente isso não termina bem. Um dos nossos clientes usa o Azure ML, uma solução muito barata e simples. Em cerca de 30% das questões, a própria máquina autoadaptativa já respondia. E essa coisa foi desenvolvida por operadores que não tinham formação em ciência de dados, estatística ou matemática. Isso é significativo. O custo dessa solução é mínimo.
4. Dicas de colaboração: Hacks de colaboração
O quarto arquétipo é a necessidade de combater o isolamento. A maioria das pessoas já sabe disso: a isolação gera hostilidade. Se cada departamento está em seu próprio andar e as pessoas não se cruzam, exceto no elevador, a hostilidade entre elas surge facilmente. Mas, caso contrário, quando as pessoas estão no mesmo ambiente, essa hostilidade desaparece quase que imediatamente. Quando alguém faz uma acusação geral, como 'tal interface nunca funciona', é bastante simples desconstruir essa acusação. Para os programadores que escreveram a interface, basta começar a fazer perguntas específicas e logo se descobrirá que, por exemplo, o usuário simplesmente usou a ferramenta de forma inadequada.
Existem muitas maneiras de superar o isolamento. Eu já fui solicitado a consultar um banco na Austrália, mas recusei, pois tenho dois filhos e uma esposa. A única forma que consegui ajudá-los foi recomendando o storytelling gráfico. É algo que comprovadamente funciona. Outra forma interessante são as reuniões no formato lean coffee. Em uma grande organização, essa é uma excelente maneira de disseminar conhecimento. Além disso, podem ser realizados eventos internos como devopsdays, hackathons, e assim por diante.
5. Coaching Kata
Como já mencionei no início, não vou discutir isso hoje. Se estiver interessado, você pode conferir .
Há também uma boa palestra sobre o tema do Mike Rother:
6. Market Oriented: organização orientada para o mercado
Aqui existem diferentes problemas. Por exemplo, pessoas 'I', pessoas 'T' e pessoas 'E'. Pessoas 'I' são aquelas que se dedicam a apenas uma coisa. Normalmente, elas existem em organizações com departamentos isolados. 'T' é quando a pessoa conhece bem algo específico, mas também se destaca em outras áreas. 'E' ou até mesmo 'escova' refere-se a alguém com muitas habilidades.
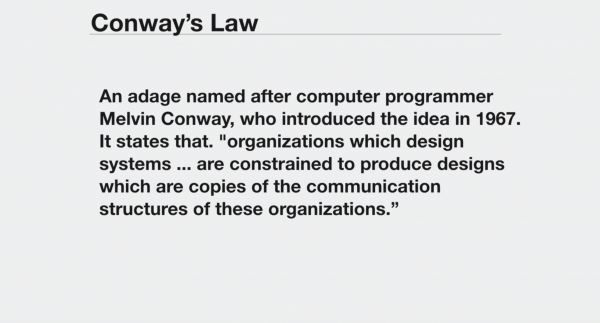
Aqui se aplica a lei de Conway (), que de forma bem simplificada pode ser resumida assim: se três equipes estão trabalhando em um compilador, no final teremos um compilador dividido em três partes. Portanto, se dentro da organização houver um alto nível de isolamento, mesmo ferramentas modernas como Kubernetes, Circuit breaker, API extensibility e outras, serão organizadas de forma semelhante à própria organização. Estritamente segundo Conway, para irritação de vocês, jovens geeks.
A resolução desse problema foi descrita muitas vezes. Existem, por exemplo, arquétipos organizacionais descritos por Fernando Fernandez. A arquitetura problemática da qual acabei de falar, com isolamento, é uma arquitetura orientada a funções. O segundo tipo — o pior, arquitetura matricial, onde há uma mistura das duas anteriores. O terceiro — é o que se observa na maioria das startups, e grandes empresas também tentam se alinhar a esse tipo. É uma organização orientada ao mercado. Aqui, há uma otimização para obter a resposta mais rápida às demandas dos clientes. Às vezes, isso é chamado de organização plana.
Essa estrutura é descrita de várias maneiras, eu gosto da formulação build/run teams, na Amazon isso é chamado de two pizza teams. Nessa estrutura, todas as pessoas do tipo "I" se agrupam em torno de um único serviço, e gradualmente se tornam mais próximas do tipo "T", e se a gestão for bem feita, podem até se tornar "E". O primeiro contra-argumento aqui é que nessa estrutura existem elementos desnecessários. Por que ter um testador em cada departamento, se podemos ter um departamento específico de testadores? Ao que eu respondo: os custos adicionais nesse caso são o preço para que toda a organização se torne do tipo "E" no futuro. Nessa estrutura, o testador gradualmente aprende sobre redes, arquitetura, design e assim por diante. No final, cada membro da organização fica totalmente ciente de tudo que acontece nela. Se você quiser saber como esse esquema funciona na indústria, leia .
7. Auditores shift-left: auditoria nas primeiras etapas do ciclo. Conformidade com as regras de segurança em evidência.
Isso é quando suas ações não passam, por assim dizer, no teste de cheiro. As pessoas que trabalham para você não são tolas. Se, como no exemplo acima, elas marcaram minor/no impact em tudo, isso continuou por três anos, e ninguém notou nada, então todos sabem que o sistema não funciona. Ou outro exemplo — o conselho de mudanças (change advisory board), onde, digamos, toda quarta-feira, é preciso enviar relatórios. Há um grupo de pessoas trabalhando lá (aliás, não muito bem remuneradas), que teoricamente deveriam saber como o sistema funciona como um todo. E nos últimos cinco anos, você provavelmente notou que nossos sistemas são absurdamente complexos. E cinco ou seis pessoas devem tomar uma decisão sobre uma mudança que elas não fizeram e sobre a qual nada sabem.
Claro, essa abordagem não funciona. Eu preciso me livrar dessas coisas, porque essas pessoas não protegem o sistema. A decisão deve ser tomada pela própria equipe, porque a equipe deve ser responsável por ela. Caso contrário, surge uma situação paradoxal, onde um gerente, que nunca escreveu código na vida, informa ao programador quanto tempo deve levar para escrever o código. Em uma empresa com a qual trabalhei, havia 7 conselhos diferentes que consideravam cada mudança, incluindo o conselho de arquitetura, de produtos, etc. Havia até um período de espera obrigatório, embora um funcionário me dissesse que, em dez anos de trabalho, ninguém jamais rejeitou mudanças feitas por esse indivíduo durante esse período obrigatório.
Os auditores devem ser convocados, não dispensados. Conte a eles que você está escrevendo contêineres binários imutáveis, que permanecem inalterados para sempre, se passarem em todos os testes. Explique que você possui um pipeline como código e o que isso significa. Mostre-lhes o seguinte diagrama: um binário imutável somente para leitura em um contêiner que passa por todos os testes de vulnerabilidade; e não apenas ninguém pode tocá-lo — até mesmo o sistema que cria o pipeline não é tocado, pois também é criado dinamicamente. Tenho clientes, como a Capital One, que usam o Vault para criar algo parecido com uma blockchain. Não é necessário mostrar ao auditor as 'receitas' do Chef, basta mostrar a blockchain, da qual é claro o que aconteceu com o ticket Jira em produção e quem é o responsável por ele.
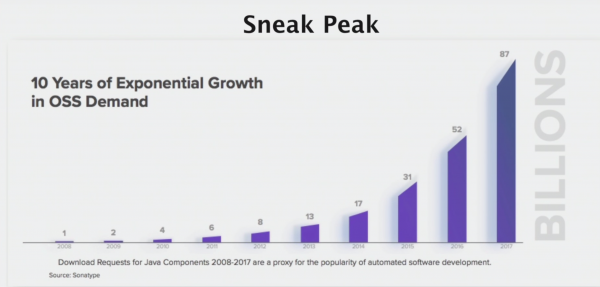
De acordo com , criado em 2018 pela Sonatype, em 2017 houve 87 bilhões de solicitações para download de OSS.
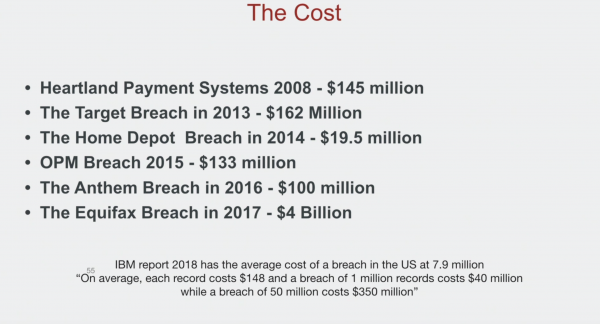
Os prejuízos devido a vulnerabilidades são excessivamente altos. Além disso, os números que você vê acima não incluem custos alternativos. Em poucas palavras, o que é DevSecOps. Quero destacar que não me interessam discussões sobre quão bem-sucedido é esse nome. O ponto é que, já que DevOps foi bastante exitoso, precisamos tentar adicionar segurança a esse pipeline.
Um exemplo dessa sequência:
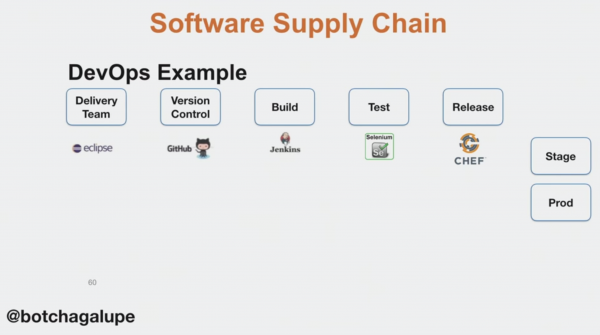
Não é uma recomendação de produtos específicos, apesar de eu gostar de todos eles. Os mencionei como exemplo para mostrar que o DevOps, que foi originalmente baseado na paradigmas da organização industrial, permite automatizar cada etapa do trabalho no produto.
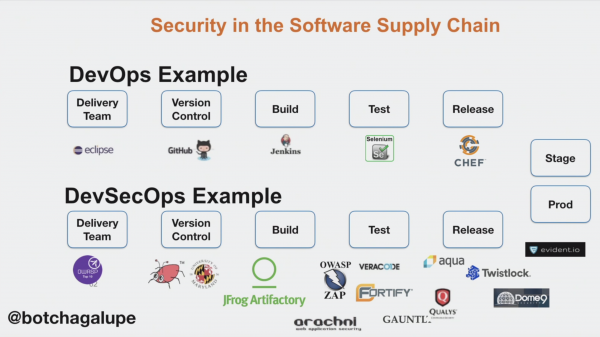
E não há nenhuma razão pela qual não podemos aplicar a mesma abordagem à segurança.
Resultado
Como conclusão, gostaria de dar alguns conselhos para DevSecOps. É necessário incluir auditores no processo de criação dos seus sistemas e dedicar tempo à sua formação. Deve-se cooperar com os auditores. Além disso, é preciso ter uma luta implacável contra alarmes falsos. Mesmo com a ferramenta de varredura de vulnerabilidades mais cara, é possível acabar criando hábitos nocivos para os seus desenvolvedores, se você não souber qual é a relação sinal-ruído. Os desenvolvedores se sentirão sobrecarregados com eventos e acabarão simplesmente os ignorando. Se você ouviu sobre a história da Equifax, foi exatamente isso que ocorreu, onde um sinal de mais alta severidade foi ignorado. Além disso, as vulnerabilidades precisam ser explicadas de maneira clara sobre como elas afetam os negócios. Por exemplo, você pode dizer que é a mesma vulnerabilidade da história com a Equifax. As vulnerabilidades de segurança devem ser tratadas como outros problemas de software, ou seja, devem ser incluídas no processo geral de DevOps. Elas devem ser geridas através do Jira, Kanban, etc. Os desenvolvedores não devem pensar que alguém mais vai lidar com isso — pelo contrário, todos devem se envolver. Por fim, é necessário investir energia no treinamento das pessoas.
Links Úteis
Aqui estão algumas palestras da conferência DevOops que podem parecer úteis para você:
- Sergei Berdnikov, Artyom Kalichkin - Uma história de sucesso, ou 'Dev+DevOps+Ops' (, )
- Baruch Sadogursky, Leonid Igolnik - DevOps em escala: uma tragédia grega em três atos (, )
- Alexandre Titov, Kirill Tolkachov -
- Timothy Lister -
Dê uma olhada no DevOops 2020 Moscow — lá também há muitas coisas interessantes.
Fonte: habr.com
