

Olá a todos.
Sou sysadmin Linux, mudei-me da Rússia para a Austrália com um visto profissional independente em 2015, mas este artigo não é sobre como um porquinho consegue um trator. Já existem muitos artigos desse tipo (entretanto, se houver interesse — eu também escreverei sobre isso), portanto gostaria de compartilhar como, no meu trabalho na Austrália como engenheiro de Linux-ops, fui o iniciador da migração de um sistema de monitoramento para outro. Especificamente — Nagios => Icinga2.
O artigo é parcialmente técnico e parcialmente sobre comunicação com as pessoas e problemas relacionados às diferenças culturais e métodos de trabalho.
Infelizmente, a tag «code» não destaca o código Puppet e YAML, então foi preciso usar «plaintext».
Nada prenunciava problemas na manhã de 21 de dezembro de 2016. Eu, como de costume, estava lendo o Habr como um anônimo não registrado nos primeiros trinta minutos do dia de trabalho, saboreando meu café e me deparei com .
Como na minha empresa o Nagios estava sendo utilizado, não pensei duas vezes, criei um ticket no Redmine e mandei o link no chat geral, pois considerei isso importante. A iniciativa é punida mesmo na Austrália, então o engenheiro líder atribuiu essa questão a mim, já que eu a descobri.
Captura de tela do Redmine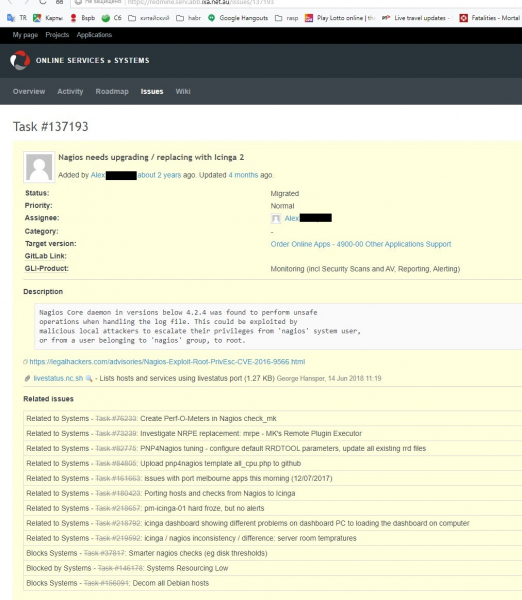
Em nosso departamento, antes de expressar minha opinião, é comum apresentar pelo menos uma alternativa, mesmo que a escolha seja óbvia, então comecei a pesquisar quais sistemas de monitoramento são relevantes atualmente, pois na Rússia, no meu último emprego, eu tinha meu próprio sistema feito à mão, muito primitivo, mas que, no entanto, funcionava bem e cumpria todas as suas tarefas. Python, o Politécnico de Petersburgo e o metrô são os melhores. Não, o metrô é ruim. Isso é pessoal (11 anos de trabalho) e merece um artigo separado, mas não agora.
Um pouco sobre as regras de alteração da configuração da infraestrutura no meu atual local de trabalho. Usamos Puppet, Gitlab e o princípio de Infrastructure as Code, então:
- Nenhuma alteração manual via SSH alterando qualquer arquivo em máquinas virtuais. Ao longo de três anos, recebi várias reprimendas por isso, sendo a mais recente há uma semana, e não acho que será a última. Afinal, corrigir uma linha em uma configuração, reiniciar o serviço e verificar se o problema foi resolvido leva apenas 10 segundos. Criar um novo branch no Gitlab, enviar as alterações, esperar que o r10k processe no Puppetmaster, rodar o Puppet —environment=mybranch e esperar mais alguns minutos para que tudo seja processado leva pelo menos 5 minutos.
- Qualquer alteração deve ser feita por meio da criação de um Merge Request no Gitlab e é necessário obter a aprovação de pelo menos um membro da equipe. Mudanças significativas, segundo a decisão do líder da equipe, exigem duas ou três aprovações.
- Todas as alterações são, de certa forma, textuais (já que os manifestos Puppet, scripts e dados Hiera são texto), arquivos binários são extremamente desaconselhados e sua aprovação requer justificativas sólidas.
Assim, as opções que considerei:
- Munin — se a infraestrutura tiver mais de 10 servidores, a administração se torna um pesadelo (de . Não tive desejo de verificar isso, então acreditei na palavra).
- Zabbix — já havia analisado há algum tempo, ainda na Rússia, mas na época era excessivo para minhas necessidades. Aqui — tive que descartar devido ao uso do Puppet como gerenciador de configuração e Gitlab como sistema de controle de versões. Naquele momento, pelo que entendi — o Zabbix armazena toda a configuração em um banco de dados, o que tornou confuso como gerenciar a configuração nas condições atuais e como acompanhar as alterações.
- Prometheus — o que acabaremos utilizando, segundo o clima no departamento, mas naquele momento não consegui dominar isso e não pude demonstrar um exemplo funcional (Proof of Concept), então tive que desistir.
- Houve ainda algumas outras opções que exigiam a reestruturação completa do sistema ou estavam em estágio inicial/abandonadas e, por essa razão, foram rejeitadas.
No final, optei pelo Icinga2 por três razões:
1 — compatibilidade com o Nrpe (serviço cliente que executa verificações com comandos do Nagios). Isso foi muito importante, pois na época tínhamos 135 (agora em 2019 são 165) máquinas virtuais com muitos serviços/verificações personalizados, e refazer tudo isso seria um grande problema.
2 — todos os arquivos de configuração são textuais, o que facilita a edição, permitindo a criação de merge requests com possibilidade de ver o que foi adicionado ou removido.
3 — este é um projeto OpenSource vivo e em desenvolvimento. Temos um grande apreço por OpenSource e fazemos nossa parte contribuindo com Pull Requests e Issues para resolver problemas.
Então, vamos lá, Icinga2.
O primeiro desafio foi a inércia dos colegas. Todos estavam acostumados com o Nagios/Nadgios (embora nem aqui conseguimos chegar a um consenso sobre como pronunciar) e a interface do CheckMK. A interface do Icinga era completamente diferente (o que foi uma desvantagem), mas há a possibilidade de configurar o que precisamos ver usando filtros para qualquer parâmetro (o que foi uma vantagem, mas eu lutei muito por isso).
Filtros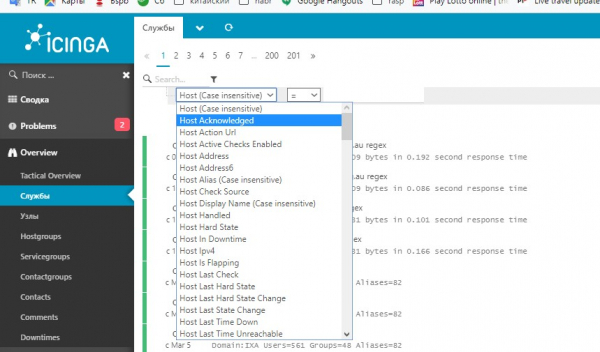
Avalie a proporção do tamanho da barra de rolagem em relação ao tamanho da área de rolagem.
Em segundo lugar — todos estavam acostumados a ver toda a infraestrutura em uma única tela, pois o CheckMk permite trabalhar com vários hosts Nagios, mas a interface do Icinga não sabia fazer isso (na verdade sabia, mas falarei disso a seguir). Uma alternativa era algo chamado Thruk, mas seu design causava náuseas em todos os membros da equipe, exceto um — aquele que o sugeriu (não fui eu).
Para o lixo com Thruk — decisão unânime da equipe.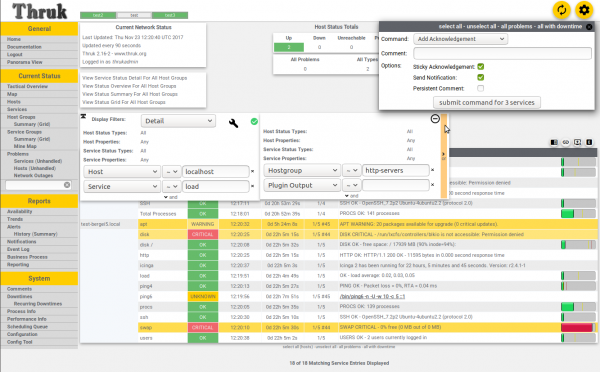
Após alguns dias de brainstorming, eu propus a ideia de monitoramento de clusters, onde há um host mestre na zona de produção e dois subordinados — um em dev/test e um externo, localizado em outro provedor, com o objetivo de monitorar nossos serviços sob a perspectiva do cliente ou de um observador externo. Essa configuração permitiu visualizar todos os problemas em uma única interface web e funcionou bem, mas o Puppet… O problema com o Puppet era que o host mestre agora precisava ter conhecimento sobre todos os hosts e serviços/verificações do sistema e deveria distribuí-los entre as zonas (dev-test, staging-prod, ext), mas o envio de mudanças através da API do Icinga leva alguns segundos, enquanto a compilação do catálogo do Puppet para todos os serviços de todos os hosts — leva alguns minutos. Isso ainda é jogado em minha cara, embora eu já tenha explicado várias vezes como tudo funciona e por que é tudo tão demorado.
Terceiro — um monte de SnowFlakes (flocos de neve) — coisas que fogem do sistema geral, porque há algo especial nelas, portanto as regras gerais não se aplicam. Isso era resolvido com uma abordagem direta — se há alertas, mas, na verdade, tudo está em ordem, significa que precisamos investigar mais a fundo e entender por que está me alertando, embora não devesse. Ou ao contrário — por que o Nagios está em pânico, mas o Icinga não.
Quarto — o Nagios trabalhou aqui por três anos antes de mim e havia mais confiança nele inicialmente do que em meu sistema moderno e hipster, assim que cada vez que o Icinga gerava pânico — ninguém fazia nada, até que o Nagios se alarmasse sobre a mesma questão. Mas muito raramente o Icinga gerava alarmes reais antes do Nagios, e eu considero isso uma falha grave, sobre a qual falarei na seção 'Conclusões'.
Como resultado, a implementação se prolongou por mais de 5 meses (estava prevista para 28 de junho de 2018, mas ocorreu de fato em 3 de dezembro de 2018), principalmente devido ao 'parity check' — aquela situação em que há vários serviços no Nagios dos quais ninguém ouviu nada nos últimos dois anos, mas AGORA eles, simplesmente, emitiram crit sem qualquer razão e eu tive que explicar por que eles não estavam no meu painel e precisei adicioná-los no Icinga para que 'parity check is complete' (Todos os serviços/verificações no Nagios correspondem aos serviços/verificações no Icinga)
Implementação:
Primeiro — a guerra entre Code e Data, estilo Puppet. Todos os dados, absolutamente todos, devem estar no Hiera e de outra forma não. Todo o código vai em arquivos .pp. Variáveis, abstrações, funções — tudo vai em pp.
No final — temos um monte de máquinas virtuais (165 no momento da redação deste artigo) e 68 aplicativos web que precisam ser monitorados quanto à funcionalidade e à validade dos certificados SSL. Mas devido a problemas históricos, as informações para monitorar os aplicativos vêm de um repositório gitlab separado e o formato dos dados não mudou desde os tempos do Puppet 3, o que cria complicações adicionais na configuração.
Puppet-code para aplicativos, protejam os olhos
definir perfis::serviços::monitoramento::docker_apps(
  Hash $app_list,
  Hash $apps_accessible_from,
  Hash $apps_access_list,
  Hash $webhost_defaults,
  Hash $webcheck_defaults,
  Hash $service_overrides,
  Hash $targets,
  Hash $app_checks,
  )
{
#### APLICATIVOS ####
  $zone = $name
  $app_list.each | String $app_name, Hash $app_data |
  {

    $notify_group = { 'notify_group' => ($webcheck_defaults[$zone]['notify_group'] + pick($app_data['notify_group'], {} )) } # adiciona notificações para o grupo padrão (sistemas) + qualquer grupo definido em int/pm_docker_apps.eyaml

    $data = merge($webhost_defaults, $apps_accessible_from, $app_data)

    $site_domain = $app_data['site_domain']

    $regexp = pick($app_data['check_regex'], 'html')        # Escolhe uma regex para verificação

    $check_url = $app_data['check_url'] ? {
      undef   => { 'http_uri' => '\/ ' },
      default => { 'http_uri' => $app_data['check_url'] }
    }

    $check_regex = $regexp ?{
      'absent' => {},
      default  => {'http_expect_body_regex' => $regexp}
    }

    $site_domain.each | String $vhost, Hash $vdata | {        # Divide um aplicativo por domínios se houver dois ou mais
      $vhost_name = {'http_vhost' => $vhost}

      $vars = $data['vars'] + $vhost_name + $check_regex + $check_url

      $web_ipaddress = is_array($vdata['web_ipaddress']) ? {  # Torna o endereço IP um array se não for, porque askizzy tem 2 ips e é um array
        true  => $vdata['web_ipaddress'],
        false => [$vdata['web_ipaddress']],
      }

      $access_from_zones = [$zone] + $apps_access_list[$data['accessible_from']] # Mescla a zona padrão (onde o aplicativo está definido) e zonas extras se existirem
      $web_ipaddress.each | String $ip_address | {            # Para cada IP (se tivermos múltiplos)
        $suffix = length($web_ipaddress) ? {                  # Se tivermos mais de um - adiciona o IP como um sufixo a este nome de host para evitar duplicar recursos
          1       => '',
          default => "_${ip_address}"
        }
        $octets = split($ip_address, '.')
        $ip_tag = "${octets[2]}.${octets[3]}" # Usar apenas o último octeto causa uma colisão entre nginx-vip 203.15.70.94 e ip ext. 49.255.194.94

        $access_from_zones.each | $zone_prefix |{
          $zone_target = $targets[$zone_prefix]

          $nginx_vip_name = "${zone_prefix}_nginx-vip-${ip_tag}" # Se for um host para ext - o prefixo se torna 'ext_' (ext_nginx-vip...)
          $nginx_host_vip = {
            $nginx_vip_name => {
              ensure        => present,
              target        => $zone_target,
              address       => $ip_address,
              check_command => 'hostalive',
              groups        => ['nginx_vip',],
            }
          }

          $ssl_vars = $app_checks['ssl']
          $regex_vars = $app_checks['http'] + $vars + $webcheck_defaults[$zone] + $notify_group

          if !defined( Profiles::Services::Monitoring::Host[$nginx_vip_name] ) {
          ensure_resources('profiles::services::monitoring::host', $nginx_host_vip)
          }

          if !defined( Icinga2::Object::Service["${nginx_vip_name}_ssl"] ) {
            icinga2::object::service {"${nginx_vip_name}_ssl":
              ensure         => $data['ensure'],
              assign         => ["host.name == $nginx_vip_name",],
              groups         => ['webchecks',],
              check_command  => 'ssl',
              check_interval => $service_overrides['ssl']['check_interval'],
              target         => $targets['services'],
              apply          => true,
              vars           => $ssl_vars
            }
          }
          if $regexp != 'absent'{
            if !defined(Icinga2::Object::Service["${vhost}${$suffix} regex"]){
              icinga2::object::service {"${vhost}${$suffix} regex":
                ensure          => $data['ensure'],
                assign          => ["match(*_nginx-vip-${ip_tag}, host.name)",],
                groups          => ['webchecks',],
                check_command   => 'http',
                check_interval  => $service_overrides['regex']['check_interval'],
                target          => $targets['services'],
                enable_flapping => true,
                apply           => true,
                vars            => $regex_vars
              }
            }
          }
        }
      }
    }
  }
}
O código de configuração dos hosts e serviços também parece horrível:
monitoring/config.pp
class profiles::services::monitoring::config(
  Array $default_config,
  Array $hostgroups,
  Hash $hosts = {},
  Hash $host_defaults,
  Hash $services,
  Hash $service_defaults,
  Hash $service_overrides,
  Hash $webcheck_defaults,
  Hash $servicegroups,
  String $servicegroup_target,
  Hash $user_defaults,
  Hash $users,
  Hash $oncall,
  Hash $usergroup_defaults,
  Hash $usergroups,
  Hash $notifications,
  Hash $notification_defaults,
  Hash $notification_commands,
  Hash $timeperiods,
  Hash $webhost_defaults,
  Hash $apps_access_list,
  Hash $check_commands,
  Hash $hosts_api = {},
  Hash $targets = {},
  Hash $host_api_defaults = {},
)
{

  # Profiles::Services::Monitoring::Hostgroup <> # será ativado quando movermos para o icinga completamente
#### APPS ####
  case $location {
    'int', 'ext': {
      $apps_by_zone = {}
    }
    'pm': {
      $int_apps         = hiera('int_docker_apps')
      $int_app_defaults = hiera('int_docker_app_common')

      $st_apps          = hiera('staging_docker_apps')
      $srs_apps         = hiera('pm_docker_apps_srs')
      $pm_apps          = hiera('pm_docker_apps') + $st_apps + $srs_apps
      $pm_app_defaults  = hiera('pm_docker_app_common')

      $apps_by_zone = {
        'int' => $int_apps,
        'pm'  => $pm_apps,
      }

      $app_access_by_zone = {
        'int' => {'accessible_from' => $int_app_defaults['accessible_from']},
        'pm'  => {'accessible_from' => $pm_app_defaults['accessible_from']},
      }
    }

    default: {
      fail('Por favor, certifique-se de que o nó possui o fato $location definido (int, pm, ext)')
    }
  }

  file { '/etc/icinga2/conf.d/':
    ensure  => directory,
    recurse => true,
    purge   => true,
    owner   => 'icinga',
    group   => 'icinga',
    mode    => '0750',
    notify  => Service['icinga2'],
  }

  $default_config.each | String $file_name |{
    file {"/etc/icinga2/conf.d/${file_name}":
      ensure => present,
      source => "puppet://modules/profiles/services/monitoring/default_config/${file_name}",
      owner  => 'icinga',
      group  => 'icinga',
      mode    => '0640',
    }
  }

  $app_checks = {
    'ssl' => $services['webchecks']['checks']['ssl']['vars'],
    'http' => $services['webchecks']['checks']['http_regexp']['vars']
  }

  $apps_by_zone.each | String $zone, Hash $app_list | {
    profiles::services::monitoring::docker_apps{$zone:
      app_list             => $app_list,
      apps_accessible_from => $app_access_by_zone[$zone],
      apps_access_list     => $apps_access_list,
      webhost_defaults     => $webhost_defaults,
      webcheck_defaults    => $webcheck_defaults,
      service_overrides    => $service_overrides,
      targets              => $targets,
      app_checks           => $app_checks,
    }
  }

####    HOSTS    ####

  # Profiles::Services::Monitoring::Host <> # Isto é para a invasão de naves quando estiver pronta.
  $hosts_has_large_disks = query_nodes('mountpoints.*.size_bytes >= 1099511627776')

  $hosts.each | String $hostgroup, Hash $list_of_hosts_with_settings | {           # Dividindo listas de sites por grupos de hosts - docker_host/gluster_host/etc
    $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
    $hostgroup_settings     = $list_of_hosts_with_settings['settings']
    $merged_hostgroup_settings = deep_merge($host_defaults, $list_of_hosts_with_settings['settings'])
    $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{  # Dividindo listas de grupos por hosts
      # Este host está no array $hosts_has_large_disks? Se sim, defina host.vars.has_large_disks
      if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
        $vars_has_large_disks = { 'has_large_disks' => true }
      } else {
        $vars_has_large_disks = {}
      }
      $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
      $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})
      $host_settings_vars = pick($host_settings['vars'], {})
      $host_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
      $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_notify_group}, $vars_has_large_disks)) # Mesclando vars separadamente

      $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

      profiles::services::monitoring::host{$host_name:
        ensure             => $host_data['ensure'],
        display_name       => $host_data['display_name'],
        address            => $host_data['address'],
        groups             => $hostgroups,
        target             => $host_data['target'],
        check_command      => $host_data['check_command'],
        check_interval     => $host_data['check_interval'],
        max_check_attempts => $host_data['max_check_attempts'],
        vars               => $host_data_vars,
        template           => $host_data['template'],
      }
    }
  }
  if !empty($hosts_api){                                                                # Todos os hosts geridos pela API
    $hosts_api.each | String $zone, Hash $hosts_api_zone | {                            # Dividindo hosts api por zonas
      $hosts_api_zone.each | String $hostgroup, Hash $list_of_hosts_with_settings | {   # Dividindo listas de sites por grupos de hosts - docker_host/gluster_host/etc
        $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
        $hostgroup_settings     = $list_of_hosts_with_settings['settings']
        $merged_hostgroup_settings = deep_merge($host_api_defaults, $list_of_hosts_with_settings['settings'])
        $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{        # Dividindo listas de grupos por hosts
          # Este host está no array $hosts_has_large_disks? Se sim, defina host.vars.has_large_disks
          if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
            $vars_has_large_disks = { 'has_large_disks' => true }
          } else {
            $vars_has_large_disks = {}
          }
          $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
          $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})

          $host_settings_vars = pick($host_settings['vars'], {})
          $host_api_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
          $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_api_notify_group}, $vars_has_large_disks))
          $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

          if defined(Profiles::Services::Monitoring::Host[$host_name]){
            $hostname = "${host_name}_from_${zone}"
          }
          else
          {
            $hostname = $host_name
          }
          profiles::services::monitoring::host{$hostname:
            ensure             => $host_data['ensure'],
            display_name       => $host_data['display_name'],
            address            => $host_data['address'],
            groups             => $hostgroups,
            target             => "${host_data['target_base']}/${zone}/hosts.conf",
            check_command      => $host_data['check_command'],
            check_interval     => $host_data['check_interval'],
            max_check_attempts => $host_data['max_check_attempts'],
            vars               => $host_data_vars,
            template           => $host_data['template'],
          }
        }
      }
    }
  }

#### FIM DOS HOSTS ####

####   SERVIÇOS   ####

  $services.each | String $service_group, Hash $s_list |{             # Service_group e lista de serviços nesse grupo
    $service_list = $s_list['checks']                                 # Lista de checagens reais, separadamente das configurações do SG
    $service_list.each | String $service_name, Hash $data |{

      $merged_defaults = merge($service_defaults, $s_list['settings']) # defaults globais do serviço + defaults do grupo de serviços
      $merged_data = merge($merged_defaults, $data)

      $settings_vars = pick($s_list['settings']['vars'], {})
      $this_service_vars = pick($data['vars'], {})
      $all_service_vars = delete_undef_values($service_defaults['vars'] + $settings_vars + $this_service_vars)

      # Se substituirmos o check_timeout padrão, mas não o nrpe_timeout, faça nrpe_timeout ser o mesmo que check_timeout
      if ( $merged_data['check_timeout'] and ! $this_service_vars['nrpe_timeout'] ) {
        # NB: O Icinga converterá 1m para 60 automaticamente!
        $nrpe = { 'nrpe_timeout' => $merged_data['check_timeout'] }
      } else {
        $nrpe = {}
      }

      # Por padrão, usamos nrpe e todos os comandos são executados via nrpe. Então vars.nrpe_command = $service_name é um valor padrão
      # Se for um comando do Icinga do lado do servidor - não precisamos de 'nrpe_command'
      # mas não há mal em ter essa var e o código é mais curto

      if $merged_data['check_command'] == 'nrpe'{
        $check_command = $merged_data['vars']['nrpe_command'] ? {
          undef   => { 'nrpe_command' => $service_name },
          default => { 'nrpe_command' => $merged_data['vars']['nrpe_command'] }
        }
      }else{
        $check_command = {}
      }

      # Montando $vars das configurações globais padrão do serviço, configurações do grupo de serviços, configurações dessa checagem particular e não esqueçamos das configurações do nrpe.
      if $all_service_vars['graphite_template'] {
        $graphite_template = {'check_command' => $all_service_vars['graphite_template']}
      }else{
        $graphite_template = {'check_command' => $service_name}
      }
      $service_notify = [] + pick($settings_vars['notify_group'], []) + pick($this_service_vars['notify_group'], []) # pick é necessário em toda parte, caso contrário, torna-se "O valor '' não pode ser convertido em numérico"

      $service_notify_group = $service_notify ? {
        []      => $service_defaults['vars']['notify_group'],
        default => $service_notify
      } # Atribui o grupo padrão (sistemas) se nenhum outro grupo estiver definido

      $vars = $all_service_vars + $nrpe + $check_command + $graphite_template + {'notify_group' => $service_notify_group}

      # Isso precisa ser mesclado separadamente, porque mesclá-lo como parte do MERGED_DATA sobrescreve arrays em vez de mesclá-los, então perdemos alguns valores "assign" e "ignore"

      $assign = delete_undef_values($service_defaults['assign'] + $s_list['settings']['assign'] + $data['assign'])
      $ignore = delete_undef_values($service_defaults['ignore'] + $s_list['settings']['ignore'] + $data['ignore'])

      icinga2::object::service {$service_name:
        ensure             => $merged_data['ensure'],
        apply              => $merged_data['apply'],
        enable_flapping    => $merged_data['enable_flapping'],
        assign             => $assign,
        ignore             => $ignore,
        groups             => [$service_group],
        check_command      => $merged_data['check_command'],
        check_interval     => $merged_data['check_interval'],
        check_timeout      => $merged_data['check_timeout'],
        check_period       => $merged_data['check_period'],
        display_name       => $merged_data['display_name'],
        event_command      => $merged_data['event_command'],
        retry_interval     => $merged_data['retry_interval'],
        max_check_attempts => $merged_data['max_check_attempts'],
        target             => $merged_data['target'],
        vars               => $vars,
        template           => $merged_data['template'],
      }
    }
  }
#### FIM DOS SERVIÇOS ####

#### OUTRAS COISAS CHATAS ####

  $servicegroups.each | $servicegroup, $description |{
    icinga2::object::servicegroup{ $servicegroup:
      target       => $servicegroup_target,
      display_name => $description
    }
  }

  $hostgroups.each| String $hostgroup |{
    profiles::services::monitoring::hostgroup { $hostgroup:}
  }

  $notifications.each | String $name, Hash $settings |{

    $assign = pick($notification_defaults['assign'], []) + $settings['assign']
    $ignore = pick($notification_defaults['ignore'], []) + $settings['ignore']

    $merged_settings = $settings + $notification_defaults

    icinga2::object::notification{$name:
      target       => $merged_settings['target'],
      apply        => $merged_settings['apply'],
      apply_target => $merged_settings['apply_target'],
      command      => $merged_settings['command'],
      interval     => $merged_settings['interval'],
      states       => $merged_settings['states'],
      types        => $merged_settings['types'],
      assign       => delete_undef_values($assign),
      ignore       => delete_undef_values($ignore),
      user_groups  => $merged_settings['user_groups'],
      period       => $merged_settings['period'],
      vars         => $merged_settings['vars'],
    }
  }

  # Mesclando configurações de notificações para usuários com outras configurações
  $users_oncall = deep_merge($users, $oncall)
  # Magia. Não toque.
  create_resources('icinga2::object::user', $users_oncall, $user_defaults)
  create_resources('icinga2::object::usergroup', $usergroups, $usergroup_defaults)
  create_resources('icinga2::object::timeperiod',$timeperiods)
  create_resources('icinga2::object::checkcommand', $check_commands)
  create_resources('icinga2::object::notificationcommand', $notification_commands)

  profiles::services::sudoers { 'icinga_runs_ping_l2':
    ensure            => present,
    sudoersd_template => 'profiles/os/redhat/centos7/sudoers/icinga.erb',
  }

}
Ainda estou trabalhando neste código e melhorando-o sempre que possível. No entanto, esse código permite usar uma sintaxe simples e clara no Hiera:
Dados
profiles::services::monitoring::config::services:
  perf_checks:
    settings:
      check_interval: '2m'
      assign:
        - 'host.vars.type == linux'
    checks:
      procs: {}
      load: {}
      memory: {}
      disk:
        check_interval: '5m'
        vars:
          notification_period: '24x7'
      disk_iops:
        vars:
          notifications:
            - 'silent'
      cpu:
        vars:
          notifications:
            - 'silent'
      dns_fqdn:
        check_interval: '15m'
        ignore:
          - 'xenserver in host.groups'
        vars:
          notifications:
            - 'silent'
      iftraffic_nrpe:
        vars:
          notifications:
            - 'silent'
  logging:
    settings:
      assign:
        - 'logserver in host.groups'
    checks:
       rsyslog: {}
      nginx_limit_req_other: {}
      nginx_limit_req_s2s: {}
      nginx_limit_req_s2x: {}
      nginx_limit_req_srs: {}
     logstash: {}
      logstash_api:
        vars:
          notifications:
            - 'silent'
Todas as verificações são agrupadas, e cada grupo possui configurações padrão sobre onde e com que frequência executar essas verificações, quais notificações enviar e para quem.
Em cada verificação, é possível sobrescrever qualquer opção, e tudo isso se soma ainda às configurações padrão de todas as verificações em geral. Por isso, o config.pp é escrito dessa forma — ele realiza a fusão de todas as configurações padrão com as configurações dos grupos e, em seguida, com cada verificação individual.
Uma mudança muito importante foi a possibilidade de usar funções nas configurações, por exemplo, uma função para substituir a porta, o endereço e o URL para a verificação http_regex.
http_regexp:
  assign:
    - 'host.vars.http_regex'
    - 'static_sites in host.groups'
  check_command: 'http'
  check_interval: '1m'
  retry_interval: '20s'
  max_check_attempts: 6
  http_port: '{{ if(host.vars.http_port) { return host.vars.http_port } else { return 443 } }}'
  vars:
    notification_period: 'host.vars.notification_period'
    http_vhost: '{{ if(host.vars.http_vhost) { return host.vars.http_vhost } else { return host.name } }}'
    http_ssl: '{{ if(host.vars.http_ssl) { return false } else { return true } }}'
    http_expect_body_regex: 'host.vars.http_regex'
    http_uri: '{{ if(host.vars.http_uri) { return host.vars.http_uri } else { return "\/" } }}'
    http_onredirect: 'follow'
    http_warn_time: 8
    http_critical_time: 15
    http_timeout: 30
    http_sni: true
Isso significa — se na definição do host existe a variável http_port — utilize-a, caso contrário, 443. Por exemplo, a interface web do jabber fica em 9090, enquanto o Unifi está em 7443.
http_vhost significa ignorar o DNS e usar esse endereço.
Se um URI for especificado no host — siga-o, caso contrário, use "\/".
Com http_ssl, surgiu uma história engraçada — essa coisa não queria ser desativada sob demanda. Demorei um tempo para entender essa linha, até perceber que a variável na definição do host:
http_ssl: falseSubstitui-se na expressão
if(host.vars.http_ssl) { return false } else { return true }como falso e no final resulta em
if(false) { return false } else { return true }ou seja, a verificação ssl está sempre ativa. Foi resolvido trocando a sintaxe:
http_ssl: noComo resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.:
Acesso direto aos sistemas de cabos transpacíficos. Ping mínimo para a China, Japão, Austrália e costa oeste dos EUA.
- Agora temos um único sistema de monitoramento, e não dois, como nos últimos 7-8 meses, ou um que era obsoleto e vulnerável.
- A estrutura dos dados dos hosts / serviços (verificações) agora parece, na minha opinião, muito mais legível e compreensível. Para outros, isso não foi tão óbvio, então tive que criar algumas páginas na wiki local para esclarecer como tudo funciona e onde fazer alterações.
- Há a possibilidade de configuração flexível das verificações usando variáveis e funções, por exemplo, para verificar http_regexp o padrão buscado, o código de retorno, a url e a porta podem ser definidos nas configurações do host.
- Existem vários painéis (dashboards), para os quais é possível definir sua própria lista de alarmes exibidos e gerenciar tudo isso através do Puppet e merge requests.
Pontos negativos:
- Inércia dos membros da equipe — Nagios trabalhava, trabalhava e trabalhava, enquanto seu Icinga constantemente travava e falhava. E como posso ver o histórico? Ah, droga, ele não é atualizado… (Um problema real — o histórico de alarmes não é atualizado automaticamente, apenas com F5)
- Inércia do sistema — quando clico na interface web em "atualizar" (check now) — o resultado da execução depende das condições no Marte, especialmente em serviços complicados que requerem dezenas de segundos para serem executados. Um resultado assim é normal.

- No geral, ao longo de seis meses de estatísticas de operação de dois sistemas lado a lado, Nagios sempre funcionou mais rápido do que Icinga e isso me incomodou muito. Pelo que parece, algo foi mexido com os timers e a verificação a cada cinco minutos na verdade ocorre a cada 5:30 ou algo do tipo.
- Se reiniciar o serviço a qualquer momento (systemctl restart icinga2) — todas as verificações que estavam em processo de execução naquele momento emitirão um alerta crítico <terminado pelo sinal 15> na tela e, do lado de fora, parece que tudo caiu ().
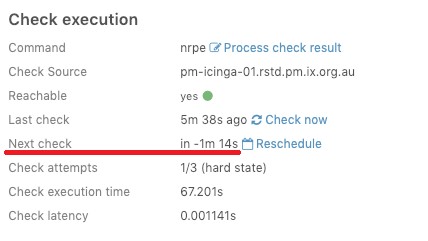
Mas, no geral — ele funciona.
Fonte: habr.com
