

Olá a todos! Em minha Escrevi sobre a organização de um sistema modular de monitoramento para uma arquitetura de microserviços. Nada permanece parado, nosso projeto está sempre crescendo, assim como a quantidade de métricas armazenadas. Como organizamos a transição de Graphite+Whisper para Graphite+ClickHouse sob altas cargas, as expectativas sobre isso e os resultados da migração, você pode ler abaixo.
Antes de explicar como organizamos a transição do armazenamento de métricas em Graphite+Whisper para Graphite+ClickHouse, gostaria de fornecer informações sobre as razões que nos levaram a essa decisão e sobre as desvantagens do Whisper, com as quais vivenciamos por um longo tempo.
Problemas de Graphite+Whisper
1. Alta carga no subsistema de disco
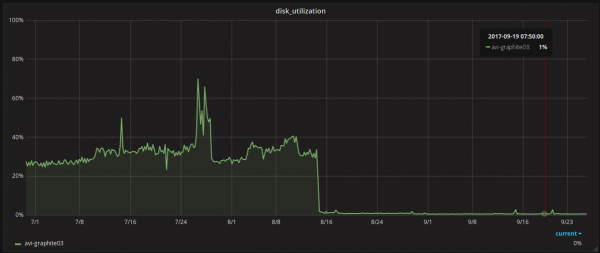
No momento da transição, recebíamos cerca de 1,5 milhões de métricas por minuto. Com esse fluxo, a utilização do disco nos servidores era de aproximadamente 30%. No geral, isso era bastante aceitável — tudo funcionava de forma estável, era escrito rapidamente e lido de forma ágil... Até o momento em que uma das equipes de desenvolvimento lançou uma nova funcionalidade e começou a enviar 10 milhões de métricas por minuto. Foi então que o subsistema de disco ficou sobrecarregado e vimos uma utilização de 100%. O problema foi resolvido rapidamente, mas ficou um certo desconforto.
2. Ausência de replicação e consistência
Provavelmente, assim como todos que usam/usarão o Graphite+Whisper, nós canalizávamos um fluxo idêntico de métricas simultaneamente para vários servidores Graphite com o objetivo de criar resistência a falhas. Não havia grandes problemas com isso — até o momento em que um dos servidores falhava por algum motivo. Às vezes conseguíamos reiniciar o servidor caído rapidamente e o carbon-c-relay conseguia injetar as métricas de seu cache, e outras vezes não. E então havia uma lacuna nas métricas, que nós preenchíamos com rsync. O procedimento era bastante demorado. O que nos salvava era que isso acontecia muito raramente. Também periodicamente pegávamos um conjunto aleatório de métricas e comparávamos com outros conjuntos semelhantes em nós vizinhas do cluster. Em cerca de 5% dos casos, alguns valores diferiam, o que não era muito animador para nós.
3. Grande volume de espaço ocupado
Como escrevemos no Graphite não apenas métricas de infraestrutura, mas também métricas de negócios (e agora também métricas do Kubernetes), frequentemente enfrentamos uma situação em que a métrica contém apenas alguns valores, enquanto o arquivo .wsp é criado considerando todo o período de retenção, ocupando um espaço instalado que era de aproximadamente 2MB. O problema é agravado pelo fato de que tais arquivos se acumulam com o tempo, e ao gerar relatórios sobre eles, leva-se muito tempo e recursos para ler pontos vazios.
Gostaria de destacar que os problemas descritos acima podem ser combatidos de diversas maneiras e com diferentes níveis de eficiência, mas quanto mais dados você começa a receber, mais intensamente eles se agravam.
Tendo em conta tudo o que foi mencionado acima (considerando o anterior ), assim como o aumento constante no número de métricas recebidas, o desejo de reduzir todos os intervalos de armazenamento para 30 segundos (se necessário — até 10 segundos), decidimos experimentar o Graphite+ClickHouse como uma alternativa promissora ao Whisper.
Graphite+ClickHouse. Expectativas
Após participar de vários meetups com a equipe do Yandex e ler , rigorosamente analisando a documentação e encontrando componentes viáveis para a integração do ClickHouse com o Graphite, decidimos agir!
Gostaríamos de obter o seguinte:
- reduzir a utilização do subsistema de disco de 30% para 5%;
- reduzir o espaço ocupado de 1TB para 100GB;
- ter a capacidade de receber 100 milhões de métricas por minuto no servidor;
- replicação de dados e tolerância a falhas "out of the box";
- não passar um ano neste projeto e fazer a migração dentro de um prazo razoável;
- realizar a transição sem tempo de inatividade.
Bastante ambicioso, não?
Graphite+ClickHouse. Componentes
Para obter dados pelo protocolo Graphite e gravá-los no ClickHouse, optamos pelo (golang).
Como banco de dados para armazenamento de séries temporais, escolhemos o último lançamento estável do ClickHouse na versão 1.1.54253. Ao trabalhar com ele, encontramos problemas: um monte de erros eram registrados nos logs, e não estava muito claro como lidar com eles. Em discussão com (autor do carbon-clickhouse, graphite-clickhouse e muito mais) escolhemos uma versão mais antiga . Os erros desapareceram — tudo começou a funcionar perfeitamente.
Para leitura de dados do ClickHouse, optamos pelo (golang). Como interface de API para o Graphite — (golang). Para organizar a replicação entre as tabelas ClickHouse, foi utilizado . Para a roteação de métricas, mantivemos nosso amado (C) .
Graphite+ClickHouse. Estrutura das tabelas
“graphite” — banco de dados criado por nós para as tabelas de monitoramento.
“graphite.metrics” — tabela com o mecanismo ReplicatedReplacingMergeTree (replicada ). Nesta tabela, são armazenados os nomes das métricas e seus caminhos.
CREATE TABLE graphite.metrics ( Date Date, Level UInt32, Path String, Deleted UInt8, Version UInt32 ) ENGINE = ReplicatedReplacingMergeTree('\/clickhouse\/tables\/replicator\/graphite.metrics', 'r1', Date, (Level, Path), 8192, Version);“graphite.data” — tabela com o mecanismo ReplicatedGraphiteMergeTree (replicada ). Nesta tabela, são armazenados os valores das métricas.
CREATE TABLE graphite.data ( Path String, Value Float64, Time UInt32, Date Date, Timestamp UInt32 ) ENGINE = ReplicatedGraphiteMergeTree('\/clickhouse\/tables\/replicator\/graphite.data', 'r1', Date, (Path, Time), 8192, 'graphite_rollup')“graphite.date_metrics” — tabela preenchida sob condição, com o mecanismo ReplicatedReplacingMergeTree. Nesta tabela são registradas os nomes de todas as métricas que apareceram durante o dia. As razões para a criação estão descritas na seção no final deste artigo.
CREATE MATERIALIZED VIEW graphite.date_metrics ( Path String, Level UInt32, Date Date) ENGINE = ReplicatedReplacingMergeTree('\/clickhouse\/tables\/replicator\/graphite.date_metrics', 'r1', Date, (Level, Path, Date), 8192) AS SELECT toUInt32(length(splitByChar('.', Path))) AS Level, Date, Path FROM graphite.data“graphite.data_stat” — tabela preenchida sob condição, com o mecanismo ReplicatedAggregatingMergeTree (replicada ). Nesta tabela é registrado o número de métricas recebidas, com detalhamento de até 4 níveis de profundidade.
CREATE MATERIALIZED VIEW graphite.data_stat ( Date Date, Prefix String, Timestamp UInt32, Count AggregateFunction(count)) ENGINE = ReplicatedAggregatingMergeTree('\/clickhouse\/tables\/replicator\/graphite.data_stat', 'r1', Date, (Timestamp, Prefix), 8192) AS SELECT toStartOfMonth(now()) AS Date, replaceRegexpOne(Path, '^([^.]+.[^.]+.[^.]+).*$', '1') AS Prefix, toUInt32(toStartOfMinute(toDateTime(Timestamp))) AS Timestamp, countState() AS Count FROM graphite.data GROUP BY Timestamp, PrefixGraphite+ClickHouse. Esquema de interação dos componentes
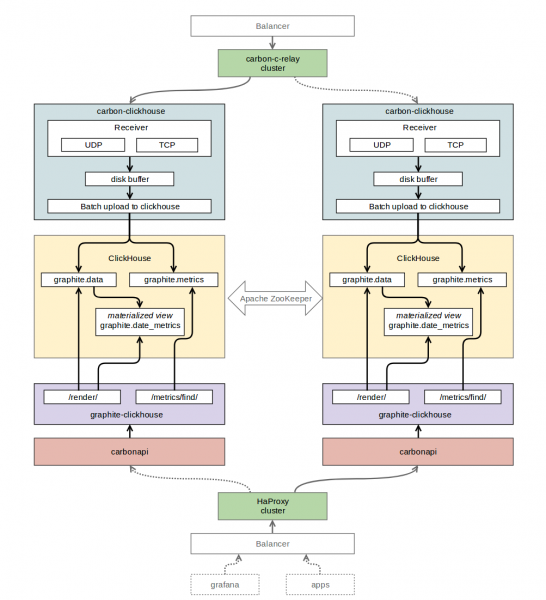
Graphite+ClickHouse. Migração de dados
Como lembramos das expectativas deste projeto, a transição para ClickHouse deve ocorrer sem downtime, portanto, de alguma forma, deveríamos alternar todo o nosso sistema de monitoramento para o novo armazenamento de maneira transparente para nossos usuários.
Fizemos isso da seguinte forma.
No carbon-c-relay, adicionamos uma regra para enviar um fluxo adicional de métricas para carbon-clickhouse em um dos servidores envolvidos na replicação das tabelas ClickHouse.
Escrevemos um pequeno script em Python que, usando a biblioteca whisper-dump, extraía todos os arquivos .wsp do nosso armazenamento e enviava esses dados para o carbon-clickhouse em 24 threads. O número de métricas recebidas pelo carbon-clickhouse chegou a 125 milhões/min, e o ClickHouse não teve dificuldades.
Criamos uma DataSource separada no Grafana com o objetivo de depurar funções usadas nos dashboards existentes. Identificamos uma lista de funções que utilizamos, mas que não estavam implementadas no carbonapi. Adicionamos essas funções e enviamos PRs para os autores do carbonapi (muito obrigado a eles).
- Para mudar a carga de leitura, nas configurações dos balanceadores mudamos os endpoints de graphite-api (interface API para Graphite+Whisper) para carbonapi.
Graphite+ClickHouse. Resultados
reduzimos a utilização do subsistema de disco de 30% para 1%;

- reduzimos o espaço ocupado de 1 TB para 300 GB;
- temos a capacidade de receber 125 milhões de métricas por minuto no servidor (picos durante a migração);
- transferimos todas as métricas para um intervalo de retenção de trinta segundos;
- obtivemos replicação de dados e alta disponibilidade;
- executei a mudança sem downtime;
- levou cerca de 7 semanas no total.
Graphite+ClickHouse. Problemas
No nosso caso, também enfrentamos algumas armadilhas. Aqui está o que encontramos após a transição.
- O ClickHouse nem sempre lê as configurações em tempo real, às vezes é necessário reiniciá-lo. Por exemplo, no caso da descrição do cluster zookeeper na configuração do ClickHouse — essa configuração não foi aplicada até a reinicialização do clickhouse-server.
- Consultas grandes não eram processadas pelo ClickHouse, portanto, nossa string de conexão para ClickHouse no graphite-clickhouse é assim:
url = "http://localhost:8123/?max_query_size=268435456&max_ast_elements=1000000" - O ClickHouse frequentemente lança novas versões estáveis, e elas podem trazer surpresas: fique atento.
- Contêineres criados dinamicamente no Kubernetes enviam uma grande quantidade de métricas com um curto e aleatório período de vida. O número de pontos de métricas não é grande, e não há problemas com espaço. No entanto, ao construir consultas, o ClickHouse busca uma quantidade enorme dessas métricas da tabela 'metrics'. Em 90% dos casos, os dados nessa janela (24 horas) estão ausentes. E o tempo para procurar esses dados na tabela 'data' é utilizado, o que, no final das contas, resulta em um timeout. Para resolver esse problema, começamos a manter uma visualização separada com informações sobre as métricas que apareceram ao longo do dia. Assim, ao construir relatórios (gráficos) sobre contêineres criados dinamicamente, consultamos apenas as métricas que estavam presentes dentro da janela especificada, e não durante todo o tempo, o que acelerou consideravelmente a construção de relatórios sobre elas. Para a solução descrita acima, reunimos , incluindo a implementação do trabalho com a tabela date_metrics.
Graphite+ClickHouse. Tags
A partir da versão 1.1.0, o Graphite passou a oficialmente . E estamos ativamente pensando em como devemos implementar isso para apoiar essa iniciativa na pilha graphite+clickhouse.
Graphite+ClickHouse. Detector de anomalias
Com base na infraestrutura descrita acima, implementamos um protótipo de detector de anomalias, e ele está funcionando! Mas sobre isso - no próximo artigo.
Inscreva-se, clique na seta para cima e seja feliz!
Fonte: habr.com
