

Hoje, em nosso projeto, além do código monolítico, funcionam dezenas de microsserviços. Cada um deles requer monitoramento. Fazer isso em tal escala com a ajuda de engenheiros DevOps é problemático. Desenvolvemos um sistema de monitoramento que funciona como um serviço para os desenvolvedores. Eles podem escrever métricas para o sistema de monitoramento, utilizá-las, criar painéis com base nelas, e configurar alertas que serão acionados ao atingirem limites predefinidos. Os engenheiros DevOps cuidam apenas da infraestrutura e da documentação.
Esta postagem é a transcrição da minha apresentação na nossa na RIT++. Muitos pediram que fizéssemos versões textuais das palestras lá. Se você estava na conferência ou assistiu ao vídeo, não encontrará nada de novo. E para todos os outros — bem-vindos ao post. Vou contar como chegamos a esse sistema, como ele funciona e como planejamos atualizá-lo.
O passado: esquemas e planos
Como chegamos ao sistema de monitoramento existente? Para responder a essa pergunta, precisamos voltar a 2015. Veja como era naquela época:
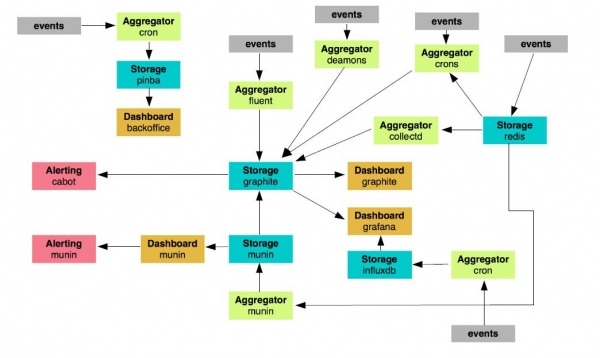
Tínhamos cerca de 24 nós responsáveis pelo monitoramento. Aqui havia um conjunto de diferentes cron jobs, scripts, daemons que monitoravam algo de alguma forma, enviavam mensagens, executavam funções. Pensamos que quanto mais avançássemos, menos viável seria tal sistema. Não fazia sentido desenvolvê-lo: era muito pesado.
Decidimos escolher os elementos de monitoramento que manteríamos e desenvolveríamos, e aqueles dos quais desistiríamos. Afinal, restaram 19. Fomos deixados apenas com Graphite, agregadores e Grafana como painel. Mas como será o novo sistema? Assim:
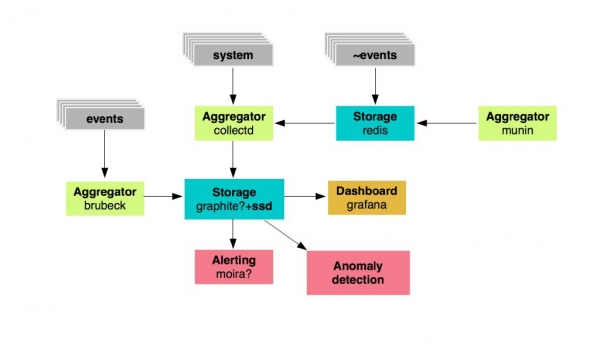
Temos um armazenamento de métricas: são os Graphites, que serão baseados em SSDs rápidos, além de determinados agregadores para métricas. Em seguida — Grafana para exibição de painéis e Moira como sistema de alerta. Também queríamos desenvolver um sistema para detecção de anomalias.
Padrão: Monitoramento 2.0
Assim eram os planos em 2015. Mas precisávamos preparar não apenas a infraestrutura e o próprio serviço, mas também a documentação para ele. Desenvolvemos para nós um padrão corporativo que chamamos de monitoramento 2.0. Quais eram os requisitos para o sistema?
- disponibilidade constante;
- intervalo de armazenamento de métricas = 10 segundos;
- armazenamento estruturado de métricas e painéis;
- SLA > 99,99%
- coleta de métricas de eventos via UDP (!).
Precisávamos de UDP, pois temos um grande fluxo de tráfego e eventos que geram métricas. Se todas fossem escritas de uma vez no Graphite, o armazenamento falharia. Também optamos por prefixos de primeiro nível para todas as métricas.
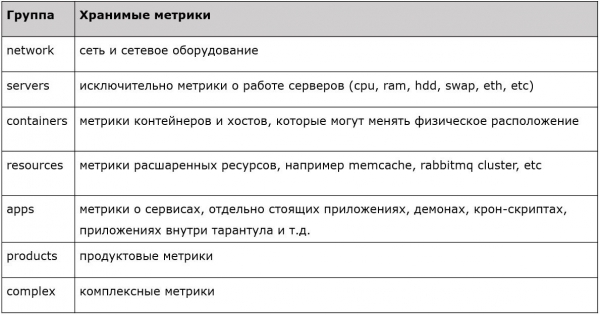
Cada prefixo tem uma propriedade específica. Existem métricas para servidores, redes, containers, recursos, aplicações e assim por diante. Implementamos um filtro claro, rigoroso e tipificado, onde aceitamos métricas de primeiro nível e descartamos as restantes. Assim planejamos este sistema em 2015. E o que temos agora?
O presente: esquema de interação dos componentes de monitoramento
Em primeiro lugar, monitoramos as aplicações: nosso código PHP, aplicações e microserviços - em suma, tudo que nossos desenvolvedores escrevem. Todas as aplicações enviam métricas para o agregador Brubeck (statsd, reescrito em C) via UDP. Ele se mostrou o mais rápido em testes sintéticos. E já envia métricas agregadas para o Graphite via TCP.
Ele possui um tipo de métrica chamado timers. Isso é muito útil. Por exemplo, para cada conexão do usuário com o serviço, você envia uma métrica de tempo de resposta para o Brubeck. Chegaram um milhão de respostas, e o agregador retornou apenas 10 métricas. Você possui a contagem de visitantes, o tempo máximo, mínimo e médio de resposta, a mediana e 4 percentis. Depois, os dados são enviados ao Graphite e podemos vê-los todos ao vivo.
Também temos agregação para métricas de hardware, software, métricas do sistema e nosso antigo sistema de monitoramento Munin (que funcionou até 2015). Coletamos tudo isso através do daemon CollectD em C (ele tem uma série de plugins diversos embutidos, capaz de interrogar todos os recursos do sistema host em que está instalado, é só especificar na configuração onde enviar os dados) e escrevemos os dados no Graphite. Ele também suporta plugins Python e scripts shell, então você pode criar suas soluções personalizadas: o CollectD coletará esses dados de um host local ou remoto (suponha que haja Curl) e os enviará para o Graphite.
A seguir, todas as métricas que coletamos são enviadas para o Carbon-c-relay. Esta é uma solução do Carbon Relay da Graphite, desenvolvida em C. É um roteador que agrega todas as métricas que enviamos de nossos agregadores e as roteia para os nós. Além disso, na fase de roteamento, ele verifica a validade das métricas. Elas, por um lado, devem corresponder ao esquema com prefixos que mostrei anteriormente e, por outro, ser válidas para o Graphite. Caso contrário, são descartadas.
Em seguida, o Carbon-c-relay envia as métricas para o cluster Graphite. Usamos o Carbon-cache, reescrito em Go, como nosso principal repositório de métricas. O Go-carbon, devido à sua capacidade de multitarefa, supera em desempenho o Carbon-cache. Ele aceita os dados e os grava em discos utilizando o pacote whisper (o padrão, escrito em Python). Para ler os dados de nossos repositórios, utilizamos a API do Graphite. Ela funciona muito mais rápido do que o padrão Graphite WEB. O que acontece com os dados depois?
Eles vão para o Grafana. Usamos nossos clusters Graphite como a principal fonte de dados, além de termos o Grafana como interface web para exibição de métricas e construção de painéis. Cada serviço tem seu próprio painel, onde constrõem gráficos que mostram as métricas que registram de suas aplicações. Além do Grafana, temos também o SLAM. Este é um daemon em Python que calcula o SLA com base nos dados do Graphite. Como mencionei, temos várias dezenas de microsserviços, cada um com seus próprios requisitos. Com o SLAM, consultamos a documentação e a comparamos com o que existe no Graphite para verificar a conformidade dos requisitos com a disponibilidade de nossos serviços.
Continuando: o alerta. Ele é organizado por meio de um sistema robusto — o Moira. Ele é independente porque possui seu próprio Graphite em seu núcleo. Foi desenvolvido por pessoal da SKB 'Kontur', escrito em Python e Go, e é totalmente open-source. O Moira recebe o mesmo fluxo de dados que vai para os Graphites. Se, por algum motivo, seu repositório falhar, seu sistema de alertas continuará funcionando.
Implementamos o Moira no Kubernetes, utilizando um cluster de servidores Redis como banco de dados principal. O resultado foi um sistema resiliente. Ele compara o fluxo de métricas com uma lista de gatilhos: se não houver menções, descarta a métrica. Assim, ele é capaz de processar gigabytes de métricas por minuto.
Além disso, conectamos um LDAP corporativo, que permite que cada usuário do sistema corporativo crie notificações para gatilhos existentes (ou novos). Como o Moira contém o Graphite, ele suporta todas as suas funcionalidades. Portanto, você primeiro pega uma linha e a copia para o Grafana. Veja como os dados aparecem nos gráficos. Então, você pega essa mesma linha e a copia para o Moira. Você define limites e recebe alertas como resultado. Para fazer tudo isso, você não precisa de conhecimentos específicos. O Moira pode enviar alertas via SMS, e-mail, Jira, Slack… Também suporta a execução de scripts personalizados. Quando um gatilho ocorre e ele está inscrito em um script ou executável personalizado, ele o inicia e passa um JSON para o stdin desse executável. Assim, seu programa deve analisar esse JSON. O que você fará com esse JSON — decide você. Quer enviar para o Telegram, quer abrir tarefas no Jira, faça o que quiser.
Para os alertas, usamos também uma solução desenvolvida internamente — o Imagotag. Adaptamos um painel normalmente usado para etiquetas eletrônicas em lojas para nossas necessidades. Exibimos nele os gatilhos do Moira. Nele, está indicado em qual estado eles estão e quando ocorreram. Parte da equipe de desenvolvimento desistiu das notificações no Slack e no e-mail em favor deste painel.
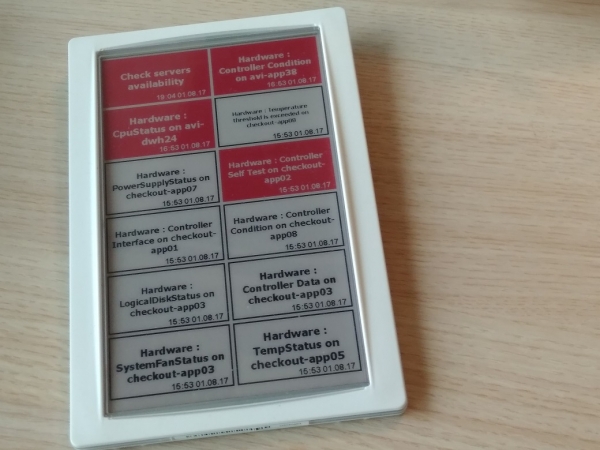
E como somos uma empresa inovadora, monitoramos também o Kubernetes nesse sistema. O integramos usando o Heapster, que instalamos no cluster, que coleta dados e os envia para o Graphite. No final, este é o diagrama:
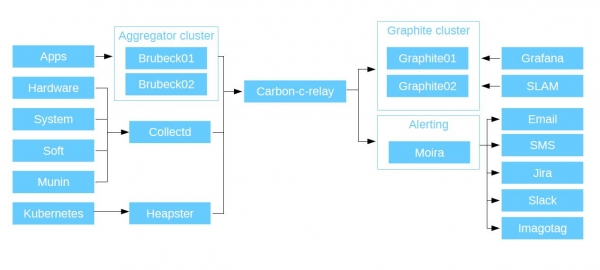
Componentes de Monitoramento
Aqui está uma lista de links para os componentes que utilizamos para essa tarefa. Todos eles são open-source.
Graphite:
- go-carbon:
- whisper:
- graphite-api:
Carbon-c-relay:
Brubeck:
Collectd:
Moira:
Grafana:
Heapster:
Estatísticas
Aqui estão alguns números sobre como o sistema funciona para nós.
Agregador (brubeck)
Número de métricas: ~ 300 000 / seg
Intervalo de envio de métricas ao Graphite: 30 seg
Uso de recursos do servidor: ~ 6% CPU (referente a servidores completos); ~ 1Gb RAM; ~ 3 Mbps LAN
Graphite (go-carbon)
Número de métricas: ~ 1 600 000 / min
Intervalo de atualização de métricas: 30 seg
Esquema de armazenamento de métricas: 30seg 35d, 5min 90d, 10min 365d (oferece uma visão do que acontece com o serviço ao longo do tempo)
Uso de recursos do servidor: ~ 10% CPU; ~ 20Gb RAM; ~ 30 Mbps LAN
Flexibilidade
Nós, da Avito, valorizamos muito a flexibilidade em nosso serviço de monitoramento. Por que ele se tornou assim? Em primeiro lugar, seus componentes são intercambiáveis: tanto os próprios componentes quanto suas versões. Em segundo lugar, a manutenção. Como todo o projeto é baseado em código aberto, você pode editar o código, fazer alterações e implementar funcionalidades que não estão disponíveis por padrão. Utilizamos pilhas bastante comuns, principalmente Go e Python, o que torna isso bastante simples.
Aqui está um exemplo de um problema que realmente surgiu. Uma métrica no Graphite é um arquivo. Ele tem um nome. O nome do arquivo = nome da métrica. E há um caminho para ele. Nomes de arquivos no Linux são limitados a 255 caracteres. E temos (como 'clientes internos') pessoas do departamento de banco de dados. Eles nos dizem: 'Queremos monitorar nossas consultas SQL. E elas não têm 255 caracteres, mas 8 MB cada. Queremos exibi-las no Grafana, ver os parâmetros para essa consulta, e ainda melhor, queremos ver as principais dessas consultas. Seria ótimo se isso fosse exibido em tempo real. E seria incrível se pudéssemos incluí-las em alertas.'
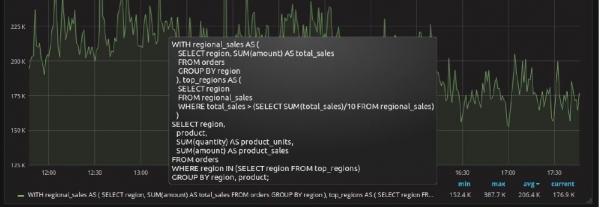
Exemplo de consulta SQL selecionado como exemplo de
Estamos configurando um servidor Redis e nossos plugins Collectd, que acessam o Postgres e extraem todos os dados, enviando as métricas para o Graphite. Mas substituímos o nome da métrica por hashes. Este mesmo hash é enviado ao Redis como chave, e toda a consulta SQL como valor. Precisamos fazer com que o Grafana consiga acessar o Redis e obter essas informações. Abrimos a API do Graphite, pois é a principal interface de interação entre todos os componentes de monitoramento e o Graphite, e adicionamos uma nova função chamada aliasByHash() — do Grafana obtemos o nome da métrica e o usamos na consulta ao Redis como chave, recebendo em resposta o valor da chave, que é nossa “consulta SQL”. Dessa forma, exibimos no Grafana a consulta SQL, que, em teoria, não poderia ser exibida lá, juntamente com as estatísticas relacionadas (calls, rows, total_time, ...).
Resultados
Disponibilidade. Nosso serviço de monitoramento está disponível 24 horas por dia, 7 dias por semana, de qualquer aplicativo e qualquer código. Se você tiver acesso aos repositórios, pode enviar dados para o serviço. A linguagem não importa, as soluções não importam. Você só precisa saber como abrir um socket, enviar a métrica e fechar o socket.
Confiabilidade. Todos os componentes são tolerantes a falhas e lidam bem com nossas cargas de trabalho.
Baixa barreira de entrada. Para usar este sistema, você não precisa aprender linguagens de programação e consultas no Grafana. Basta abrir seu aplicativo, inserir um socket que enviará as métricas para o Graphite, fechá-lo, abrir o Grafana, criar dashboards lá e observar o comportamento de suas métricas, recebendo notificações através do Moira.
Autonomia. Tudo isso pode ser feito por conta própria, sem a ajuda de engenheiros de DevOps. E isso é um overkill, porque você pode monitorar seu projeto agora mesmo, sem precisar pedir ajuda — nem para começar a trabalhar, nem para fazer alterações.
A que estamos nos esforçando?
Tudo o que está listado abaixo não são apenas pensamentos abstratos, mas sim objetivos para os quais já foram dados pelo menos os primeiros passos.
- Detetor de anomalias. Queremos criar um serviço que acesse nossos repositórios Graphite e verifique cada métrica usando vários algoritmos. Já temos algoritmos que queremos revisar, temos dados, e sabemos como trabalhar com eles.
- Metadados. Temos muitos serviços que mudam com o tempo, assim como as pessoas que trabalham com eles. Manter documentação manualmente não é uma opção. Por isso, agora nossos microsserviços incorporam metadados. Lá está registrado quem o desenvolveu, as linguagens com as quais interage, os requisitos de SLA, para onde e para quem enviar notificações. No processo de implantação do serviço, todos os dados da entidade são gerados automaticamente. No final, você recebe dois links — um para os gatilhos, o outro para os dashboards no Grafana.
- Monitoramento em cada casa. Acreditamos que todos os desenvolvedores devem usar um sistema assim. Dessa forma, você sempre entende onde está seu tráfego, o que está acontecendo com ele, onde ele falha e quais são seus pontos fracos. Se, por exemplo, algo inesperado acontecer e derrubar seu serviço, você será avisado não quando receber uma ligação do gerente, mas por um alerta, e imediatamente poderá abrir os logs recentes e ver o que ocorreu.
- Alta performance. Nosso projeto está em constante crescimento e hoje processa cerca de 2.000.000 de valores de métricas por minuto. Um ano atrás, esse número era de 500.000. O crescimento continua, e isso significa que em breve o Graphite (whisper) começará a sobrecarregar bastante o sistema de armazenamento. Como já mencionei, esse sistema de monitoramento é bastante versátil devido à intercambialidade dos componentes. Algumas pessoas mantêm e expandem continuamente sua infraestrutura especialmente para o Graphite, mas nós decidimos seguir por outro caminho: usar como nosso repositório de métricas. Essa transição está praticamente concluída, e em breve contarei mais detalhes sobre como foi feito: quais dificuldades surgiram e como foram superadas, como foi o processo de migração, descreverei os componentes escolhidos como suporte e suas configurações.
Obrigado pela atenção! Fiquem à vontade para fazer suas perguntas sobre o assunto, tentarei responder aqui ou nos próximos posts. Talvez alguém tenha experiência na construção de um sistema de monitoramento semelhante ou na migração para o Clickhouse em uma situação parecida — compartilhe nos comentários.
Fonte: habr.com
