

Encontrei um material interessante sobre inteligência artificial em jogos. Com explicações básicas sobre IA usando exemplos simples, além de muitas ferramentas e métodos úteis para seu desenvolvimento e design práticos. Como, onde e quando usá-los — também está incluído.
A maioria dos exemplos está escrita em pseudocódigo, portanto, conhecimentos profundos de programação não serão necessários. Na sequência, há 35 páginas de texto com imagens e gifs, então prepare-se.
UPD. Peço desculpas, mas já fiz minha própria tradução deste artigo no Habrahabr . Você pode ler a versão dele , mas por algum motivo, o artigo passou despercebido por mim (usei a pesquisa, mas algo não funcionou). E como escrevo em um blog dedicado ao desenvolvimento de jogos, decidi deixar minha versão da tradução para os assinantes (alguns pontos estão formatados de maneira diferente, outros — intencionalmente omitidos por conselho dos desenvolvedores).
O que é IA?
A IA em jogos se concentra nas ações que um objeto deve realizar, com base nas condições em que se encontra. Isso é geralmente chamado de gerenciamento de "agentes inteligentes", onde o agente pode ser um personagem do jogo, um veículo, um bot ou, às vezes, algo mais abstrato: um grupo inteiro de entidades ou até mesmo uma civilização. Em cada caso, é algo que deve perceber seu ambiente, tomar decisões com base nisso e agir de acordo. Isso é chamado de ciclo Sense/Think/Act (Perceber/Pensar/Agir):
- Sense: o agente encontra ou recebe informações sobre coisas em seu ambiente que podem afetar seu comportamento (ameaças próximas, itens para coleta, locais interessantes para exploração).
- Think: o agente decide como reagir (considera se é seguro coletar itens ou se primeiro deve lutar/escapar).
- Act: o agente executa ações para realizar a decisão anterior (começa a se mover em direção ao inimigo ou ao item).
- …agora a situação mudou devido às ações dos personagens, portanto, o ciclo se repete com novos dados.
A IA, geralmente, se concentra na parte Sense do ciclo. Por exemplo, carros autônomos fazem imagens da estrada, as combinam com dados de radar e lidar, e interpretam. Normalmente, isso é feito por meio de aprendizado de máquina, que processa os dados de entrada e lhes atribui significado, extraindo informações semânticas como "há mais um carro a 20 jardas à sua frente". Esses são chamados de problemas de classificação.
Os jogos não precisam de um sistema complexo para extrair informações, pois a maior parte dos dados já faz parte integrante deles. Não é necessário rodar algoritmos de reconhecimento de imagens para determinar se há um inimigo à frente — o jogo já sabe e transmite informações diretamente no processo de tomada de decisão. Portanto, a parte do ciclo Sense é muitas vezes muito mais simples do que Think e Act.
Limitações da IA em jogos
A IA tem uma série de limitações que precisam ser observadas:
- A IA não precisa ser treinada antecipadamente, como se fosse um algoritmo de aprendizado de máquina. É sem sentido criar uma rede neural durante o desenvolvimento para observar dezenas de milhares de jogadores e aprender a melhor forma de jogar contra eles. Por quê? Porque o jogo não foi lançado e não há jogadores.
- O jogo deve entreter e desafiar, portanto, os agentes não devem encontrar a melhor abordagem contra humanos.
- Os agentes precisam parecer realistas, para que os jogadores sintam que estão jogando contra pessoas reais. O programa AlphaGo superou os humanos, mas os passos selecionados estavam muito distantes da compreensão tradicional do jogo. Se o jogo imita um oponente humano, esse sentimento não deve existir. O algoritmo precisa ser ajustado para que ele tome decisões plausíveis, e não ideais.
- A IA deve operar em tempo real. Isso significa que o algoritmo não pode monopolizar o uso da CPU por longos períodos para tomar decisões. Até mesmo 10 milissegundos para isso é muito tempo, pois a maioria dos jogos precisa de entre 16 a 33 milissegundos para processar tudo e passar para o próximo quadro gráfico.
- É ideal que pelo menos parte do sistema seja controlada por dados, para que "não-codificadores" possam fazer mudanças e para que os ajustes ocorram mais rapidamente.
Vamos considerar abordagens para a IA que abrangem todo o ciclo Sense/Think/Act.
Tomando decisões básicas
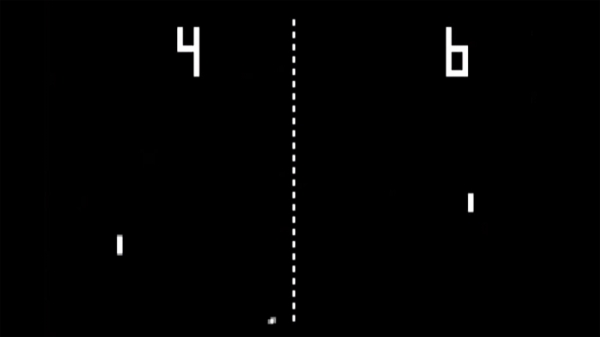
Começaremos com um jogo simples — Pong. O objetivo é mover a plataforma (paddle) de forma que a bola rebata nela, em vez de passar de lado. É como um tênis, onde você perde se não rebater a bola. Aqui, a IA tem uma tarefa relativamente fácil — decidir em que direção mover a plataforma.
Operadores condicionais
Para a IA em Pong, a solução mais óbvia é sempre tentar posicionar a plataforma sob a bola.
Um algoritmo simples para isso, escrito em pseudocódigo:
toda vez que o jogo está em execução:
se a bola está à esquerda da plataforma:
mover a plataforma para a esquerda
senão, se a bola está à direita da plataforma:
mover a plataforma para a direita
Se a plataforma se move na mesma velocidade que a bola, esse é o algoritmo ideal para a IA em Pong. Não é necessário complicar, se os dados e as possíveis ações para o agente não são tão numerosos.
Essa abordagem é tão simples que todo o ciclo Sense/Think/Act é quase imperceptível. Mas ele existe:
- A parte Sense está nos dois operadores if. O jogo sabe onde está a bola e onde está a plataforma, então a IA consulta essa informação.
- A parte Think também é composta por dois operadores if. Eles encapsulam duas decisões que, neste caso, são mutuamente exclusivas. Como resultado, uma das três ações é escolhida — mover a plataforma para a esquerda, mover para a direita, ou não fazer nada se ela já estiver na posição correta.
- A parte Act está nos operadores Mover Plataforma para a Esquerda e Mover Plataforma para a Direita. Dependendo do design do jogo, eles podem mover a plataforma instantaneamente ou a uma certa velocidade.
Essas abordagens são chamadas de reativas — existe um conjunto simples de regras (neste caso os operadores if no código) que reagem ao estado atual do mundo e agem.
Árvore de decisões
O exemplo do jogo Pong equivale, de fato, a um conceito formal de IA chamado árvore de decisões. O algoritmo passa por ela para alcançar uma 'folha' — a decisão sobre qual ação tomar.
Vamos fazer um fluxograma da árvore de decisões para o algoritmo da nossa plataforma:
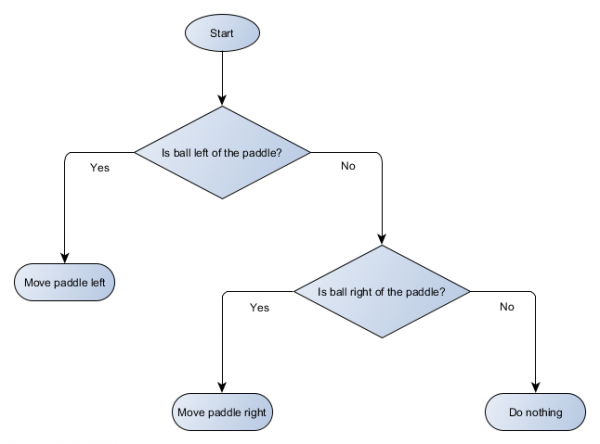
Cada parte da árvore é chamada de node (nó) — a IA usa a teoria dos grafos para descrever tais estruturas. Existem dois tipos de nós:
- Nós de decisão: a escolha entre duas alternativas com base na verificação de uma determinada condição, onde cada alternativa é representada por um nó separado.
- Nós finais: uma ação a ser executada, representando a decisão final.
O algoritmo começa pelo primeiro nó ('raiz') da árvore. Ele pode tomar uma decisão sobre qual nó filho deve acessar ou executar uma ação armazenada no nó e, em seguida, finalizar.
Qual é a vantagem, então, se a árvore de decisões realiza a mesma tarefa que operadores if na seção anterior? Há um sistema geral, onde cada decisão tem apenas uma condição e dois possíveis resultados. Isso permite que o desenvolvedor crie IA a partir de dados que representam decisões na árvore, evitando a hardcoding. Vamos imaginar na forma de uma tabela:
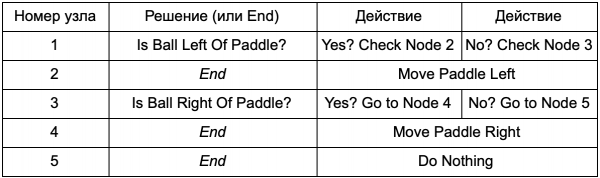
Do lado do código, você terá um sistema para ler linhas. Crie um nó para cada uma delas, conecte a lógica de tomada de decisões com base na segunda coluna e os nós filhos com base na terceira e quarta colunas. Você ainda precisará programar as condições e ações, mas agora a estrutura do jogo ficará mais complexa. Nela, você adiciona decisões e ações adicionais e, em seguida, configura toda a IA simplesmente editando um arquivo de texto com a definição da árvore. Depois, você passa o arquivo para o game designer, que poderá alterar o comportamento sem recompilar o jogo ou modificar o código.
As árvores de decisões são bastante úteis quando são construídas automaticamente com base em um grande conjunto de exemplos (por exemplo, usando o algoritmo ID3). Isso as torna uma ferramenta eficaz e de alto desempenho para classificar situações com base nos dados recebidos. No entanto, estamos indo além de um sistema simples para escolha de ações por agentes.
Cenários
Analisamos o sistema de árvore de decisões, que usou condições e ações pré-criadas. A pessoa que projeta a IA pode organizar a árvore como desejar, mas ainda precisa confiar no programador que codificou tudo isso. E se pudéssemos dar ao designer ferramentas para criar suas próprias condições ou ações?
Para que o programador não precise escrever código para as condições Is Ball Left Of Paddle e Is Ball Right Of Paddle, ele pode criar um sistema em que o designer registrará as condições para verificar esses valores. Assim, os dados da árvore de decisões ficariam assim:
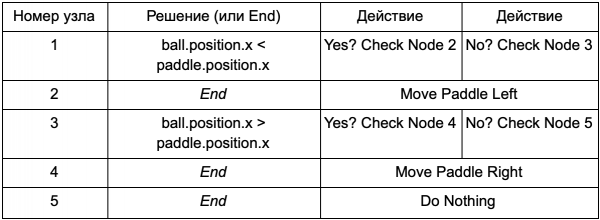
Na essência, isso é o mesmo que na primeira tabela, mas as soluções contêm seu próprio código, um pouco semelhante à parte condicional de um operador if. No lado do código, isso seria lido na segunda coluna para os nós de decisão, mas, em vez de procurar uma condição específica a ser executada (Is Ball Left Of Paddle), ele avalia a expressão condicional e retorna verdadeiro ou falso, respectivamente. Isso é feito usando a linguagem de script Lua ou Angelscript. Com elas, o desenvolvedor pode usar objetos em seu jogo (bola e paddle) e criar variáveis que estarão disponíveis no script (ball.position). Além disso, a linguagem de script é mais simples do que C++. Ela não requer um estágio completo de compilação, o que a torna ideal para ajustes rápidos na lógica do jogo e permite que "não-programadores" criem as funções necessárias por conta própria.
No exemplo apresentado, a linguagem de script é utilizada apenas para avaliar a expressão condicional, mas também pode ser usada para ações. Por exemplo, os dados Move Paddle Right podem se tornar um operador de script (ball.position.x += 10). Assim, a ação também pode ser definida no script, sem a necessidade de programar Move Paddle Right.
É possível ir mais além e escrever completamente a árvore de decisões em uma linguagem de script. Isso seria código na forma de operadores condicionais programados de forma rígida (hardcoded), mas que ficariam em arquivos externos de script, ou seja, poderiam ser modificados sem recompilar todo o programa. Muitas vezes, é possível alterar o arquivo de script enquanto o jogo está em andamento, para testar rapidamente diferentes reações da IA.
Reagindo a eventos
Os exemplos acima se encaixam perfeitamente no Pong. Eles continuamente executam o ciclo Sense/Think/Act e agem com base no último estado do mundo. Mas em jogos mais complexos, é necessário reagir a eventos específicos, e não avaliar tudo de uma vez. Nesse caso, Pong já não é um bom exemplo. Vamos escolher outro.
Imagine um jogo de tiro, onde os inimigos ficam parados até detectarem o jogador, então agem de acordo com sua "especialização": alguns correrão para o ataque, outros atacarão à distância. Isso ainda é um sistema reativo básico — "se o jogador for visto, faça algo" — mas pode ser logicamente dividido em evento Player Seen (jogador visto) e reação (escolha uma resposta e execute-a).
Isso nos traz de volta ao ciclo Sense/Think/Act. Podemos codificar a parte Sense, que a cada quadro verifica se a IA vê o jogador. Se não, nada acontece, mas se vê, um evento Player Seen é gerado. O código terá uma seção separada que diz: "quando o evento Player Seen ocorre, faça ", onde é a resposta necessária para se referir às partes Think e Act. Assim, você configurará as reações para o evento Player Seen: para um personagem "rushando" — ChargeAndAttack, e para um sniper — HideAndSnipe. Essas conexões podem ser criadas em um arquivo de dados para edição rápida sem necessidade de recompilar. Aqui também é possível usar uma linguagem de script.
Tomada de decisões complexas
Embora sistemas de reações simples sejam muito eficazes, há muitas situações em que eles não são suficientes. Às vezes, é necessário tomar decisões variadas, com base no que o agente está fazendo no momento, mas representar isso como uma condição é difícil. Às vezes, existem muitas condições para representá-las de forma eficaz em uma árvore de decisões ou script. Às vezes, é necessário avaliar antecipadamente como a situação mudará antes de decidir o próximo passo. Para resolver esses problemas, são necessárias abordagens mais complexas.
Máquina de estados finitos
Uma máquina de estados finitos ou FSM (finite state machine) é uma forma de dizer que nosso agente está atualmente em um dos vários estados possíveis e que ele pode transitar de um estado para outro. Existem um número definido de tais estados — daí o nome. O melhor exemplo da vida real é um semáforo. Em diferentes locais há diferentes sequências de luzes, mas o princípio é o mesmo — cada estado representa algo (pare, siga, etc.). O semáforo está em apenas um estado a qualquer momento e transita de um para outro com base em regras simples.
Com NPCs em jogos, a história é semelhante. Para exemplo, vamos pegar um guarda com os seguintes estados:
- Patrulhando (Patrolling).
- Atacando (Attacking).
- Fugindo (Fleeing).
E com essas condições para mudar seu estado:
- Se o guarda vê um inimigo, ele ataca.
- Se o guarda ataca, mas não vê mais o inimigo, ele volta a patrulhar.
- Se o guarda ataca, mas está gravemente ferido, ele foge.
Também é possível escrever operadores if com uma variável de estado do guardião e várias verificações: se há um inimigo por perto, qual o nível de saúde do NPC, etc. Adicionaremos mais alguns estados:
- Inatividade (Idling) — entre patrulhas.
- Busca (Searching) — quando um inimigo avistado se escondeu.
- Pedir ajuda (Finding Help) — quando um inimigo é avistado, mas é muito forte para enfrentar sozinho.
A escolha de cada um é limitada — por exemplo, o guardião não irá procurar um inimigo escondido se tiver pouca saúde.
No final, uma enorme lista de "se" <x и y, но не z>, então <p>", pode se tornar excessivamente complexa, portanto, devemos formalizar um método que nos permita manter em mente os estados e as transições entre os estados. Para fazer isso, levaremos em consideração todos os estados e, sob cada estado, listaremos todas as transições para outros estados, juntamente com as condições necessárias para elas.
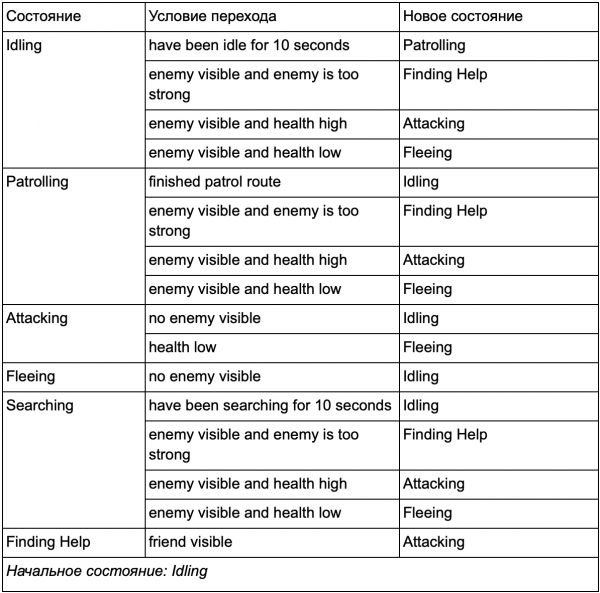
Esta é uma tabela de transições de estados — uma forma abrangente de representar uma FSM. Vamos desenhar um diagrama para obter uma visão completa de como o comportamento do NPC muda.
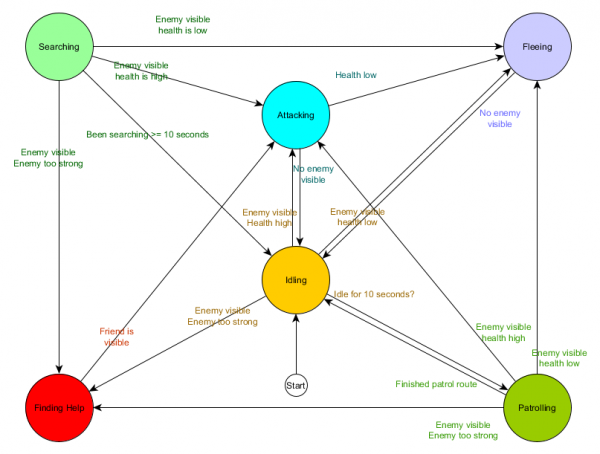
O diagrama reflete a essência da tomada de decisões para este agente com base na situação atual. Cada seta mostra a transição entre estados, se a condição ao lado dela for verdadeira.
A cada atualização, verificamos o estado atual do agente, revisamos a lista de transições, e se as condições para a transição forem atendidas, ele assume um novo estado. Por exemplo, a cada quadro verifica-se se o temporizador de 10 segundos expirou e, se sim, o guardião passa do estado Idling para Patrolling. De maneira semelhante, o estado Attacking verifica a saúde do agente — se estiver baixa, ele transita para o estado Fleeing.
Essa é a manipulação das transições entre estados, mas e quanto ao comportamento relacionado aos próprios estados? Quanto à implementação do comportamento real para um estado específico, normalmente existem dois tipos de "gancho", onde atribuimos ações à FSM:
- Ações que realizamos periodicamente para o estado atual.
- Ações que tomamos ao transitar de um estado para outro.
Exemplos para o primeiro tipo. O estado Patrolling moverá o agente ao longo da rota de patrulha a cada quadro. O estado Attacking tentará iniciar um ataque a cada quadro ou transitará para um estado quando isso for possível.
Para o segundo tipo, consideremos a transição "se o inimigo está visível e o inimigo é muito forte, então entre no estado Finding Help. O agente deve escolher para onde ir em busca de ajuda e manter essa informação, para que o estado Finding Help saiba a quem recorrer. Assim que a ajuda for encontrada, o agente retorna ao estado Attacking. Neste momento, ele querrá informar seu aliado sobre a ameaça, portanto, pode ocorrer a ação NotifyFriendOfThreat.
Mais uma vez, podemos olhar para este sistema através do ciclo Sense / Think / Act. Sense se manifesta nos dados utilizados pela lógica de transição. Think se refere às transições disponíveis em cada estado. E Act é realizado pelas ações que são executadas periodicamente dentro do estado ou nas transições entre estados.
Às vezes, a sondagem contínua das condições de transição pode ser custosa. Por exemplo, se cada agente executar cálculos complexos a cada quadro para determinar se vê inimigos e entender se pode transitar do estado Patrolling para Attacking — isso consumirá muito tempo de CPU.
Mudanças significativas no estado do mundo podem ser vistas como eventos que serão processados à medida que surgem. Em vez de o FSM verificar a cada quadro a condição de transição "meu agente pode ver o jogador?", pode-se configurar um sistema separado para realizar verificações com menos frequência (por exemplo, 5 vezes por segundo). E o resultado seria Player Seen, quando a verificação for bem-sucedida.
Isso é passado para o FSM, que agora deve transitar para a condição de evento Player Seen recebido e reagir de forma apropriada. O comportamento final é o mesmo, exceto por um atraso quase imperceptível antes da resposta. No entanto, o desempenho melhorou devido à separação de parte do Sense em uma parte distinta do programa.
Máquina de estados finitos hierárquica
No entanto, trabalhar com grandes FSMs nem sempre é conveniente. Se quisermos expandir o estado de ataque, substituindo-o por MeleeAttacking (luta corpo a corpo) e RangedAttacking (luta à distância), teremos que alterar as transições de todos os outros estados que levam ao estado Attacking (atuais e futuros).
Você certamente percebeu que, em nosso exemplo, há muitas transições duplicadas. A maioria das transições no estado de Idling é idêntica às transições no estado de Patrolling. Seria bom não haver repetições, especialmente se adicionarmos mais estados semelhantes. Faz sentido agrupar Idling e Patrolling sob a etiqueta comum "não bélico", onde há apenas um conjunto comum de transições para estados de combate. Se apresentarmos essa etiqueta como um estado, então Idling e Patrolling se tornarão substados. Exemplo de uso de uma tabela de transições separada para o novo substado não bélico:
Estados principais:
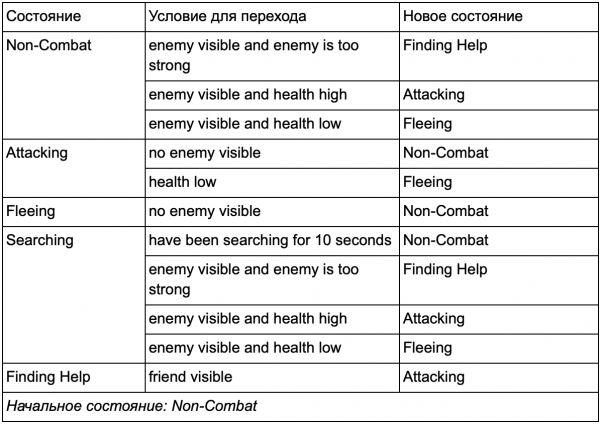
Estado fora de combate:
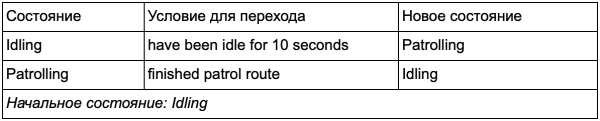
E na forma de diagrama:
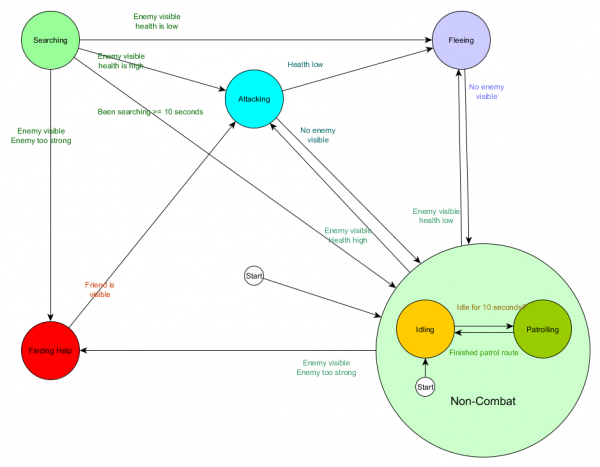
Este é o mesmo sistema, mas com um novo estado não bélico que inclui Idling e Patrolling. Com cada estado contendo FSM com substados (e esses substados, por sua vez, contendo suas próprias FSM — e assim por diante, quantas você precisar), obtemos Máquinas de Estado Finais Hierárquicas ou HFSM. Agrupando o estado não bélico, eliminamos um monte de transições redundantes. O mesmo podemos fazer para qualquer novo estado com transições comuns. Por exemplo, se no futuro ampliarmos o estado Attacking para os estados MeleeAttacking e MissileAttacking, eles serão substados que transitam entre si com base na distância até o inimigo e na disponibilidade de munições. No final, modelos de comportamento complexos e submodelos de comportamento podem ser representados com o mínimo de transições duplicadas.
Árvore de comportamentos
Com HFSM, complexas combinações de comportamentos são criadas de maneira simples. No entanto, há uma pequena dificuldade, pois a tomada de decisões na forma de regras de transição está intimamente relacionada ao estado atual. E em muitos jogos, isso é exatamente o que se precisa. Um uso cuidadoso da hierarquia de estados pode reduzir a quantidade de repetições nas transições. Mas, às vezes, são necessárias regras que funcionem independentemente do estado em que você está ou que se aplicam em quase qualquer estado. Por exemplo, se a saúde do agente cair para 25%, você desejará que ele fuja, independentemente de estar em combate, ocioso ou conversando — você terá que adicionar essa condição a cada estado. E se seu designer quiser mais tarde alterar o limite de baixa saúde de 25% para 10%, precisará lidar com isso novamente.
Idealmente, para essa situação, é necessário um sistema em que as decisões sobre "que estado manter" estejam além dos próprios estados, permitindo fazer alterações em um único local sem alterar as condições de transição. Aqui surgem as árvores de comportamento.
Existem várias maneiras de implementá-las, mas a essência para todas é semelhante a uma árvore de decisões: o algoritmo começa com um nó "raiz" e a árvore contém nós que representam decisões ou ações. No entanto, há algumas diferenças chave:
- Agora, os nós retornam um dos três valores: Succeeded (se o trabalho foi concluído), Failed (se não é possível iniciar) ou Running (se ainda está em execução e não há resultado final).
- Não existem mais nós de decisão para escolher entre duas alternativas. Em vez disso, temos nós Decorator, que possuem um único nó filho. Se eles Succeed, então executam seu único nó filho.
- Nós que executam ações retornam o valor Running para representar ações em andamento.
Esse pequeno conjunto de nós pode ser combinado para criar uma grande variedade de modelos de comportamento complexos. Vamos imaginar um HFSM de guardião do exemplo anterior na forma de uma árvore de comportamento:
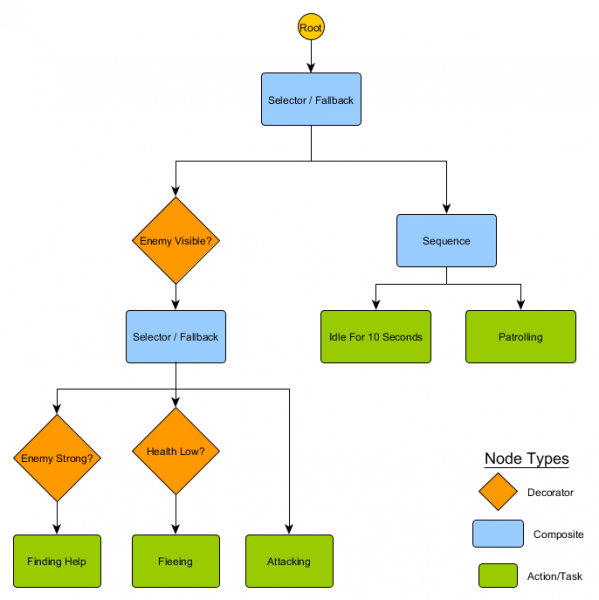
Com essa estrutura, não deve haver uma transição explícita dos estados Idling/Patrolling para o estado Attacking ou qualquer outro. Se o inimigo estiver visível e a saúde do personagem estiver baixa, a execução será interrompida no nó Fleeing, independentemente de qual nó ele estava executando anteriormente — Patrolling, Idling, Attacking ou qualquer outro.
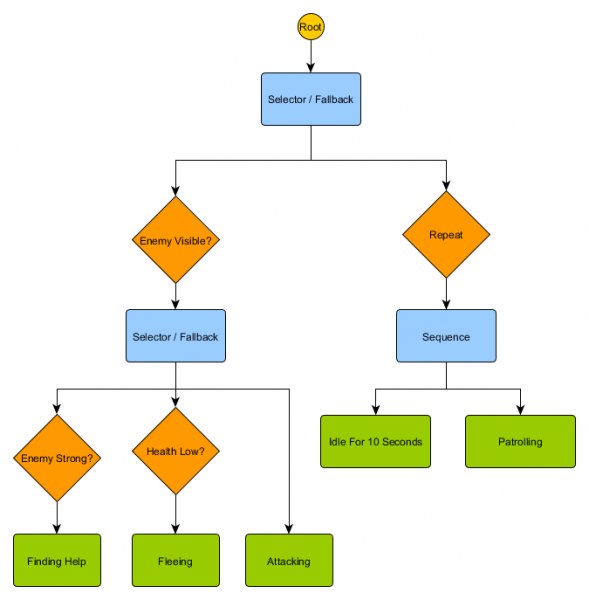
Árvores de comportamento são complexas — existem muitas maneiras de construí-las, e encontrar a combinação certa de decoradores e nós compostos pode ser desafiador. Também surgem questões sobre com que frequência verificar a árvore — queremos passar por cada parte dela ou apenas quando uma das condições mudar? Como armazenar o estado relacionado aos nós — como saber se estivemos no estado Idling por 10 segundos ou como descobrir quais nós foram executados da última vez para lidar corretamente com a sequência?
É por isso que existem muitas implementações. Por exemplo, em alguns sistemas, nós decoradores foram substituídos por decoradores embutidos. Eles reavaliam a árvore ao alterar as condições do decorador, ajudam a conectar nós e fornecem atualizações periódicas.
Sistema baseado em utilidade
Alguns jogos têm várias mecânicas diferentes. É desejável que todos elas aproveitem as regras de transição simples e comuns, mas não necessariamente na forma de uma árvore de comportamento completa. Em vez de ter um conjunto claro de escolhas ou uma árvore de ações possíveis, é mais fácil explorar todas as ações e escolher a mais apropriada no momento.
Um sistema baseado em utilidade ajudará exatamente nisso. É um sistema onde o agente tem várias ações e decide qual realizar, com base na utilidade relativa de cada uma. Onde a utilidade é uma medida arbitrária de quão importante ou desejável é executar essa ação para o agente.
A utilidade calculada da ação, com base no estado atual e no ambiente, permite que o agente verifique e escolha o estado alternativo mais adequado a qualquer momento. Isso é semelhante a um FSM, exceto que as transições são determinadas pela avaliação de cada estado potencial, incluindo o atual. Note que escolhemos a ação mais útil para a transição (ou permanecemos, se já a executamos). Para maior diversidade, isso pode ser uma escolha ponderada, mas aleatória, a partir de uma pequena lista.
O sistema atribui um intervalo arbitrário de valores de utilidade — por exemplo, de 0 (completamente indesejado) a 100 (totalmente desejado). Cada ação tem uma série de parâmetros que influenciam o cálculo desse valor. Retornando ao nosso exemplo com o guardião:
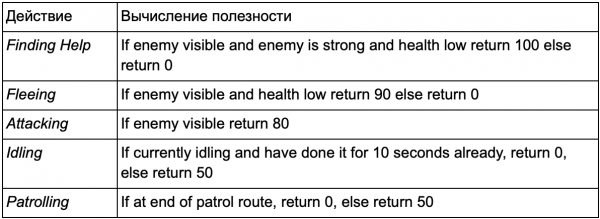
As transições entre ações não são ambíguas — qualquer estado pode seguir qualquer outro. As prioridades das ações estão nos valores de utilidade retornados. Se o inimigo for visível, e esse inimigo for forte, enquanto a saúde do personagem estiver baixa, tanto Fleeing quanto FindingHelp retornarão altos valores não nulos. Neste caso, FindingHelp sempre terá prioridade. Da mesma forma, ações não combativas nunca retornam mais de 50, então elas sempre estarão abaixo das ações de combate. Isso deve ser considerado ao criar ações e calcular sua utilidade.
No nosso exemplo, as ações retornam ou um valor fixo constante ou um dos dois valores fixos. Um sistema mais realista pressupõe o retorno de avaliações de um intervalo contínuo de valores. Por exemplo, a ação Fleeing retorna valores de utilidade mais altos se a saúde do agente está baixa, enquanto a ação Attacking retorna valores mais baixos se o inimigo é muito forte. Por causa disso, a ação Fleeing tem prioridade sobre Attacking em qualquer situação na qual o agente sente que não tem saúde suficiente para vencer o oponente. Isso permite ajustar as prioridades das ações com base em qualquer número de critérios, tornando essa abordagem mais flexível e variável do que uma árvore de comportamento ou FSM.
Cada ação tem muitas condições para calcular o programa. Elas podem ser escritas em uma linguagem de script ou na forma de uma série de fórmulas matemáticas. Em The Sims, que modela a rotina diária do personagem, é adicionado um nível adicional de cálculos — o agente recebe uma série de "motivações" que influenciam as avaliações de utilidade. Se um personagem está com fome, ao longo do tempo ele ficará ainda mais faminto, e o resultado da ação EatFood aumentará até que o personagem a execute, reduzindo seu nível de fome e retornando o valor de EatFood a zero.
A ideia de escolher ações com base em um sistema de avaliações é bastante simples, portanto, um sistema baseado em utilidade pode ser usado como parte dos processos de tomada de decisão da IA, e não como uma substituição completa. Uma árvore de decisões pode solicitar uma avaliação da utilidade de dois nós filhos e escolher o mais alto. Da mesma forma, uma árvore de comportamento pode ter um nó composto Utility para avaliar a utilidade das ações, a fim de decidir qual elemento filho executar.
Movimentação e navegação
Nos exemplos anteriores, temos uma plataforma que movemos para a esquerda ou direita, e um guardião que patrulha ou ataca. Mas como exatamente tratamos o movimento do agente ao longo de um período de tempo? Como estabelecemos a velocidade, como evitamos obstáculos, e como planejamos a rota se chegar ao destino for mais complicado do que simplesmente mover-se em linha reta? Vamos analisar isso.
Gerenciamento
Na fase inicial, vamos considerar que cada agente tem um valor de velocidade, que inclui quão rápido ele se move e em que direção. Isso pode ser medido em metros por segundo, quilômetros por hora, pixels por segundo, etc. Lembrando do ciclo Sense/Think/Act, podemos imaginar que a parte Think escolhe a velocidade, enquanto a parte Act aplica essa velocidade ao agente. Normalmente, em jogos há um sistema físico que realiza essa tarefa por você, analisando o valor de velocidade de cada objeto e regulando-o. Portanto, podemos deixar a IA com uma única tarefa — decidir qual deve ser a velocidade do agente. Se sabemos onde o agente deve estar, então precisamos movê-lo na direção certa com uma velocidade definida. Uma equação muito trivial:
desired_travel = destination_position – agent_position
Imagine um mundo 2D. O agente está no ponto (-2,-2), o destino em algum lugar ao nordeste no ponto (30, 20), e o caminho necessário para o agente chegar lá é (32, 22). Suponha que essas posições sejam medidas em metros — se aceitarmos a velocidade do agente como 5 metros por segundo, então escalaremos nosso vetor de movimentação e obteremos uma velocidade de aproximadamente (4.12, 2.83). Com esses parâmetros, o agente chegaria ao destino em quase 8 segundos.
Os valores podem ser recalculados a qualquer momento. Se o agente estava a meio caminho do objetivo, o deslocamento teria sido metade do comprimento, mas como a velocidade máxima do agente é de 5 m/s (decidimos isso anteriormente), a velocidade será a mesma. Isso também funciona para alvos em movimento, permitindo que o agente faça pequenos ajustes enquanto eles se deslocam.
Mas queremos mais variabilidade — por exemplo, aumentar lentamente a velocidade para simular um personagem que se move de um estado parado para a corrida. O mesmo pode ser feito no final antes de parar. Essas características são conhecidas como comportamentos de direção, cada uma com nomes específicos: Seek (procurar), Flee (fugir), Arrival (chegada), etc. A ideia é que forças de aceleração podem ser aplicadas à velocidade do agente, com base na comparação da posição do agente e da velocidade atual com o destino, para utilizar diferentes maneiras de se mover em direção ao objetivo.
Cada comportamento tem um objetivo um pouco diferente. Seek e Arrival são formas de mover o agente em direção ao seu destino. Obstacle Avoidance (evitamento de obstáculos) e Separation (separação) ajustam o movimento do agente para contornar obstáculos no caminho para o objetivo. Alignment (alinhamento) e Cohesion (coesão) mantêm os agentes juntos enquanto se movem. Um número qualquer de comportamentos de navegação pode ser somado para obter um único vetor de caminho, levando em conta todos os fatores. Um agente utiliza os comportamentos Arrival, Separation e Obstacle Avoidance para se manter afastado de paredes e outros agentes. Essa abordagem funciona bem em locais abertos, sem muitos detalhes.
Em condições mais difíceis, a combinação de diferentes comportamentos funciona pior — por exemplo, o agente pode ficar preso na parede devido ao conflito entre Arrival e Obstacle Avoidance. Portanto, precisamos considerar opções que sejam mais complexas do que simplesmente somar todos os valores. Uma maneira de fazer isso é, em vez de somar os resultados de cada comportamento, considerar movimentos em diferentes direções e escolher a melhor opção.
No entanto, em um ambiente complexo com becos sem saída e escolha de direção, precisaremos de algo ainda mais avançado.
Busca de caminho
Comportamentos de navegação são excelentes para movimento simples em áreas abertas (como um campo de futebol ou uma arena), onde ir de A a B é um caminho direto com pequenas desvios ao contornar obstáculos. Para rotas complexas, precisamos de pathfinding (busca de caminho), que é uma maneira de explorar o mundo e decidir a rota através dele.
A maneira mais simples é sobrepor uma grade a cada quadrado ao lado do agente e avaliar em quais deles é permitido se mover. Se algum desses quadrados for o destino, então siga a partir dele pela rota de cada quadrado até o anterior, até chegar ao início. Esse é o caminho. Caso contrário, repita o processo com os quadrados mais próximos até encontrar o destino ou ficar sem quadrados (o que significa que não há rota possível). Isso é formalmente conhecido como Breadth-First Search ou BFS (algoritmo de busca em largura). Em cada etapa, ele verifica em todas as direções (por isso, breadth, "largura"). O espaço de busca se assemelha a uma frente de onda que se move até alcançar o local desejado — a área de busca se expande a cada passo até que o ponto final seja atingido, depois do qual o caminho pode ser rastreado até o início.
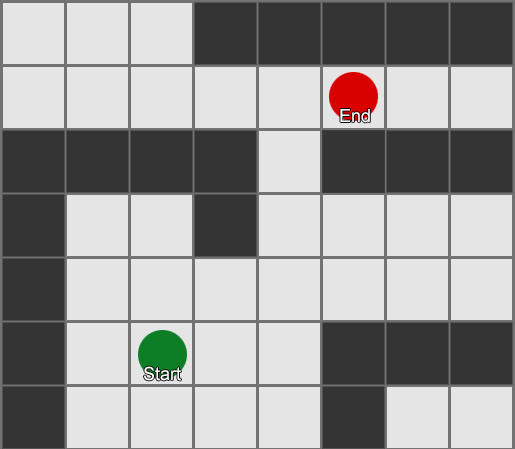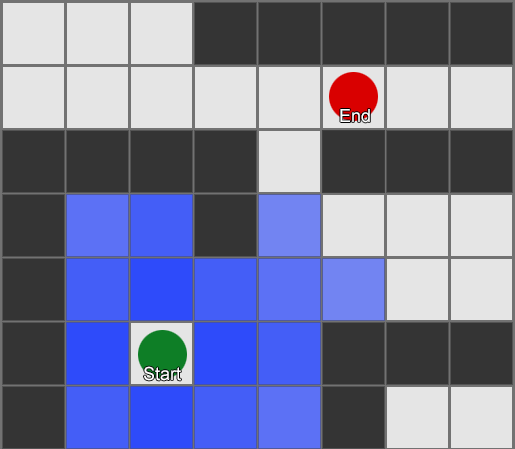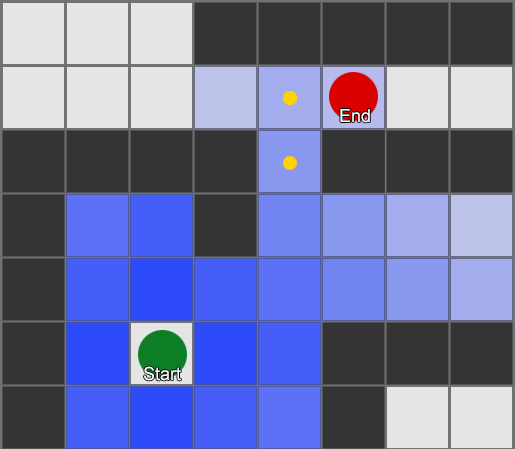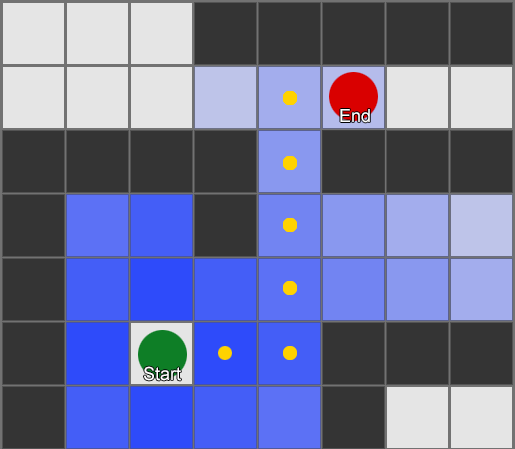
Como resultado, você obterá uma lista de quadrados que compõem a rota necessária. Este é o caminho (daí, pathfinding) — uma lista de locais que o agente irá visitar ao seguir para o destino.
Dado que sabemos a posição de cada quadrado no mundo, podemos usar comportamentos de direção para mover ao longo do caminho — do nó 1 para o nó 2, depois do nó 2 para o nó 3 e assim por diante. A maneira mais simples é direcionar-se ao centro do próximo quadrado, mas é ainda melhor parar no meio da borda entre o quadrado atual e o próximo. Isso permite que o agente corte os cantos em curvas acentuadas.
O algoritmo BFS tem desvantagens — ele explora tantos quadrados na direção "errada" quanto na direção "certa". Aqui entra um algoritmo mais complexo chamado A* (A estrela). Ele funciona de forma semelhante, mas em vez de explorar cegamente os quadrados vizinhos (depois os vizinhos dos vizinhos, e assim por diante), ele coleta nós em uma lista e os classifica de modo que o próximo nó a ser explorado seja sempre aquele que levará ao caminho mais curto. Os nós são classificados com base em uma heurística que leva em conta duas coisas — o "custo" hipotético do caminho para o quadrado desejado (incluindo quaisquer custos de movimento) e uma estimativa de quão longe esse quadrado está do destino (direcionando a busca na direção certa).
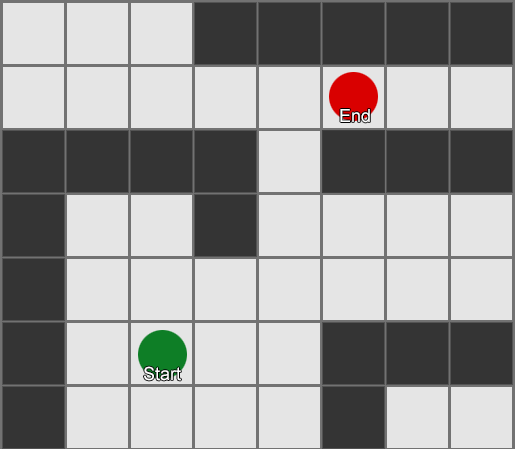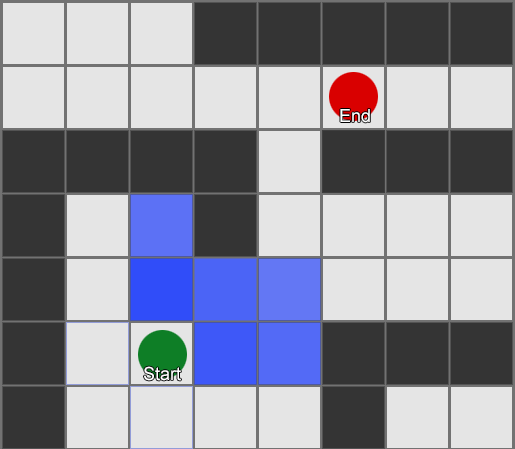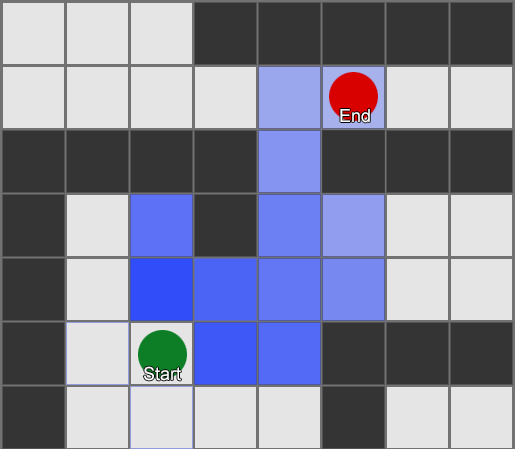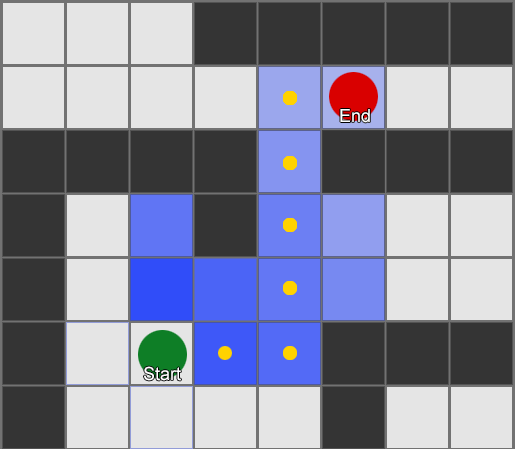
Neste exemplo, o agente explora uma quadrícula de cada vez, escolhendo sempre o vizinho com maior potencial. O caminho obtido é semelhante ao da BFS, mas durante o processo, foram considerados menos quadrados — o que tem um grande impacto no desempenho do jogo.
Movimento sem grade
Mas a maioria dos jogos não é construída em uma grade, e muitas vezes não é possível fazê-la sem comprometer o realismo. Compromissos são necessários. Qual deve ser o tamanho dos quadrados? Se forem muito grandes — não poderão representar corretamente corredores ou curvas pequenas; se forem muito pequenos — haverá uma quantidade excessiva de quadrados a serem pesquisados, o que acabará levando muito tempo.
A primeira coisa a entender é que a grade nos fornece um grafo de nós conectados. Os algoritmos A* e BFS, de fato, operam em gráficos e não se preocupam com a nossa grade. Poderíamos colocar nós em qualquer lugar do mundo do jogo: com uma conexão entre quaisquer dois nós conectados, assim como entre o ponto inicial e o final, e pelo menos um dos nós — o algoritmo funcionará tão bem quanto antes. Isso é frequentemente chamado de sistema de pontos de passagem, pois cada nó representa uma posição significativa no mundo que pode ser parte de qualquer número de caminhos hipotéticos.
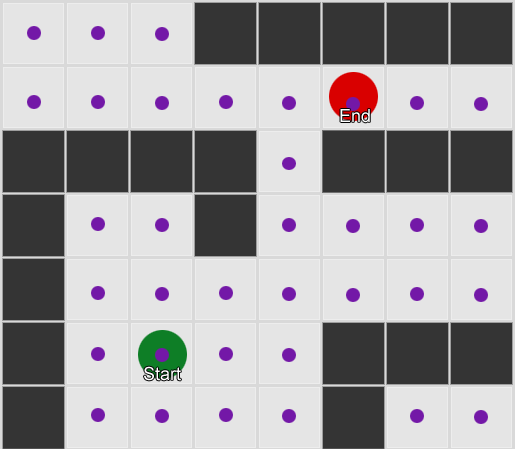
Exemplo 1: um nó em cada quadrado. A busca começa no nó onde o agente está localizado e termina no nó do quadrado desejado.
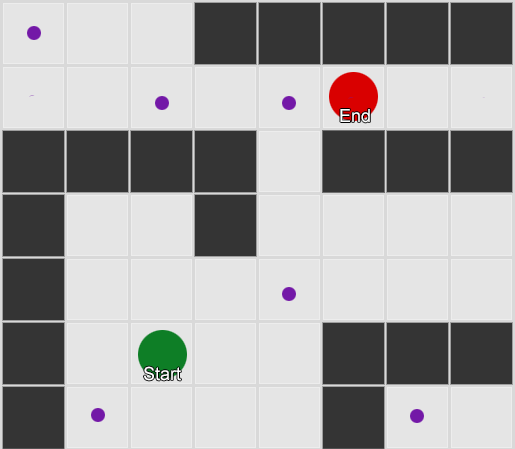
Exemplo 2: um conjunto menor de nós (pontos de passagem). A busca começa no quadrado com o agente, passa pelo número necessário de nós e, em seguida, continua até o destino.
Este é um sistema bastante flexível e poderoso. Mas é necessário ter cuidado nas decisões sobre onde e como colocar os pontos de passagem, caso contrário, os agentes podem simplesmente não ver o ponto mais próximo e não conseguir iniciar o caminho. Seria mais fácil se pudéssemos colocar os pontos de passagem automaticamente com base na geometria do mundo.
Aqui entra a malha de navegação ou navmesh. Essa é tipicamente uma malha 2D de triângulos que se sobrepõe à geometria do mundo — em todos os lugares onde o agente é permitido andar. Cada um dos triângulos na malha se torna um nó no grafo e tem até três triângulos adjacentes, que se tornam nós vizinhos no grafo.
Esta imagem é um exemplo do motor Unity — ele analisou a geometria do mundo e criou um navmesh (na captura de tela, em azul claro). Cada polígono no navmesh é uma área onde o agente pode permanecer ou se mover de um polígono para outro. No exemplo dado, os polígonos são menores que os andares em que estão localizados — isso foi feito para levar em conta as dimensões do agente, que podem ultrapassar sua posição nominal.
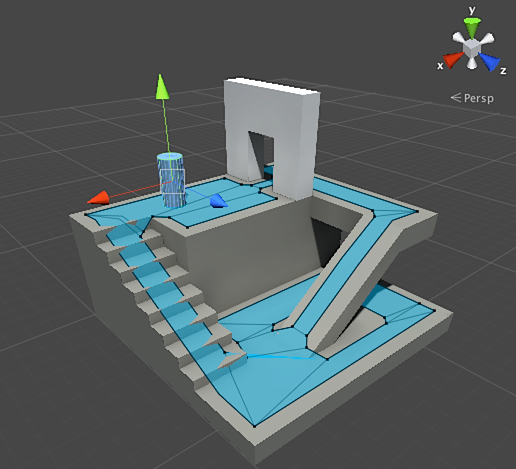
Podemos buscar um caminho através dessa grade, utilizando novamente o algoritmo A*. Isso nos dará um caminho praticamente perfeito no mundo, que leva em conta toda a geometria e não requer nós extras ou criação de pontos de referência.
Pathfinding — é um tema muito abrangente, que não pode ser coberto em apenas uma seção de um artigo. Se você deseja estudá-lo mais a fundo, isso pode ser feito através do .
Planejamento
Nós nos certificamos de que, no pathfinding, às vezes não basta simplesmente escolher uma direção e seguir — devemos escolher uma rota e fazer algumas curvas para chegar ao local desejado. Podemos generalizar essa ideia: alcançar um objetivo não é apenas o próximo passo, mas uma sequência inteira, onde às vezes é necessário olhar para frente alguns passos para entender como deve ser o primeiro. Isso se chama planejamento. O pathfinding pode ser visto como um dos vários complementos ao planejamento. Do ponto de vista do nosso ciclo Sense/Tthink/Act, é aqui que a parte Think planeja várias partes do Act para o futuro.
Vamos analisar com o exemplo do jogo de cartas Magic: The Gathering. Nós começamos com as seguintes cartas na mão:
- Swamp — fornece 1 mana preta (carta de terreno).
- Forest — fornece 1 mana verde (carta de terreno).
- Fugitive Wizard — requer 1 mana azul para invocar.
- Elvish Mystic — requer 1 mana verde para invocar.
Ignoramos as três cartas restantes para simplificar. De acordo com as regras, o jogador pode jogar 1 carta de terreno por turno, ele pode "tapear" essa carta para extrair mana e, em seguida, usar feitiços (incluindo invocar criaturas) de acordo com a quantidade de mana disponível. Nessa situação, o jogador humano sabe que precisa jogar Forest, "tapear" 1 mana verde e, em seguida, invocar Elvish Mystic. Mas como o IA do jogo pode adivinhar isso?
Planejamento simples
Uma abordagem trivial é testar cada ação sequencialmente até que nenhuma ação apropriada permaneça. Observando as cartas, a IA vê que pode jogar Swamp. E joga. Existem outras ações disponíveis neste turno? Ela não pode convocar nem Elvish Mystic nem Fugitive Wizard, pois ambas requerem, respectivamente, mana verde e azul, enquanto Swamp fornece apenas mana preta. E ela não poderá jogar Forest, pois já jogou Swamp. Assim, a IA do jogo seguiu as regras, mas o fez de forma inadequada. Isso pode ser melhorado.
O planejamento pode encontrar uma lista de ações que levam o jogo ao estado desejado. Assim como cada quadrado no caminho tinha vizinhos (em busca de caminho), cada ação no plano também tem vizinhos ou sucessores. Podemos buscar essas ações e ações subsequentes até alcançarmos o estado desejado.
No nosso exemplo, o resultado desejado é 'convocar uma criatura, se possível'. No início do turno, vemos apenas duas possíveis ações permitidas pelas regras do jogo:
1. Jogar Swamp (resultado: Swamp em jogo)
2. Jogar Forest (resultado: Forest em jogo)
Cada ação tomada pode levar a outras ações e bloquear outras, novamente dependendo das regras do jogo. Imagine que jogamos Swamp — isso removerá Swamp como a próxima jogada (já o jogamos), também removerá Forest (porque segundo as regras, só é permitido jogar um card de terreno por turno). Depois disso, a IA adiciona como próximo passo — ganhar 1 mana preta, pois não há outras opções disponíveis. Se avançar e escolher Tap the Swamp, ganhará 1 unidade de mana preta e nada poderá fazer com ela.
1. Jogar Swamp (resultado: Swamp em jogo)
1.1 'Tap' Swamp (resultado: Swamp 'tapado', +1 unidade de mana preta)
Nenhuma ação disponível – FIM
2. Jogar Forest (resultado: Forest em jogo)
A lista de ações acabou sendo curta, chegamos a um impasse. Vamos repetir o processo para a próxima ação. Jogamos Forest, abrindo a ação 'ganhar 1 mana verde', que, por sua vez, abrirá a terceira ação — convocar Elvish Mystic.
1. Jogar Swamp (resultado: Swamp em jogo)
1.1 'Tap' Swamp (resultado: Swamp 'tapado', +1 unidade de mana preta)
Nenhuma ação disponível – FIM
2. Jogar Forest (resultado: Forest em jogo)
2.1 'Tap' Forest (resultado: Forest 'tapada', +1 unidade de mana verde)
2.1.1 Convocar Elvish Mystic (resultado: Elvish Mystic em jogo, -1 unidade de mana verde)
Nenhuma ação disponível – FIM
Finalmente, examinamos todas as ações possíveis e encontramos um plano para convocar uma criatura.
Este é um exemplo muito simplificado. É preferível escolher o melhor plano possível em vez de apenas qualquer um que atenda a certos critérios. Em geral, os planos potenciais podem ser avaliados com base no resultado final ou no benefício total que eles proporcionam. Você pode ganhar 1 ponto por jogar um terreno e 3 pontos por invocar uma criatura. Jogar um Swamp seria um plano que dá 1 ponto. E jogar um Forest → Tap the Forest → invocar um Elvish Mystic — daria imediatamente 4 pontos.
Assim funciona o planejamento em Magic: The Gathering, mas a mesma lógica se aplica a outras situações. Por exemplo, mover um peão para liberar espaço para o movimento de um bispo no xadrez. Ou se esconder atrás de uma parede para atirar com segurança em XCOM. Em geral, você entendeu o ponto.
Planejamento Avançado
Às vezes, há muitas ações potenciais para considerar cada possível opção. Voltando ao exemplo de Magic: The Gathering: suponha que no jogo você tenha várias cartas de terrenos e criaturas em mãos — o número de combinações possíveis de jogadas pode chegar a dezenas. Existem algumas soluções para esse problema.
O primeiro método é o backward chaining (formação de cadeia reversa). Em vez de percorrer todas as combinações, é melhor começar a partir do resultado final e tentar encontrar um caminho direto. Em vez de ir da raiz da árvore a uma folha específica, seguimos na direção oposta — da folha para a raiz. Este método é mais simples e rápido.
Se o oponente tem 1 ponto de vida, você pode encontrar um plano "causar 1 ou mais pontos de dano". Para conseguir isso, é preciso cumprir uma série de condições:
1. O dano pode ser causado por um feitiço — ele deve estar na mão.
2. Para jogar o feitiço — é necessário mana.
3. Para obter mana — é necessário jogar uma carta de terreno.
4. Para jogar uma carta de terreno — você precisa tê-la na mão.
Outro método é o best-first search (busca do melhor primeiro). Em vez de percorrer todos os caminhos, escolhemos o mais adequado. Na maioria das vezes, este método fornece um plano otimizado sem desperdício de tempo na busca. A* é uma forma de busca do melhor primeiro — ao explorar as rotas mais promissoras desde o início, ele pode encontrar o melhor caminho sem necessidade de verificar as outras opções.
Uma opção interessante e cada vez mais popular de busca best-first é a Monte Carlo Tree Search. Em vez de adivinhar quais planos são melhores ao escolher cada ação subsequente, o algoritmo escolhe sucessores aleatórios em cada passo, até atingir o fim (quando o plano leva à vitória ou derrota). Então, o resultado final é usado para aumentar ou diminuir a avaliação do "peso" das opções anteriores. Repetindo esse processo várias vezes, o algoritmo fornece uma boa avaliação de qual é o próximo passo melhor, mesmo que a situação mude (se o oponente tomar medidas para impedir o jogador).
Na narrativa sobre planejamento em jogos, não podemos deixar de mencionar o Goal-Oriented Action Planning ou GOAP (Planejamento de Ação Orientado a Objetivos). Este é um método amplamente utilizado e discutido, mas além de alguns detalhes distintos, é, essencialmente, um método de retroceder na cadeia, que já discutimos anteriormente. Se a tarefa é "eliminar o jogador", e o jogador está atrás de uma cobertura, o plano pode ser: elimine com granada → pegue-a → lance-a.
Normalmente, existem vários objetivos, cada um com sua prioridade. Se o objetivo de maior prioridade não pode ser alcançado (nenhuma combinação de ações cria um plano para "eliminar o jogador", pois o jogador não está visível), a IA retornará aos objetivos de menor prioridade.
Treinamento e adaptação
Já mencionamos que a IA de jogos geralmente não utiliza aprendizado de máquina, porque não é adequada para gerenciar agentes em tempo real. Mas isso não significa que não podemos pegar algo dessa área. Queremos um oponente em um atirador que possa nos ensinar algo. Por exemplo, aprender sobre as melhores posições no mapa. Ou um oponente em um jogo de luta que bloqueie combos frequentemente usados pelo jogador, incentivando o uso de outros. Assim, o aprendizado de máquina pode ser bastante útil nessas situações.
Estatísticas e probabilidades
Antes de passarmos para exemplos mais complexos, vamos estimar até onde podemos ir, fazendo algumas medições simples e usando-as para tomar decisões. Por exemplo, em uma estratégia em tempo real — como podemos determinar se um jogador consegue iniciar um ataque nos primeiros minutos do jogo e qual defesa devemos preparar contra isso? Podemos estudar a experiência passada do jogador para entender qual pode ser sua reação futura. Começamos com o fato de que não temos esses dados iniciais, mas podemos coletá-los — toda vez que a IA joga contra um humano, ela pode registrar o tempo do primeiro ataque. Após algumas sessões, teremos a média do tempo em que o jogador atacará no futuro.
Os valores médios também têm um problema: se o jogador ‘rushou’ 20 vezes e jogou lentamente outras 20, os valores necessários estarão em algum lugar no meio, o que não nos dará informações úteis. Uma das soluções é limitar os dados de entrada — podemos considerar os últimos 20 casos.
Uma abordagem semelhante é usada para avaliar a probabilidade de certas ações, assumindo que as preferências passadas do jogador serão as mesmas no futuro. Se o jogador nos ataca cinco vezes com uma bola de fogo, duas vezes com um raio e uma vez corpo a corpo, é evidente que ele prefere a bola de fogo. Extrapolamos e vemos a probabilidade de uso de diferentes armas: bola de fogo = 62,5%, raio = 25% e corpo a corpo = 12,5%. Nossa IA de jogo precisa se preparar para se defender do fogo.
Outro método interessante é usar o Classificador Naive Bayes para explorar grandes volumes de dados de entrada e classificar a situação para que a IA reaja da maneira certa. Os classificadores bayesianos são mais conhecidos por seu uso em filtros de spam de e-mail. Eles analisam palavras, comparam-nas com onde essas palavras apareceram anteriormente (em spam ou não) e tiram conclusões sobre os e-mails recebidos. Podemos fazer o mesmo mesmo com uma quantidade menor de dados de entrada. Com base em todas as informações úteis que a IA vê (por exemplo, quais unidades inimigas foram criadas, quais feitiços estão sendo usados ou quais tecnologias foram pesquisadas) e no resultado final (guerra ou paz, ‘rushar’ ou se defender etc.) — escolheremos o comportamento apropriado para a IA.
Todos esses métodos de aprendizado são suficientes, mas é preferível usá-los com base em dados de testes. A IA aprenderá a se adaptar às diferentes estratégias utilizadas pelos seus playtesters. Uma IA que se adapta ao jogador após o lançamento pode se tornar previsível demais ou, ao contrário, muito difícil de vencer.
Adaptação com base em valores
Considerando o conteúdo do nosso mundo de jogo e suas regras, podemos alterar o conjunto de valores que influenciam a tomada de decisões, em vez de apenas usar os dados de entrada. Fazemos isso:
- Deixe a IA coletar dados sobre o estado do mundo e eventos-chave durante o jogo (como mencionado acima).
- Vamos alterar alguns valores importantes com base nesses dados.
- Implementaremos nossas decisões, baseadas no processamento ou avaliação desses valores.
Por exemplo, o agente tem várias salas para escolher no mapa de um shooter em primeira pessoa. Cada sala tem seu valor, que determina quão desejável é a visita. A IA escolhe aleatoriamente para qual sala ir, com base no valor. Em seguida, o agente se lembra de em qual sala foi morto e diminui seu valor (a probabilidade de voltar lá). Da mesma forma, na situação inversa — se o agente elimina muitos oponentes, o valor da sala aumenta.
Modelo de Markov
E se usássemos os dados coletados para fazer previsões? Se lembrarmos de cada sala onde vemos o jogador durante um determinado período, podemos prever para qual sala o jogador pode se mover. Monitorando e registrando os movimentos do jogador entre as salas (valores), podemos fazer previsões sobre eles.
Vamos considerar três salas: vermelha, verde e azul. E também as observações que registramos ao assistir à sessão de jogo:
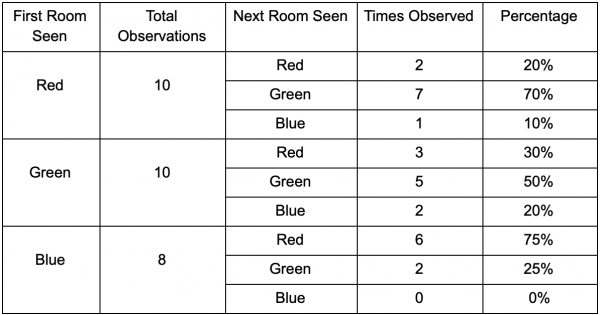
O número de observações em cada sala é quase igual — ainda não sabemos onde fazer um bom ponto de emboscada. A coleta de estatísticas também é dificultada pelo respawn dos jogadores, que aparecem uniformemente pelo mapa. Mas os dados sobre a próxima sala que eles entram após aparecer no mapa já são úteis.
É evidente que a sala verde agrada aos jogadores — a maioria das pessoas da sala vermelha a escolhe, com 50% delas permanecendo lá. A sala azul, por outro lado, não é popular, quase ninguém a frequenta, e quando o faz, não fica muito tempo.
Mas os dados nos dizem algo mais importante — quando um jogador está na sala azul, a próxima sala na qual provavelmente o veremos será a vermelha, e não a verde. Apesar de a sala verde ser mais popular que a vermelha, a situação muda se o jogador está na azul. O próximo estado (ou seja, a sala para a qual o jogador irá) depende do estado anterior (ou seja, da sala em que o jogador está agora). Devido à pesquisa das dependências, faremos previsões mais precisas do que se simplesmente contássemos as observações de forma independente.
Prever o futuro estado com base nos dados do estado passado é chamado de modelo de Markov, e esses exemplos (com salas) são chamados de cadeias de Markov. Como os modelos representam a probabilidade de mudanças entre estados consecutivos, eles são visualmente representados como FSM com a probabilidade em cada transição. Anteriormente, usamos FSM para representar o estado comportamental em que o agente se encontrava, mas esse conceito se aplica a qualquer estado, independentemente de estar relacionado ao agente ou não. Nesse caso, os estados representam a sala que o agente ocupa:
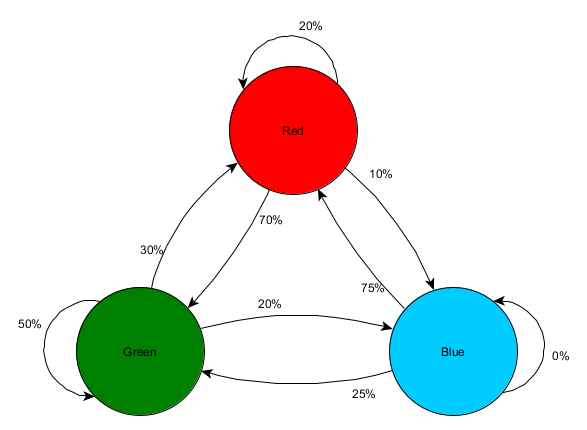
Esta é uma maneira simples de representar a probabilidade relativa de mudanças de estado, dando ao IA uma certa capacidade de prever o próximo estado. É possível prever alguns passos à frente.
Se o jogador está na sala verde, há 50% de chance de que ele permaneça lá na próxima observação. Mas qual é a probabilidade de ele ainda estar lá mesmo depois? Não há apenas a chance de que o jogador permaneceu na sala verde após duas observações, mas também a chance de que ele saiu e voltou. Aqui está uma nova tabela considerando os novos dados:
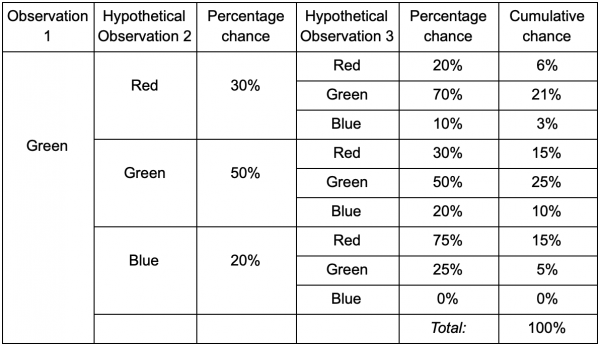
A partir dela, vemos que a chance de ver o jogador na sala verde após duas observações será de 51% — 21% de que ele venha da sala vermelha, 5% de que o jogador visitará a sala azul entre elas, e 25% de que o jogador não sairá da sala verde.
A tabela é uma ferramenta visual simples — o procedimento requer apenas multiplicação de probabilidades em cada passo. Isso significa que você pode olhar longe para o futuro com uma ressalva: assumimos que a chance de entrar em uma sala depende totalmente da sala atual. Isso é chamado de propriedade de Markov — o estado futuro depende apenas do presente. Mas isso não é 100% preciso. Os jogadores podem mudar suas decisões com base em outros fatores: níveis de saúde ou quantidade de munição. Como não fixamos esses valores, nossas previsões serão menos precisas.
N-Gramas
E quanto ao exemplo com uma luta e a previsão de combos do jogador? A mesma coisa! Mas em vez de um único estado ou evento, vamos explorar sequências inteiras que compõem o golpe do combo.
Uma forma de fazer isso é armazenar cada entrada (como Chute, Soco ou Bloqueio) em um buffer e registrar todo o buffer como um evento. Assim, o jogador aperta repetidamente Chute, Chute, Soco para usar o ataque SuperDeathFist, e o sistema de IA armazena todas as entradas no buffer e lembra as últimas três, utilizadas em cada passo.
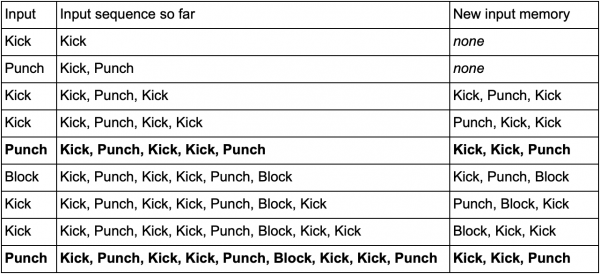
(Os trechos em negrito são as linhas quando o jogador inicia o ataque SuperDeathFist.)
A IA verá todas as opções quando o jogador escolher Chute, seguido de outro Chute, e depois notará que a próxima entrada é sempre um Soco. Isso permitirá que o agente preveja o combo SuperDeathFist e o bloqueie, se possível.
Essas sequências de eventos são chamadas de N-gramas, onde N é o número de elementos armazenados. No exemplo anterior, era um 3-grama (trigrama), o que significa: as duas primeiras entradas são usadas para prever a terceira. Assim, em um 5-grama, as quatro primeiras entradas preveem a quinta e assim por diante.
O desenvolvedor precisa escolher cuidadosamente o tamanho do N-grama. Um número menor de N requer menos memória, mas armazena uma história menor. Por exemplo, um 2-grama (bigram) registrará Chute, Chute ou Chute, Soco, mas não conseguirá armazenar Chute, Chute, Soco, portanto a IA não reagirá ao combo SuperDeathFist.
Por outro lado, números maiores exigem mais memória e a IA terá mais dificuldade em aprender, uma vez que haverá muito mais opções possíveis. Se você tinha três entradas possíveis: Chute, Soco ou Bloqueio, e usássemos um 10-grama, teríamos cerca de 60 mil variantes diferentes.
O modelo de bigramas é uma cadeia de Markov simples — cada par "estado anterior/estado atual" é um bigrama, e você pode prever o segundo estado com base no primeiro. Trigramas e n-gramas maiores também podem ser vistos como cadeias de Markov, onde todos os elementos (exceto o último no n-grama) formam juntos o primeiro estado, e o último elemento é o segundo. Um exemplo com luta mostra a chance de transição do estado Kick e Kick para o estado Kick e Punch. Ao considerar várias entradas do histórico como uma unidade, estamos essencialmente transformando a sequência de entrada em parte de um estado inteiro. Isso nos dá a propriedade de Markov, permitindo o uso de cadeias de Markov para prever a próxima entrada e adivinhar qual golpe de combo será o próximo.
Conclusão
Discutimos as ferramentas e abordagens mais comuns no desenvolvimento de inteligência artificial. Também analisamos as situações em que elas devem ser aplicadas e onde são particularmente úteis.
Isso deve ser suficiente para entender os conceitos básicos da IA em jogos. Mas, claro, está longe de ser todos os métodos. Menos populares, mas igualmente eficazes, incluem:
- algoritmos de otimização, incluindo subida de colinas, descida de gradiente e algoritmos genéticos
- algoritmos de busca/planejamento competitivos (minimax e poda alpha-beta)
- métodos de classificação (perceptrons, redes neurais e máquinas de vetores de suporte)
- sistemas para processamento de percepção e memória de agentes
- abordagens arquitetônicas para IA (sistemas híbridos, subconjuntos de arquiteturas e outras maneiras de sobrepor sistemas de IA)
- ferramentas de animação (planejamento e coordenação de movimento)
- fatores de desempenho (nível de detalhe, algoritmos anytime e timeslicing)
Recursos online sobre o assunto:
1. No GameDev.net, existe , além de .
2. contém uma variedade de apresentações e artigos sobre uma ampla gama de temas relacionados ao desenvolvimento de IA em jogos.
3. inclui tópicos da cúpula GDC AI, muitos dos quais estão disponíveis gratuitamente.
4. Materiais úteis também podem ser encontrados no site .
5. Tommy Thompson, pesquisador de IA e desenvolvedor de jogos, cria vídeos no canal do YouTube com explicações e estudos sobre IA em jogos comerciais.
Livros sobre o tema:
1. A série de livros Game AI Pro consiste em coletâneas de artigos curtos que explicam como implementar funções específicas ou como resolver problemas concretos.
2. A série AI Game Programming Wisdom é a predecessora da série Game AI Pro. Ela contém métodos mais antigos, mas quase todos ainda são relevantes hoje.
3. — é um dos textos fundamentais para todos que desejam entender a área geral de inteligência artificial. Este livro não é sobre desenvolvimento de jogos — ele ensina os fundamentos básicos de IA.
Fonte: habr.com
