

🥇UDP Flood do Google ou como não privar todos do Youtube | ProHoster
Olá a todos! Este artigo é uma coletânea de Melhores Práticas que eu e meus colegas aplicamos há muito tempo ao trabalhar em diversos projetos.
Informações sobre a máquina onde os cálculos foram realizados:BenchmarkDotNet=v0.11.5, OS=Windows 10.0.18362
Intel Core i5-8250U CPU 1.60GHz (Kaby Lake R), 1 CPU, 8 núcleos lógicos e 4 físicos
.NET Core SDK=3.0.100
[Host]: .NET Core 2.2.7 (CoreCLR 4.6.28008.02, CoreFX 4.6.28008.03), 64bit RyuJIT
Core: .NET Core 2.2.7 (CoreCLR 4.6.28008.02, CoreFX 4.6.28008.03), 64bit RyuJIT
[Host]: .NET Core 3.0.0 (CoreCLR 4.700.19.46205, CoreFX 4.700.19.46214), 64bit RyuJIT
Core: .NET Core 3.0.0 (CoreCLR 4.700.19.46205, CoreFX 4.700.19.46214), 64bit RyuJIT
Job=Core Runtime=Core
ToList vs ToArray e Ciclos
Eu planejava preparar essas informações com o lançamento do .NET Core 3.0, mas fui antecipado; não quero roubar o crédito de ninguém e copiar informações de terceiros, então apenas mencionarei .
De minha parte, gostaria apenas de apresentar minhas medições e resultados, adicionei ciclos reversos para os fãs de ‘estilo C++’ de escrever laços.
Código:
public class Bench
    {
        private List<int> _list;
        private int[] _array;

        [Params(100000, 10000000)] public int N;

        [GlobalSetup]
        public void Setup()
        {
            const int MIN = 1;
            const int MAX = 10;
            Random random = new Random();
            _list = Enumerable.Repeat(0, N).Select(i => random.Next(MIN, MAX)).ToList();
            _array = _list.ToArray();
        }

        [Benchmark]
        public int ForList()
        {
            int total = 0;
            for (int i = 0; i < _list.Count; i++)
            {
                total += _list[i];
            }

            return total;
        }

        [Benchmark]
        public int ForListFromEnd()
        {
            int total = 0;
            for (int i = _list.Count-1; i > 0; i--)
            {
                total += _list[i];
            }

            return total;
        }

        [Benchmark]
        public int ForeachList()
        {
            int total = 0;
            foreach (int i in _list)
            {
                total += i;
            }

            return total;
        }

        [Benchmark]
        public int ForeachArray()
        {
            int total = 0;
            foreach (int i in _array)
            {
                total += i;
            }

            return total;
        }

        [Benchmark]
        public int ForArray()
        {
            int total = 0;
            for (int i = 0; i < _array.Length; i++)
            {
                total += _array[i];
            }

            return total;
        }

        [Benchmark]
        public int ForArrayFromEnd()
        {
            int total = 0;
            for (int i = _array.Length-1; i > 0; i--)
            {
                total += _array[i];
            }

            return total;
        }
    }
A velocidade de operação no .NET Core 2.2 e 3.0 é quase idêntica. Aqui está o que consegui no .NET Core 3.0:
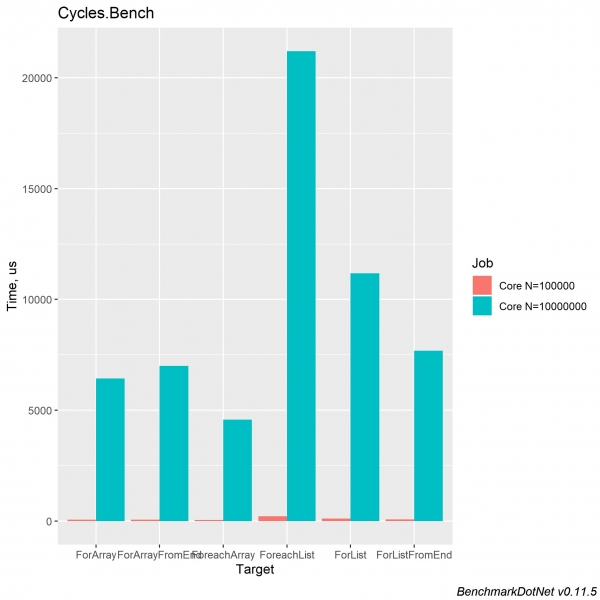
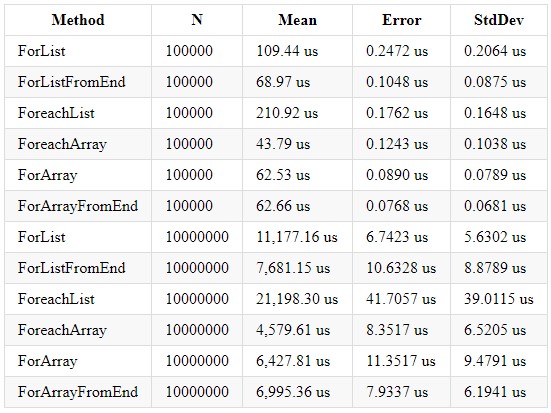
Podemos concluir que o processamento cíclico de uma coleção do tipo Array é mais rápido, devido às suas otimizações internas e ao dimensionamento explícito da coleção. Também é importante lembrar que a coleção do tipo List tem suas vantagens e você deve usar a coleção adequada dependendo dos cálculos necessários. Mesmo que você esteja escrevendo a lógica de funcionamento com ciclos, não se esqueça de que isso é um loop padrão e também está sujeito a possíveis otimizações de ciclos. Há bastante tempo, saiu um artigo no Habr: . Ele ainda é relevante e recomendado para leitura.
Throw
Há um ano, trabalhei em uma empresa em um projeto legado, onde era normal processar a validação de campos através de uma construção try-catch-throw. Já na época, percebia que essa lógica de negócios não era saudável, portanto, sempre que possível, tentava evitar tal construção. Mas vamos entender por que a abordagem de tratar erros dessa forma é ruim. Escrevi um pequeno código para comparar duas abordagens e fiz alguns "benchmarks" para cada opção.
Código:
        public bool ContainsHash()
        {
            bool result = false;
            foreach (var file in _files)
            {
                var extension = Path.GetExtension(file);
                if (_hash.Contains(extension))
                    result = true;
            }

            return result;
        }

        public bool ContainsHashTryCatch()
        {
            bool result = false;
            try
            {
                foreach (var file in _files)
                {
                    var extension = Path.GetExtension(file);
                    if (_hash.Contains(extension))
                        result = true;
                }

                if(!result)
                    throw new Exception("false");
            }
            catch (Exception e)
            {
                result = false;
            }

            return result;
        }
Os resultados no .NET Core 3.0 e Core 2.2 são semelhantes (.NET Core 3.0):
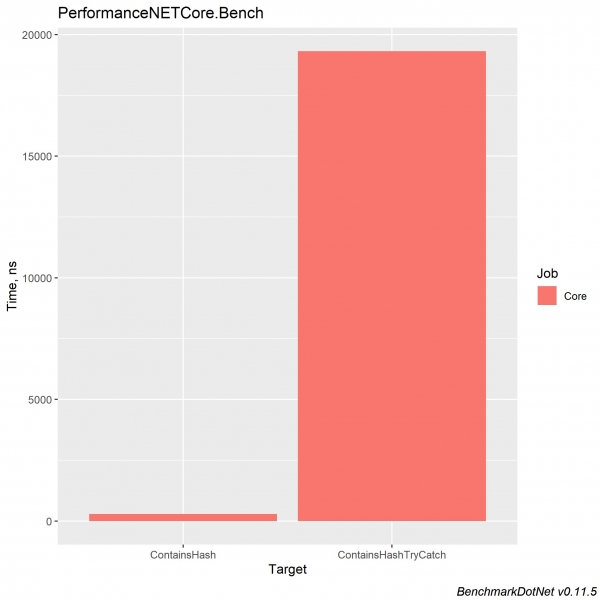
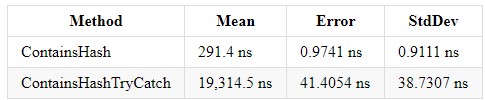
Try catch torna o código mais difícil de entender e aumenta o tempo de execução do seu programa. Mas se você precisa dessa construção, evite adicionar aquelas linhas de código que não requerem tratamento de erros — isso facilitará a compreensão do código. Na verdade, o que sobrecarrega o sistema não é tanto o tratamento de exceções, mas o lançamento real de erros por meio da construção throw new Exception.
Lançar exceções é mais lento do que qualquer classe que reúna o erro no formato necessário. Se você está processando um formulário ou alguns dados e sabe exatamente qual erro deve ocorrer, por que não tratá-los?
Não é aconselhável usar a construção throw new Exception() se essa situação não for excepcional. O tratamento e a geração de exceções são extremamente caros!!!
ToLower, ToLowerInvariant, ToUpper, ToUpperInvariant
Em meus 5 anos de experiência na plataforma .NET, encontrei muitos projetos que utilizavam comparações de strings. Também vi o seguinte cenário: havia uma solução Enterprise com vários projetos, cada um dos quais realizava comparações de strings de maneira diferente. Mas o que realmente devemos usar e como podemos unificá-lo? No livro CLR via C#, de Richter, encontrei informações de que o método ToUpperInvariant() é mais rápido do que o ToLowerInvariant().
Trecho do livro:
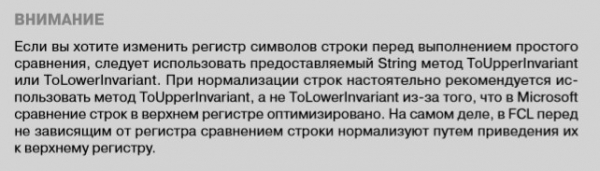
Claro que eu não acreditei e decidi fazer alguns testes na época, ainda no .NET Framework, e o resultado me surpreendeu — mais de 15% de aumento de desempenho. No dia seguinte, ao chegar ao trabalho, mostrei os dados das medições ao meu chefe e lhes dei acesso ao código-fonte. Após isso, 2 dos 14 projetos foram alterados para novas medições, e considerando que esses dois projetos existiam para processar enormes tabelas do Excel, o resultado foi muito significativo para o produto.
Também apresento medições para diferentes versões do .NET Core, para que cada um de vocês possa escolher a solução mais otimizada. E só quero acrescentar que na empresa onde trabalho, utilizamos o ToUpper() para comparações de strings.
Código:
public const string defaultString =  "VXTDuob5YhummuDq1PPXOHE4PbrRjYfBjcHdFs8UcKSAHOCGievbUItWhU3ovCmRALgdZUG1CB0sQ4iMj8Z1ZfkML2owvfkOKxBCoFUAN4VLd4I8ietmlsS5PtdQEn6zEgy1uCVZXiXuubd0xM5ONVZBqDu6nOVq1GQloEjeRN8jXrj0MVUexB9aIECs7caKGddpuut3";

        [Benchmark]
        public bool ToLower()
        {
            return defaultString.ToLower() == defaultString.ToLower();
        }

        [Benchmark]
        public bool ToLowerInvariant()
        {
            return defaultString.ToLowerInvariant() == defaultString.ToLowerInvariant();
        }

        [Benchmark]
        public bool ToUpper()
        {
            return defaultString.ToUpper() == defaultString.ToUpper();
        }

        [Benchmark]
        public bool ToUpperInvariant()
        {
            return defaultString.ToUpperInvariant() == defaultString.ToUpperInvariant();
        }
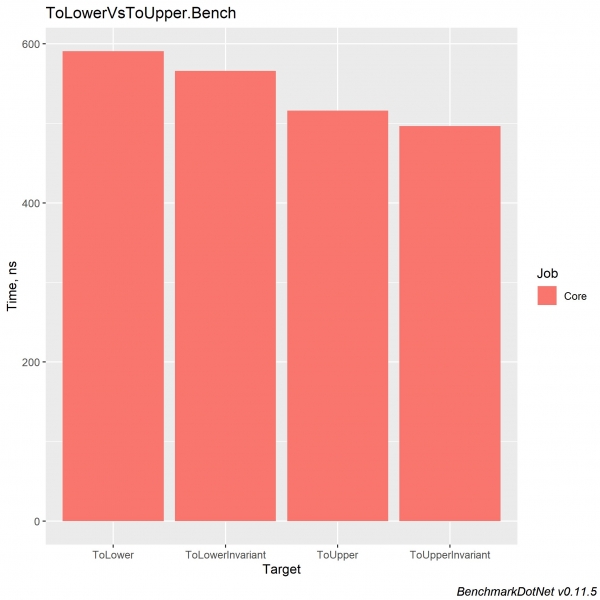
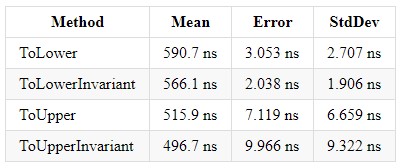
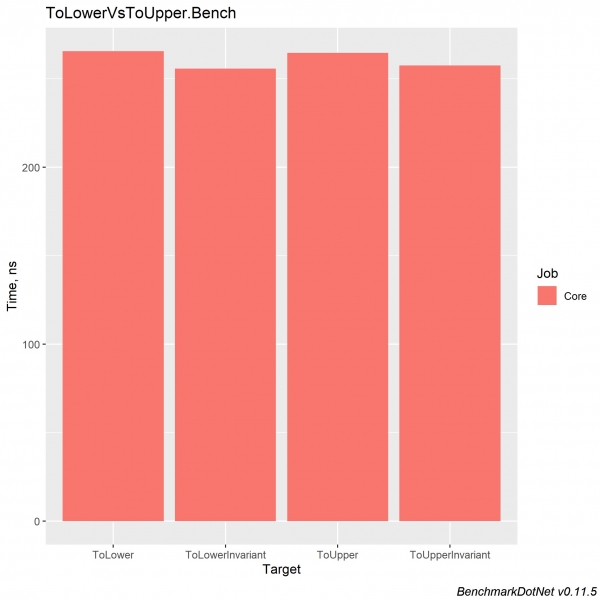
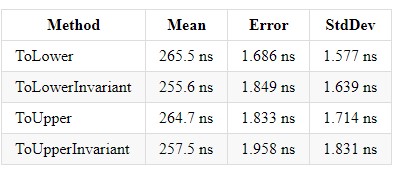
No .NET Core 3.0, o ganho para cada um desses métodos é de aproximadamente x2 e equilibra as implementações entre si.
Compilação em Camadas
No meu artigo anterior, descrevi essa funcionalidade brevemente, e gostaria de corrigir e complementar minhas palavras. A compilação em vários níveis acelera o tempo de inicialização da sua solução, mas você sacrifica o fato de que partes do seu código serão compiladas em uma versão mais otimizada em segundo plano, o que pode resultar em pequenas sobrecargas. Com a chegada do .NET Core 3.0, o tempo de compilação de projetos com a compilação em vários níveis foi reduzido e os bugs relacionados a essa tecnologia foram corrigidos. Antes, essa tecnologia resultava em erros nas primeiras requisições no ASP.NET Core e em travamentos durante a primeira compilação no modo de compilação em vários níveis. Atualmente, no .NET Core 3.0, ela está habilitada por padrão, mas você pode desativá-la se desejar. Se você ocupa uma posição de líder de equipe, sênior, intermediário ou é chefe de departamento, deve entender que uma rápida evolução do projeto aumenta o valor da equipe, e essa tecnologia permitirá que você economize tempo tanto dos desenvolvedores quanto do próprio tempo de desenvolvimento do projeto.
.NET subir de nível
Atualize a versão do seu .NET Framework / .NET Core. Muitas vezes, cada nova versão oferece um ganho adicional de desempenho e adiciona novos recursos.
Mas quais são exatamente as vantagens? Vamos analisar algumas delas:
- No .NET Core 3.0, surgiram as imagens R2R, que permitirão reduzir o tempo de inicialização de aplicativos .NET Core.
- A partir da versão 2.2, a Compilação em Nível foi introduzida, permitindo que os programadores gastem menos tempo inicializando o projeto.
- Suporte aos novos padrões do .NET Standard.
- Suporte à nova versão da linguagem de programação.
- Otimização, a cada nova versão a otimização das bibliotecas básicas Collection/Struct/Stream/String/Regex e muito mais melhora. Se você está migrando do .NET Framework para o .NET Core, terá um grande ganho de desempenho desde o início. Para exemplo, anexo um link para algumas das otimizações que foram adicionadas no .NET Core 3.0:
Conclusão
Ao escrever código, é importante prestar atenção a diferentes aspectos do seu projeto e utilizar as funções da sua linguagem de programação e plataforma para alcançar o melhor resultado. Fico feliz se você compartilhar seus conhecimentos relacionados à otimização no .NET.
Fonte: habr.com
