

Neste artigo, vamos discutir as dependências funcionais em bancos de dados — o que são, onde são aplicadas e quais algoritmos existem para sua busca.
Vamos considerar as dependências funcionais no contexto de bancos de dados relacionais. De forma mais simples, nesses bancos de dados, as informações são armazenadas na forma de tabelas. Em seguida, utilizamos conceitos aproximados que, na rigorosa teoria relacional, não são intercambiáveis: chamaremos a própria tabela de relação, as colunas de atributos (o conjunto deles é chamado de esquema da relação) e o conjunto de valores de uma linha sobre um subconjunto de atributos de tupla.
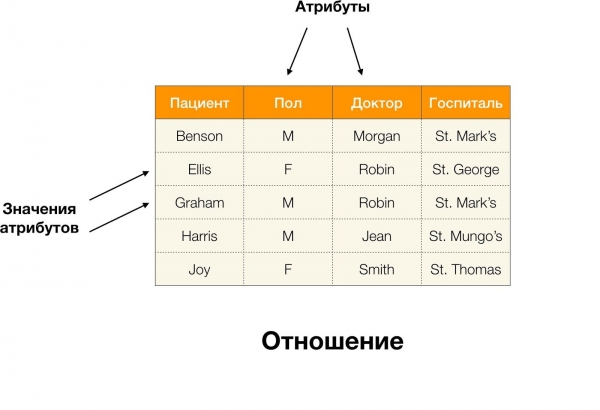
Por exemplo, na tabela acima, (Benson, M, M organ) é uma tupla pelos atributos (Paciente, Sexo, Doutor).
Mais formalmente, isso é escrito da seguinte forma:  [Paciente, Sexo, Doutor] = (Benson, M, M organ).
Agora podemos introduzir o conceito de dependência funcional (DF):
Definição 1. A relação R satisfaz a DF X → Y (onde X, Y ⊆ R) se e somente se para quaisquer tuplas  ,
 ∈ R, é verdade que: se
 [X] =
 [X], então
 [Y] =
 [Y]. Nesse caso, dizemos que X (determinante, ou conjunto definidor de atributos) define funcionalmente Y (conjunto dependente).
Em outras palavras, a existência da DF X → Y significa que, se tivermos duas tuplas em R e elas coincidirem nos atributos X, então elas também coincidirão nos atributos Y.
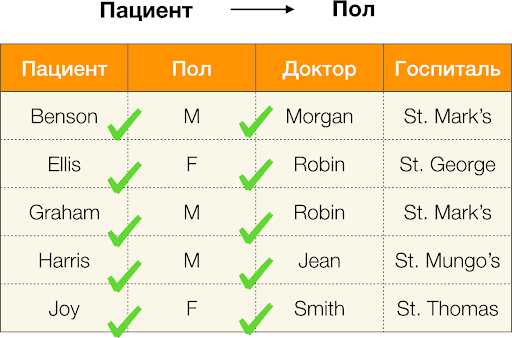
Agora, vamos em ordem. Vamos considerar os atributos Paciente e Gênero para os quais queremos saber se existem dependências entre eles ou não. Para tal conjunto de atributos, podem existir as seguintes dependências:
- Paciente → Sexo
- Sexo → Paciente
De acordo com a definição acima, para que a primeira dependência se mantenha, cada valor único da coluna Paciente deve corresponder a apenas um valor da coluna Gênero. E, para a tabela-exemplo, isso realmente é o que ocorre. No entanto, na direção oposta isso não funciona, ou seja, a segunda dependência não se mantém, e o atributo Gênero não é um determinante para Paciente.De modo semelhante, se tomarmos a dependência Doutor → Paciente, podemos notar que ela é violada, pois o valor Robin para este atributo tem vários valores diferentes — Ellis e Graham..
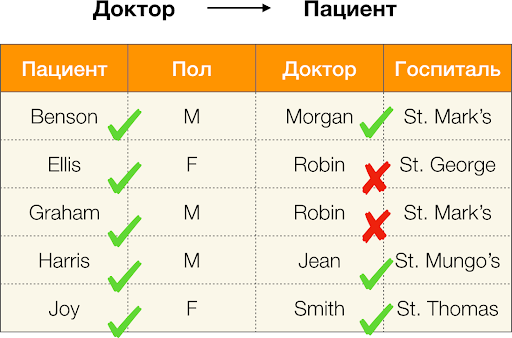
Assim, as dependências funcionais permitem identificar as relações existentes entre os conjuntos de atributos da tabela. Portanto, doravante, abordaremos as relações mais interessantes, ou seja, aquelas X → Y, que são:
- não triviais, ou seja, a parte direita da dependência não é um subconjunto da esquerda (Y ̸⊆ X);
- mínimas, ou seja, não existe tal dependência Z → Y, mesmo sem otimização para essas tarefas, tem sucesso em outra área: Z ⊂ X.
As dependências discutidas até este momento eram estritas, ou seja, não previam nenhuma violação na tabela, mas além delas, existem aquelas que permitem alguma inconsistência entre os valores das tuplas. Essas dependências são categorizadas em uma classe separada, chamadas de aproximadas, e é permitido que elas sejam violadas em um determinado número de tuplas. Essa quantidade é regulada pelo índice de erro máximo emax. Por exemplo, uma taxa de erro  = 0.01 pode significar que a dependência pode ser violada em 1% das tuplas existentes no conjunto de atributos considerado. Ou seja, para 1000 registros, no máximo 10 tuplas podem violar a FD. Porém, vamos considerar uma métrica um pouco diferente, baseada em valores distintos das tuplas comparadas. Para a dependência X → Y na relação r ela é calculada assim:

Vamos calcular o erro para Doutor → Paciente do exemplo acima. Temos duas tuplas cujos valores diferem no atributo Paciente, mas coincidem em Doutor:  [Doutor, Paciente] = (Robin, Ellis) e
 [Doutor, Paciente] = (Robin, Graham). Seguindo a definição de erro, devemos considerar todos os pares conflitantes, o que significa que haverá dois pares: (
 ,
 ) e sua inversão (
 ,
 ). Vamos substituir na fórmula e obter:

E agora vamos tentar responder à pergunta: "E para que tudo isso serve?". Na verdade, existem diferentes tipos de FD. O primeiro tipo é aquele que é definido pelo administrador na fase de projeto do banco de dados. Geralmente, eles são poucos, estritos e sua principal aplicação é na normalização de dados e no design do esquema relacional.
O segundo tipo é a dependência que representa dados "ocultos" e conexões anteriormente desconhecidas entre atributos. Ou seja, essas dependências não eram pensadas no momento do projeto e são encontradas já para um conjunto de dados existente, para depois, com base em múltiplas dependências funcionais identificadas, fazer inferências sobre as informações armazenadas. É exatamente com essas dependências que trabalhamos. Uma área inteira de mineração de dados se ocupa delas, utilizando várias técnicas de busca e algoritmos desenvolvidos com base nelas. Vamos entender como as dependências funcionais encontradas (exatas ou aproximadas) podem ser úteis em certos dados.
Hoje, entre as principais áreas de aplicação das dependências, destaca-se a limpeza de dados. Isso envolve o desenvolvimento de processos para identificar "dados sujos" seguidos de sua correção. Exemplos típicos de "dados sujos" são duplicatas, erros nos dados ou digitações, valores faltantes, dados desatualizados, espaços em branco excessivos e assim por diante.
Exemplo de erro nos dados:
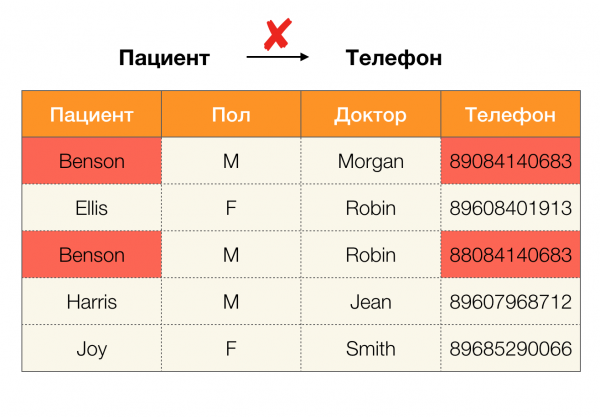
Exemplo de duplicatas nos dados:
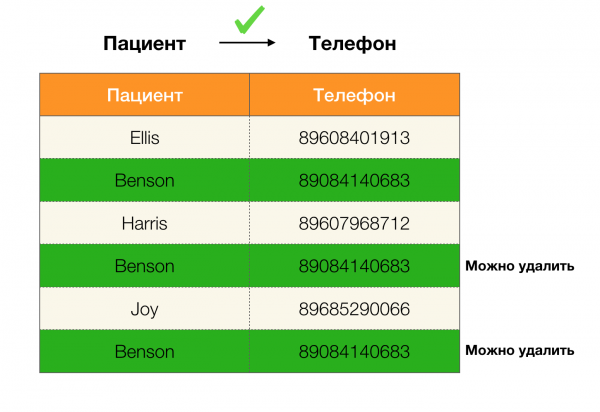
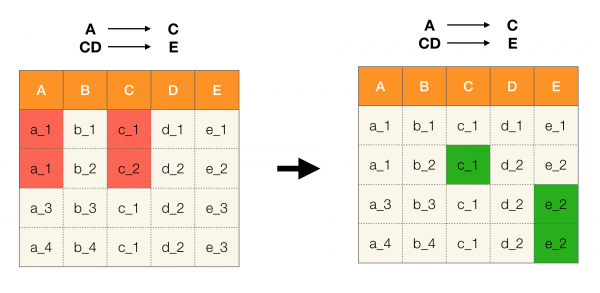
Por exemplo, temos uma tabela e um conjunto de dependências funcionais que devem ser atendidas. A limpeza de dados, neste caso, envolve modificar os dados de forma que as dependências se tornem verdadeiras. O número de modificações deve ser mínimo (para este procedimento existem algoritmos específicos, que não focaremos neste artigo). Abaixo está um exemplo dessa transformação de dados. À esquerda está a relação original, na qual claramente não são atendidas as dependências necessárias (a violação de uma das dependências está destacada em vermelho). À direita, está a relação atualizada, onde as células verdes mostram os valores alterados. Após a realização desse procedimento, as dependências necessárias passaram a ser mantidas.
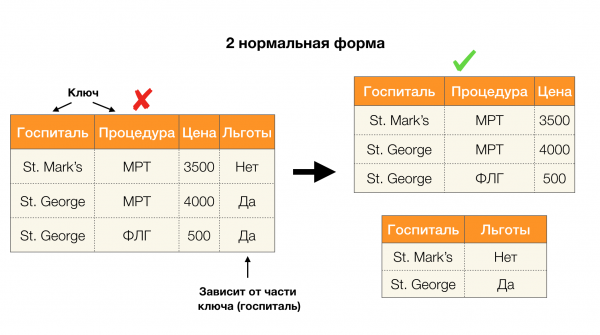
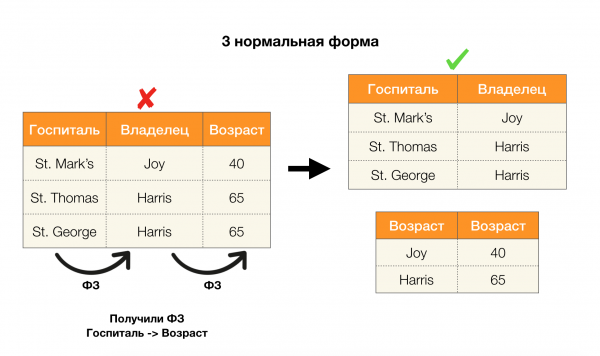
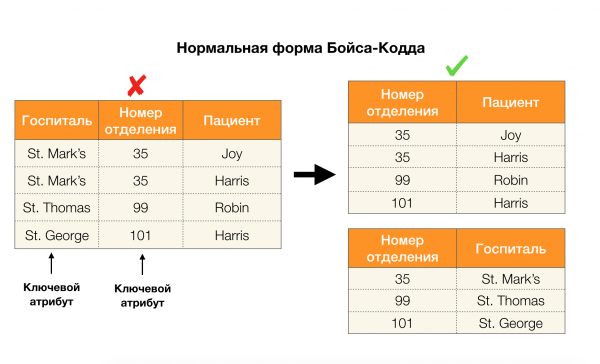
Outra área popular de aplicação é o design de banco de dados. Aqui, vale a pena lembrar das formas normais e da normalização. A normalização é o processo de conformar uma relação a um conjunto de requisitos, cada um dos quais é definido de forma diferente pela forma normal. Não vamos detalhar os requisitos das várias formas normais (isso é abordado em qualquer livro introdutório sobre o curso de bancos de dados), mas apenas notar que cada uma delas utiliza a ideia de dependências funcionais à sua maneira. Pois as DF, por sua essência, são restrições de integridade que são levadas em conta ao projetar um banco de dados (neste contexto, as DF às vezes são chamadas de superchaves).
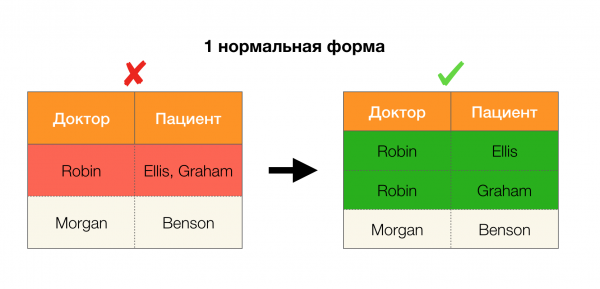
Vamos considerar suas aplicações para quatro formas normais na imagem abaixo. Lembre-se de que a forma normal de Boyce-Codd é mais rigorosa do que a terceira forma, mas menos rigorosa do que a quarta. Não iremos considerar esta última por enquanto, pois para sua origem é necessário entender as dependências multivaloradas, que não são o foco deste artigo.
Mais uma área na qual as dependências encontraram sua aplicação é na redução da dimensionalidade do espaço de características em tarefas como a construção de um classificador bayesiano ingênuo, extração de características significativas e reparametrização de modelos de regressão. Em artigos originais, essa tarefa é chamada de definição de características redundantes (feature redundancy) e relevantes (feature relevancy) [5, 6], sendo que sua resolução utiliza ativamente conceitos de bancos de dados. Com o surgimento de tais trabalhos, podemos dizer que atualmente há uma demanda por soluções que integrem banco de dados, análise e a implementação das questões de otimização mencionadas em uma única ferramenta [7, 8, 9].
Existem muitos algoritmos (tanto modernos quanto não) para encontrar DF em um conjunto de dados. Esses algoritmos podem ser divididos em três grupos:
- Algoritmos que utilizam a travessia de reticulados algébricos (Lattice traversal algorithms)
- Algoritmos baseados em busca de valores consistentes (Difference- and agree-set algorithms)
- Algoritmos baseados em comparações par a par (Dependency induction algorithms)
Uma breve descrição de cada tipo de algoritmo é apresentada na tabela abaixo:
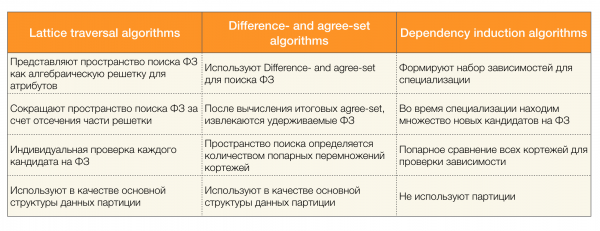
Saiba mais sobre essa classificação em [4]. Abaixo estão exemplos de algoritmos para cada um dos tipos:
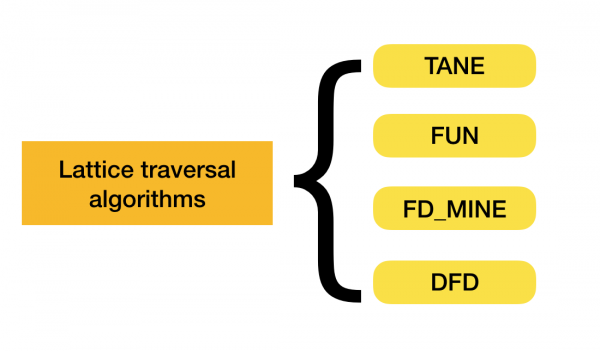
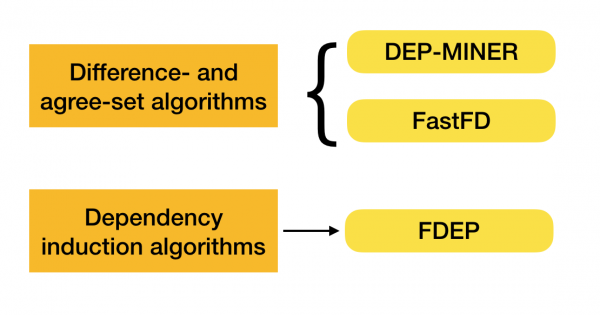
Atualmente, novos algoritmos estão surgindo, combinando várias abordagens na busca por dependências funcionais. Exemplos desses algoritmos incluem Pyro [2] e HyFD [3]. A análise de seu funcionamento será abordada nos próximos artigos desta série. Neste artigo, abordaremos apenas os conceitos básicos e o lema necessário para entender as técnicas de identificação de dependências.
Começaremos com o simples — difference-set e agree-set, utilizados no segundo tipo de algoritmos. O difference-set é um conjunto de tuplas que não coincidem em valores, enquanto o agree-set é composto por tuplas que coincidem em valores. Vale ressaltar que, neste caso, estamos considerando apenas a parte esquerda da dependência.
Outro conceito importante mencionado anteriormente é a rede algébrica. Como muitos algoritmos modernos operam com esse conceito, precisamos entender do que se trata.
Para introduzir o conceito de rede, é necessário a definição de um conjunto parcialmente ordenado (ou partially ordered set, abreviado como poset).
Definição 2. Diz-se que o conjunto S é parcialmente ordenado pela relação binária ⩽ se, para quaisquer a, b, c ∈ S, as seguintes propriedades forem satisfeitas:
- Reflexividade, ou seja, a ⩽ a
- Antissimetria, ou seja, se a ⩽ b e b ⩽ a, então a = b
- Transitividade, ou seja, para a ⩽ b e b ⩽ c, segue-se que a ⩽ c
Tal relação é chamada de relação (não estrita) de parcialidade, e o conjunto em si é chamado de conjunto parcialmente ordenado. Notação formal: ⟨S, ⩽⟩.
Como um exemplo simples de conjunto parcialmente ordenado, podemos considerar o conjunto de todos os números naturais N com a relação usual de ordem ⩽. Não é difícil verificar que todas as axiomas necessárias são satisfeitas.
Um exemplo mais substancial. Consideremos o conjunto de todos os subconjuntos {1, 2, 3}, ordenado pela relação de inclusão ⊆. De fato, essa relação atende a todas as condições de parcialidade, portanto ⟨P ({1, 2, 3}), ⊆⟩ é um conjunto parcialmente ordenado. Na figura abaixo, está representada a estrutura desse conjunto: se de um elemento é possível chegar a outro por meio de setas, eles estão em relação de ordem.
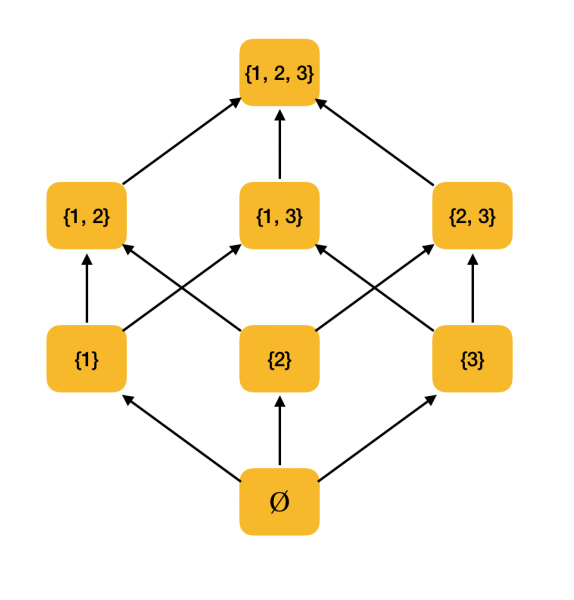
Precisamos de mais duas definições simples da matemática - supremum (supremum) e infimum (infimum).
Definição 3. Seja ⟨S, ⩽⟩ - um conjunto parcialmente ordenado, A ⊆ S. O limite superior de A é um elemento u ∈ S, tal que ∀x ∈ S: x ⩽ u. Seja U - o conjunto de todos os limites superiores de S. Se em U existe um menor elemento, então ele é chamado de supremum e é denotado como sup A.
Analogamente, introduzimos o conceito de limite inferior exato.
Definição 4. Seja ⟨S, ⩽⟩ - um conjunto parcialmente ordenado, A ⊆ S. O limite inferior de A é um elemento l ∈ S, tal que ∀x ∈ S: l ⩽ x. Seja L - o conjunto de todos os limites inferiores de S. Se em L existe um maior elemento, então ele é chamado de infimum e é denotado como inf A.
Consideremos como exemplo o conjunto parcialmente ordenado mencionado acima ⟨P ({1, 2, 3}), ⊆⟩ e vamos encontrar nele o supremum e o infimum:
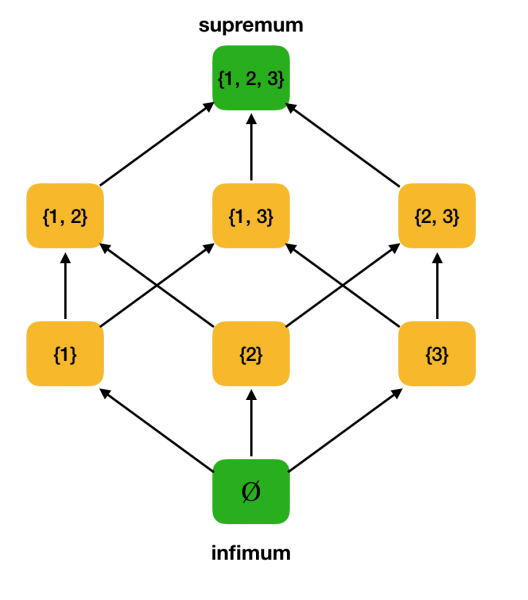
Agora podemos formular a definição de uma rede algébrica.
Definição 5. Seja ⟨P, ⩽⟩ - um conjunto parcialmente ordenado, tal que qualquer subconjunto de dois elementos tem limites superiores e inferiores exatos. Então P é chamado de rede algébrica. Aqui, sup{x, y} é escrito como x ∨ y, e inf {x, y} - como x ∧ y.
Vamos verificar se nosso exemplo de trabalho ⟨P ({1, 2, 3}), ⊆⟩ é uma rede. De fato, para quaisquer a, b ∈ P ({1, 2, 3}), a∨b = a∪b, e a∧b = a∩b. Por exemplo, considerando os conjuntos {1, 2} e {1, 3}, vamos encontrar seus infimum e supremum. Se os intersecarmos, obteremos o conjunto {1}, que será o infimum. O supremum obtemos pela união deles - {1, 2, 3}.
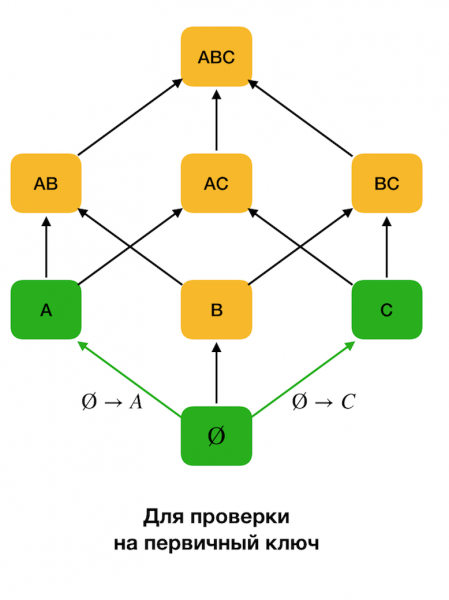
Nos algoritmos de descoberta de FD, o espaço de busca muitas vezes é representado na forma de uma rede, onde conjuntos de um elemento (leia-se primeiro nível da rede de busca, onde a parte esquerda das dependências consiste em um único atributo) representam cada atributo da relação original.
No início, consideram-se dependências do tipo ∅ → Um atributo isolado. Esse passo permite identificar quais atributos são chaves primárias (para esses atributos não há determinantes, portanto a parte esquerda está vazia). Em seguida, tais algoritmos avançam para cima na rede. Vale ressaltar que a rede pode não ser percorrida por completo, isto é, se for passado como entrada o tamanho máximo desejado da parte esquerda, o algoritmo não irá além do nível com esse tamanho.
A imagem abaixo mostra como uma grade algébrica pode ser utilizada na busca de FD. Aqui, cada aresta (X, XY) representa uma dependência X → Y. Por exemplo, avançamos para o primeiro nível e sabemos que a dependência é mantida A → B (representaremos isso com uma conexão verde entre os vértices A e B). Assim, ao avançarmos pela grade para cima, não precisamos verificar a dependência A, C → B, porque ela já não será mínima. Da mesma forma, não iríamos verificá-la se a dependência C → B.
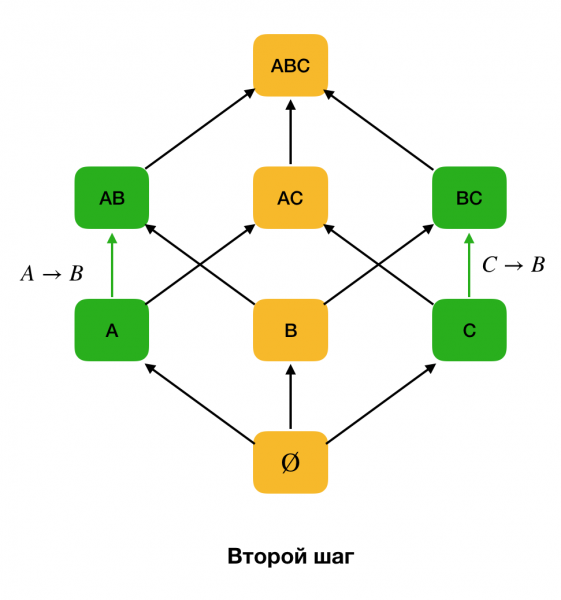
fosse mantida. Além disso, geralmente todos os algoritmos modernos de busca de FD utilizam uma estrutura de dados chamada partição (no original — stripped partition [1]). A definição formal de partição é a seguinte:
Definição 6. Seja X ⊆ R um conjunto de atributos para a relação r. Um cluster é um conjunto de índices de tuplas de r que possuem o mesmo valor para X, ou seja, c(t) = {i|ti[X] = t[X]}. A partição é um conjunto de clusters que exclui clusters de comprimento unitário:

Em termos simples, a partição para o atributo X é um conjunto de listas, onde cada lista contém os números das linhas com valores iguais para X. Na literatura moderna, a estrutura que representa partições é chamada de index de lista de posições (PLI). Clusters de comprimento unitário são excluídos para compactar o PLI, pois são clusters que contêm apenas o número da entrada com um valor único, o que sempre será fácil de determinar.
Vamos considerar um exemplo. Vamos voltar à mesma tabela de pacientes e construir partições para as colunas Paciente e Gênero (uma nova coluna apareceu à esquerda, na qual os números das linhas da tabela estão marcados):
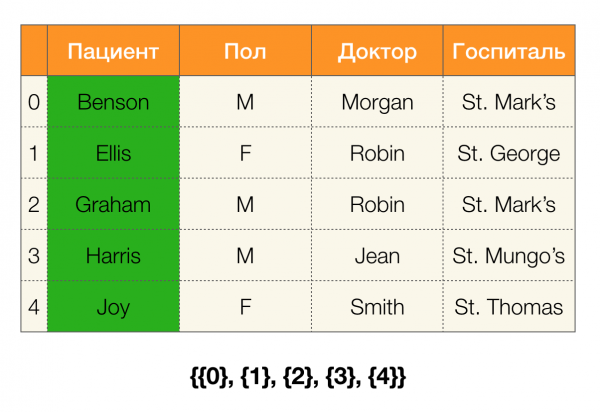
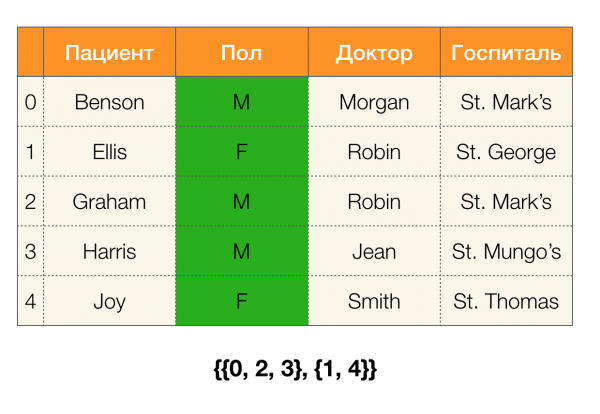
Neste caso, de acordo com a definição, a partição para a coluna Paciente na verdade será vazia, uma vez que clusters unitários são excluídos da partição.
Partições podem ser obtidas por vários atributos. E para isso existem duas maneiras: percorrendo a tabela, construir a partição imediatamente para todos os atributos necessários, ou construir uma partição usando a operação de interseção de partições em um subconjunto de atributos. Os algoritmos de busca de FD utilizam a segunda opção.
Em termos simples, para, por exemplo, obter a partição para as colunas ABC, podemos pegar partições para AC e B (ou qualquer outro conjunto de subconjuntos não sobrepostos) e intersecá-los entre si. A operação de interseção de duas partições destaca os clusters de maior comprimento comuns a ambas as partições.
Vamos considerar um exemplo:
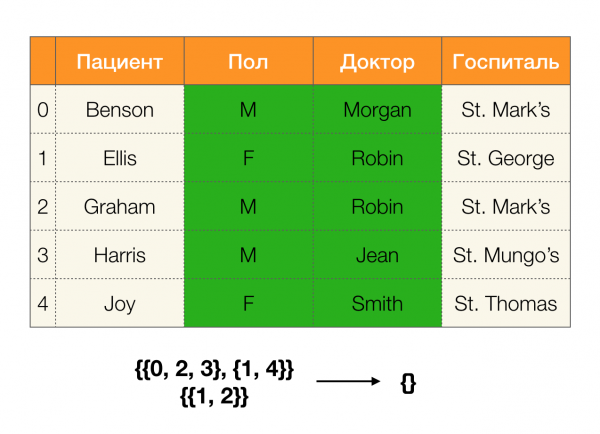
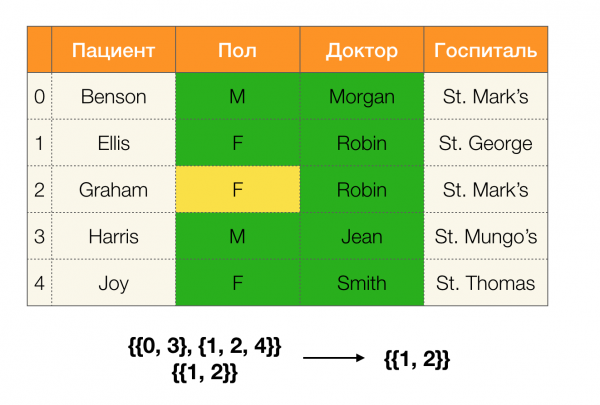
No primeiro caso, obtivemos uma partição vazia. Se observarmos a tabela, realmente não existem valores iguais para os dois atributos. Mas, se fizermos uma pequena modificação na tabela (caso à direita), já obteremos uma interseção não vazia. Nesse caso, as linhas 1 e 2 realmente contêm valores iguais para os atributos. Gênero e Doutor.
Em seguida, precisaremos de um conceito chamado tamanho da partição. Formalmente:

Simplificando, o tamanho da partição representa o número de clusters que pertencem à partição (lembrando que clusters unitários não contam na partição!):
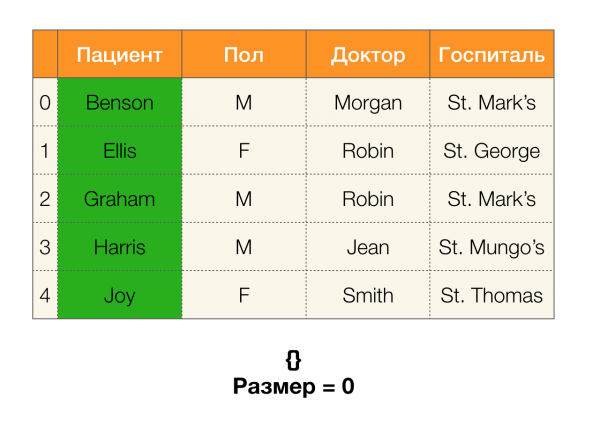
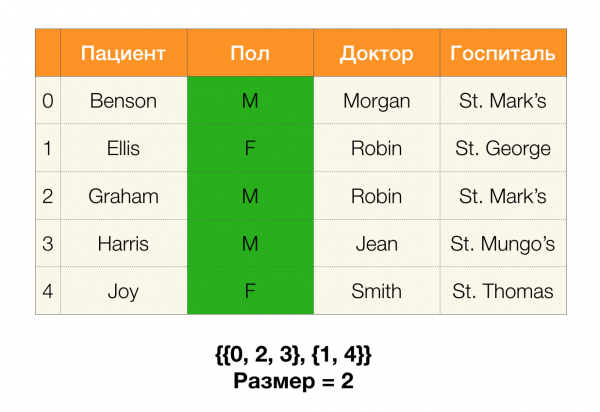
Agora podemos definir um dos lemas-chave que, para as partições dadas, permite determinar se a dependência é mantida ou não:
Lema 1. A dependência A, B → C é mantida se e somente se

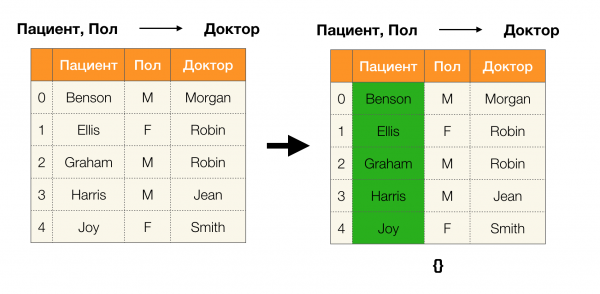
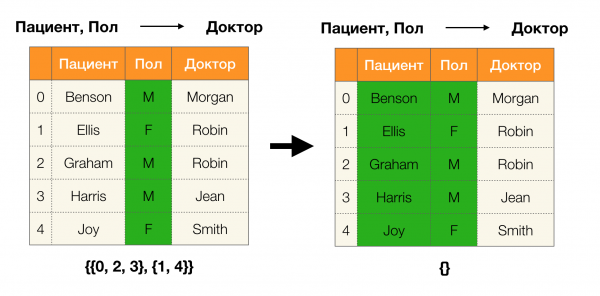
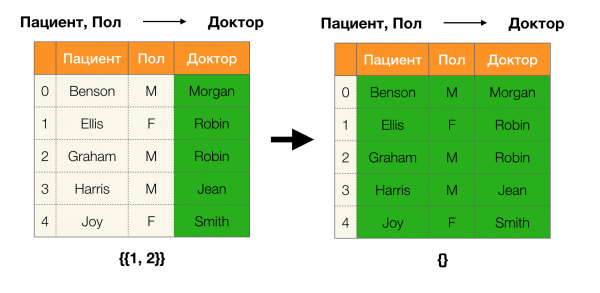
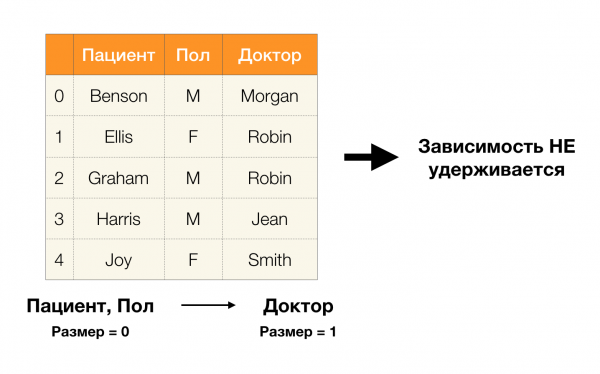
De acordo com o lema, para determinar se a dependência é mantida, é necessário seguir quatro etapas:
- Calcular a partição para a parte esquerda da dependência
- Calcular a partição para a parte direita da dependência
- Calcular o produto do primeiro e do segundo passo
- Comparar os tamanhos das partições obtidas no primeiro e no terceiro passo
Abaixo está um exemplo de verificação se a dependência é mantida de acordo com este lema:
Neste artigo, discutimos conceitos como dependência funcional, dependência funcional aproximada, onde são aplicadas e quais algoritmos de busca de DF existem. Também discutimos em detalhe os conceitos básicos, mas importantes, amplamente utilizados em algoritmos modernos de busca de DF.
Referências:
- Huhtala Y. et al. TANE: Um algoritmo eficiente para descobrir dependências funcionais e aproximadas //The computer journal. – 1999. – v. 42. – n. 2. – p. 100-111.
- Kruse S., Naumann F. Descoberta eficiente de dependências aproximadas //Proceedings of the VLDB Endowment. – 2018. – v. 11. – n. 7. – p. 759-772.
- Papenbrock T., Naumann F. Uma abordagem híbrida para descoberta de dependências funcionais //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – p. 821-833.
- Papenbrock T. et al. Descoberta de dependência funcional: Uma avaliação experimental de sete algoritmos //Proceedings of the VLDB Endowment. – 2015. – v. 8. – n. 10. – p. 1082-1093.
- Kumar A. et al. Juntar ou não juntar?: Pensando duas vezes sobre junções antes da seleção de características //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – p. 19-34.
- Abo Khamis M. et al. Aprendizado em banco de dados com tensores esparsos //Atas do 37º Simpósio ACM SIGMOD-SIGACT-SIGAI sobre Princípios dos Sistemas de Banco de Dados. – ACM, 2018. – P. 325-340.
- Hellerstein J. M. et al. A biblioteca de análises MADlib: ou habilidades MAD, o SQL //Atas do VLDB Endowment. – 2012. – Vol. 5. – N. 12. – P. 1700-1711.
- Qin C., Rusu F. Aproximações especulativas para otimização de descida de gradiente distribuído em terascale //Atas do Quarto Workshop sobre Análise de Dados na Nuvem. – ACM, 2015. – P. 1.
- Meng X. et al. Mllib: Aprendizado de máquina em apache spark //The Journal of Machine Learning Research. – 2016. – Vol. 17. – N. 1. – P. 1235-1241.
Autores do artigo: , pesquisadora na , e , pesquisadora na
Fonte: habr.com
