

O primeiro protótipo de armazenamento de objetos foi apresentado ao mundo em 1996. Dez anos depois, a Amazon Web Services lançou o Amazon S3, e o mundo começou a enlouquecer progressivamente com o espaço de endereçamento plano. Graças ao trabalho com metadados e à sua capacidade de escalabilidade sem perder performance, os armazenamento de objetos rapidamente se tornaram o padrão para a maioria dos serviços de armazenamento em nuvem, e não só. Outra característica importante é a boa adaptação para armazenar arquivos raramente utilizados, como arquivos de arquivamento. Todos que estavam envolvidos com o armazenamento de dados comemoraram e adotaram essa nova tecnologia.
Mas rumores entre as pessoas se espalhavam dizendo que os armazenamento de objetos eram apenas para grandes nuvens, e se você não precisava de soluções dos malditos capitalistas, era muito difícil criar a sua própria. Já foram escritas muitas coisas sobre a implantação da sua própria nuvem, mas há poucas informações sobre a criação de soluções compatíveis com S3.
Portanto, hoje vamos explorar quais são as opções "Para algo similar ao que os grandes fazem, e não CEPH, e com um pouco mais de empenho", vamos implementar uma delas, e testaremos se tudo funciona com o Veeam Backup & Replication. Ele declara suporte para trabalhar com armazenamento compatível com S3, e essa é a declaração que iremos verificar.
E como está com os outros?
Comecemos com uma breve visão geral do mercado e das opções de armazenamento de objetos. O líder indiscutível e padrão é o Amazon S3. Os dois concorrentes mais próximos são o Microsoft Azure Blob Storage e o IBM Cloud Object Storage.
É só isso? Não há outros concorrentes? Claro que há concorrentes, mas alguns seguem seu próprio caminho, como o Google Cloud ou o Oracle Cloud Object Storage, com suporte incompleto para a API do S3. Outros usam versões antigas da API, como o Baidu Cloud. E alguns, como o Hitachi Cloud, exigem uma lógica especial, o que certamente trará suas dificuldades. De qualquer forma, todos são comparados à Amazon, que pode ser considerada o padrão da indústria.
Já nas soluções on-premise, a escolha é muito maior, então vamos estabelecer critérios importantes para nós. Em princípio, bastam dois: suporte à API do S3 e uso da assinatura v4. Sendo sincero, o que nos interessa como futuros clientes são apenas as interfaces de interação, e a parte interna do armazenamento em si já nos interessa menos.
Há muitas soluções que se encaixam nesses requisitos simples. Por exemplo, pesos pesados corporativos clássicos:
- Dell EMC ECS
- NetApp S3 StorageGrid
- Nutanix Buckets
- Pure Storage FlashBlade e StorReduce
- Huawei FusionStorage
Há um nicho de soluções puramente de software que funcionam prontamente:
- Red Hat Ceph
- SUSE Enterprise Storage
- Cloudian
E até mesmo os aficionados por ajustes meticulosos após a montagem não foram esquecidos:
- CEPH em seu estado puro
- Minio (versão Linux, pois há muitas questões com a versão para Windows)
A lista não está completa, pode ser discutida nos comentários. Apenas não se esqueçam de verificar, além da compatibilidade da API, também o desempenho do sistema antes da implementação. A última coisa que vocês querem é perder terabytes de dados devido a solicitações pendentes. Portanto, não hesitem em realizar testes de carga. Todo software maduro que trabalha com grandes volumes de dados possui, no mínimo, relatórios de compatibilidade. No caso do Veeam tem de testes mútuos, permitindo afirmar com confiança a total compatibilidade de nossos produtos com equipamentos específicos. Este já é um trabalho bilateral, nem sempre rápido, mas estamos constantemente expandindo as soluções testadas.
Estamos montando nosso stand
Quero falar um pouco sobre a escolha do sujeito de teste.
Primeiramente, eu queria encontrar uma opção que funcionasse automaticamente. Ou pelo menos com a maior probabilidade de funcionar sem a necessidade de movimentos desnecessários. Dançar em torno e mexer no console à noite é muito interessante, mas às vezes preferimos que funcione de imediato. E, geralmente, a confiabilidade dessas soluções é maior. E sim, a nossa coragem aventureira desapareceu, paramos de escalar janelas para ver nossas amadas, etc.
Em segundo lugar, para ser honesto, a necessidade de trabalhar com armazenamentos de objetos surge em empresas bastante grandes, então este é o caso em que olhar para soluções de nível enterprise não só não é vergonhoso, como é até encorajado. De qualquer forma, até agora não tenho exemplos de que alguém tenha sido demitido por comprar soluções desse tipo.
Com base em tudo que foi dito, minha escolha recaiu sobre Dell EMC ECS Community Edition. Este é um projeto muito interessante, e considero necessário contar a vocês sobre ele.
A primeira coisa que vem à mente ao ver o complemento Community Edition — isso não é simplesmente uma cópia do ECS completo com algumas limitações que são removidas pela compra da licença. Portanto, não é isso!
Lembre-se:
!!!A Community Edition é um projeto separado, criado para testes, e sem suporte técnico da Dell!!
E não pode ser transformada em um ECS completo, mesmo que você realmente queira.
Vamos esclarecer.
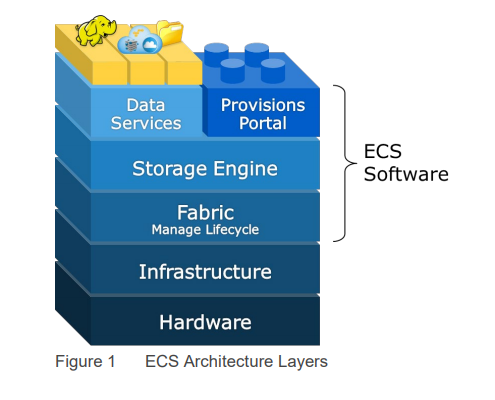
Muitos acreditam que o Dell EMC ECS é uma das melhores soluções disponíveis quando se trata de armazenamento de objetos. Todos os projetos sob a marca ECS, incluindo os comerciais e corporativos, estão baseados em . Esta é uma espécie de gesto de boa vontade da Dell. Além do software que roda em seu hardware de marca, existe uma versão open source que pode ser implantada em nuvem, em uma máquina virtual, em um contêiner ou em qualquer hardware que você possua. Para adiantar — existe até uma versão OVA, que nós iremos utilizar.
O próprio DELL ECS Community Edition é uma versão mini do software completo, operando em servidores Dell EMC ECS.
Eu destaquei quatro principais diferenças:
- Não há suporte para criptografia. É decepcionante, mas não crítico.
- Falta a Fabric Layer. Esta parte é responsável pela construção de clusters, gestão de recursos, atualizações, monitoramento e armazenamento de imagens Docker. Aqui já é bem decepcionante, mas a Dell também pode ser compreendida.
- A consequência mais desagradável do ponto anterior: o tamanho do nó não pode ser expandido após a conclusão da instalação.
- Não há suporte técnico. Este é um produto para testes, que pode ser utilizado em pequenas instalações, mas eu não arriscaria armazenar petabytes de dados importantes lá. Contudo, tecnicamente ninguém pode impedir você de fazê-lo.
E o que há na versão maior?
Vamos dar uma rápida passada pelas soluções de hardware para ter uma compreensão mais completa do ecossistema.
De alguma forma, não vou confirmar ou refutar a afirmação de que o DELL ECS é o melhor armazenamento de objetos on-prem, mas se você tem algo a dizer sobre isso, ficaria feliz em ler nos comentários. De qualquer forma, de acordo com A Dell EMC está firmemente entre os cinco principais líderes do mercado de OBS. Embora as soluções baseadas em nuvem não sejam consideradas, essa é uma conversa separada.
Do ponto de vista técnico, o ECS é um armazenamento de objetos que fornece acesso a dados por meio de protocolos de armazenamento em nuvem. Suporta AWS S3 e OpenStack Swift. Para buckets habilitados para arquivos, o ECS suporta NFSv3 para a exportação de arquivos.
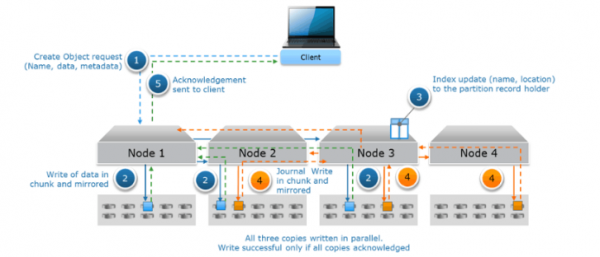
O processo de gravação de informações é bastante incomum, especialmente em comparação com sistemas clássicos de armazenamento em bloco.
- Quando novos dados chegam, um novo objeto é criado, que possui um nome, os próprios dados e metadados.
- Os objetos são divididos em chunks de 128 MB, e cada chunk é gravado simultaneamente em três nós.
- O arquivo de índice é atualizado, onde são registrados os identificadores e os locais de armazenamento.
- O arquivo de log (registro) também é atualizado e gravado em três nós.
- Um aviso de gravação bem-sucedida é enviado ao cliente.
Todas as três cópias dos dados são gravadas em paralelo. A gravação é considerada bem-sucedida somente se todas as três cópias forem gravadas com sucesso.
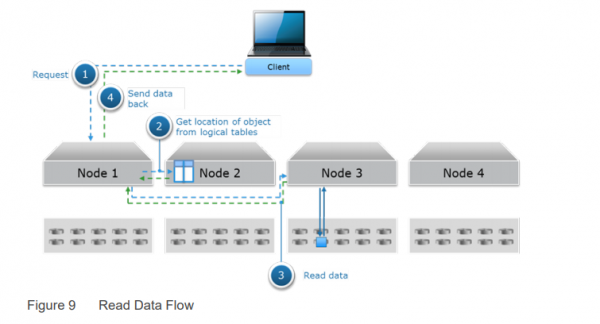
A leitura é bem mais simples:
- O cliente solicita os dados.
- O índice é pesquisado para encontrar o local de armazenamento dos dados.
- Os dados são lidos de um nó e enviados ao cliente.
Existem muitos servidores, então vamos olhar para o menor, o Dell EMC ECS EX300. Ele começa com 60TB, podendo crescer até 1,5PB. Seu irmão maior, o Dell EMC ECS EX3000, permite armazenar até 8,6PB por rack.
Deploy
Tecnicamente, o Dell ECS CE pode ser dimensionado indefinidamente. De qualquer forma, não encontrei restrições explícitas. No entanto, toda a escalabilidade é convenientemente feita através da clonagem do nó inicial, para a qual precisaremos de:
- 8 vCPU
- 64GB de RAM
- 16GB para o sistema operacional
- 1TB diretamente para armazenamento
- A última versão do CentOS minimal
Esta é uma opção para quando você deseja instalar tudo manualmente desde o início. Para nós, esta opção não é relevante, pois vou usar uma imagem OVA para o deploy.
Mas de qualquer forma, os requisitos são bastante rigorosos até mesmo para um único nó, e se seguirmos estritamente as regras, será necessário ter quatro desses nós.
No entanto, os desenvolvedores do ECS CE vivem no mundo real, e a instalação ocorre com sucesso mesmo com um único nó, e os requisitos mínimos são:
- 4 vCPU
- 16 GB de RAM
- 16GB para o sistema operacional
- 104GB de armazenamento
Esses são os recursos necessários para implantar a imagem OVA. Já é muito mais razoável e realista.
O próprio nó de instalação pode ser adquirido oficialmente. . Há também uma documentação detalhada sobre o deploy tudo-em-um, mas você pode ler mais no oficial . Portanto, não vamos nos aprofundar na implementação do OVA, não tem mistério. O mais importante é não esquecer de aumentar o disco para o tamanho necessário ou anexar o que for preciso antes de iniciá-lo.
Iniciamos a máquina, abrimos o console e usamos as melhores credenciais padrão:
- login: admin
- senha: ChangeMe
Em seguida, rodamos sudo nmtui e configuramos a interface de rede — IP/máscara, DNS e gateway. Lembrando que no CentOS minimal não há net-tools, verificamos as configurações através de ip addr.
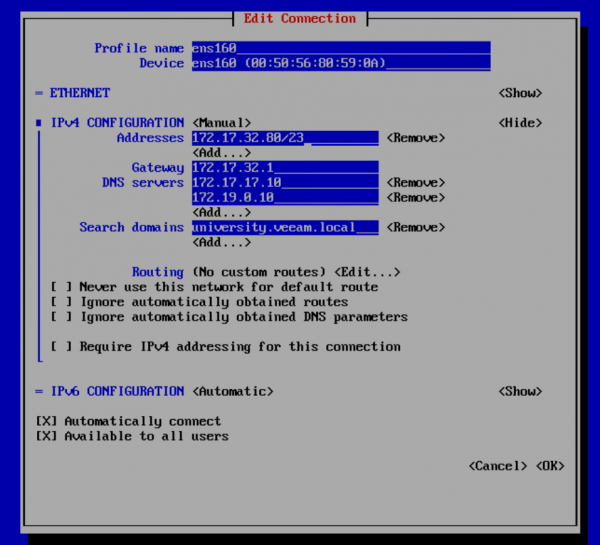
E já que somente os audazes conquistam mares, fazemos yum update, após o que reboot. Na verdade, isso é bastante seguro, pois toda a implementação é feita através de playbooks, e todos os pacotes importantes do Docker estão bloqueados na versão atual.
Agora é hora de editar o script de instalação. Nada de janelinhas bonitas ou pseudo UI — tudo pelo seu editor de texto favorito. Tecnicamente, há duas maneiras: você pode executar cada comando manualmente ou iniciar o configurador videploy de uma vez. Ele simplesmente abrirá a configuração no vim e, ao sair, iniciará a verificação. Mas simplificar minha vida não é interessante, então faremos duas vezes mais comandos. Embora isso não faça sentido, eu avisei =)
Então, abrimos vim ECS-CommunityEdition/deploy.xml e fazemos as alterações minimamente otimizadas para que o ECS seja ativado e funcione. A lista de parâmetros pode ser reduzida, mas eu fiz assim:
- licensed_accepted: true Você pode deixar como está, então durante o deploy será solicitado que você aceite explicitamente e exibirá uma frase simpática. Talvez seja até uma ‘surpresa’.

- Descomentar as linhas autonames: e custom: Insira pelo menos um nome desejado para o nó — o hostname será substituído por ele durante a instalação.
- install_node: 192.168.1.1 Indicar o IP real do nó. Neste caso, usamos o mesmo que está em nmtui
- dns_domain: insira seu domínio.
- dns_servers: insira seu dns.
- ntp_servers: pode-se indicar qualquer um. Eu peguei o primeiro que encontrei do pool 0.pool.ntp.org (que se tornou 91.216.168.42)
- autonaming: custom Se não descomentar, a lua será chamada de Luna.
- ecs_block_devices:
/dev/sdb
Por razões desconhecidas, pode haver um dispositivo de armazenamento em bloco inexistente /dev/vda - storage_pools:
members:
192.168.1.1 Novamente, indicamos o IP real do nó. - ecs_block_devices:
/dev/sdb Повторяем операцию вырезания несуществующих устройств.

No geral, todo o arquivo é muito bem descrito em , mas quem vai lê-la em tempos tão conturbados? Está escrito que o mínimo necessário é indicar o IP e a máscara, mas na minha lab, esse conjunto não foi muito bem, e tive que ampliar para o que foi mencionado acima.
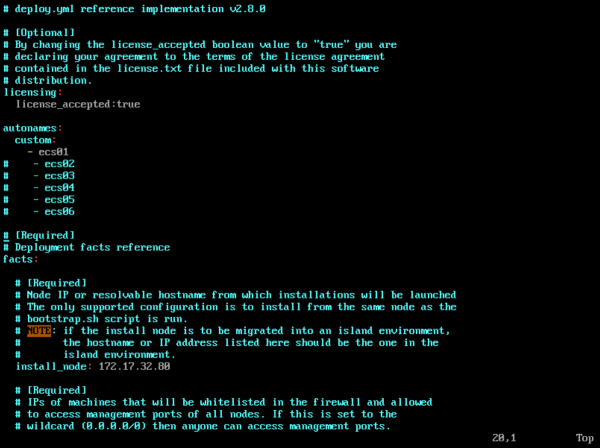
Após sair do editor, você deve executar update_deploy /home/admin/ECS-CommunityEdition/deploy.yml, e se tudo estiver feito corretamente, isso será comunicado de forma clara.
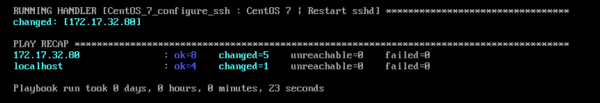
Depois, ainda será necessário rodar o videploy, aguardar a atualização do ambiente e você pode iniciar a instalação com o comando ova-step1, e após a execução bem-sucedida, o comando ova-step2. Importante: não pare a execução dos scripts manualmente! Algumas etapas podem levar um tempo significativo, não serem realizadas na primeira tentativa e parecer que tudo está quebrado. De qualquer forma, você deve aguardar a conclusão do script naturalmente. No final, você deve ver uma mensagem parecida com esta.
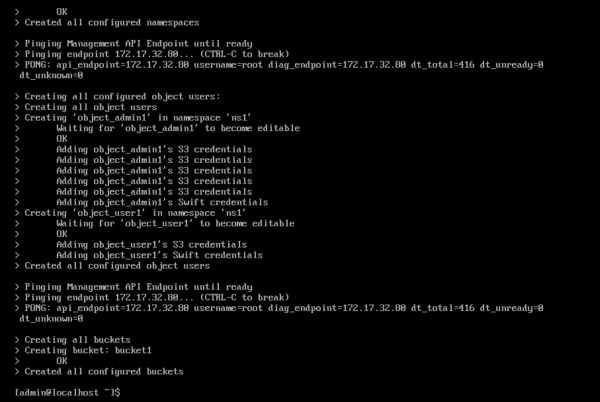
Agora, finalmente, podemos abrir o painel de controle do WebUI pelo IP que já conhecemos. Se durante a configuração não alteramos nada, a conta padrão será root/ChangeMe. Podemos até começar a usar nosso armazenamento compatível com S3 imediatamente. Ele está disponível nas portas 9020 para HTTP e 9021 para HTTPS. Novamente, se nada foi alterado, access_key: object_admin1 e secret_key: ChangeMeChangeMeChangeMeChangeMeChangeMe.
Mas vamos devagar e começar pela ordem.
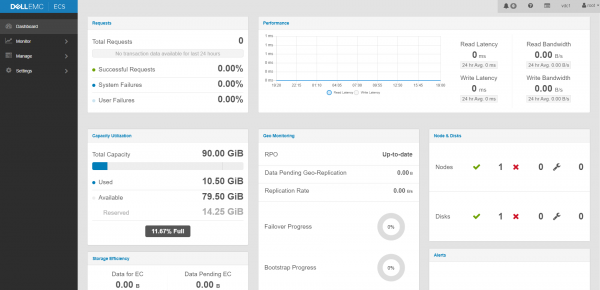
Na primeira login, você será obrigatoriamente solicitado a alterar sua senha para uma mais adequada, o que é absolutamente correto. O painel principal é extremamente compreensível, portanto, vamos fazer algo mais interessante do que explicar métricas óbvias. Por exemplo, vamos criar um usuário que usaremos para acessar o armazenamento. No mundo dos provedores de serviço, isso é chamado de tenant. Isso é feito em Manage > Users > New Object User.
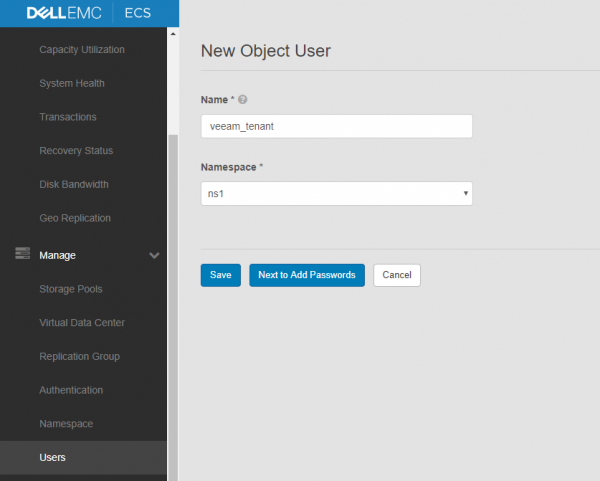
Ao criar o usuário, somos solicitados a indicar o namespace. Tecnicamente, nada impede que criemos quantos quisermos, desde que tenhamos usuários. E vice-versa. Isso permite gerenciar os recursos de forma independente para cada tenant.
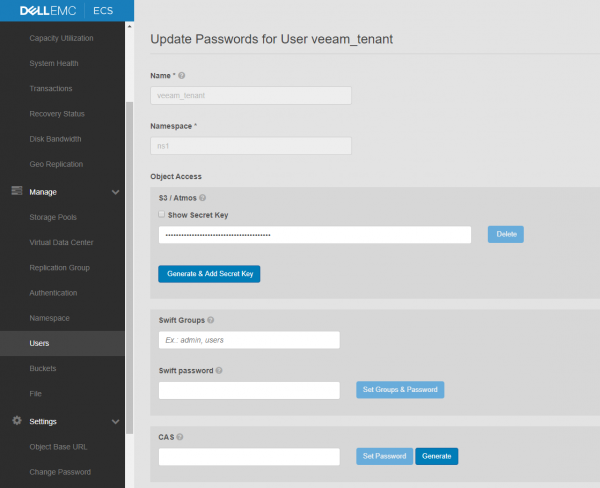
Portanto, escolhemos as funções necessárias e geramos as chaves de usuário. Para mim, S3/Atmos é suficiente. E não se esqueça de salvar a chave 😉.
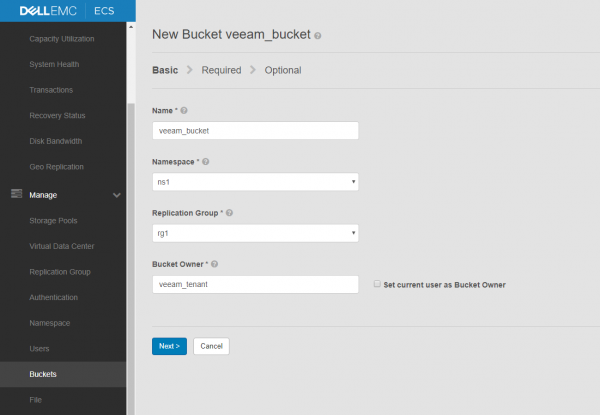
O usuário foi criado, agora é hora de dedicar um bucket a ele. Vamos para Manage > Bucket e preencher os campos necessários. Aqui tudo é simples.
Agora estamos prontos para o uso prático do nosso armazenamento S3.
Configurando o Veeam
Como lembramos, uma das principais utilizações de armazenamento de objetos é a armazenamento de longo prazo de informações que são acessadas raramente. Um exemplo ideal é a necessidade de armazenar backups em um local remoto. No Veeam Backup & Replication, essa função é chamada de Capacity Tier.
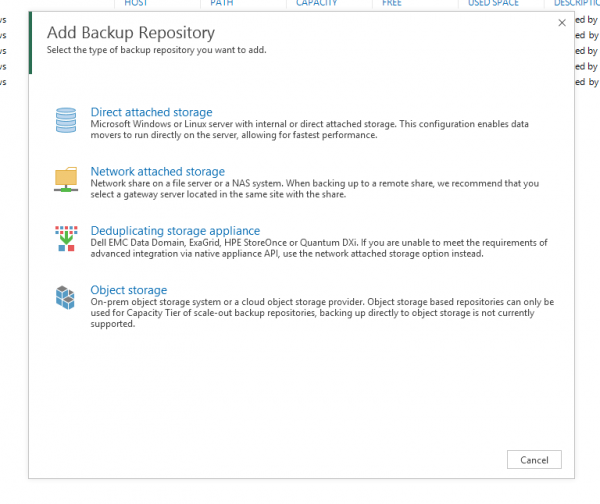
Vamos começar a configuração adicionando nosso Dell ECS CE à interface do Veeam. Na aba Backup Infrastructure, iniciamos o assistente para adicionar um novo repositório e escolhemos a opção Object Storage.
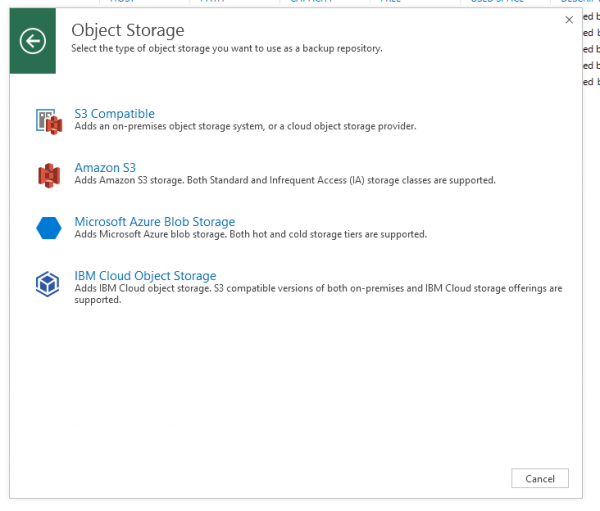
Selecionamos o que realmente importa — S3 Compatible.
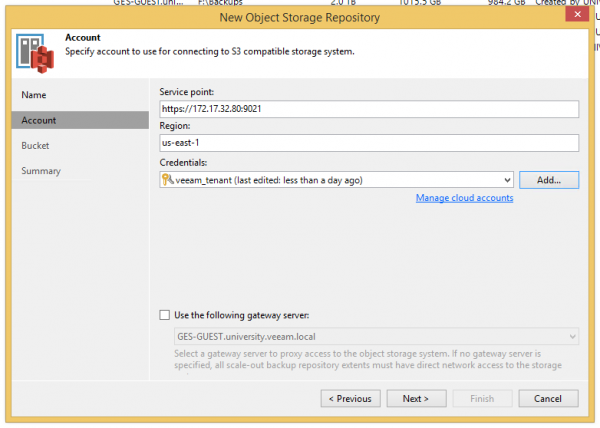
Na janela que aparece, digitamos o nome desejado e seguimos para a etapa Account. Aqui devemos indicar o Service point no formato , a região pode ser mantida como está, e adicionamos o usuário criado. O gateway é necessário caso seu armazenamento esteja em um local remoto, mas isso já é um assunto de otimização de infraestrutura e um artigo separado, então pode ser ignorado por enquanto.
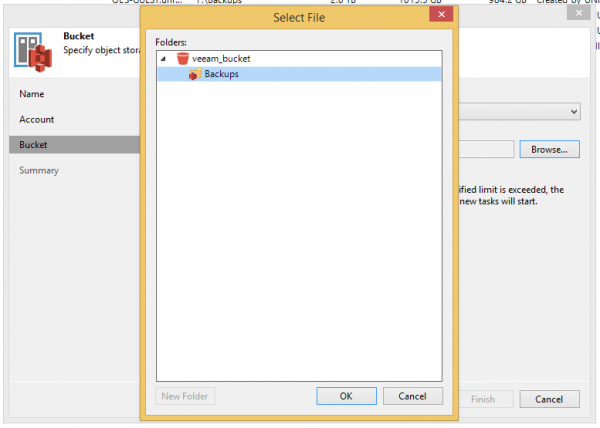
Se tudo foi especificado e configurado corretamente, aparecerá um aviso sobre o certificado e, em seguida, uma janela com o bucket, onde podemos criar uma pasta para nossos arquivos.
Vamos prosseguir com o assistente até o final e desfrutar do resultado.
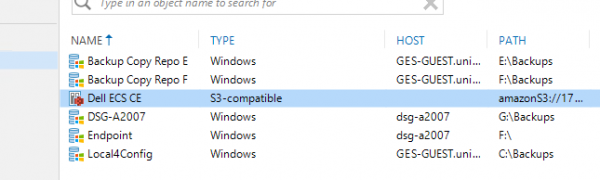
Na próxima etapa, precisamos ou criar um novo Scale-out Backup Repository ou adicionar nosso S3 a um existente — ele será usado como Capacity Tier para armazenamento em arquivo. Nesta versão atual, não há função para usar armazenamentos compatíveis com S3 diretamente como um repositório comum. Existem muitos problemas que precisam ser resolvidos, mas tudo pode acontecer.
Acessamos as configurações do repositório e ativamos o Capacity Tier. A documentação é clara, mas há um detalhe interessante: se você deseja que todos os dados sejam enviados para o armazenamento de objetos o mais rápido possível, basta definir 0 dias.
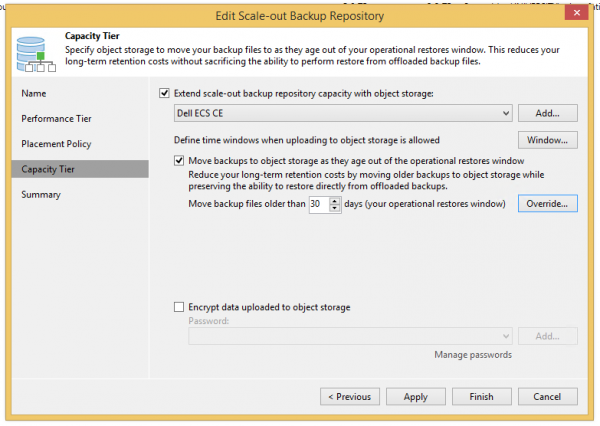
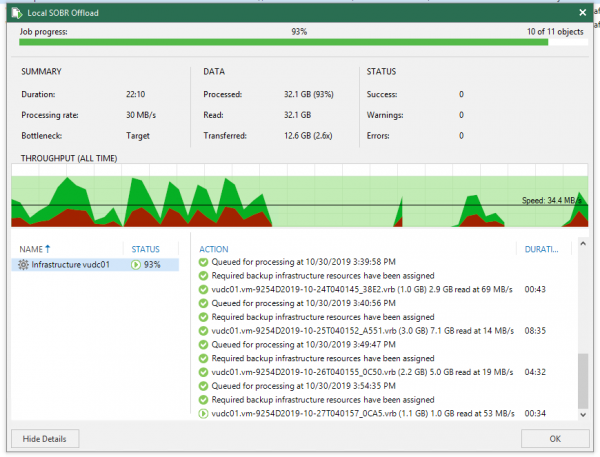
Após passar pelo assistente, se você não quiser esperar, pode pressionar ctrl+clique direito no repositório, forçar a execução do Tiering job e observar os gráficos se movimentarem.
Por enquanto é isso. Acredito que cumpri a tarefa de mostrar que os armazenamentos em bloco não são tão assustadores quanto se pensa. Sim, existem soluções e opções infinitas, mas não dá para cobrir tudo em um único artigo. Portanto, vamos compartilhar experiências nos comentários.
Fonte: habr.com
