

Olá, Habr! Na Dodo Pizza Engineering, amamos dados (quem não ama hoje em dia?). Agora, vou contar como coletar todos os dados do universo Dodo Pizza e fornecer a qualquer funcionário da empresa acesso conveniente a esse vasto conjunto de dados. O desafio é: manter a calma da equipe de Data Engineering.
Como verdadeiros acumuladores, coletamos todas as informações sobre o funcionamento das nossas pizzarias:
- lembramos todos os pedidos dos usuários;
- sabemos quanto tempo levou para fazer a primeira pizza em Syktyvkar;
- vemos quanto tempo a pizza está esfriando na prateleira térmica em Voronezh agora mesmo;
- armazenamos dados sobre a baixa de produtos;
- e muito, muito mais.
Hoje, várias equipes estão encarregadas de trabalhar com dados na Dodo Pizza, sendo uma delas a equipe de Data Engineering. Agora, temos a tarefa de fornecer a qualquer funcionário da empresa acesso conveniente a esse conjunto de dados.
Quando começamos a pensar em como fazer isso e a discutir a tarefa, encontramos uma abordagem muito interessante para a gestão de dados – (no link você encontrará um artigo incrível). As ideias dele se encaixaram muito bem na nossa visão sobre como queremos construir nosso sistema. A seguir, nesta artigo, apresentaremos nossa reinterpretação da abordagem e como vemos sua implementação na Dodo Pizza Engineering.
O que queremos dizer com "dados"
Primeiro, vamos esclarecer o que entendemos por dados na Dodo Pizza Engineering:
- Eventos que os serviços enviam (temos um barramento comum construído com RabbitMQ);
- Registros dentro do banco de dados (para nós é MySQL e CosmosDB);
- Clickstream do aplicativo móvel e do site.
Para que os negócios da Dodo Pizza possam utilizar esses dados e confiar neles, é importante que as seguintes condições sejam atendidas:
- Eles devem ser íntegros. Devemos ter certeza de que não alteramos os dados durante seu processamento, armazenamento e exibição. Se o negócio não puder confiar em nossos dados, não haverá utilidade neles.
- Eles devem ter um carimbo de data/hora e não devem ser sobrescritos. Isso significa que, a qualquer momento, queremos ter a capacidade de retroceder e olhar os dados daquele período. Por exemplo, descobrir quantas pizzas foram vendidas em 8 de julho de 2018.
- Eles devem ser confiáveis. Durante a coleta e armazenamento de dados, devemos não apenas manter a integridade, mas também a confiabilidade. Não podemos perder dados, intervalos de tempo, porque com eles perdemos a confiança de nossos clientes (tanto externos quanto internos).
- Eles devem ter um esquema estável – escrevemos consultas para esses dados. Não gostaríamos que, com a mudança do código do aplicativo e a refatoração, eles mudassem tanto que nossas consultas parassem de funcionar. Aqueles que escrevem consultas nunca saberão que você fez refatoração até que tudo quebre completamente. Não gostaria de descobrir isso através dos clientes.
Considerando todos esses requisitos, chegamos à conclusão de que os dados no Dodo são um produto. Assim como a API pública do serviço. Portanto, a equipe que possua os dados deve ser a mesma que possui o serviço. Além disso, as alterações no esquema de dados devem ser sempre compatíveis com versões anteriores.
Abordagem tradicional – Data Lake
Para resolver problemas de armazenamento e processamento confiáveis de grandes dados, existe uma abordagem tradicional adotada por muitas empresas que trabalham com esse volume de informações – Data Lake. Dentro dessa abordagem, os engenheiros de dados coletam informações de todos os componentes do sistema e as armazenam em um grande repositório (pode ser, por exemplo, Hadoop, Azure Kusto, Apache Cassandra ou até mesmo uma réplica do MySQL, se os dados couberem).
Em seguida, esses mesmos engenheiros escrevem consultas para esse repositório. A implementação dessa abordagem na engenharia do Dodo Pizza implica que a equipe de Data Engineering possua o esquema de dados no repositório analítico.
Nesse cenário, a equipe se torna muito triste e aqui está o porquê:
- Ela deve acompanhar as mudanças em TODOS os serviços dentro da empresa. E há muitos serviços e muitas mudanças (em média, mesclamos ~100 pull requests por semana, sendo que muitos serviços não fazem pull requests de forma alguma).
- Quando ocorre uma alteração no esquema de dados, o product owner e a equipe que altera o esquema de dados devem esperar até que a Data Engineering escreva o código necessário para que as mudanças sejam suportadas. E já faz tempo que estamos em uma situação em que uma equipe espera pela outra – algo muito raro. E não queremos que isso se torne uma parte «normal» do processo de desenvolvimento.
- Ela deve estar imersa em TODAS negócio da empresa. A rede de pizzarias pode parecer um negócio simples, mas isso é apenas uma impressão. É muito difícil reunir em uma única equipe as competências necessárias para construir um modelo de dados adequado para toda a empresa.
- Ela é o único ponto de falha. Sempre que é necessário modificar os dados que o serviço retorna ou redigir uma consulta, todas essas tarefas recaem sobre a equipe de Engenharia de Dados. Como resultado, a equipe fica com um backlog sobrecarregado.
Assim, a equipe se encontra em uma interseção de muitas necessidades e dificilmente conseguirá atendê-las. Ao mesmo tempo, estará constantemente sob pressão e estresse. Nós realmente não queremos isso. Portanto, precisamos pensar em como resolver esses problemas e ainda ter a capacidade de analisar os dados.
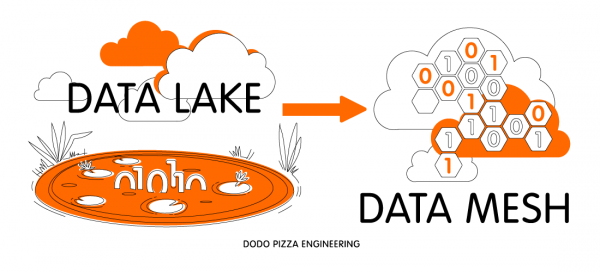
Transitando do Data Lake para o Data Mesh
Felizmente, essa questão não foi pensada apenas por nós. Na verdade, esse problema já foi resolvido na indústria (aleluia!). Porém, em outra área: a implantação de aplicativos. Sim, estou me referindo à abordagem DevOps, na qual a equipe define como deve ser implantado o produto que está criando.
Uma abordagem semelhante para resolver os problemas do Data Lake foi proposta por Zhamak Dehghani, consultora da ThoughtWorks. Observando como tarefas semelhantes são resolvidas pela Netflix e Spotify, ela escreveu um artigo fantástico (o link para ele estava no início do artigo). As principais ideias que extraímos dele foram:
- Dividir um grande Data Lake em domínios de dados, que se assemelham aos domínios do design orientado a domínio (domain-driven design). Cada domínio é um pequeno bounded context.
- As Feature Teams, que são responsáveis pelos domínios DDD, também são responsáveis pelos domínios de dados correspondentes. Elas mantêm o esquema, fazem alterações, carregam os dados nele. E, ao mesmo tempo, sabem como modificar a carga de dados sem quebrar nada quando o aplicativo muda. O conhecimento não se perde. Para acessar os dados, elas não precisam ir a lugar algum. A própria equipe gerencia todo o ciclo de desenvolvimento, desde a alteração dos dados operacionais até a disponibilização de dados analíticos para terceiros. Uma equipe possui toda a responsabilidade relacionada ao domínio (tanto no domínio de negócios quanto no domínio de dados).
- Engenheiro de Dados – um papel dentro da Feature Team. Isso não precisa necessariamente ser uma pessoa separada, mas é essencial que a equipe possua essa competência.
Enquanto isso, a equipe de Engenharia de Dados...
Se imaginarmos que tudo isso se realiza com um estalar de dedos, restam duas perguntas a responder:
O que a equipe de Data Engineering fará agora? Na Dodo Pizza Engineering, já existe uma equipe de plataforma/SRE. Sua tarefa é fornecer aos desenvolvedores ferramentas para a fácil implantação de serviços. A equipe de Data Engineering desempenhará um papel semelhante, mas para os dados.
Transformar dados operacionais em dados analíticos é um processo complicado. Tornar os dados analíticos acessíveis para toda a empresa é ainda mais difícil. A equipe de Data Engineering se dedicará a resolver esses problemas.
Estamos planejando fornecer à Feature Team um conjunto conveniente de ferramentas e práticas, com as quais poderão publicar dados de seus serviços para o restante da empresa. Também seremos responsáveis por partes da infraestrutura do data pipeline (filas, armazenamento confiável, clusters para execução de transformações nos dados).
Como as habilidades de Data Engineer aparecerão dentro da Feature Team? Com a Feature Team, a situação é mais complicada. Claro, poderíamos tentar contratar um Data Engineer para cada uma de nossas equipes. Mas isso é muito difícil. Encontrar alguém com um bom histórico em processamento de dados e convencê-lo a trabalhar dentro das equipes de produto é desafiador.
Um grande ponto positivo da Dodo é que gostamos de treinamento interno. Então, agora nosso plano é o seguinte: a equipe de Data Engineering começa a publicar dados de alguns serviços, chora, se machuca, mas continua a comer o cacto. Assim que entendermos que temos um processo pronto para publicação, começamos a compartilhá-lo com a Feature Team.
Temos algumas maneiras de fazer isso:
- , onde iremos mostrar como é o processo que criamos, quais ferramentas existem e como usá-las da maneira mais eficaz.
- Uma apresentação no DevForum nos ajudará a coletar feedback dos desenvolvedores de produto. Depois disso, poderemos nos juntar às equipes de produto e ajudá-las a resolver questões relacionadas à publicação de dados, organizando treinamentos para as equipes.
Consumo de dados
Agora falei muito sobre publicação de dados. Mas também há o consumo. O que temos a dizer sobre isso?
Temos uma equipe incrível de BI que cria relatórios muito complexos para a empresa de gestão. Dentro do Dodo IS, existem muitos relatórios para nossos parceiros que os ajudam a administrar as pizzarias. Em nosso novo modelo, nós os vemos como consumidores de dados que possuem seus próprios domínios de dados. E são esses consumidores que serão responsáveis por seus próprios domínios. Às vezes, o domínio do consumidor pode ser descrito por uma única consulta no armazenamento analítico - e isso é bom. Mas entendemos que nem sempre isso funcionará. É por isso que queremos que a plataforma que criaremos para as equipes de produtos também possa ser usada pelos consumidores de dados (pois no caso dos relatórios dentro do Dodo IS - será a mesma equipe).
Assim vemos o trabalho com dados na Dodo Pizza Engineering. Ficaríamos felizes em ler suas opiniões sobre isso nos comentários.
Fonte: habr.com
