

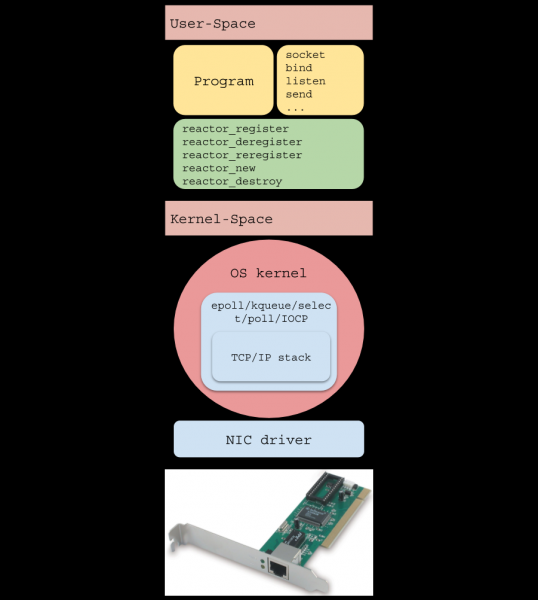
Introdução
(monotarefa ) — é um padrão para escrever software de alta carga, utilizado em muitas soluções populares:
- …
Neste artigo, vamos explorar o funcionamento do reator I/O e seu princípio de operação, escrever uma implementação em menos de 200 linhas de código e fazer um servidor HTTP simples processar mais de 40 milhões de solicitações por minuto.
Prefácio
- O artigo foi escrito com o objetivo de ajudar a entender o funcionamento do reator I/O e, assim, perceber os riscos associados ao seu uso.
- Para compreender o artigo, é necessário ter conhecimento básico e alguma experiência em desenvolvimento de aplicativos de rede.
- Todo o código foi escrito na linguagem C estritamente de acordo com (cuidado: PDF longo) para Linux e está disponível em .
Por que isso é necessário?
Com o aumento da popularidade da Internet, os servidores web precisaram processar um grande número de conexões simultaneamente, levando à experimentação de duas abordagens: I/O bloqueante em um grande número de threads do sistema operacional e I/O não bloqueante em combinação com um sistema de notificação de eventos, também conhecido como 'seletor de sistema' (///etc).
A primeira abordagem envolvia a criação de um novo thread do sistema operacional para cada conexão entrante. Sua desvantagem é a má escalabilidade: o sistema operacional terá que realizar múltiplas e . Essas operações são caras e podem levar à falta de RAM livre com um grande número de conexões.
Uma versão modificada destaca (pool de threads), evitando que o sistema interrompa a execução de forma abrupta, mas, ao mesmo tempo, introduz um novo problema: se, neste momento, o pool de threads estiver bloqueado em operações de leitura duradouras, outros sockets que já estão prontos para receber dados não conseguirão fazê-lo.
A segunda abordagem utiliza (seletor de sistema), que é fornecido pelo sistema operacional. Neste artigo, é abordado o tipo de seletor de sistema mais comumente encontrado, baseado em notificações (eventos, avisos) de prontidão para operações de I/O, em vez de . Um exemplo simplificado de seu uso pode ser apresentado no seguinte fluxograma:
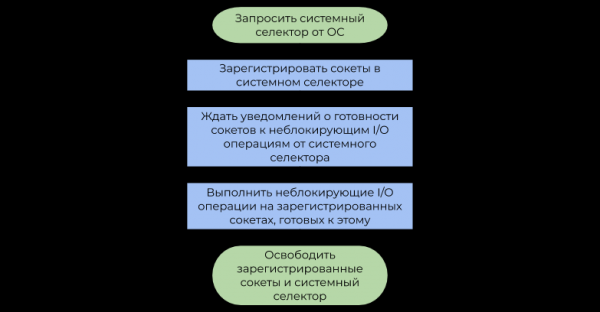
A diferença entre essas abordagens é a seguinte:
- As operações de I/O bloqueantes suspende a thread do usuário até então, enquanto o sistema operacional não os pacotes em um fluxo de bytes (, recebimento de dados) ou até que haja espaço suficiente nos buffers internos para o envio subsequente através de (envio de dados).
- O seletor de sistema após um tempo notifica o programa que o sistema operacional já desfragmentou os pacotes IP (TCP, recebimento de dados) ou que espaço suficiente nos buffers internos está já disponível (envio de dados).
Em resumo, reservar um fluxo do sistema operacional para cada I/O é um desperdício de poder computacional, pois na verdade, os fluxos não estão envolvidos em trabalho útil (daí vem o termo ). O seletor de sistema resolve esse problema, permitindo que o programa do usuário utilize os recursos da CPU de maneira muito mais econômica.
O modelo de reator de I/O
O reator de I/O atua como uma camada entre o seletor de sistema e o código do usuário. O princípio de seu funcionamento é descrito no seguinte fluxograma:
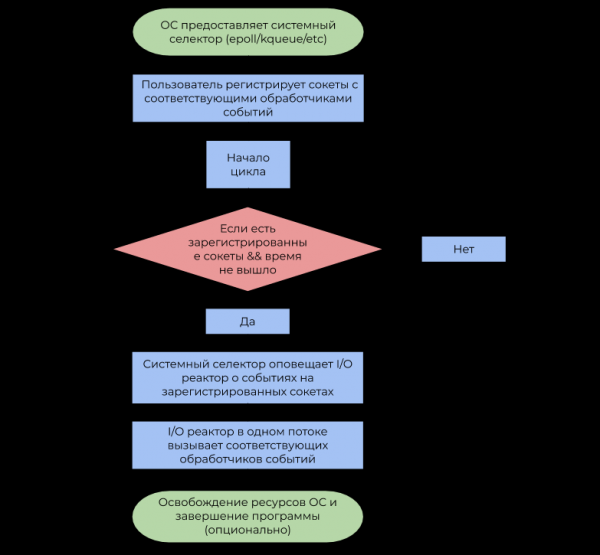
- Lembre-se de que um evento é uma notificação de que um determinado soquete está pronto para realizar uma operação de I/O não bloqueante.
- Um manipulador de eventos é uma função chamada pelo reator de I/O ao receber um evento, que então realiza a operação de I/O não bloqueante.
É importante notar que o reator de I/O é, por definição, de thread única, mas nada impede o uso do conceito em um ambiente multithreaded na relação 1 thread: 1 reator, assim aproveitando todos os núcleos da CPU.
Implementação
Vamos colocar a interface pública no arquivo , e a implementação em . reactor.h consistirá nas seguintes declarações:
Mostrar declarações em reactor.h
typedef struct reactor Reactor;

/*
 * Ponteiro para a função que será chamada pelo reator I/O quando um
 * evento ocorre no seletor do sistema.
 */
typedef void (*Callback)(void *arg, int fd, uint32_t events);

/*
 * Retorna `NULL` em caso de erro, ponteiro não-`NULL` para `Reactor`
 * caso contrário.
 */
Reactor *reactor_new(void);

/*
 * Libera o seletor do sistema, todos os sockets registrados no momento
 * e o próprio reator I/O.
 *
 * As funções a seguir retornam -1 em caso de erro, 0 em caso de sucesso.
 */
int reactor_destroy(Reactor *reactor);

int reactor_register(const Reactor *reactor, int fd, uint32_t interest,
                     Callback callback, void *callback_arg);
int reactor_deregister(const Reactor *reactor, int fd);
int reactor_reregister(const Reactor *reactor, int fd, uint32_t interest,
                       Callback callback, void *callback_arg);

/*
 * Inicia um loop de eventos com um timeout de `timeout`.
 *
 * Esta função devolverá o controle ao código chamador se o tempo
 * alocado expirar ou\/e na ausência de sockets registrados.
 */
int reactor_run(const Reactor *reactor, time_t timeout);
A estrutura do reator I/O consiste em seletor e , que mapeia cada socket com CallbackData (estrutura do manipulador de eventos e argumento do usuário para ele).
Mostrar Reactor e CallbackData
struct reactor {
    int epoll_fd;
    GHashTable *table; // (int, CallbackData)
};

typedef struct {
    Callback callback;
    void *arg;
} CallbackData;
Observe que utilizamos a possibilidade de lidar com por meio de um ponteiro. Em reactor.h declaramos a estrutura reactor, e no reactor.c definimos-a, impedindo assim que o usuário altere explicitamente seus campos. Este é um dos padrões , encaixando-se de forma concisa na semântica do C.
Funções reactor_register, reactor_deregister e reactor_reregister atualizam a lista de sockets de interesse e os manipuladores de eventos correspondentes no seletor do sistema e na tabela hash.
Mostrar funções de registro
#define REACTOR_CTL(reactor, op, fd, interest)
    if (epoll_ctl(reactor->epoll_fd, op, fd,
                  &(struct epoll_event){.events = interest,
                                        .data = {.fd = fd}}) == -1) {
        perror("epoll_ctl");
        return -1;
    }

int reactor_register(const Reactor *reactor, int fd, uint32_t interest,
                     Callback callback, void *callback_arg) {
    REACTOR_CTL(reactor, EPOLL_CTL_ADD, fd, interest)
    g_hash_table_insert(reactor->table, int_in_heap(fd),
                        callback_data_new(callback, callback_arg));
    return 0;
}

int reactor_deregister(const Reactor *reactor, int fd) {
    REACTOR_CTL(reactor, EPOLL_CTL_DEL, fd, 0)
    g_hash_table_remove(reactor->table, &fd);
    return 0;
}

int reactor_reregister(const Reactor *reactor, int fd, uint32_t interest,
                       Callback callback, void *callback_arg) {
    REACTOR_CTL(reactor, EPOLL_CTL_MOD, fd, interest)
    g_hash_table_insert(reactor->table, int_in_heap(fd),
                        callback_data_new(callback, callback_arg));
    return 0;
}
Depois que o reator I/O captura um evento no descritor fd, ele chama o respectivo manipulador de eventos, passando a ele fd, de eventos gerados e um ponteiro do usuário para void.
Mostrar função reactor_run()
int reactor_run(const Reactor *reactor, time_t timeout) {
    int result;
    struct epoll_event *events;
    if ((events = calloc(MAX_EVENTS, sizeof(*events))) == NULL)
        abort();

    time_t start = time(NULL);

    while (true) {
        time_t passed = time(NULL) - start;
        int nfds =
            epoll_wait(reactor->epoll_fd, events, MAX_EVENTS, timeout - passed);

        switch (nfds) {
        // Erro
        case -1:
            perror("epoll_wait");
            result = -1;
            goto cleanup;
        // Tempo esgotado
        case 0:
            result = 0;
            goto cleanup;
        // Operação bem-sucedida
        default:
            // Chamar manipuladores de eventos
            for (int i = 0; i table, &fd);
                callback->callback(callback->arg, fd, events[i].events);
            }
        }
    }

cleanup:
    free(events);
    return result;
}
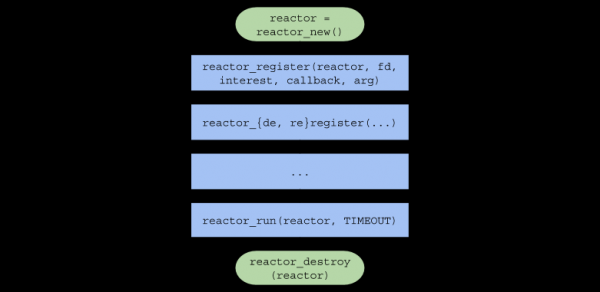
Resumindo, a cadeia de chamadas de funções no código do usuário será a seguinte:
Servidor de thread única
Para testar o reator I/O sob alta carga, escreveremos um simples servidor web HTTP que responda a qualquer solicitação com uma imagem.
Breve introdução ao protocolo HTTP
— é um protocolo , amplamente utilizado para a interação entre servidor e navegador.
O HTTP pode ser facilmente utilizado encima de do protocolo , enviando e recebendo mensagens no formato definido pela .
Formato da solicitação
CRLF
CRLF
CRLF
CRLF CRLF CRLF— é uma sequência de dois caracteres:ren, separando a primeira linha da solicitação, os cabeçalhos e os dados.<КОМАНДА>— um dosCONNECT,DELETE,GET,HEAD,OPTIONS,PATCH,POST,PUT,TRACE. O navegador enviará ao nosso servidor o comandoGET, que significa 'Envie-me o conteúdo do arquivo'.<URI>— . Por exemplo, se o URI =/index.html, o cliente solicita a página inicial do site.<ВЕРСИЯ HTTP>— versão do protocolo HTTP no formatoHTTP/X.Y. A versão mais utilizada hoje éHTTP/1.1.:, enviado ao servidor para análise posterior.<ДАННЫЕ>— dados necessários ao servidor para realizar a operação. Muitas vezes isso é apenas ou qualquer outro formato.
Formato da resposta
CRLF
CRLF
CRLF
CRLF CRLF
<КОД СТАТУСА>— este é um número que representa o resultado de uma operação. Nosso servidor sempre retornará o status 200 (operação bem-sucedida).<ОПИСАНИЕ СТАТУСА>— representação em string do código de status. Para o código de status 200 — éOK.Content-Length(tamanho do arquivo) eContent-Type: text/html(tipo de dados retornados).<ДАННЫЕ>— dados solicitados pelo usuário. Neste caso, é o caminho para a imagem em .
Arquivo (servidor de thread única) inclui o arquivo , que contém os seguintes protótipos de funções:
Mostrar protótipos de funções em common.h
/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов принять новое соединение.
 */
static void on_accept(void *arg, int fd, uint32_t events);

/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов отправить HTTP ответ.
 */
static void on_send(void *arg, int fd, uint32_t events);

/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов принять часть HTTP запроса.
 */
static void on_recv(void *arg, int fd, uint32_t events);

/*
 * Переводит входящее соединение в неблокирующий режим.
 */
static void set_nonblocking(int fd);

/*
 * Печатает переданные аргументы в stderr и выходит из процесса с
 * кодом `EXIT_FAILURE`.
 */
static noreturn void fail(const char *format, ...);

/*
 * Возвращает файловый дескриптор сокета, способного принимать новые
 * TCP соединения.
 */
static int new_server(bool reuse_port);
Também é descrito o macro funcional SAFE_CALL() e definida a função fail(). O macro compara o valor da expressão com um erro, e se a condição for atendida, chama a função fail():
#define SAFE_CALL(call, error)
    do {
        if ((call) == error) {
            fail("%s", #call);
        }
    } while (false)
Função fail() imprime os argumentos passados no terminal (como ) e encerra o programa com o código EXIT_FAILURE:
static noreturn void fail(const char *format, ...) {
    va_list args;
    va_start(args, format);
    vfprintf(stderr, format, args);
    va_end(args);
    fprintf(stderr, ": %sn", strerror(errno));
    exit(EXIT_FAILURE);
}
Função new_server() retorna um descritor de arquivo do socket 'servidor' criado por chamadas de sistema , e e capaz de aceitar conexões de entrada no modo não bloqueante.
Mostrar função new_server()
static int new_server(bool reuse_port) {
    int fd;
    SAFE_CALL((fd = socket(AF_INET, SOCK_STREAM | SOCK_NONBLOCK, IPPROTO_TCP)),
              -1);

    if (reuse_port) {
        SAFE_CALL(
            setsockopt(fd, SOL_SOCKET, SO_REUSEPORT, &(int){1}, sizeof(int)),
            -1);
    }

    struct sockaddr_in addr = {.sin_family = AF_INET,
                               .sin_port = htons(SERVER_PORT),
                               .sin_addr = {.s_addr = inet_addr(SERVER_IPV4)},
                               .sin_zero = {0}};

    SAFE_CALL(bind(fd, (struct sockaddr *)&addr, sizeof(addr)), -1);
    SAFE_CALL(listen(fd, SERVER_BACKLOG), -1);
    return fd;
}- Observe que o socket é inicialmente criado no modo não bloqueante com a flag
SOCK_NONBLOCK, então a funçãoon_accept()(continuar lendo) a chamada de sistemaaccept()não interrompe a execução da thread. - Se
reuse_porté igual averdadeiro, então esta função configurará o socket com a opção por meio de , para usar a mesma porta em um ambiente multithread (ver seção 'Servidor Multithread').
O manipulador de eventos on_accept() é chamado após o sistema operacional gerar um evento EPOLLIN, neste caso significando que uma nova conexão pode ser aceita. on_accept() aceita uma nova conexão, muda para modo não bloqueante e registra com o manipulador de eventos on_recv() no reator I/O.
Mostrar função on_accept()
static void on_accept(void *arg, int fd, uint32_t events) {
    int incoming_conn;
    SAFE_CALL((incoming_conn = accept(fd, NULL, NULL)), -1);
    set_nonblocking(incoming_conn);
    SAFE_CALL(reactor_register(reactor, incoming_conn, EPOLLIN, on_recv,
                               request_buffer_new()),
              -1);
}
O manipulador de eventos on_recv() é chamado após o sistema operacional gerar um evento EPOLLIN, significando, neste caso, que a conexão registrada on_accept(), está pronta para receber dados.
on_recv() lê os dados da conexão até que a solicitação HTTP esteja completamente recebida, então registra o manipulador on_send() para enviar a resposta HTTP. Se o cliente fechar a conexão, o socket é desregistrado e fechado através de .
Mostrar função on_recv()
static void on_recv(void *arg, int fd, uint32_t events) {
    RequestBuffer *buffer = arg;

    // Aceita os dados de entrada até que recv retorne 0 ou um erro
    ssize_t nread;
    while ((nread = recv(fd, buffer->data + buffer->size,
                         REQUEST_BUFFER_CAPACITY - buffer->size, 0)) > 0)
        buffer->size += nread;

    // O cliente fechou a conexão
    if (nread == 0) {
        SAFE_CALL(reactor_deregister(reactor, fd), -1);
        SAFE_CALL(close(fd), -1);
        request_buffer_destroy(buffer);
        return;
    }

    // read retornou um erro diferente do erro que bloqueia a chamada
    // da thread
    if (errno != EAGAIN && errno != EWOULDBLOCK) {
        request_buffer_destroy(buffer);
        fail("read");
    }

    // Um pedido HTTP completo foi recebido do cliente. Agora registramos o manipulador
    // de eventos para enviar os dados
    if (request_buffer_is_complete(buffer)) {
        request_buffer_clear(buffer);
        SAFE_CALL(reactor_reregister(reactor, fd, EPOLLOUT, on_send, buffer),
                  -1);
    }
}
O manipulador de eventos on_send() é chamado após o sistema operacional gerar um evento EPOLLOUT, significando que a conexão registrada on_recv(), está pronta para enviar dados. Esta função envia a resposta HTTP, contendo HTML com uma imagem, para o cliente, e então muda o manipulador de eventos novamente para on_recv().
Mostrar função on_send()
static void on_send(void *arg, int fd, uint32_t events) {
    const char *content = "<img "
 "src="https://habrastorage.org/webt/oh/wl/23/"
                          "ohwl23va3b-dioerobq_mbx4xaw.jpeg">";
    char response[1024];
    sprintf(response,
            "HTTP/1.1 200 OK" CRLF "Content-Length: %zd" CRLF "Content-Type: "
            "text/html" DOUBLE_CRLF "%s",
            strlen(content), content);

    SAFE_CALL(send(fd, response, strlen(response), 0), -1);
    SAFE_CALL(reactor_reregister(reactor, fd, EPOLLIN, on_recv, arg), -1);
}
E finalmente, no arquivo http_server.c, na função main() nós criamos um reator de I/O através de reactor_new(), criamos um socket de servidor e o registramos, executamos o reator usando reactor_run() exatamente por um minuto, e então liberamos os recursos e saímos do programa.
Mostrar http_server.c
#include "reactor.h"

static Reactor *reactor;

#include "common.h"

int main(void) {
    SAFE_CALL((reactor = reactor_new()), NULL);
    SAFE_CALL(
        reactor_register(reactor, new_server(false), EPOLLIN, on_accept, NULL),
        -1);
    SAFE_CALL(reactor_run(reactor, SERVER_TIMEOUT_MILLIS), -1);
    SAFE_CALL(reactor_destroy(reactor), -1);
}
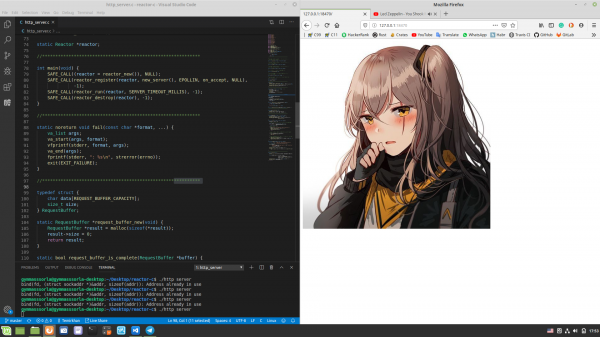
Vamos verificar se tudo está funcionando conforme esperado. Compilamos (chmod a+x compile.sh && ./compile.sh na raiz do projeto) e iniciamos o servidor personalizado, abrimos no navegador e observamos o que esperávamos:
Medição de desempenho
Mostrar especificações da minha máquina
$ screenfetch
 MMMMMMMMMMMMMMMMMMMMMMMMMmds+.        OS: Mint 19.1 tessa
 MMm----::-:////////////oymNMd+`     Kernel: x86_64 Linux 4.15.0-20-generic
 MMd      /++                -sNMd:    Uptime: 2h 34m
 MMNso/`  dMM    `.::-. .-::.` .hMN:   Packages: 2217
 ddddMMh  dMM   :hNMNMNhNMNMNh: `NMm   Shell: bash 4.4.20
     NMm  dMM  .NMN/-+MMM+-/NMN` dMM   Resolution: 1920x1080
     NMm  dMM  -MMm  `MMM   dMM. dMM   DE: Cinnamon 4.0.10
     NMm  dMM  -MMm  `MMM   dMM. dMM   WM: Muffin
     NMm  dMM  .mmd  `mmm   yMM. dMM   WM Theme: Mint-Y-Dark (Mint-Y)
     NMm  dMM`  ..`   ...   ydm. dMM   GTK Theme: Mint-Y [GTK2/3]
     hMM- +MMd/-------...-:sdds  dMM   Icon Theme: Mint-Y
     -NMm- :hNMNNNmdddddddddy/`  dMM   Font: Noto Sans 9
      -dMNs-``-::::-------.``    dMM   CPU: Intel Core i7-6700 @ 8x 4GHz [52.0°C]
       `/dMNmy+/:-------------:/yMMM   GPU: NV136
          ./ydNMMMMMMMMMMMMMMMMMMMMM   RAM: 2544MiB / 7926MiB
             .MMMMMMMMMMMMMMMMMMM
Vamos medir o desempenho de um servidor de thread único. Abriremos dois terminais: em um rodaremos ./http_server, no outro — . Após um minuto, o segundo terminal exibirá as seguintes estatísticas:
$ wrk -c100 -d1m -t8 http://127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Running 1m test @ http://127.0.0.1:18470
  8 threads and 100 connections
  Thread Stats   Avg      Stdev     Max   +/- Stdev
    Latency   493.52us   76.70us  17.31ms   89.57%
    Req/Sec    24.37k     1.81k   29.34k    68.13%
  11657769 requests in 1.00m, 1.60GB read
Requests/sec: 193974.70
Transfer/sec:     27.19MB
Nosso servidor de thread único conseguiu processar mais de 11 milhões de requisições por minuto, oriundas de 100 conexões. Um bom resultado, mas é possível melhorá-lo?
Servidor multithreaded
Como mencionado anteriormente, um reator de I/O pode ser criado em threads separadas, utilizando assim todos os núcleos da CPU. Vamos aplicar essa abordagem na prática:
Mostrar http_server_multithreaded.c
#include "reactor.h"

static Reactor *reactor;
#pragma omp threadprivate(reactor)

#include "common.h"

int main(void) {
#pragma omp parallel
    {
        SAFE_CALL((reactor = reactor_new()), NULL);
        SAFE_CALL(reactor_register(reactor, new_server(true), EPOLLIN,
                                   on_accept, NULL),
                  -1);
        SAFE_CALL(reactor_run(reactor, SERVER_TIMEOUT_MILLIS), -1);
        SAFE_CALL(reactor_destroy(reactor), -1);
    }
}
Agora cada thread reator:
static Reactor *reactor;
#pragma omp threadprivate(reactor)
Note que o argumento da função new_server() é verdadeiro. Isso significa que estamos atribuindo ao socket do servidor a opção , para que ele possa ser utilizado em um ambiente multithreaded. Você pode ler mais detalhes .
A segunda tentativa
Agora vamos medir o desempenho do servidor multithreaded:
$ wrk -c100 -d1m -t8 http://127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Running 1m test @ http://127.0.0.1:18470
  8 threads and 100 connections
  Thread Stats   Avg      Stdev     Max   +/- Stdev
    Latency     1.14ms    2.53ms  40.73ms   89.98%
    Req/Sec    79.98k    18.07k  154.64k    78.65%
  38208400 requests in 1.00m, 5.23GB read
Requests/sec: 635876.41
Transfer/sec:     89.14MB
O número de requisições processadas em 1 minuto aumentou em ~3.28 vezes! Mas ainda faltaram cerca de ~dois milhões para um número redondo, vamos tentar corrigir isso.
Primeiro, vamos olhar as estatísticas geradas :
$ sudo perf stat -B -e task-clock,context-switches,cpu-migrations,page-faults,cycles,instructions,branches,branch-misses,cache-misses ./http_server_multithreaded

 Estatísticas do contador de desempenho para './http_server_multithreaded':

     242446,314933      task-clock (msec)         #    4,000 CPUs utilizados
         1 813 074      context-switches          #    0,007 M/sec
             4 689      cpu-migrations            #    0,019 K/sec
               254      page-faults               #    0,001 K/sec
   895 324 830 170      cycles                    #    3,693 GHz
   621 378 066 808      instructions              #    0,69  insn por ciclo
   119 926 709 370      branches                  #  494,653 M/sec
     3 227 095 669      branch-misses             #    2,69% de todos os branches
           808 664      cache-misses

60,604330670 segundos de tempo decorrido, compilação com -march=native, , aumento do número de acertos em , aumento MAX_EVENTS e uso de EPOLLET não resultaram em um aumento significativo de desempenho. Mas o que acontecerá se aumentarmos o número de conexões simultâneas?
Estatísticas com 352 conexões simultâneas:
$ wrk -c352 -d1m -t8 http://127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Executando teste de 1m @ http://127.0.0.1:18470
  8 threads e 352 conexões
  Estatísticas da Thread   Média      Desvio     Máx   +/ - Desvio
    Latência     2.12ms    3.79ms  68.23ms   87.49%
    Req/Sec    83.78k    12.69k  169.81k    83.59%
  40006142 requisições em 1.00m, 5.48GB lidos
Requisições/seg: 665789.26
Transferência/seg:     93.34MB
O resultado desejado foi alcançado, junto com um gráfico interessante que demonstra a relação entre o número de requisições processadas em 1 minuto e o número de conexões:
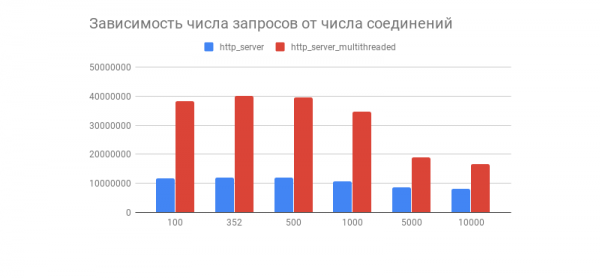
Percebemos que após algumas centenas de conexões, o número de requisições processadas em ambos os servidores cai drasticamente (isso é mais evidente na variante multithreaded). Isso está relacionado à implementação do stack TCP/IP do Linux? Sinta-se à vontade para compartilhar suas sugestões sobre o comportamento do gráfico e as otimizações nas versões multithreaded e single-thread nos comentários.
Como nos comentários, este teste de desempenho não mostra o comportamento do reator de I/O sob cargas reais, já que quase sempre o servidor interage com o banco de dados, gera logs, utiliza criptografia com etc., tornando a carga heterogênea (dinâmica). Testes junto com componentes externos serão realizados em um artigo sobre o reator de I/O.
Desvantagens do reator de I/O
É importante entender que o reator de I/O não está isento de desvantagens, nomeadamente:
- Usar o reator de I/O em um ambiente multithreaded é um pouco mais complicado, pois será necessário gerenciar os threads manualmente.
- A prática mostra que, na maioria dos casos, a carga não é uniforme, o que pode fazer com que um fluxo se destaque enquanto outro fica sobrecarregado.
- Se um manipulador de eventos bloquear o fluxo, o seletor do sistema também ficará bloqueado, o que pode levar a bugs difíceis de depurar.
Esses problemas são resolvidos , que frequentemente possui um planejador que distribui uniformemente a carga em um pool de threads, além de ter uma API mais amigável. Este será discutido mais adiante em meu outro artigo.
Conclusão
Assim, nossa jornada da teoria diretamente para os resultados do profiler chegou ao fim.
Não devemos parar por aqui, pois existem muitas outras abordagens igualmente interessantes para a escrita de software de rede, com diferentes níveis de conveniência e velocidade. Links interessantes, na minha opinião, estão listados abaixo.
Até a próxima!
Projetos interessantes
- C
O que mais ler?
Fonte: habr.com
