

Desenvolvemos um design de rede de data centers que permite implantar clusters computacionais com mais de 100 mil servidores, com largura de banda de bisecção superior a um petabyte por segundo.
No relatório de Dmitry Afanasyev, você vai aprender sobre os princípios básicos do novo design, a escalabilidade das topologias, os problemas que surgem, as opções para resolvê-los, as particularidades do roteamento e a escalabilidade das funções do plano de encaminhamento em topologias "densamente conectadas" com um grande número de rotas ECMP. Além disso, Dima fez um breve relato sobre a organização da conectividade externa, o nível físico, o sistema de cabos e as formas de aumentar ainda mais a capacidade.
— Bom dia a todos! Meu nome é Dmitry Afanasyev, sou arquiteto de redes do Yandex e me concentro principalmente no design de redes de data centers.
Minha apresentação será sobre a rede atualizada de data centers do Yandex. Isso é, em grande medida, uma evolução do design que tínhamos, mas, ao mesmo tempo, existem novos elementos. Esta é uma apresentação geral, pois tivemos que condensar bastante informação em um tempo limitado. Começaremos com a escolha da topologia lógica. Em seguida, haverá uma visão geral do plano de controle e dos problemas de escalabilidade do plano de dados, a escolha do que acontecerá no nível físico, e veremos algumas particularidades dos dispositivos. Também tocaremos um pouco sobre o que ocorre no data center com MPLS, sobre o qual falamos há algum tempo.
Então, o que o Yandex é em termos de cargas e serviços? O Yandex é um típico hyperscaler. Se olharmos para os usuários, a primeira coisa que ocorre é o processamento de solicitações dos usuários. Também temos diversos serviços de streaming e entrega de dados, uma vez que também dispomos de serviços de armazenamento. Se falarmos do backend, temos cargas e serviços de infraestrutura, como armazenamento de objetos distribuídos, replicação de dados e, claro, filas persistentes. Um dos principais tipos de carga é o MapReduce e sistemas semelhantes, processamento em fluxo, machine learning, etc.
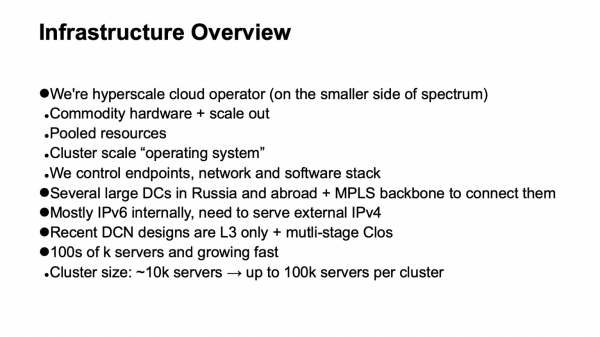
Como é estruturada a infraestrutura sobre a qual tudo isso acontece? Novamente, somos um hiperescalador típico, embora possamos estar um pouco mais próximos do lado do espectro onde estão hiperescaladores menores. Mas possuímos todos os atributos. Usamos hardware comum e escalabilidade horizontal em todos os lugares onde é possível. Temos um grande pool de recursos: não trabalhamos com máquinas ou racks separados, mas os unimos em um grande pool de recursos intercambiáveis, com alguns serviços adicionais que cuidam da programação e alocação, e trabalhamos com todo esse pool.
Assim surge o próximo nível - o sistema operacional do nível do cluster de computação. É muito importante que tenhamos controle total sobre a pilha de tecnologias que utilizamos. Controlamos os endpoints (hosts), a rede e a pilha de software.
Temos vários grandes data centers na Rússia e no exterior. Eles são interconectados por uma backbone que utiliza a tecnologia MPLS. Nossa infraestrutura interna é praticamente totalmente construída sobre IPv6, mas como precisamos atender o tráfego externo, que ainda chega principalmente através de IPv4, precisamos de alguma forma entregar as solicitações que chegam via IPv4 até o frontend-servidores, e ainda navegar um pouco na internet externa IPv4 - por exemplo, para indexação.
As últimas iterações do design das redes de data centers utilizam topologias Clos em múltiplos níveis, e nelas é aplicada apenas a L3. Deixamos a L2 há algum tempo e respiramos aliviados. Finalmente, nossa infraestrutura inclui centenas de milhares de instâncias computacionais (servidores). O tamanho máximo do cluster, algum tempo atrás, era de cerca de 10 mil servidores. Isso se deve, em grande parte, a como as operações do sistema do nível do cluster, schedulers, alocação de recursos, etc. podem funcionar. Como houve progresso do lado do software de infraestrutura, o objetivo atual é um tamanho em torno de 100 mil servidores em um único cluster de computação, e temos a tarefa de ser capazes de construir fábricas de rede que permitam efetivamente o pooling de recursos em tal cluster.
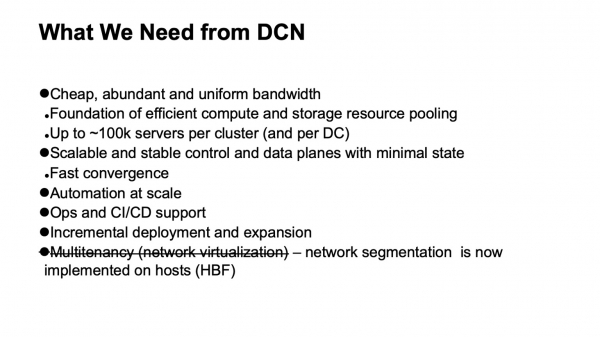
O que queremos da rede do data center? Em primeiro lugar, uma grande largura de banda, relativamente barata e suficientemente distribuída. Porque a rede é a base a partir da qual podemos agrupar recursos. O novo tamanho alvo é de cerca de 100 mil servidores em um cluster.
Além disso, é claro que queremos um plano de controle escalável e estável, porque em uma infraestrutura tão grande, muitos problemas podem surgir mesmo com eventos aleatórios, e não queremos que o plano de controle também nos dê dor de cabeça. Ao mesmo tempo, queremos minimizar o estado nele. Quanto menos estado, melhor e mais estável tudo funciona, e mais fácil é diagnosticar.
Claro, precisamos de automação, porque gerenciar tal infraestrutura manualmente é impossível, e isso já não era viável há algum tempo. Precisamos de suporte para operações operacionais e suporte de CI/CD, na medida do possível.
Com tamanhos tão grandes de data centers e clusters, a questão de suportar implantações incrementais e expansões sem interrupção do serviço já é bastante crítica. Se em clusters do tamanho de mil máquinas, talvez perto de dez mil, ainda pudéssemos realizá-los como uma única operação — ou seja, planejamos a expansão da infraestrutura, e algumas milhares de máquinas são adicionadas como uma única operação, então um cluster do tamanho de cem mil máquinas não surge imediatamente dessa forma, ele se constrói ao longo do tempo. E é desejável que durante todo esse tempo, o que já foi implantado, a infraestrutura que foi desenvolvida, esteja disponível.
E um requisito que tínhamos e que desapareceu: é o suporte à multitenancy, ou seja, virtualização ou segmentação de rede. Agora não precisamos fazer isso no nível da fiação de rede, porque a segmentação foi transferida para os hosts, o que facilitou muito a escalabilidade. Graças ao IPv6 e ao grande espaço de endereçamento, não precisávamos usar endereços duplicados na infraestrutura interna, toda a endereçamento já era único. E devido ao fato de termos transferido a filtragem e a segmentação da rede para os hosts, não precisamos criar entidades de rede virtuais nas redes de data centers.
Uma coisa muito importante é que não precisamos de certas funcionalidades. Se algumas funções podem ser removidas da rede, isso facilita muito a vida e, geralmente, amplia a escolha de hardware e software disponíveis, além de simplificar bastante o diagnóstico.
Então, o que não precisamos e do que conseguimos abrir mão, nem sempre com prazer no momento em que isso acontecia, mas com grande alívio quando o processo era concluído?
Em primeiro lugar, abrimos mão do L2. Não precisamos de L2, nem real, nem emulado. Ele não é amplamente utilizado devido ao fato de que controlamos a pilha de aplicativos. Nossos aplicativos são escaláveis horizontalmente, eles operam com endereçamento L3 e não se preocupam muito se alguma instância específica falhar, simplesmente implementamos uma nova; não precisa ser implementada no antigo endereço, pois há um nível separado de descoberta de serviços e monitoramento das máquinas no cluster. Não transferimos essa tarefa para a rede. A função da rede é entregar pacotes do ponto A ao ponto B.
Além disso, não temos situações em que os endereços mudam dentro da rede e isso precisa ser monitorado. Em muitos designs, isso geralmente é necessário para suportar a mobilidade de VMs. Não utilizamos a mobilidade de máquinas virtuais na infraestrutura interna do grande Yandex e, além disso, acreditamos que, mesmo que isso seja feito, não deve acontecer com suporte da rede. Se for realmente necessário, isso deve ser feito no nível dos hosts, colocando endereços que podem migrar em sobreposições, para não mexer e não fazer muitas alterações dinâmicas no sistema de roteamento da rede subjacente.
Outra tecnologia que não usamos é o multicast. Para quem quiser, posso explicar em detalhes por quê. Isso facilita muito a vida, porque, se alguém já lidou com isso e viu como parece o plano de controle do multicast — em todas as implementações, exceto nas mais simples, isso é uma grande dor de cabeça. Além disso, é difícil encontrar uma implementação aberta que funcione bem, para dizer o mínimo.
E, finalmente, projetamos nossas redes de modo que não ocorram muitas mudanças. Podemos contar que o fluxo de eventos externos no sistema de roteamento é pequeno.
Quais problemas e limitações devemos considerar ao desenvolver uma rede de data center? O custo, naturalmente. A escalabilidade, até que ponto queremos crescer. A necessidade de expansão sem interromper o serviço. A largura de banda e a disponibilidade. A visibilidade do que acontece na rede, para os sistemas de monitoramento e para as equipes operacionais. O suporte à automação — novamente, tanto quanto possível, já que diferentes tarefas podem ser resolvidas em diferentes níveis, incluíndo a introdução de camadas adicionais. E a independência em relação aos fornecedores. Embora em diferentes períodos históricos, dependendo do ângulo que olharmos, essa independência tenha sido mais fácil ou mais difícil de alcançar. Se considerarmos o segmento de chips de dispositivos de rede, até recentemente, falar sobre independência em relação aos fornecedores, se quiséssemos chips com alta largura de banda, era muito condicional.
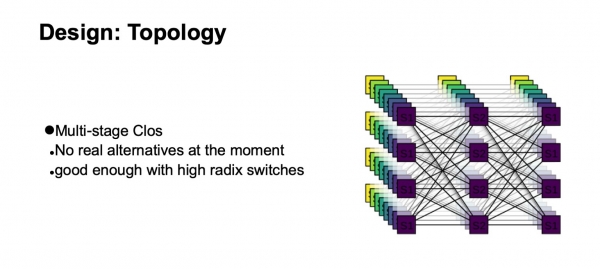
Qual topologia lógica construiremos para nossa rede? Será um Clos de múltiplos níveis. Na verdade, atualmente não existem alternativas reais. E a topologia Clos é bastante boa, mesmo quando comparada a várias topologias avançadas que estão mais na esfera do interesse acadêmico, se tivermos switches com grande radix.
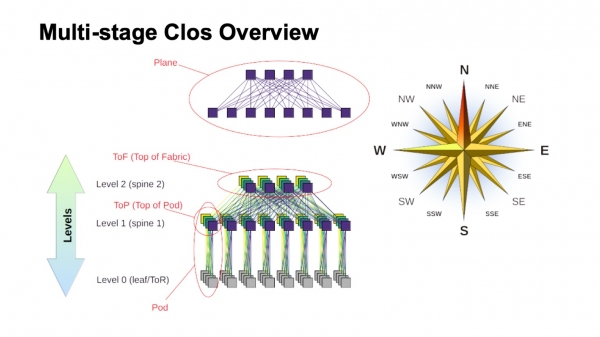
Como é aproximadamente uma rede Clos de múltiplos níveis e como são chamados seus diferentes elementos? Em primeiro lugar, uma rosa dos ventos, para se orientar sobre onde fica o norte, o sul, o leste e o oeste. Esse tipo de rede é geralmente construído por aqueles com tráfego muito grande de leste a oeste. Em relação aos outros elementos, na parte superior está um switch virtual, construído a partir de switches menores. Essa é a ideia principal da construção recursiva de redes Clos. Pegamos elementos com algum radix e os conectamos de forma que o resultado possa ser visto como um switch com um radix maior. Se precisar de ainda mais, o procedimento pode ser repetido.
Em casos, como os Clos de dois níveis, quando é possível distinguir claramente os componentes que na minha representação são verticais, eles costumam ser chamados de planos. Se estivéssemos construindo um Clos com três níveis de switches spine (todos que não são de borda e não são ToR, utilizados apenas para trânsito), os planos pareceriam mais complexos; os de dois níveis se apresentam exatamente assim. O bloco de switches ToR ou leaf e os switches spine de primeiro nível associados a eles chamamos de Pod. Os switches spine do nível spine-1 no topo do Pod são o topo do Pod. Os switches localizados na parte superior de toda a fabric são a camada superior da fabric, Top of fabric.
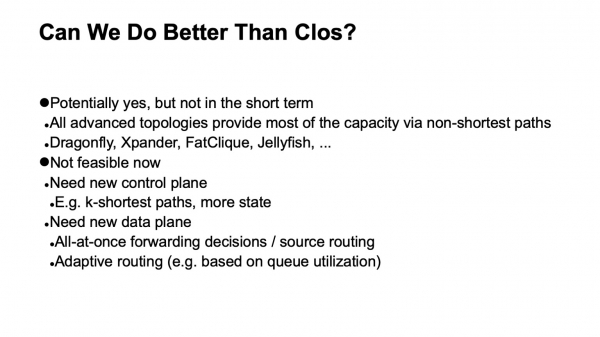
Claro, surge a questão: as redes Clos estão sendo construídas há algum tempo, a própria ideia é oriunda dos tempos da telefonia clássica, das redes TDM. Pode ter aparecido algo melhor, pode ser que algo possa ser feito de forma mais eficiente? Sim e não. Teoricamente, sim, na prática, a curto prazo, definitivamente não. Porque há um certo número de topologias interessantes, algumas das quais são até utilizadas em produção, por exemplo, Dragonfly é usada em aplicações de HPC; há também topologias interessantes como Xpander, FatClique, Jellyfish. Se olharmos as apresentações em conferências como SIGCOMM ou NSDI recentemente, podemos descobrir um número considerável de trabalhos sobre topologias alternativas que possuem melhores propriedades (de alguma forma) do que Clos.
Mas todas essas topologias têm uma propriedade interessante. Ela impede sua implementação em redes de data centers que tentamos construir em hardware comum e que têm custos razoáveis. Em todas essas topologias alternativas, a maior parte da largura de banda, infelizmente, não está disponível pelos caminhos mais curtos. Portanto, de imediato perdemos a possibilidade de usar o plano de controle tradicional.
Teoricamente, a solução para o problema é conhecida. Isso inclui, por exemplo, modificações do link state utilizando k-shortest path, mas, mais uma vez, não existem protocolos que tenham sido implementados em produção e estejam amplamente disponíveis no hardware.
Além disso, como a maior parte da capacidade não está disponível pelos caminhos mais curtos, precisamos modificar não apenas o plano de controle para que ele escolha todos esses caminhos (e, a propósito, isso é um estado consideravelmente maior no plano de controle). Também precisamos modificar o plano de encaminhamento, e geralmente são necessárias pelo menos duas funcionalidades adicionais. A primeira é a capacidade de tomar todas as decisões de encaminhamento de pacotes de uma vez, por exemplo, em um host. De fato, isso é roteamento fonte, às vezes na literatura sobre redes de interconexão é chamado de decisões de encaminhamento tudo de uma vez. E a segunda é o roteamento adaptativo — essa é uma função necessária em nossos dispositivos de rede, que se resume, por exemplo, a escolher o próximo salto com base nas informações sobre a menor carga de fila. Como exemplo, outras opções são possíveis.
Assim, a direção é interessante, mas, infelizmente, não podemos aplicá-la agora mesmo.
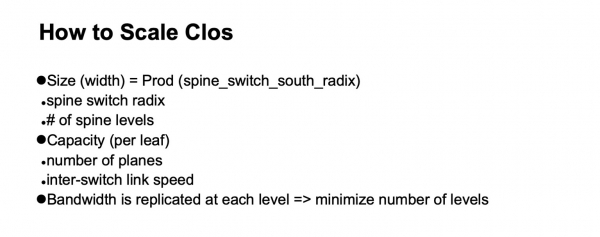
Certo, paramos na topologia lógica Clos. Como vamos escalá-la? Vamos ver como é estruturada e o que pode ser feito.
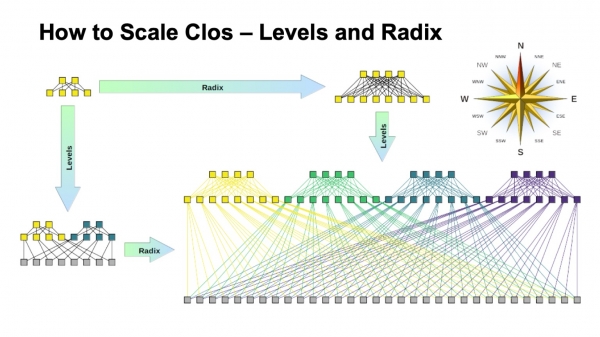
Na rede Clos, há dois parâmetros principais que podemos variar e obter diferentes resultados: o radix dos elementos e o número de níveis na rede. Eu tenho uma representação esquemática de como ambos influenciam o tamanho. Idealmente, combinamos os dois.
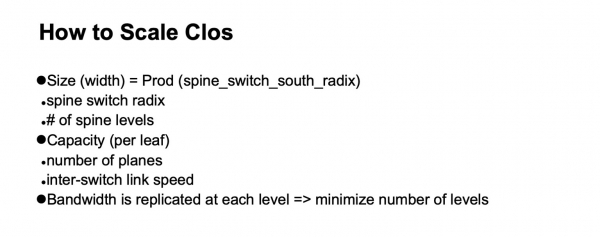
É visível que a largura final da rede Clos é o produto de todos os níveis de switches spine do radix sul, que mostra quantos links temos para baixo, como se ramifica. Assim escalamos o tamanho da rede.
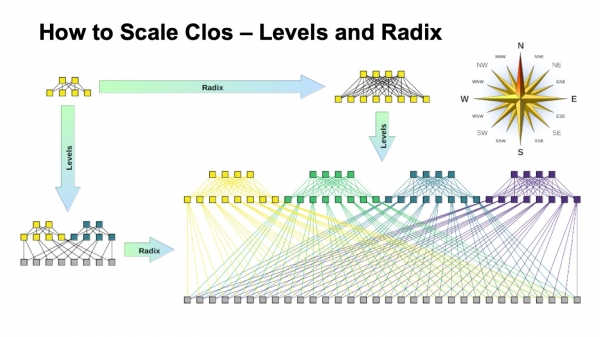
No que diz respeito à capacidade, especialmente em switches ToR, há duas opções de escalonamento. Ou podemos, mantendo a topologia geral, usar links mais rápidos, ou podemos adicionar mais planos.
Se olharmos para a versão expandida da rede Clos (no canto inferior direito) e voltarmos para esta imagem da rede Clos na parte inferior…
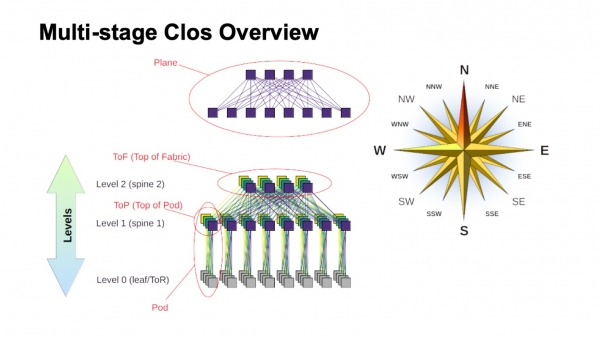
… isso é exatamente a mesma topologia, mas neste slide ela está compactada de forma mais compacta e os planos da fábrica estão sobrepostos. É a mesma coisa.
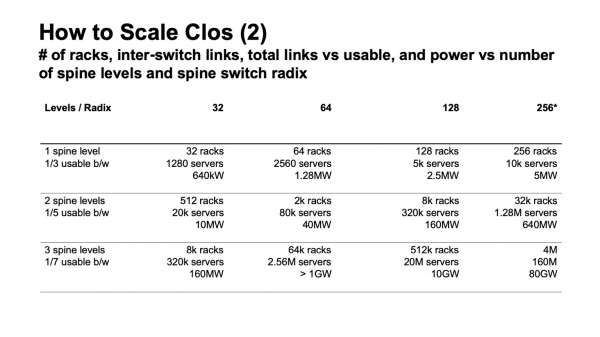
Como é o escalonamento da rede Clos em números? Aqui eu forneço dados sobre qual a largura máxima que a rede pode alcançar, qual a quantidade máxima de racks, switches ToR ou switches de folha, caso estes não estejam nos racks, que podemos obter dependendo do radix dos switches usados para os níveis spine e quantos níveis utilizamos.
Aqui está indicado quantos racks podemos ter, quantos servidores e aproximadamente quanto tudo isso pode consumir, com base em 20 kW por rack. Antes, eu mencionei que nosso objetivo é ter um cluster com cerca de 100 mil servidores.
É evidente que, em toda essa construção, existem dois com meio opções interessantes. Há a opção com duas camadas de spine e switches de 64 portas, que fica um pouco aquém. Depois, existem opções que se ajustam perfeitamente para switches de spine de 128 portas (com radix 128) com duas camadas, ou switches com radix 32 com três camadas. E em todos os casos em que temos um radix maior e mais camadas, é possível fazer uma rede muito grande, mas se você olhar o consumo esperado, normalmente, está na faixa de gigawatts. O cabeamento pode ser instalado, mas é improvável que consigamos tanta eletricidade em um único local. Se observarmos as estatísticas, os dados públicos sobre data centers mostram que é muito difícil encontrar data centers com capacidade planejada acima de 150 MW. O que é maior, normalmente, são campi de data centers, com vários grandes data centers localizados bastante próximos uns dos outros.
Há também um parâmetro importante. Se você olhar a coluna à esquerda, verá a largura de banda utilizável. Não é difícil notar que, em uma rede Clos, uma parte significativa das portas é utilizada para conectar switches entre si. A largura de banda utilizável é aquilo que pode ser alocado externamente, em direção aos servidores. Naturalmente, estou falando de portas condicionais e precisamente da largura de banda. Normalmente, as conexões dentro da rede são mais rápidas do que as conexões em direção aos servidores, mas para cada unidade de largura de banda que podemos fornecer externamente ao nosso equipamento de servidor, ainda há uma fração da largura de banda dentro da própria rede. E quanto mais camadas criamos, maiores são os custos unitários para fornecer essa largura de banda externamente.
Além disso, mesmo essa largura de banda adicional não é exatamente a mesma. Enquanto as distâncias forem curtas, podemos usar algo como DAC (cobre de conexão direta, ou seja, cabos twinax), ou óptica multimodo, que ainda custa razoavelmente. Assim que passamos para distâncias mais longas — normalmente, isso é óptica monomodo, e o custo dessa largura de banda adicional aumenta significativamente.
E, voltando ao slide anterior, se construirmos uma rede Clos sem re-assinatura, não é difícil olhar para o diagrama e ver como a rede é montada — ao adicionar cada nível de switches spine, estamos repetindo toda a largura que estava na parte inferior. Além disso, cada nível adiciona — e toda a mesma largura, mais tantos portos nos switches, e mais transceptores. Portanto, é muito desejável minimizar o número de níveis de switches spine.
A partir dessa imagem, é claro que gostaríamos muito de nos basear em algo como switches com radix 128.
Aqui, em princípio, é tudo o que acabei de explicar; este slide é mais para consideração futura.
Quais opções temos para escolher como potenciais switches? Uma notícia muito boa para nós é que agora finalmente é possível construir essas redes em switches de chip único. E isso é fantástico, pois eles têm muitas características agradáveis. Por exemplo, quase não há estrutura interna. Isso significa que eles quebram mais facilmente. Eles quebram, sem dúvida, mas, felizmente, quebram completamente. Nos dispositivos modulares, há uma grande quantidade de falhas (muito desagradáveis), quando do ponto de vista dos vizinhos e do controle, ele parece estar funcionando, mas, por exemplo, parte da fábrica pode ter falhado, e ele não opera em plena capacidade. O tráfego é balanceado com base no fato de que ele é totalmente funcional, e podemos enfrentar sobrecarga.
Ou, por exemplo, podem surgir problemas com o backplane, porque dentro do dispositivo modular também há SerDes de alta velocidade — ele é realmente complexo internamente. Ou suas tabelas podem ou não estar sincronizadas entre os elementos de encaminhamento. No geral, qualquer dispositivo modular de alto desempenho, composto por muitos elementos, regra geral contém toda a mesma rede Clos, apenas que é muito difícil de diagnosticar. Muitas vezes, até mesmo o fornecedor tem dificuldade em diagnosticar.
E ele tem uma grande quantidade de cenários de falha, nos quais o dispositivo degrada, mas não sai completamente da topologia. Como temos uma grande rede, usando ativamente o balanceamento entre elementos idênticos, a rede é muito regular, ou seja, um caminho em que tudo está funcionando não é diferente de outro caminho, é mais vantajoso simplesmente perder parte dos dispositivos da topologia do que cair na situação em que alguns parecem estar funcionando, enquanto outros não.
Uma característica agradável dos dispositivos de chip único é que eles evoluem melhor, mais rapidamente. Além disso, eles tendem a ter uma capacidade melhor. Se pegarmos grandes construções reunidas que temos, em média, a capacidade por rack unit em portas da mesma velocidade acaba sendo quase duas vezes melhor do que a dos dispositivos modulares. Dispositivos construídos em torno de um único chip são consideravelmente mais baratos do que os modulares e consomem menos energia.
Mas, claro, tudo isso não vem sem desvantagens. Em primeiro lugar, praticamente sempre um menor radix do que o dos dispositivos modulares. Se conseguirmos um dispositivo, construído em torno de um único chip, com 128 portas, podemos alcançar dispositivos modulares com várias centenas de portas agora sem grandes problemas.
Isso resulta em uma tabela de encaminhamento evidentemente menor e, como regra, em tudo que diz respeito à escalabilidade do plano de dados. Buffers não tão profundos. E, geralmente, uma funcionalidade bastante limitada. Mas descobre-se que, se conhecemos essas limitações e cuidamos a tempo para contorná-las ou simplesmente considerá-las, não é tão assustador. O fato de o radix ser menor, em dispositivos recentemente surgidos com radix 128, já não é um problema; podemos construir em duas camadas de spine. E com uma única camada, não conseguimos construir algo interessante em tamanho de qualquer maneira. Com um único nível, obtemos clusters muito pequenos. Mesmo nossos designs e requisitos anteriores ainda os superavam.
Na verdade, se por acaso a solução estiver no limite, há outra forma de escalar. Como o último (ou o primeiro), o nível mais baixo ao qual os servidores se conectam são os switches ToR ou switches leaf, não somos obrigados a conectar uma única rack a eles. Portanto, se a solução estiver aquém em até duas vezes, pode-se considerar simplesmente usar um switch com maior radix no nível inferior e conectar, por exemplo, duas a três racks a um único switch. Essa também é uma opção, tem seus próprios custos, mas funciona bem e pode ser uma boa solução quando é necessário aumentar em até duas vezes o tamanho.
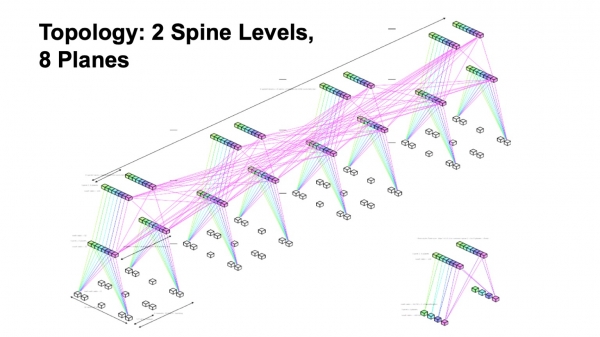
Em resumo, estamos construindo com uma topologia de dois níveis de spine, com oito camadas de fábrica.
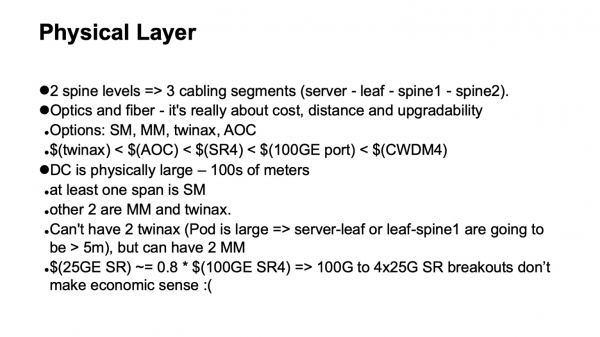
E quanto à física? Cálculos muito simples. Se temos dois níveis de spine, então temos um total de três níveis de switches, e esperamos que na rede haja três segmentos de cabos: dos servidores para os switches leaf, para o spine 1, e para o spine 2. As opções que podemos usar são: twinax, multimodo, e modo único. Aqui precisamos considerar qual a largura disponível, quanto isso vai custar, quais são as dimensões físicas, quais vãos podemos atravessar e como faremos o upgrade.
Em termos de custo, tudo pode ser organizado em uma linha. Os twinax custam significativamente menos do que a óptica ativa, são mais baratos que os transceptores multimodo, se considerarmos por vão, custam um pouco menos que uma porta de switch de 100 gigabits. E atenção, custam menos que a óptica de modo único, porque nos vãos onde se requer o modo único, nos data centers, por várias razões, faz sentido usar CWDM, trabalhar com modo único paralelo (PSM) não é muito conveniente, e se ficarmos com essas tecnologias, teremos uma hierarquia de preços semelhante.
Mais um comentário: infelizmente, não é muito viável usar portas multimodo de 100 a 4x25 desmontadas. Devido às características dos transceptores, SFP28 não custa muito menos que QSFP28 de 100 Gbit. E essa desmontagem para multimodo não funciona muito bem.
Outra limitação é que, devido ao tamanho dos clusters computacionais e ao número de servidores, nossos data centers são fisicamente grandes. Isso significa que pelo menos um vão precisará ser feito com modo simples. Novamente, devido ao tamanho físico dos Pods, não será possível passar por dois vãos com cabos twinax (cabeamentos de cobre).
Como resultado, se otimizar pelo preço e considerar a geometria dessa construção, teremos um vão com twinax, um vão com multimodo e um vão com modo simples usando CWDM. Isso leva em conta possíveis caminhos de upgrade.
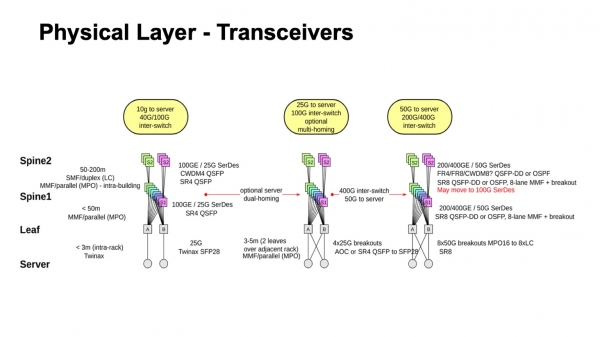
Assim é como parece, o que foi recentemente, para onde estamos indo e o que é possível. Está claro, pelo menos, como avançar para SerDes de 50 gigabits, tanto para multimodo quanto para modo simples. Além disso, se olharmos para o que existe nos transceptores de modo simples agora e no futuro para 400G, muitas vezes, mesmo quando chegam os SerDes de 50G do lado elétrico, na parte óptica já podem alcançar 100 Gbps por linha. Portanto, é bem possível que, em vez da transição para 50, haja a transição para SerDes de 100 gigabits e 100 Gbps por linha, pois segundo muitos fornecedores, sua disponibilidade é esperada em breve. O período em que os SerDes de 50G eram os mais rápidos parece que não vai durar muito, pois os primeiros exemplares de 100G devem ser lançados já no próximo ano. E algum tempo depois disso, talvez eles custem valores razoáveis.
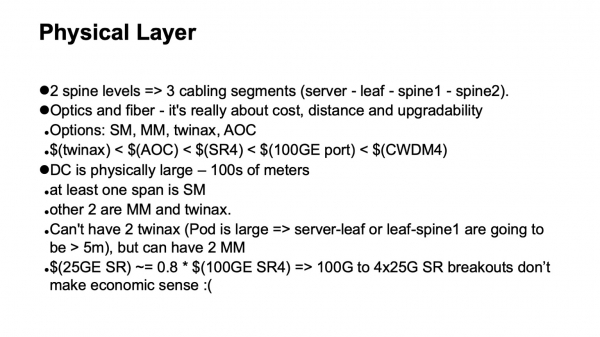
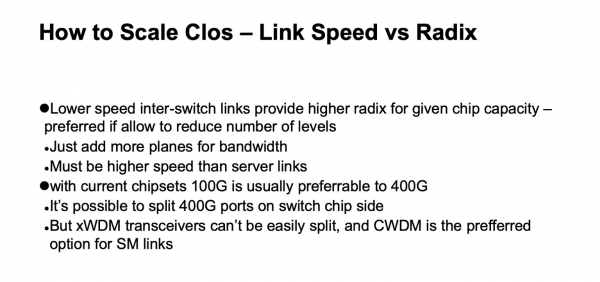
Outro detalhe sobre a escolha da física. Em princípio, já podemos utilizar portas de 400 ou 200 gigabits com SerDes de 50G. Mas fica claro que isso não faz muito sentido, porque, como mencionei anteriormente, queremos um radix suficientemente grande nos switches, dentro do razoável, é claro. Queremos 128. E se a capacidade do chip é limitada e aumentamos a velocidade do link, o radix, naturalmente, diminui; não há milagres.
Podemos aumentar a capacidade total através de planos, e nisso não há custos especiais; é possível adicionar mais planos. Se perdermos o radix, teremos que introduzir um nível adicional, portanto, com as atuais condições, com a capacidade máxima disponível para um chip, fica claro que é mais eficiente usar portas de 100 gigabits, pois elas permitem obter um radix maior.
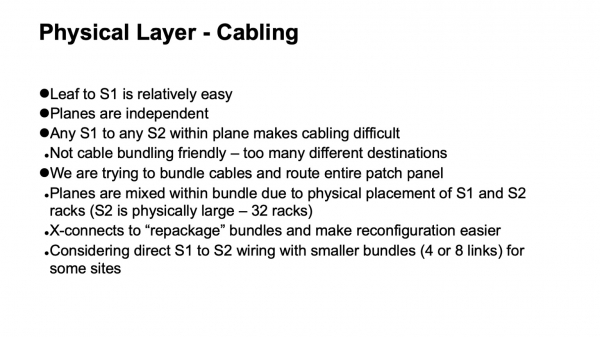
A próxima questão é como a física está organizada, mas agora do ponto de vista da infraestrutura de cabos. Descobre-se que é organizada de uma forma bastante interessante. O cabeamento entre os switches leaf e os spine switches de primeiro nível não possui muitos links, tudo é construído de forma relativamente simples. No entanto, se pegarmos um plano, o que acontece internamente — precisamos conectar todos os spine switches de primeiro nível a todos os spine switches de segundo nível.
Além disso, geralmente há algumas exigências sobre como isso deve parecer dentro do data center. Por exemplo, queríamos muito agrupar os cabos em um bundle e direcioná-los de forma que um patch panel de alta densidade se conectasse inteiramente a outro patch panel, evitando uma confusão de comprimentos. Conseguimos resolver essa tarefa. Se olharmos inicialmente para a topologia lógica, podemos ver que os planos são independentes, cada plano pode ser construído por conta própria. Mas quando adicionamos esse agrupamento e queremos conectar completamente um patch panel a outro, precisaremos misturar diferentes planos dentro de um único bundle e introduzir uma estrutura intermediária na forma de cross-connects ópticos, para reorganizá-los do modo como foram montados em um segmento para o modo como serão montados em outro segmento. Graças a isso, temos uma característica agradável: toda a comutação complexa não ultrapassa os limites dos racks. Quando é necessário entrelaçar algo extensivamente, "desdobrar planos", como às vezes é chamado nas redes Clos, tudo isso está concentrado dentro de um único rack. Não temos uma comutação muito fragmentada, nem mesmo até links individuais, entre os racks.
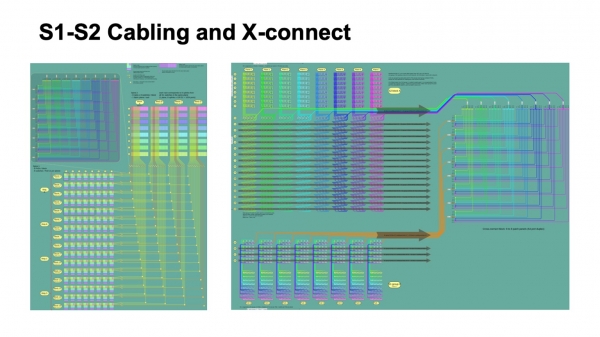
Assim é como se parece do ponto de vista da organização lógica da infraestrutura de cabos. Na imagem à esquerda, blocos coloridos representam os blocos dos spine switches de primeiro nível, com oito deles, e os quatro bundles de cabos que vão deles, cruzando-se com os bundles que vêm dos blocks dos spine switches de segundo nível.
Os pequenos quadrados representam interseções. No canto superior esquerdo, está a representação de cada uma dessas interseções, que na verdade é um módulo de cross-connect de 512 por 512 portas, que reorganiza os cabos de forma a chegar totalmente a um único rack, onde existe apenas um plano spine-2. E à direita, a representação dessa imagem é um pouco mais detalhada, aplicada a vários Pods no nível spine-1 e como isso é empacotado no cross-connect, como chega ao nível spine-2.
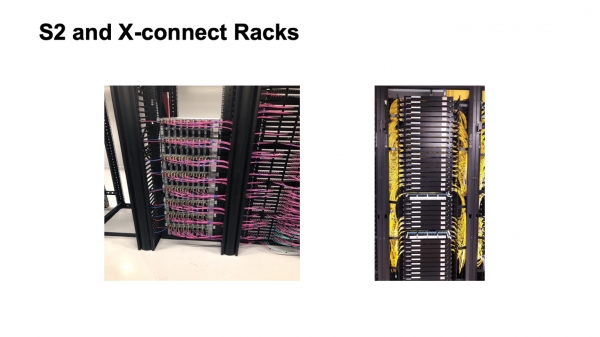
Assim é como isso se apresenta. Um rack spine-2 ainda não completamente montado (à esquerda) e o rack de cross-connect. Infelizmente, não é possível ver muito. Toda essa estrutura está sendo implementada agora em um de nossos grandes data centers que está em expansão. É um trabalho em andamento, ficará mais bonito e será melhor preenchido.
Uma questão importante: escolhemos a topologia lógica, construímos a física. O que acontecerá com o plano de controle? É bastante sabido pela experiência operacional que existe um certo número de apresentações que os protocolos de link state são bons, são agradáveis de trabalhar, mas, infelizmente, em uma topologia densamente conectada, eles não escalam bem. E há um fator principal que impede isso — é como funciona o flooding nos protocolos de link state. Se simplesmente pegarmos o algoritmo de flooding e olharmos como nossa rede está estruturada, podemos ver que em cada etapa haverá um fanout muito grande, e será simplesmente inundar o plano de controle com atualizações. Topologias específicas com o algoritmo tradicional de flooding em protocolos de link state misturam-se muito mal.
A escolha é usar BGP. Como prepará-lo corretamente está descrito na RFC 7938 sobre o uso de BGP em grandes data centers. As ideias básicas são simples: o mínimo de prefixos por host e em toda a rede, utilizar agregação quando possível, e suprimir a busca de caminho. Queremos uma propagação de atualizações muito cuidadosa e muito controlada, o que chamamos de valley free. Queremos que as atualizações, ao transitarem pela rede, se propaguem exatamente uma vez. Se se originarem na parte inferior, elas vão para cima, se propagando não mais de uma vez. Não deve haver ziguezagues. Ziguezagues são muito ruins.
Para fazer isso, usamos um esquema bastante simples que aproveita os mecanismos básicos do BGP. Ou seja, utilizamos eBGP funcionando em link local, com sistemas autônomos atribuídos da seguinte forma: um sistema autônomo no ToR, um sistema autônomo para todo o bloco de switches spine-1 de um Pod, e um sistema autônomo geral para todo o Top of Fabric. Não é difícil observar e confirmar que esse comportamento normal do BGP nos proporciona a disseminação de atualizações que desejamos.
Naturalmente, é necessário projetar o endereçamento e a agregação de endereços de forma que sejam compatíveis com a construção da roteirização, garantindo a estabilidade do plano de controle. O endereçamento L3 no transporte está vinculado à topologia, pois sem isso não é possível obter agregação; sem isso, endereços individuais conseguirão passar pelo sistema de roteirização. E outra coisa é que a agregação, infelizmente, não se mistura muito bem com multi-path, porque quando temos multi-path e agregação, tudo funciona bem enquanto toda a rede está operante, sem falhas. Infelizmente, assim que ocorrem falhas na rede e a simetria da topologia se perde, podemos chegar a um ponto do qual o agregado foi anunciado, de onde não conseguimos avançar para onde precisamos. Portanto, é melhor agregar onde não há multi-path, neste caso, os switches ToR.
Na realidade, é possível agregar, mas com cautela. Se conseguirmos fazer uma desagregação controlada diante de falhas na rede. Mas essa é uma tarefa bastante complexa; até tentamos prever se seria possível implementar automação adicional e autômatos finais que pudessem efetivamente pressionar o BGP para obter o comportamento desejado. Infelizmente, o tratamento de casos extremos é muito nebuloso e complicado, e a adoção de equipamentos externos para o BGP não resolve bem essa questão.
Um trabalho muito interessante foi feito nesse aspecto no âmbito do protocolo RIFT, que será discutido na próxima palestra.
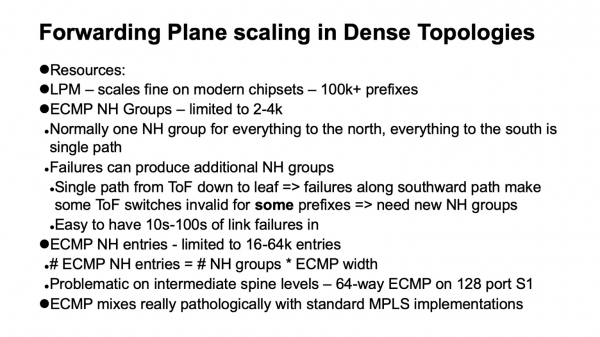
Outro aspecto importante é como os data planes se escalonam em topologias densas, onde temos um grande número de caminhos alternativos. Para isso, são utilizadas várias estruturas de dados adicionais: grupos ECMP, que descrevem, por sua vez, os grupos de Next Hop.
Em uma rede que funciona normalmente, sem falhas, quando seguimos a topologia Clos para cima, é suficiente usar apenas um grupo, porque tudo o que não é local é descrito por um padrão, podemos subir. Quando vamos de cima para baixo em direção ao sul, todos os caminhos não são ECMP, são caminhos de um único caminho. Tudo está bem. O problema, e a característica da topologia clássica Clos, é que se olharmos para o Top of Fabric, para qualquer elemento, até qualquer elemento na parte inferior, há um único caminho. Se ocorrerem falhas ao longo desse caminho, aquele elemento específico no topo da Fabric se torna inválido apenas para os prefixos que estão além do caminho quebrado. Para os outros, ele é válido, e temos que desmontar os grupos ECMP e introduzir um novo estado.
Como é a escalabilidade do data plane em dispositivos modernos? Se fazemos LPM (longest prefix match), tudo funciona bastante bem, acima de 100k prefixos. Se falarmos sobre grupos Next Hop, a situação é menos favorável, com 2 a 4 mil. Se falarmos sobre a tabela que contém a descrição dos Next Hops (ou adjacencies), isso varia de 16k a 64k. E isso pode se tornar um problema. E aqui chegamos a um desvio interessante: o que aconteceu com o MPLS em data centers? Na verdade, queríamos implementá-lo.
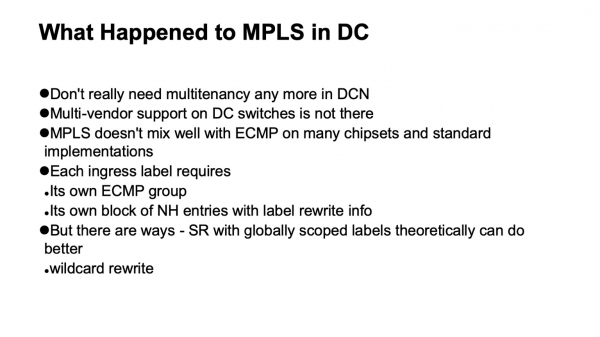
Duas coisas aconteceram. Fizemos microsegmentação nos hosts, então não precisávamos fazer isso na rede. A compatibilidade com diferentes fornecedores não era muito boa, especialmente com implementações abertas em white boxes com MPLS. Além disso, o MPLS, pelo menos suas implementações tradicionais, infelizmente, se combina muito mal com ECMP. E é por isso.
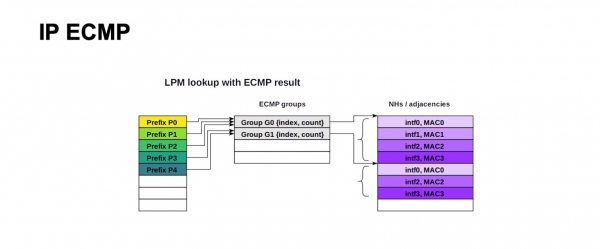
Esta é a estrutura de encaminhamento ECMP para IP. Um grande número de prefixos pode usar o mesmo grupo e o mesmo bloco de Next Hops (ou adjacencies, que na documentação de diferentes dispositivos podem ser chamados de maneiras diferentes). A essência é que isso é descrito como uma porta de saída e para o que reescrever o endereço MAC para chegar ao Next Hop correto. Para IP, tudo parece simples, pode-se usar um grande número de prefixos no mesmo grupo, o mesmo bloco de Next Hops.
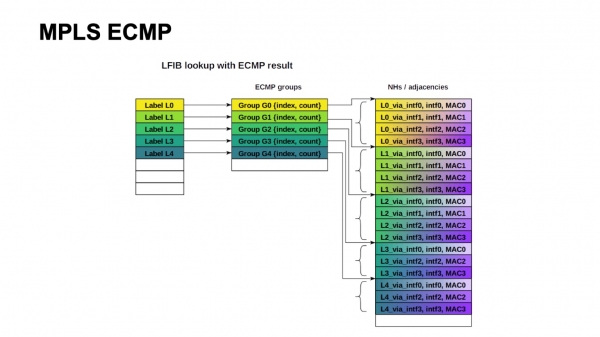
A arquitetura clássica do MPLS pressupõe — dependendo da interface de saída, a etiqueta pode ser reescrita para diferentes valores. Portanto, precisamos manter por grupo e por bloco de Next Hops para cada etiqueta de entrada. E isso, infelizmente, não escala.
Não é difícil ver que, na nossa configuração, precisávamos de cerca de 4000 switches ToR, com uma largura máxima de 64 caminhos ECMP, se mudarmos do spine-1 para o spine-2. Estamos nos limitando ao máximo em uma tabela de grupos ECMP, caso apenas um prefixo do ToR saia, e não conseguimos, de forma alguma, encaixar na tabela Next Hops.
Não está tudo perdido, pois arquiteturas como o Segment Routing implicam em rótulos globais. Formalmente, poderia-se novamente compactar todos esses blocos Next Hops. Para isso, seria necessária uma operação tipo wild card: pegar um rótulo e reescrever para o mesmo, sem um valor específico. Mas, infelizmente, nas implementações disponíveis, isso não está muito presente.
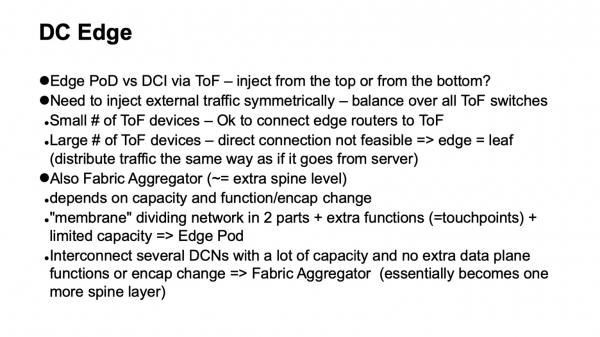
E, finalmente, precisamos trazer tráfego externo para o data center. Como fazer isso? Anteriormente, o tráfego era introduzido nas redes Clos de cima. Ou seja, havia roteadores de borda que se conectavam a todos os aparelhos no Top of fabric. Essa solução funciona razoavelmente bem em escalas pequenas e médias. Infelizmente, para introduzir o tráfego de maneira simétrica em toda a rede, é necessário conectar-se simultaneamente a todos os elementos do Top of fabric, e quando eles ultrapassam uma centena, percebemos que precisamos de um grande radix também nos roteadores de borda. Isso, em geral, custa dinheiro, pois os roteadores de borda são mais funcionais, e suas portas tendem a ser mais caras, resultando em uma configuração não muito estética.
Outra opção é trazer esse tráfego de baixo. Não é difícil perceber que a topologia Clos é construída de modo que o tráfego que chega de baixo, ou seja, do lado do ToR, é distribuído uniformemente pelos níveis em todo o Top of fabric em duas iterações, carregando toda a rede. Portanto, introduzimos um tipo especial de Pod, o Edge Pod, que garante a conectividade externa.
Há mais uma opção. Por exemplo, isso é feito pelo Facebook. Eles chamam isso de Fabric Aggregator ou HGRID. Um nível de spine adicional é introduzido para conectar vários data centers. Essa construção é possível se não temos funções adicionais ou troca de encapsulamento nas junções. Se houver, são pontos de contato adicionais, o que complica. Na maioria das vezes, surgem mais funções e uma espécie de membrana que separa diferentes partes do data center. Não vale a pena fazer essa membrana muito grande, mas se for realmente necessária, faz sentido considerar a possibilidade de deslocá-la, tornando-a o mais ampla possível e transferindo-a para os hosts. Isso é como muitos provedores de nuvem fazem. Eles têm overlays que começam nos hosts.
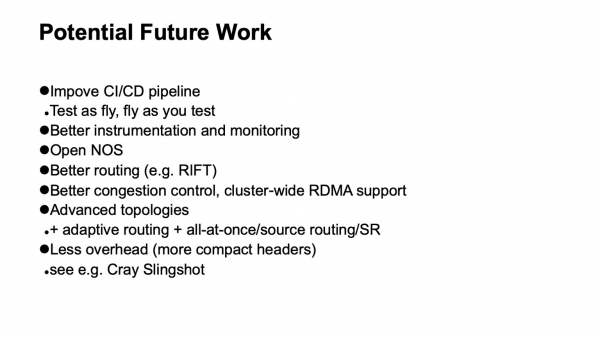
Quais oportunidades de desenvolvimento vemos? Em primeiro lugar, a melhoria do suporte ao pipeline CI/CD. Queremos voar como testamos e testar como voamos. Isso não está funcionando muito bem, pois a infraestrutura é grande e duplicá-la para testes é impossível. Precisamos entender como integrar elementos de teste na infraestrutura de produção sem derrubá-la.
Melhores ferramentas e melhor monitoramento raramente são excessivos. A questão é encontrar o equilíbrio entre esforço e retorno. Se for possível adicionar de maneira razoável, será muito bom.
Sistemas operacionais abertos para dispositivos de rede. Melhores protocolos e melhores sistemas de roteamento, como o RIFT. Também são necessárias pesquisas sobre a aplicação das melhores esquemas de controle de congestão e, possivelmente, a introdução, pelo menos em alguns pontos, do suporte RDMA dentro do cluster.
Se olharmos para um futuro mais distante, precisamos de topologias avançadas e, possivelmente, redes que utilizem menos overhead. Recentemente, houve publicações sobre a tecnologia de fabric para HPC Cray Slingshot, que se baseia em Ethernet commodity, mas com a opção de usar cabeçalhos muito mais curtos. Como resultado, o overhead diminui.
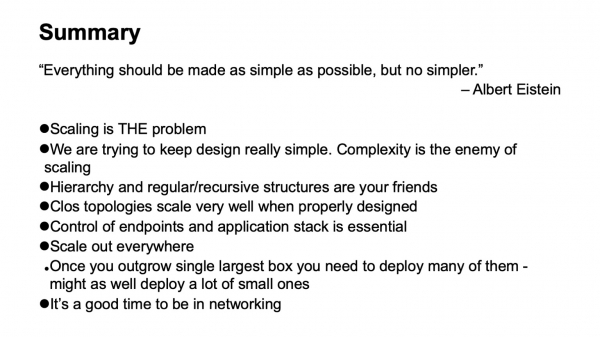
Tudo deve ser feito tão simples quanto possível, mas não mais simples. A complexidade é inimiga da escalabilidade. A simplicidade e estruturas regulares são nossos amigos. Se houver uma oportunidade para fazer scale out em algum lugar, faça-o. E, de fato, agora é uma ótima época para trabalhar com tecnologias de rede. Muitas coisas interessantes estão acontecendo. Obrigado.
Fonte: habr.com
