

Inspirado nas minhas apresentações no Highload++ e DataFest Minsk 2019.
Para muitos, hoje, o e-mail é uma parte indispensável da vida online. Através dele, conduzimos comunicações comerciais, armazenamos diversas informações importantes relacionadas a finanças, reservas de hotéis, processamento de pedidos e muito mais. Em meados de 2018, formulamos uma estratégia de produto para o desenvolvimento do e-mail. Como deve ser o e-mail moderno?
O e-mail deve ser inteligente, ou seja, ajudar os usuários a navegar na crescente quantidade de informações: filtrar, estruturar e apresentá-las da maneira mais conveniente. Ele deve ser útil, permitindo resolver diversas tarefas diretamente na caixa de entrada, como, por exemplo, pagar multas (uma funcionalidade da qual, para meu lamento, faço uso). E, claro, o e-mail deve garantir segurança da informação, bloqueando spam e protegendo contra invasões, ou seja, ser segura.
Essas direções definem uma série de tarefas-chave, muitas das quais podem ser resolvidas de maneira eficaz com o uso de aprendizado de máquina. Aqui estão exemplos de recursos já em funcionamento, desenvolvidos dentro da estratégia - um para cada direção.
- Resposta Inteligente. O e-mail conta com uma função de resposta inteligente. A rede neural analisa o texto do e-mail, compreende seu significado e objetivo e, como resultado, oferece três opções de resposta mais adequadas: positiva, negativa e neutra. Isso ajuda a economizar significativamente tempo ao responder e-mails, além de muitas vezes possibilitar respostas de forma não convencional e divertida.
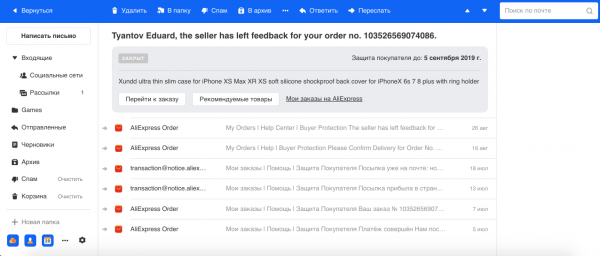
- Agrupamento de e-mails, relacionados a pedidos em lojas online. Frequentemente compramos pela internet e, em geral, as lojas podem enviar vários e-mails para cada pedido. Por exemplo, da AliExpress, o maior serviço, chega uma quantidade significativa de e-mails para um único pedido, e calculamos que, em casos extremos, essa quantidade pode chegar a 29. Portanto, com o uso do modelo de Reconhecimento de Entidades Nomeadas, extraímos o número do pedido e outras informações do texto e agrupamos todos os e-mails em uma única thread. Também mostramos as informações principais sobre o pedido em uma barra separada, facilitando o trabalho com esse tipo de e-mail.

- AntiphishingPhishing é um tipo de e-mail criminoso altamente perigoso, pelo qual os golpistas tentam obter informações financeiras (incluindo dados de cartões de crédito dos usuários) e logins. Esses e-mails imitam os verdadeiros, enviados pelos serviços, inclusive visualmente. Portanto, com o uso de Computer Vision, conseguimos reconhecer os logotipos e o estilo de formatação dos e-mails de grandes empresas (como Mail.ru, Sber, Alfa) e consideramos isso junto com o texto e outros sinais em nossos classificadores de spam e phishing.
Aprendizado de Máquina
Um pouco sobre aprendizado de máquina em e-mails, em geral. O e-mail é um sistema de alta carga: nossos servidores processam, em média, 1,5 bilhões de e-mails por dia para 30 milhões de usuários ativos. Cerca de 30 sistemas de aprendizado de máquina cuidam de todas as funções e recursos necessários.
Cada e-mail passa por uma verdadeira linha de classificação. Primeiro, filtramos o spam e deixamos os bons e-mails. Os usuários muitas vezes não percebem o trabalho do anti-spam, porque 95-99% do spam nem chega à pasta apropriada. A identificação de spam é uma parte muito importante do nosso sistema e a mais complexa, pois na área de anti-spam há uma constante adaptação entre os sistemas de defesa e ataque, o que apresenta um desafio contínuo para nossa equipe.
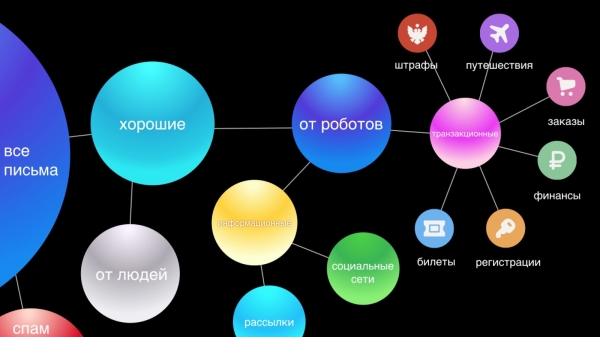
Em seguida, separamos os e-mails de pessoas e robôs. Os e-mails de pessoas são os mais importantes, por isso, para eles, oferecemos funções como Smart Reply. Os e-mails de robôs são divididos em duas partes: transacionais — são e-mails importantes de serviços, como confirmações de compras ou reservas de hotel, e financeiros — são anúncios de negócios e descontos.
Acreditamos que os e-mails transacionais têm a mesma importância da correspondência pessoal. Eles devem estar à mão, pois muitas vezes é necessário encontrar rapidamente informações sobre um pedido ou a reserva de um voo, e gastamos tempo procurando esses e-mails. Portanto, para conveniência, os separamos automaticamente em seis categorias principais: viagens, pedidos, finanças, ingressos, registros e, finalmente, multas.
Os comunicados informativos são o grupo mais numeroso e, provavelmente, o menos importante, pois não exigem uma reação imediata; nada substancial mudará na vida do usuário se ele não ler tal comunicado. Na nossa nova interface, agrupamos esses comunicados em dois threads: redes sociais e newsletters, assim, limpando visualmente a caixa de entrada e deixando à vista apenas os e-mails importantes.
Operação
Um grande número de sistemas traz muitas dificuldades em sua operação. Afinal, os modelos, com o tempo, se degradam, assim como qualquer software: as funções falham, as máquinas param de funcionar, e códigos problemáticos surgem. Além disso, os dados mudam constantemente: novos dados são adicionados, o padrão de comportamento dos usuários se transforma, etc., por isso um modelo sem o devido suporte tende a funcionar cada vez pior com o tempo.
Não podemos esquecer que quanto mais o aprendizado de máquina se infiltra na vida dos usuários, maior é a influência que eles exercem sobre o ecossistema, e, como consequência, maiores podem ser as perdas financeiras ou os lucros que os players do mercado obtêm. Assim, em um número cada vez maior de áreas, os players se adaptam para trabalhar com algoritmos de ML (exemplos clássicos incluem publicidade, busca e o já mencionado anti-spam).
Além disso, as tarefas de aprendizado de máquina têm uma particularidade: qualquer alteração, mesmo que insignificante, no sistema pode gerar muito trabalho com o modelo: manipulação de dados, re-treinamento, deploy, o que pode se estender por semanas ou meses. Portanto, quanto mais rapidamente o ambiente em que seus modelos operam muda, mais esforço é necessário para mantê-los. A equipe pode criar muitos sistemas e se alegrar com isso, mas depois gastar quase todos os recursos na manutenção deles, sem ter a possibilidade de criar algo novo. Já enfrentei uma situação assim na equipe de anti-spam e cheguei à conclusão óbvia de que a manutenção precisa ser automatizada.
Automação
O que pode ser automatizado? Na verdade, quase tudo. Eu destaquei quatro direções que definem a infraestrutura do aprendizado de máquina:
- coleta de dados;
- re-treinamento;
- deploy;
- testes & monitoramento.
Se o ambiente é instável e muda constantemente, toda a infraestrutura ao redor do modelo acaba sendo muito mais importante do que o próprio modelo. Pode ser um bom e velho classificador linear, mas se as características forem bem fornecidas e um bom feedback dos usuários for estabelecido, ele funcionará muito melhor do que modelos State-Of-The-Art com todos os recursos adicionais.
Ciclo de feedback
Esse ciclo integra a coleta de dados, o re-treinamento e o deployment — resumindo, todo o ciclo de atualização do modelo. Por que isso é importante? Veja o gráfico de registro de contas de e-mail:
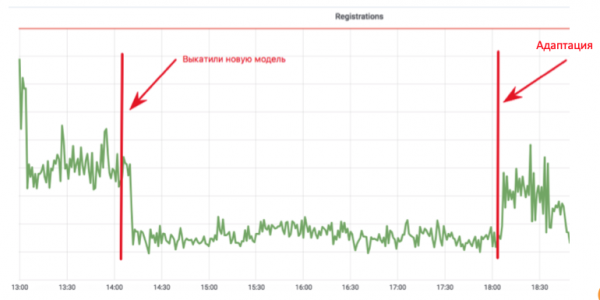
O desenvolvedor de aprendizado de máquina implementou um modelo anti-bots, que impede que bots se registrem em contas de e-mail. O gráfico cai para um valor onde permanecem apenas usuários reais. Tudo ótimo! Mas, após quatro horas, os criadores de bots ajustam seus scripts, e tudo volta ao normal. Neste caso, o desenvolvedor gastou um mês adicionando características e re-treinando o modelo, mas o spammer conseguiu se adaptar em quatro horas.
Para que não seja tão doloroso e não tenhamos que refazer tudo depois, é preciso pensar desde o início em como será o ciclo de feedback e o que faremos se o ambiente mudar. Vamos começar pela coleta de dados — esse é o combustível para nossos algoritmos.
Coleta de dados
É claro que, para redes neurais modernas, quanto mais dados, melhor, e esses dados, essencialmente, são gerados pelos usuários do produto. Podemos contar com os usuários para rotular os dados, mas não devemos abusar disso, porque, em algum momento, os usuários se cansarão de treinar seus modelos e mudarão para outro produto.
Um dos erros mais comuns (aqui faço referência a Andrew Ng) é uma orientação excessivamente forte em métricas no conjunto de dados de teste, e não no feedback do usuário, que é na verdade o principal critério de qualidade, pois estamos criando um produto para o usuário. Se o usuário não entende ou não gosta do funcionamento do modelo, tudo será em vão.
Portanto, o usuário sempre deve ter a oportunidade de votar, devemos fornecer a ele uma ferramenta para feedback. Se acreditamos que um e-mail recebeu a classificação de financeiro, devemos marcá-lo como "finanças" e desenhar um botão que o usuário possa clicar para dizer que isso não se trata de finanças.
Qualidade do feedback
Vamos discutir a qualidade do feedback do usuário. Primeiro, você e o usuário podem atribuir diferentes significados a um mesmo conceito. Por exemplo, você e os gerentes de produto podem achar que "finanças" se refere a cartas do banco, enquanto o usuário acredita que a carta da avó sobre a aposentadoria também se enquadra em finanças. Em segundo lugar, há usuários que pressionam botões sem qualquer lógica. Em terceiro lugar, o usuário pode estar profundamente equivocado em suas conclusões. Um exemplo claro da nossa prática é a implementação de um classificador , um tipo bastante curioso de spam, onde se oferece ao usuário a chance de recuperar milhões de dólares de um parente distante repentinamente encontrado na África. Após a implementação desse classificador, verificamos os cliques em "Não é spam" nessas cartas, e descobrimos que 80% delas eram puro spam nigeriano, o que indica que os usuários podem ser extremamente credulários.
E não podemos esquecer que não são apenas pessoas que clicam nos botões, mas também diversos bots que se passam por navegadores. Portanto, o feedback bruto não é adequado para o treinamento. O que pode ser feito com essa informação?
Aplicamos duas abordagens:
- Feedback de ML relacionado. Por exemplo, temos um sistema online anti-bot que, como já mencionei, toma decisões rápidas com base em um número limitado de características. E há um segundo sistema, mais lento, que opera post factum. Ele possui mais dados sobre o usuário, seu comportamento, etc. Como consequência, é tomada a decisão mais ponderada, o que resulta em uma maior precisão e completude. Podemos direcionar a diferença de funcionamento desses sistemas para o primeiro como dados para treinamento. Dessa forma, o sistema mais simples estará sempre tentando se aproximar do desempenho do sistema mais complexo.
- Classificação de cliquesÉ possível classificar cada clique do usuário, avaliar sua validade e possibilidade de uso. Fazemos isso no anti-spam de e-mail, utilizando características do usuário, seu histórico, características do remetente, o próprio texto e o resultado do trabalho dos classificadores. No final, obtemos um sistema automático que valida o feedback do usuário. E como ele precisa ser treinado com muito menos frequência, seu funcionamento pode se tornar a base para todos os outros sistemas. O principal prioridade nesse modelo é a precisão, pois treinar o modelo com dados imprecisos pode trazer consequências graves.
Enquanto limpamos os dados e treinamos nossos sistemas de ML, não podemos esquecer dos usuários, pois para nós, milhares ou milhões de erros em um gráfico são estatísticas, mas para o usuário, cada bug é uma tragédia. Além do fato de que o usuário precisa lidar de alguma forma com o erro em seu produto, ele espera que, após o feedback, situações semelhantes sejam evitadas no futuro. Portanto, sempre devemos oferecer aos usuários não apenas a oportunidade de votar, mas também de corrigir o comportamento dos sistemas de ML, criando, por exemplo, heurísticas pessoais para cada clique de feedback; no caso do e-mail, isso pode ser a possibilidade de filtrar e-mails semelhantes por remetente e assunto para esse usuário.
Além disso, é necessário, com base em relatórios ou solicitações de suporte, ajustar a modelo em um modo semi-automático ou manual, para que outros usuários também não sofram com problemas semelhantes.
Heurísticas para treinamento
Com esses dados de heurísticas e ajustes, existem dois problemas. O primeiro é que o número crescente de ajustes é difícil de manter, sem mencionar sua qualidade e eficácia a longo prazo. O segundo problema é que o erro pode não ser frequente, e alguns cliques podem não ser suficientes para treinar o modelo. A princípio, parece que esses dois efeitos não relacionados podem ser substancialmente neutralizados se adotarmos a abordagem seguinte.
- Criar um ajuste temporário.
- Direcionar os dados dele para o modelo, que será treinado regularmente, incluindo os dados obtidos. Aqui, é claro que é importante que a heurística tenha alta precisão, para não comprometer a qualidade dos dados no conjunto de treinamento.
- Em seguida, configuramos a monitoração para acionar o atalho, e se, após algum tempo, o atalho não acionar mais e for completamente coberto pelo modelo, podemos removê-lo sem hesitação. Agora, é improvável que esse problema se repita.
Portanto, um exército de atalhos é muito útil. O principal é que seu uso seja temporário, e não permanente.
Aprimoramento
Aprimoramento é o processo de adicionar novos dados, obtidos a partir do feedback de usuários ou de outros sistemas, e treinar o modelo existente com esses dados. No aprimoramento, pode haver vários problemas:
- O modelo pode simplesmente não suportar aprimoramento e só treinar do zero.
- Não está escrito em lugar nenhum que o aprimoramento necessariamente melhorará a qualidade no ambiente de produção. Muitas vezes, acontece exatamente o oposto, ou seja, pode até resultar em uma degradação.
- As mudanças podem ser imprevisíveis. Esse é um ponto delicado que identificamos. Mesmo que um novo modelo, em um teste A/B, apresente resultados semelhantes ao atual, isso não significa que funcionará da mesma forma. Seu desempenho pode divergir em um único percentual, o que pode introduzir novos erros ou reverter erros antigos que já foram corrigidos. Tanto nós quanto os usuários já aprendemos a lidar com os erros atuais, e quando um grande número de novos erros surge, o usuário também pode não entender o que está acontecendo, pois espera um comportamento previsível.
Portanto, o mais importante no aprimoramento é garantir que o modelo melhore ou, pelo menos, não piore.
A primeira coisa que vem à mente quando falamos sobre aprimoramento é a abordagem de Aprendizado Ativo. O que isso significa? Por exemplo, um classificador determina se uma mensagem se refere a finanças, e ao redor do seu limite de decisão, adicionamos uma amostra de exemplos rotulados. Isso funciona bem, por exemplo, em publicidade, onde há muito feedback e é possível treinar o modelo em tempo real. E se o feedback for escasso, obtemos uma amostra altamente enviesada em relação à distribuição de dados de produção, com base na qual não é possível avaliar o comportamento do modelo durante a operação.
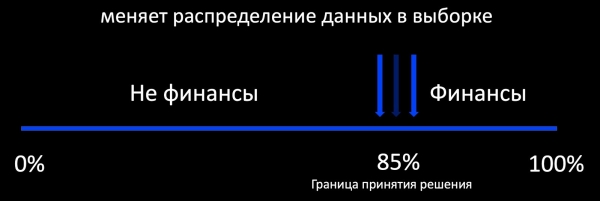
Na verdade, nosso objetivo é preservar os padrões antigos, modelos já conhecidos, e adquirir novos. Aqui, a continuidade é importante. O modelo que frequentemente implementamos com grande dificuldade já está em funcionamento, portanto, podemos nos basear em seu desempenho.
No e-mail, diferentes modelos são aplicados: árvores, lineares, redes neurais. Para cada um, elaboramos nosso próprio algoritmo de ajuste. No processo de ajuste, não apenas obtemos novos dados, mas frequentemente também novos atributos, que levaremos em consideração em todos os algoritmos a seguir.
Modelos lineares
Suponha que temos uma regressão logística. Montamos a função perda do modelo a partir dos seguintes componentes:
- LogLoss em novos dados;
- regularizamos os pesos dos novos atributos (não tocamos nos antigos);
- aprendemos também com os dados antigos, para preservar os padrões estabelecidos;
- e, talvez o mais importante: aplicamos a Regularização Harmônica, que garante que os pesos não mudem significativamente em relação ao modelo antigo.
Como cada componente da perda possui coeficientes, podemos ajustar os valores ideais para nossa tarefa por meio de validação cruzada ou com base nas exigências do produto.
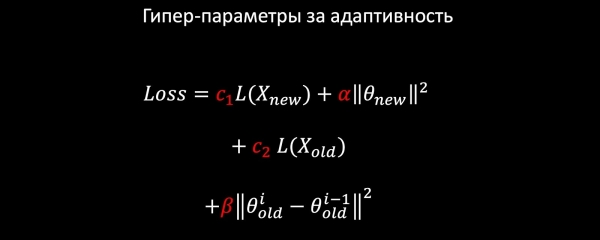
Árvores
Vamos passar para as árvores de decisão. Desenvolvemos o seguinte algoritmo de ajuste para as árvores:
- Em produção, temos uma floresta de 100 a 300 árvores, treinada em um conjunto de dados antigo.
- Removemos no final M = 5 árvores e adicionamos 2M = 10 novas, treinadas em todo o conjunto de dados, mas com alto peso para os novos dados, o que naturalmente garante uma mudança incremental no modelo.
É evidente que, com o tempo, o número de árvores aumenta significativamente, e elas precisam ser periodicamente diminuídas para se manter dentro dos prazos. Para isso, utilizamos a onipresente hoje Distilação do Conhecimento (KD). Um breve resumo do seu funcionamento.
- Temos o modelo atual "complexo". Executamos ele em um conjunto de dados de treinamento e obtemos a distribuição de probabilidades das classes na saída.
- Em seguida, ensinamos o modelo aluno (um modelo com um número menor de árvores, neste caso) a repetir os resultados do modelo, usando a distribuição das classes como variável alvo.
- É importante notar que não usamos a marcação do conjunto de dados, e por isso podemos utilizar dados arbitrários. Certamente, utilizamos amostras de dados do fluxo de produção como conjunto de treinamento para o modelo aprendiz. Dessa forma, o conjunto de treinamento nos permite garantir a precisão do modelo, enquanto a amostra do fluxo garante desempenho semelhante na distribuição de produção, compensando o viés do conjunto de treinamento.
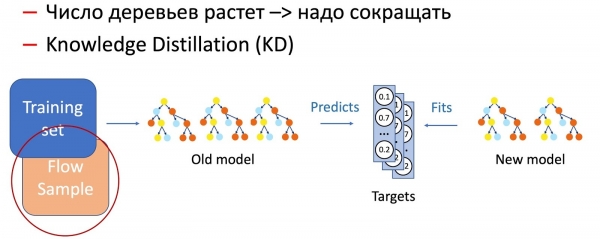
A combinação dessas duas metodologias (adição de árvores e a redução periódica de seu número através da Knowledge Distillation) assegura a introdução de novos padrões e continuidade total.
Com a KD, também realizamos operações de diferenciação com características do modelo, como a remoção de características e o trabalho com faltas. No nosso caso, temos uma série de características estatísticas importantes (por remetentes, hashes de texto, URLs, etc.) que são armazenadas em uma base de dados que pode falhar. A modelo, naturalmente, não está preparado para tal situação, pois o conjunto de treinamento não inclui cenários de falha. Nesses casos, combinamos as técnicas de KD e aumento: durante o treinamento, para parte dos dados, removemos ou zeramos as características necessárias, enquanto as etiquetas (saídas do modelo atual) são as originais, e o modelo aprendiz aprende a repetir essa distribuição.
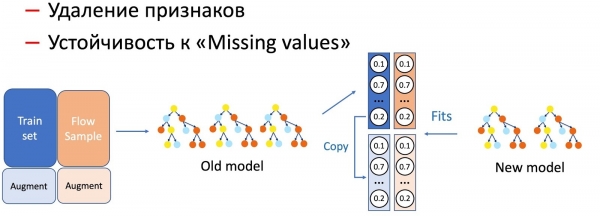
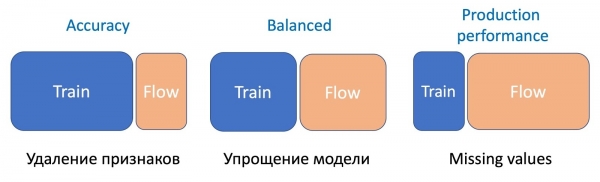
Observamos que quanto mais séria a manipulação dos modelos, mais porcentagem de amostra do fluxo é necessária.
Para remover características, a operação mais simples, exige apenas uma pequena parte do fluxo, já que apenas algumas características mudam e o modelo atual foi treinado no mesmo conjunto — a diferença é mínima. Para simplificar o modelo (reduzindo o número de árvores várias vezes), já se requer um equilíbrio de 50 a 50. E para as faltas de características estatísticas importantes, que afetam seriamente o desempenho do modelo, é necessário ainda mais fluxo para equilibrar o funcionamento do novo modelo resistente a faltas em todos os tipos de e-mails.
FastText
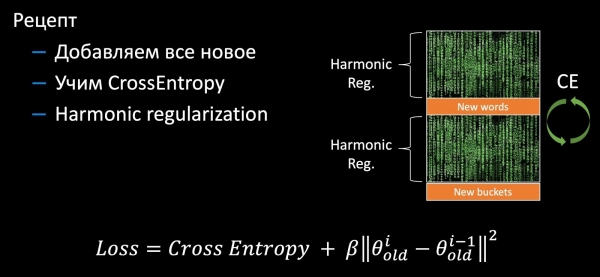
Vamos falar sobre o FastText. Lembro que a representação (embedding) de uma palavra é composta pela soma do embedding da própria palavra e todos os seus N-grams, geralmente trigramas. Como podem existir muitos trigramas, utiliza-se o Bucket Hashing, ou seja, a transformação de todo o espaço em um determinado hash map fixo. Como resultado, a matriz de pesos tem dimensões da camada interna multiplicadas pelo número de palavras mais buckets.
No fine-tuning surgem novas características: palavras e trigramas. No fine-tuning padrão do Facebook, nada de significativo acontece. Apenas os pesos antigos são ajustados com entropia cruzada em novos dados. Dessa forma, as novas características não são utilizadas, e esse método, claro, apresenta todas as desvantagens descritas anteriormente relacionadas à imprevisibilidade do modelo em produção. Portanto, ajustamos um pouco o FastText. Adicionamos todos os novos pesos (palavras e trigramas), treinamos toda a matriz com entropia cruzada e aplicamos a regularização harmônica, de forma análoga ao modelo linear, que garante que os pesos antigos não sejam alterados de forma significativa.
CNN
Com redes convolucionais é um pouco mais complicado. Se, em uma CNN, as últimas camadas são ajustadas, obviamente, a regularização harmônica pode ser aplicada e garantir a continuidade. Mas quando é necessário realizar o fine-tuning de toda a rede, essa regularização não pode ser aplicada a todas as camadas. No entanto, existe a opção de treinar embeddings complementares através do Triplet Loss ().
Triplet Loss
No exemplo da tarefa de anti-phishing, analisamos de forma geral o Triplet Loss. Pegamos nosso logotipo, assim como exemplos positivos e negativos de logotipos de outras empresas. Minimiza-se a distância entre os primeiros e maximiza-se a distância entre os segundos, fazendo isso com uma pequena margem para garantir uma maior compactação das classes.
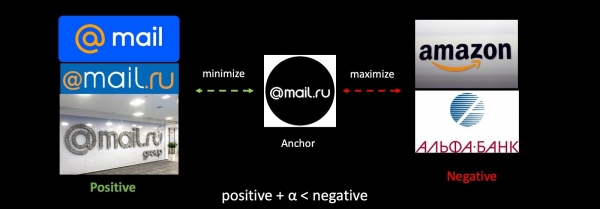
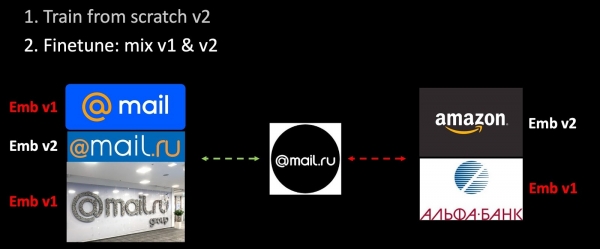
Se ajustamos a rede, o espaço métrico muda completamente e se torna absolutamente incompatível com o anterior. Esse é um problema sério em tarefas que utilizam vetores. Para contornar esse problema, devemos misturar embeddings antigos durante o treinamento.
Adicionamos novos dados ao conjunto de treinamento e estamos reensinando do zero a segunda versão do modelo. Na segunda fase, realizamos o fine-tuning da nossa rede: inicialmente, apenas a última camada é treinada, e, em seguida, toda a rede é destravada. Durante a formação dos tripletos, apenas uma parte dos embeddings é calculada com o modelo treinável, enquanto o restante é feito com o modelo antigo. Dessa forma, durante o fine-tuning, garantimos a compatibilidade entre os espaços métricos v1 e v2. É uma espécie de variante de regularização harmônica.
Arquitetura como um todo
Quando olhamos para todo o sistema como um exemplo de anti-spam, notamos que os modelos não estão isolados, mas sim aninhados uns dentro dos outros. Pegamos imagens, texto e outros atributos, e, utilizando CNN e Fast Text, obtemos embeddings. Em seguida, classificadores são aplicados sobre os embeddings, que geram scores para diferentes classes (tipos de emails, spam, presença de logotipo). Os scores e atributos então entram na floresta de árvores para a decisão final. Classificadores separados nesse esquema permitem uma melhor interpretação dos resultados do sistema e um fine-tuning mais direcionado dos componentes em caso de problemas, em vez de simplesmente alimentar todos os dados brutos nas árvores de decisão.
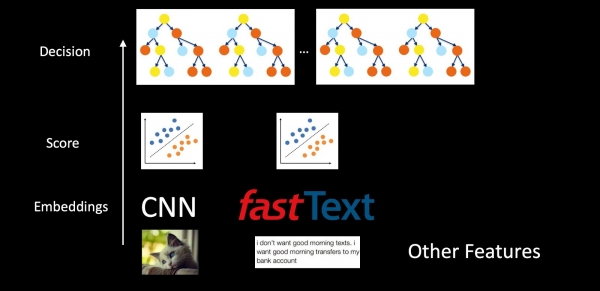
No final, garantimos a continuidade em cada nível. No nível inferior, em CNN e Fast Text, usamos regularização harmônica; para os classificadores do meio, também usamos regularização harmônica e calibração das pontuações para compatibilidade da distribuição de probabilidade. Por sua vez, o boosting das árvores é treinado de forma incremental ou através de Knowledge Distillation.
No geral, dar suporte a um sistema de aprendizado de máquina tão aninhado costuma ser complicado, pois qualquer componente no nível inferior leva à atualização de todo o sistema acima. Contudo, como em nossa configuração cada componente muda minimamente e é compatível com o anterior, todo o sistema pode ser atualizado em partes, sem a necessidade de reencontrar toda a estrutura, o que permite mantê-lo sem um grande overhead.
Deploy
Discutimos a coleta de dados e o fine-tuning de diferentes tipos de modelos, agora vamos ao seu deploy no ambiente de produção.
A/B testing
Como mencionei anteriormente, durante o processo de coleta de dados, geralmente obtemos uma amostra distorcida, a qual torna impossível avaliar o desempenho real da produção do modelo. Portanto, ao implementar o modelo, é imprescindível compará-lo com a versão anterior para entender como realmente as coisas estão, ou seja, realizar testes A/B. De fato, o processo de lançamento e análise dos gráficos é bastante rotineiro e se presta bem a automatização. Liberamos nossos modelos gradualmente para 5%, 30%, 50% e 100% dos usuários, enquanto reunimos todas as métricas disponíveis sobre as respostas do modelo e o feedback dos usuários. Caso haja alguns picos sérios, revertamos automaticamente o modelo, e para os demais casos, após termos um número suficiente de cliques dos usuários, tomamos a decisão de aumentar a porcentagem. Assim, conseguimos levar o novo modelo até 50% dos usuários de forma totalmente automática, e a implementação para todo o público é aprovada por uma pessoa, embora este passo também possa ser automatizado.
No entanto, o processo de testes A/B apresenta oportunidades para otimização. O fato é que qualquer teste A/B é bastante longo (no nosso caso, leva de 6 a 24 horas dependendo da quantidade de feedback), o que o torna bastante caro e com recursos limitados. Além disso, é necessário um percentual bastante elevado de fluxo para o teste, a fim de, essencialmente, acelerar o tempo total do teste A/B (coletar uma amostra estatisticamente significativa para avaliar métricas com uma pequena porcentagem pode levar muito tempo), o que torna o número de slots A/B extremamente limitado. É evidente que precisamos levar ao teste apenas os modelos mais promissores, dos quais, durante o processo de ajuste fino, obtemos bastante ao longo.
Para resolver essa tarefa, treinamos um classificador separado que prevê o sucesso do teste A/B. Para isso, usamos como características a estatística de decisões, Precision, Recall e outras métricas em um conjunto de treinamento, em um conjunto separado e em uma amostra do fluxo. Também comparamos o modelo com o atual em produção, com heurísticas, e levamos em conta a complexidade (Complexity) do modelo. Usando todas essas características, o classificador treinado com o histórico dos testes avalia os modelos candidatos, que no nosso caso são florestas de árvores, e toma a decisão sobre qual deles liberar para o teste A/B.
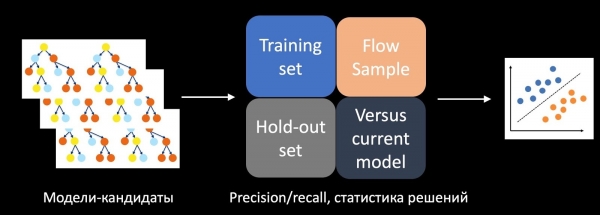
Na implementação, essa abordagem permitiu aumentar várias vezes o número de testes A/B bem-sucedidos.
Testes & monitoramento
Testar e monitorar, estranhamente, não prejudica nossa saúde; pelo contrário, melhora e alivia o estresse. O teste ajuda a prevenir falhas, enquanto o monitoramento permite detectá-las a tempo, minimizando o impacto nos usuários.
Aqui é importante entender que, mais cedo ou mais tarde, seu sistema sempre errará — isso está relacionado ao ciclo de desenvolvimento de qualquer software. No início do desenvolvimento, sempre há muitos bugs até que tudo se estabilize e a fase principal de inovações seja concluída. Mas com o tempo, a entropia se impõe e novos erros surgem — devido à degradação dos componentes ao redor e às mudanças nos dados, sobre as quais já mencionei.
Aqui gostaria de salientar que qualquer sistema de aprendizado de máquina deve ser avaliado em termos de seu benefício ao longo de todo o ciclo de vida. Abaixo, o gráfico mostra um exemplo de como funciona um sistema de detecção de um tipo raro de spam (no gráfico, a linha está próxima de zero). Em uma ocasião, devido a uma característica mal armazenada em cache, o sistema pirou. Como por ironia, não havia monitoramento para detectar ativação anômala, resultando no sistema começar a salvar e-mails na pasta 'spam' no limite da tomada de decisão em grande quantidade. Apesar de corrigir as consequências, o sistema já falhou tantas vezes que não se pagará nem em cinco anos. E isso é um fracasso total em termos do ciclo de vida do modelo.
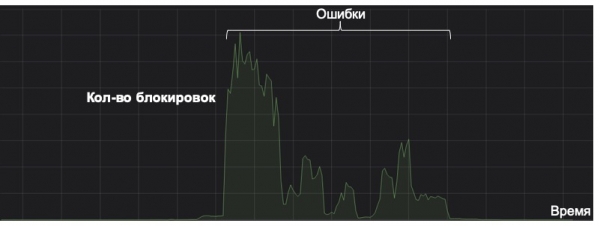
Por isso, uma coisa tão simples como monitoramento pode se tornar crucial na vida do modelo. Além das métricas padrão e óbvias, consideramos a distribuição das respostas e dos scores do modelo, assim como a distribuição dos valores das características chave. Com a divergência KL, podemos comparar a distribuição atual com a histórica ou os valores no teste A/B com o restante do fluxo, permitindo identificar anomalias no modelo e reverter mudanças a tempo.
Na maioria das vezes, lançamos nossas primeiras versões de sistemas usando heurísticas simples ou modelos que, no futuro, utilizamos para monitoramento. Por exemplo, monitorando um modelo NER em comparação com expressões regulares para lojas de comércio eletrônico específicas, e se a cobertura do classificador cair em relação a elas, investigamos as razões. Mais uma aplicação útil das heurísticas!
Resultados
Vamos passar novamente pelos principais pontos do artigo.
- Fibdac. Sempre pensamos no usuário: como ele lidará com nossos erros, como poderá reportá-los. Não devemos esquecer que os usuários não são uma fonte pura de feedback para treinar modelos, e é necessário filtrar isso com a ajuda de sistemas de ML auxiliares. Se não for possível coletar um sinal do usuário, buscamos fontes alternativas de feedback, como sistemas relacionados.
- Aprimoramento. Aqui, o principal é a continuidade, por isso nos baseamos no modelo de produção atual. Treinamos novos modelos de forma que não se diferenciem muito do anterior, usando regularização harmônica e truques semelhantes.
- Deploy. A autoimplantação baseada em métricas reduz significativamente o tempo de implementação de modelos. O monitoramento de estatísticas e a distribuição de decisões, bem como a quantidade de falsos positivos dos usuários, são essenciais para sua tranquilidade e fins de semana produtivos.
Bem, espero que o que você leu ajude a melhorar mais rapidamente seus sistemas de ML, acelerando seu lançamento no mercado e tornando-os mais confiáveis, reduzindo o estresse do trabalho.
Fonte: habr.com
