

Há alguns anos, o Kubernetes no blog oficial do GitHub. Desde então, tornou-se a tecnologia padrão para a implementação de serviços. Hoje, o Kubernetes gerencia uma parte significativa dos serviços internos e públicos. À medida que nossos clusters cresceram e as exigências de desempenho se tornaram mais rigorosas, começamos a notar que em alguns serviços no Kubernetes surgiam esporadicamente atrasos que não podiam ser explicados pela carga do aplicativo.
Na prática, nas aplicações ocorre um tipo de atraso de rede aleatório de até 100 ms ou mais, o que resulta em timeouts ou tentativas de reconexão. Esperava-se que os serviços pudessem responder a solicitações muito mais rapidamente que 100 ms. Mas isso não é possível se a própria conexão leva esse tempo. Observamos também requisições MySQL muito rápidas, que deveriam levar milissegundos, e o MySQL realmente levantava em milissegundos, mas do ponto de vista do aplicativo que solicita, a resposta levava 100 ms ou mais.
Logo ficou claro que o problema surgia apenas na conexão com o nó Kubernetes, mesmo quando a chamada vinha de fora do Kubernetes. A maneira mais simples de reproduzir o problema é em um teste , que é executado a partir de qualquer host interno, testa o serviço Kubernetes em uma porta específica e registra esporadicamente uma grande latência. Neste artigo, veremos como conseguimos rastrear a causa desse problema.
Eliminando complexidade desnecessária na cadeia para a falha
Reproduzindo o mesmo exemplo, queríamos focar o problema e remover camadas desnecessárias de complexidade. Inicialmente, havia muitos elementos na conexão entre o Vegeta e os pods no Kubernetes. Para identificar um problema de rede mais profundo, era necessário excluir alguns deles.
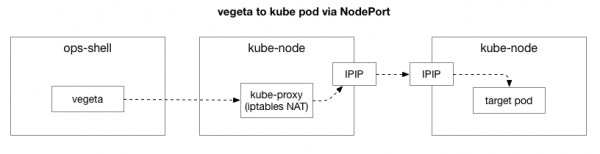
O cliente (Vegeta) cria uma conexão TCP com qualquer nó no cluster. O Kubernetes funciona como uma rede sobreposta (sobre a rede existente do data center), que utiliza , ou seja, encapsula pacotes IP da rede sobreposta dentro de pacotes IP do data center. Ao se conectar ao primeiro nó, ocorre uma tradução de endereços de rede (NAT) com rastreamento de estado para transformar o endereço IP e a porta do nó do Kubernetes em um endereço IP e porta na rede de sobreposição (em particular, do pod com o aplicativo). Para os pacotes recebidos, a sequência reversa de ações é executada. Trata-se de um sistema complexo com muitas condições e múltiplos elementos que estão em constante atualização e mudança à medida que serviços são implantados e movidos.
Utilitário tcpdump no teste do Vegeta, gera uma latência durante o handshake TCP (entre SYN e SYN-ACK). Para eliminar essa complexidade excessiva, pode-se utilizar hping3 para pings simples com pacotes SYN. Checamos se há latência na resposta do pacote e, em seguida, encerramos a conexão. Podemos filtrar os dados, incluindo apenas pacotes com mais de 100 ms e obter uma versão mais simples para reproduzir o problema do que um teste completo de camada de rede 7 no Vegeta. Aqui estão os pings do nó do Kubernetes usando TCP SYN/SYN-ACK na "porta do nó" do serviço (30927) com um intervalo de 10 ms, filtrados pelas respostas mais lentas:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
É possível fazer uma primeira observação imediatamente. Pelos números de sequência e pelos temporizadores, vê-se que não se tratam de congestionamentos únicos. A latência se acumula frequentemente e, eventualmente, é processada.
Em seguida, queremos descobrir quais componentes podem estar envolvidos na causa do congestionamento. Seria algum dos centenas de regras do iptables no NAT? Ou haveria problemas com o tunelamento IPIP na rede? Uma maneira de verificar isso é examinar cada etapa do sistema, excluindo-a. O que aconteceria se removêssemos o NAT e a lógica do firewall, deixando apenas a parte do IPIP:
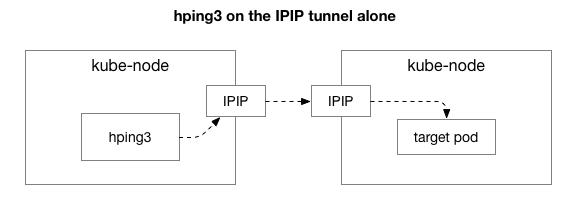
Felizmente, o Linux permite acesso fácil diretamente à camada de sobreposição IP, caso a máquina esteja na mesma rede:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
De acordo com os resultados, o problema ainda persiste! Isso exclui iptables e NAT. Então, o problema está no TCP? Vamos ver como está o ping ICMP comum:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
Os resultados mostram que o problema não desapareceu. Talvez seja um túnel IPIP? Vamos simplificar ainda mais o teste:
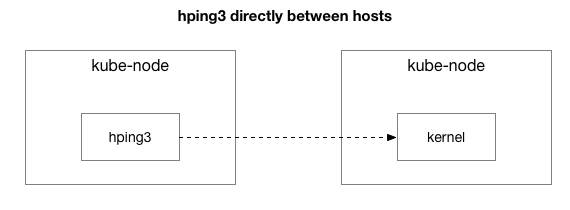
Todos os pacotes estão sendo enviados entre esses dois hosts?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
Simplificamos a situação para dois nós Kubernetes enviando pacotes um ao outro, mesmo um ping ICMP. Eles ainda veem latência se o host de destino é 'ruim' (alguns são piores que outros).
Agora, a última pergunta: por que a latência ocorre apenas nos servidores kube-node? E isso ocorre quando o kube-node é o remetente ou o destinatário? Felizmente, isso também é relativamente fácil de descobrir, enviando um pacote de um host fora do Kubernetes, mas com o mesmo 'conhecido ruim' destinatário. Como vemos, o problema não desapareceu:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Então, faremos as mesmas solicitações do kube-node de origem anterior para o host externo (o que exclui o host de origem, pois o ping inclui como componente RX e TX):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 estatística do hping ---
 22352 pacotes transmitidos, 22350 pacotes recebidos, 1% de perda de pacotes
 tempo de ida e volta min/média/máx = 0.2/7.6/1010.6 ms
Ao analisar os pacotes capturados com atraso, obtivemos algumas informações adicionais. Em particular, o remetente (abaixo) vê esse timeout, enquanto o destinatário (acima) não vê — ver a coluna Delta (em segundos):
Além disso, se observarmos a diferença na ordem dos pacotes TCP e ICMP (pelo número de sequência) no lado do destinatário, os pacotes ICMP chegam sempre na mesma sequência em que foram enviados, mas com diferentes tempos. Ao mesmo tempo, os pacotes TCP às vezes se alternam, e parte deles fica presa. Em particular, se examinarmos as portas dos pacotes SYN, do lado do remetente eles chegam em ordem, mas do lado do destinatário não.
Há uma sutil diferença em como dos servidores modernos (como em nosso data center) processam pacotes contendo TCP ou ICMP. Quando um pacote chega, o adaptador de rede 'hash' ele por conexão, ou seja, tenta dividir as conexões em filas e enviar cada fila para um núcleo separada do processador. Para TCP, esse hash inclui tanto o endereço IP de origem quanto o de destino e a porta. Em outras palavras, cada conexão é hashada (potencialmente) de maneira diferente. Para ICMP, apenas os endereços IP são hashados, pois não há portas.
Outra nova observação: durante esse período, vemos atrasos no ICMP em todas as comunicações entre dois hosts, mas não no TCP. Isso nos indica que a causa está provavelmente relacionada ao hashing das filas RX: quase certamente o congestionamento ocorre no processamento dos pacotes RX, e não no envio das respostas.
Isso exclui a possibilidade de que a causa esteja no envio dos pacotes. Agora sabemos que o problema de processamento de pacotes está do lado da recepção em alguns servidores kube-node.
Investigando o processamento de pacotes no núcleo Linux
Para entender por que o problema ocorre no receptor em alguns servidores kube-node, vamos ver como o núcleo Linux processa os pacotes.
Voltando à implementação tradicional mais simples, a placa de rede recebe um pacote e envia para o núcleo Linux, informando que há um pacote que precisa ser processado. O núcleo interrompe outra tarefa, muda o contexto para o manipulador de interrupção, processa o pacote e depois retorna às tarefas atuais.
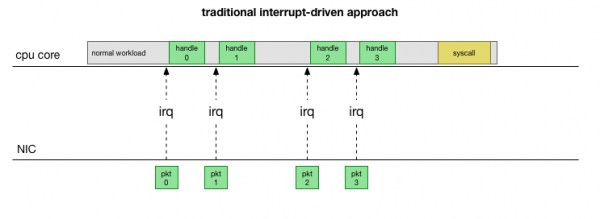
A troca de contexto acontece lentamente: a latência pode ter sido imperceptível em placas de rede de 10 megabits nos anos 90, mas em placas modernas de 10G com uma largura de banda máxima de 15 milhões de pacotes por segundo, cada núcleo de um pequeno servidor de oito núcleos pode ser interrompido milhões de vezes por segundo.
Para evitar o processamento constante de interrupções, há muitos anos foi adicionado ao Linux : a API de rede utilizada por todos os drivers modernos para melhorar o desempenho em altas velocidades. Em velocidades mais baixas, o núcleo ainda recebe interrupções da placa de rede de maneira tradicional. Assim que um número suficiente de pacotes que ultrapassa o limite chega, o núcleo desativa as interrupções e, em vez disso, começa a interrogar o adaptador de rede e a coletar pacotes em lotes. O processamento ocorre em softirq, ou seja, no após chamadas de sistema e interrupções de hardware, quando o núcleo (ao contrário do espaço do usuário) já está executando.
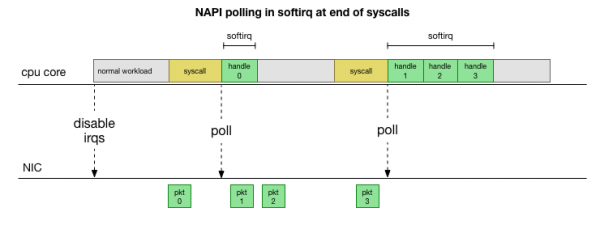
Isso é muito mais rápido, mas causa outro problema. Se há muitos pacotes, todo o tempo é gasto processando pacotes da placa de rede, e os processos do espaço do usuário não conseguem esvaziar efetivamente essas filas (lendo de conexões TCP, etc.). No final, as filas se enchem, e começamos a descartar pacotes. Tentando encontrar um equilíbrio, o núcleo estabelece um orçamento para o número máximo de pacotes processados no contexto de softirq. Assim que esse orçamento é excedido, um thread separado é ativado ksoftirqd (você verá um deles em ps para cada núcleo), que processa esses softirq fora do caminho normal de syscall/interrupção. Esse thread é agendado com o planejador de processos padrão, que tenta distribuir os recursos de maneira justa.
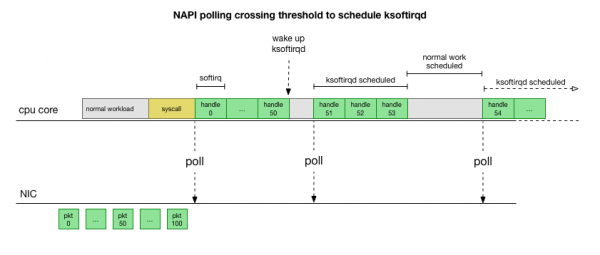
Estudando como o núcleo processa pacotes, pode-se notar que há uma certa probabilidade de ocorrer congestionamentos. Se as chamadas de softirq chegam com menos frequência, os pacotes terão que aguardar algum tempo na fila RX da placa de rede para serem processados. Isso pode ocorrer devido a alguma tarefa que está bloqueando o núcleo do processador, ou algo mais que impede o núcleo de iniciar os softirq.
Restringimos o processamento ao núcleo ou método
As atrasos de softirq são apenas uma suposição por enquanto. Mas faz sentido, e sabemos que estamos observando algo muito parecido. Portanto, o próximo passo é confirmar essa teoria. E se ela se confirmar, vamos encontrar a causa dos atrasos.
Voltando aos nossos pacotes lentos:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Como discutido anteriormente, esses pacotes ICMP são agrupados em uma fila na NIC RX e processados por um único núcleo de CPU. Se quisermos entender como o Linux funciona, é útil saber onde (em qual núcleo de CPU) e como (softirq, ksoftirqd) esses pacotes são processados, para rastrear o processo.
Agora é hora de usar ferramentas que permitem monitorar em tempo real o funcionamento do núcleo do Linux. Aqui usamos . Este conjunto de ferramentas permite escrever pequenos programas em C que interceptam funções arbitrárias no núcleo e armazenam eventos em um programa Python de espaço do usuário, que pode processá-los e retornar os resultados. Hooks para funções arbitrárias no núcleo são complicados, mas a utilidade é projetada para máxima segurança e destinada a rastrear exatamente esses problemas de produção que são difíceis de reproduzir em um ambiente de teste ou desenvolvimento.
O plano aqui é simples: sabemos que o núcleo processa esses pings ICMP, então vamos colocar um hook na função do núcleo , que aceita um pacote ICMP de "echo request" e inicia o envio de uma resposta ICMP "echo response". Podemos identificar o pacote pelo incremento do número icmp_seq, que mostra hping3 acima.
Código parece complexo, mas não é tão assustador quanto parece. A função icmp_echo transmite struct sk_buff *skb: é um pacote com o pedido "echo request". Podemos rastreá-lo, extrair a sequência echo.sequence (que se correlaciona com icmp_seq do hping3 acima), e enviá-la para o espaço do usuário. Também é conveniente capturar o nome do processo atual / identificador. Abaixo estão os resultados que vemos diretamente durante o processamento dos pacotes pelo núcleo:
TGID    PID     NOME DO PROCESSO    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Aqui vale a pena notar que, no contexto softirq processos que realizaram chamadas de sistema aparecerão como "processos", embora na verdade o núcleo esteja processando pacotes de forma segura no contexto do núcleo.
Com essa ferramenta, conseguimos estabelecer uma conexão entre processos específicos e pacotes específicos que apresentam latência em hping3. Fazemos uma simples grep captura para determinados valores icmp_seq. Os pacotes correspondentes aos valores icmp_seq acima mencionados foram marcados junto com seu RTT, que observamos acima (os valores RTT esperados dos pacotes que filtramos devido a RTT de menos de 50 ms estão entre parênteses):
TGID    PID     NOME DO PROCESSO    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Os resultados nos dizem várias coisas. Primeiro, todos esses pacotes são processados no contexto ksoftirqd/11. Isso significa que, para este par específico de máquinas, os pacotes ICMP foram hashados para o núcleo 11 no lado receptor. Também vemos que em cada congestionamento há pacotes que são processados no contexto da chamada de sistema cadvisor. Então ksoftirqd assume a tarefa e processa a fila acumulada: exatamente a quantidade de pacotes que se acumulou após cadvisor.
O fato de que sempre há um cadvisorfuncionando imediatamente antes disso implica sua participação no problema. Por ironia, a finalidade do é "analisar o uso de recursos e as características de desempenho dos contêineres em execução", e não causar esse problema de desempenho.
Assim como em outros aspectos do funcionamento dos containers, esta é uma ferramenta extremamente avançada, da qual se pode esperar problemas de desempenho em algumas circunstâncias imprevistas.
O que exatamente o cadvisor faz que causa lentidão na fila de pacotes?
Agora temos uma boa compreensão de como a falha ocorre, qual processo a provoca e em qual CPU. Observamos que, devido a um bloqueio rígido, o núcleo Linux não consegue agendar os processos a tempo. ksoftirqd. E vemos que os pacotes são processados no contexto cadvisor. Faz sentido supor que cadvisor inicia uma syscall lenta, após a qual todos os pacotes acumulados durante esse tempo são processados:
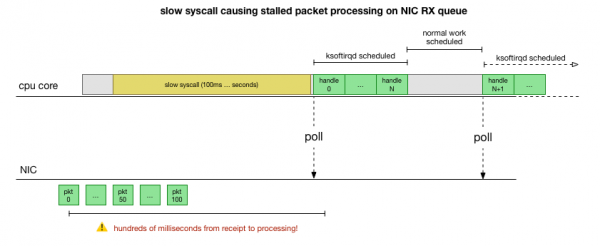
Essa é a teoria, mas como podemos testá-la? O que podemos fazer é monitorar o trabalho do núcleo da CPU durante todo esse processo, encontrar o ponto em que ocorre o excesso no orçamento de pacotes e ativa-se o ksoftirqd, e então olhar um pouco antes — o que exatamente estava sendo executado no núcleo da CPU imediatamente antes desse momento. É como se fizesse um raio-X da CPU a cada poucos milissegundos. Ele parecerá mais ou menos assim:
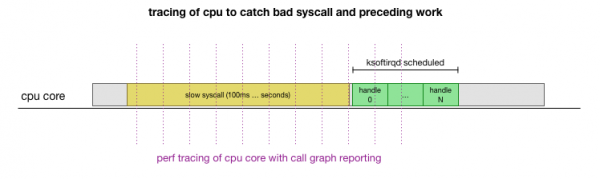
Felizmente, tudo isso pode ser feito com ferramentas existentes. Por exemplo, verifica com uma periodicidade definida o núcleo da CPU especificado e pode gerar um gráfico de chamadas do sistema em funcionamento, abrangendo tanto o espaço do usuário quanto o núcleo Linux. Podemos pegar essa gravação e processá-la usando um pequeno fork do programa de Brendan Gregg, que mantém a ordem da rastreabilidade da pilha. Podemos salvar rastreios da pilha de uma linha a cada 1 ms e, em seguida, destacar e salvar uma amostra dos 100 milissegundos antes de entrar na rastreabilidade ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Aqui estão os resultados:
(centenas de rastros que parecem semelhantes)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Aqui existem muitas informações, mas o principal é que encontramos o padrão "cadvisor antes de ksoftirqd", que já vimos anteriormente no rastreador ICMP. O que isso significa?
Cada linha representa um rastreamento da CPU em um determinado momento. Cada chamada no stack é separada por ponto e vírgula. No meio das linhas, vemos a chamada de syscall: read(): .... ;do_syscall_64;sys_read; .... Assim, o cadvisor passa muito tempo em chamadas de sistema read(), relacionadas a funções mem_cgroup_* (parte superior da pilha de chamadas/fim da linha).
No rastreamento das chamadas, não é fácil ver o que está sendo lido, então vamos executar strace e observar o que o cadvisor faz, e encontrar chamadas de sistema que demoram mais de 100 ms:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Tempo limite)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Como era de se esperar, aqui vemos chamadas lentas read(). A partir do conteúdo das operações de leitura e do contexto mem_cgroup é visível que essas chamadas read() referem-se ao arquivo memory.stat, que mostra o uso de memória e as restrições do cgroup (tecnologia de isolamento de recursos em Docker). A ferramenta cadvisor consulta esse arquivo para obter informações sobre o uso de recursos para os containers. Vamos verificar se é o kernel ou cadvisor que está fazendo algo inesperado:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat >/dev/null
real 0m0.153s
user 0m0.000s
sys 0m0.152s
theojulienne@kube-node-bad ~ $
Agora podemos reproduzir o bug e entendemos que o kernel Linux enfrenta uma patologia.
Por que a operação de leitura é tão lenta?
Neste ponto, é muito mais fácil encontrar relatos de outros usuários sobre problemas semelhantes. Acontece que, no rastreador do cadvisor, esse bug foi relatado como um , apenas ninguém percebeu que o atraso também se reflete aleatoriamente na pilha de rede. De fato, foi notado que o cadvisor consumia mais tempo de CPU do que o esperado, mas isso não foi muito levado a sério, já que nossos servidores têm muitos recursos de CPU, e assim o problema não foi investigado a fundo.
O problema é que os grupos de controle (cgroups) contabilizam o uso de memória dentro do namespace (container). Quando todos os processos desse cgroup terminam, o Docker libera o grupo de controle de memória. No entanto, ‘memória’ não é apenas a memória do processo. Embora a própria memória dos processos não esteja mais sendo utilizada, o kernel ainda aloca conteúdo cacheado, como dentries e inodes (metadados de diretórios e arquivos), que ficam armazenados no cgroup de memória. Da descrição do problema:
cgroups zumbis: grupos de controle que não têm processos e foram removidos, mas para os quais ainda assim foi alocada memória (no meu caso, do cache de dentry, mas também pode ser alocada do cache de páginas ou tmpfs).
A verificação do kernel de todas as páginas no cache ao liberar o cgroup pode ser muito lenta, por isso foi escolhido um processo preguiçoso: aguardar até que essas páginas sejam novamente solicitadas, e somente então, quando a memória realmente for necessária, limpar finalmente o cgroup. Até esse momento, o cgroup ainda é contabilizado na coleta de estatísticas.
Em termos de desempenho, eles sacrificaram memória em prol da performance: acelerando a limpeza inicial ao deixar um pouco de memória cacheada. Isso é aceitável. Quando o núcleo utiliza a última parte da memória cacheada, a cgroup acaba sendo limpa, então isso não pode ser chamado de 'vazamento'. Infelizmente, a implementação específica do mecanismo de busca memory.stat nesta versão do núcleo (4.9), em combinação com a enorme quantidade de memória em nossos servidores, resulta em que para restaurar os últimos dados cacheados e limpar os cgroups zumbis, leva-se muito mais tempo.
Acontece que, em alguns dos nossos nós, havia tantos cgroups zumbis que a leitura e a latência ultrapassavam um segundo.
Uma maneira de contornar o problema do cadvisor é liberar imediatamente os caches de dentries/inodes em todo o sistema, o que elimina imediatamente a latência de leitura, bem como a latência na rede do host, uma vez que a remoção do cache inclui as páginas cacheadas dos cgroups zumbis, que também são liberadas. Isso não é uma solução, mas confirma a causa do problema.
Descobrimos que em versões mais recentes do núcleo (4.19+) houve melhorias no desempenho da chamada memory.stat, assim a migração para esse núcleo resolvia o problema. Ao mesmo tempo, tínhamos ferramentas para detectar nós problemáticos em clusters Kubernetes, seu desligamento elegante e reinicialização. Pesquisamos todos os clusters, encontramos nós com latência suficientemente alta e os reinicializamos. Isso nos deu tempo para atualizar o sistema operacional nos outros servidores.
Resumindo
Como esse bug interrompia o processamento das filas NIC RX por centenas de milissegundos, gerava simultaneamente alta latência em conexões curtas e latência no meio da conexão, por exemplo, entre as consultas MySQL e os pacotes de resposta.
Compreender e manter o desempenho dos sistemas mais fundamentais, como o Kubernetes, é crucial para a confiabilidade e velocidade de todos os serviços baseados nele. Todas as sistemas executados se beneficiam das melhorias de desempenho do Kubernetes.
Fonte: habr.com
