

O desenvolvimento industrial de sistemas de software exige grande atenção à resistência do produto final, bem como a uma resposta rápida a falhas e interrupções, caso ocorram. A monitoração, claro, ajuda a reagir a falhas e interrupções de forma mais eficaz e rápida, mas não é suficiente. Primeiro, é muito difícil acompanhar um grande número de servidores – é necessário um grande número de pessoas. Em segundo lugar, é preciso entender bem como o aplicativo funciona para prever seu estado. Portanto, são necessárias muitas pessoas que conheçam bem os sistemas que desenvolvemos, suas métricas e características. Suponha que, mesmo que encontremos um número suficiente de pessoas dispostas a fazer isso, ainda requer muito tempo para treiná-las.
O que fazer? Aqui, a inteligência artificial vem em nosso socorro. Este artigo abordará (predictive maintenance). Esta abordagem está se tornando cada vez mais popular. Muitos artigos foram escritos sobre isso, inclusive no Habr. Grandes empresas estão utilizando essa abordagem para manter a funcionalidade de seus servidores. Após estudar uma grande quantidade de artigos, decidimos tentar aplicar essa abordagem. O que resultou disso?
Introdução
Um sistema de software desenvolvido, mais cedo ou mais tarde, entra em operação. É importante para o usuário que o sistema funcione sem interrupções. Se ocorrer uma situação extraordinária, ela deve ser resolvida com o mínimo de atrasos.
Para simplificar o suporte técnico do sistema de software, especialmente se houver muitos servidores, geralmente são utilizados programas de monitoração que coletam métricas do sistema de software em funcionamento, possibilitam diagnosticar seu estado e ajudam a determinar o que causou a falha. Esse processo é chamado de monitoração do sistema de software.
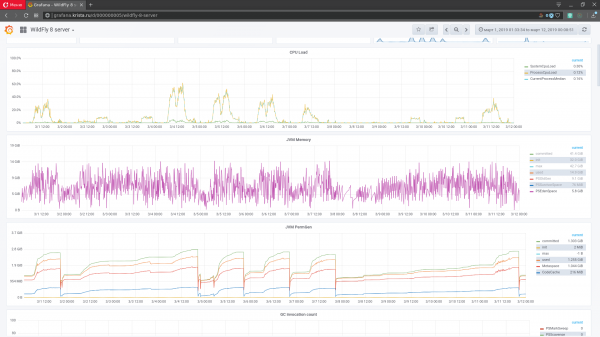
Figura 1. Interface para monitoramento grafana
Métricas são diversos indicadores de um sistema de software, do ambiente em que ele opera ou da máquina computacional física na qual o sistema foi executado, com uma marca temporal do momento em que as métricas foram obtidas. Na análise estática, os dados das métricas são chamados de séries temporais. Para monitorar o estado do sistema de software, as métricas são exibidas na forma de gráficos: no eixo X – tempo, e no eixo Y – valores (figura 1). Um sistema de software em funcionamento pode gerar milhares de métricas (de cada nó). Elas formam um espaço de métricas (séries temporais multidimensionais).
Como em sistemas de software complexos são coletadas muitas métricas, a monitorização manual se torna uma tarefa difícil. Para reduzir a quantidade de dados analisados pelo administrador, as ferramentas de monitoramento contam com recursos para detectar automaticamente possíveis problemas. Por exemplo, é possível configurar um gatilho que dispara quando o espaço em disco livre diminui até um limite especificado. Também é possível diagnosticar automaticamente a parada do servidor ou uma desaceleração crítica no desempenho. Na prática, as ferramentas de monitoramento lidam bem com a detecção de falhas já ocorridas ou identificação de sintomas simples de falhas futuras, mas, no geral, a previsão de uma possível falha continua sendo um desafio. A previsão manual através da análise de métricas requer a participação de especialistas qualificados. É pouco produtivo. A maioria das falhas em potencial pode passar despercebida.
Recentemente, entre grandes empresas de TI dedicadas ao desenvolvimento de software, a chamada manutenção preditiva de sistemas de software tem ganhado cada vez mais popularidade. A essência desse enfoque consiste em encontrar falhas que levam à degradação do sistema em estágios iniciais, antes de sua falha, utilizando inteligência artificial. Esse enfoque não исключa completamente a monitorização manual do sistema. Ele é um suporte ao processo de monitoramento como um todo.
A principal ferramenta para a implementação da manutenção preditiva é a tarefa de busca de anomalias nas séries temporais, pois ao surgir uma anomalia nos dados, há uma alta probabilidade de que, após algum tempo ocorrerá uma falha ou interrupção. Uma anomalia é um desvio nos indicadores de um sistema de software, como a identificação de degradação na velocidade de execução de um tipo de solicitação ou a redução do número médio de atendimentos durante um nível constante de sessões de clientes.
A tarefa de detectar anomalias em sistemas de software tem suas especificidades. Na verdade, para cada sistema de software é necessário desenvolver ou aprimorar os métodos existentes, pois a detecção de anomalias depende muito dos dados nos quais é realizada, e os dados dos sistemas de software variam bastante dependendo das ferramentas de implementação do sistema, até mesmo do tipo de máquina computacional em que está sendo executado.
Métodos de detecção de anomalias na previsão de falhas de sistemas de software
Antes de mais nada, vale dizer que a ideia de prever falhas foi inspirada pelo artigo . Para verificar a eficácia da abordagem de detecção automática de anomalias, foi escolhida a sistema de software "Web-Consolidation", que é um dos projetos da empresa NPO "Krista". Anteriormente, a monitoramento manual era feita com base nas métricas obtidas. Como o sistema é bastante complexo, uma grande quantidade de métricas é coletada: indicadores JVM (carga do coletor de lixo), indicadores do sistema operacional sob o qual o código é executado (memória virtual, % de carga da CPU), indicadores de rede (carga da rede), do servidor em si (carga da CPU, memória), métricas do wildfly e métricas próprias do aplicativo em todos os subsistemas críticos.
Todas as métricas são extraídas do sistema utilizando graphite. Inicialmente, foi utilizado o banco whisper como solução padrão para grafana, mas com o crescimento da base de clientes, graphite não conseguiu mais atender, esgotando a capacidade de transferência da subsistema de armazenamento do DC. Após isso, foi tomada a decisão de buscar uma solução mais eficiente. A escolha recaiu sobre , o que permitiu reduzir significativamente a carga na subsistema de armazenamento e diminuir de cinco a seis vezes o espaço em disco ocupado. Abaixo está apresentada a diagrama do mecanismo de coleta de métricas utilizando graphite+clickhouse (Figura 2).
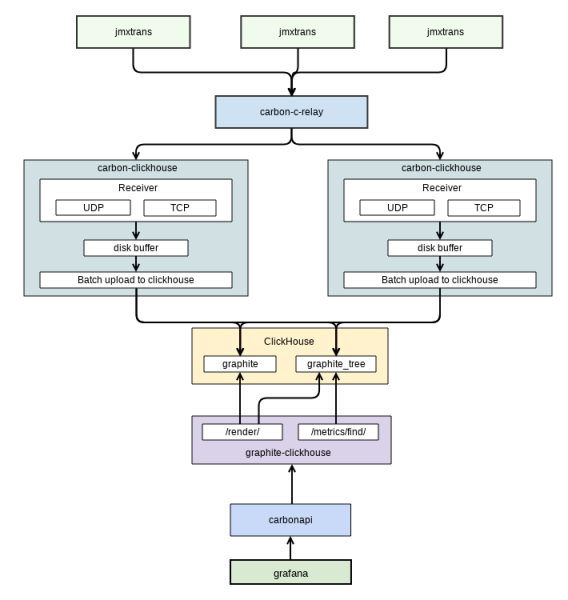
Figura 2. Diagrama da coleta de métricas
O diagrama foi retirado da documentação interna. Nele está mostrado o intercâmbio de dados entre o grafana (a interface de usuário para monitoramento que utilizamos) e o graphite. A coleta de métricas do aplicativo é realizada por um software separado – . Ele também as armazena no graphite.
O sistema de "Web-Consolidação" possui várias particularidades que geram problemas na previsão de falhas:
- frequentemente ocorrem mudanças de tendência. Para este sistema de software, diferentes versões são lançadas. Cada uma delas traz alterações na parte programática do sistema. Assim, os desenvolvedores impactam diretamente as métricas deste sistema e podem causar mudanças de tendência;
- a particularidade da implementação, bem como os objetivos dos usuários deste sistema frequentemente provocam anomalias sem degradação anterior;
- a porcentagem de anomalias em relação a todo o conjunto de dados é pequena (< 5%);
- podem ocorrer interrupções na obtenção de métricas do sistema. Em alguns breves períodos de tempo, o sistema de monitoramento não consegue coletar as métricas. Por exemplo, se o servidor estiver sobrecarregado. Para o treinamento da rede neural, isso é crítico. Surge a necessidade de preencher as lacunas sinteticamente;
- Casos com anomalias frequentemente são relevantes apenas para um número/mês/tempo específico (sazonalidade). Este sistema possui um regulamento claro sobre seu uso pelos usuários. Assim, as métricas são relevantes apenas para um momento específico. O sistema pode ser utilizado não continuamente, mas apenas em determinados meses: seletivamente dependendo do ano. Há situações em que o mesmo comportamento das métricas em um caso pode levar à falha do sistema de software, enquanto em outro não.
Para começar, foram analisados métodos de detecção de anomalias nos dados de monitoramento de sistemas de software. Em artigos sobre este tema, com porcentagens baixas de anomalias em relação ao restante do conjunto de dados, geralmente é recomendado o uso de redes neurais.
A lógica principal para buscar anomalias utilizando dados de redes neurais está ilustrada na figura 3:
Figura 3. Busca de anomalias utilizando rede neural
No resultado da previsão ou da restauração da janela do fluxo atual de métricas, calcula-se a discrepância em relação ao que foi obtido de um sistema de software em funcionamento. Caso haja uma grande diferença entre as métricas obtidas do sistema de software e da rede neural, pode-se concluir sobre a anomalia do trecho de dados atual. Surge uma série de problemas para o uso de redes neurais:
- para que funcione corretamente em modo de streaming, os dados para o treinamento dos modelos de redes neurais devem incluir apenas dados 'normais';
- é necessário ter um modelo atualizado para uma detecção correta. Mudanças de tendência e sazonalidade nas métricas podem causar um grande número de alarmes falsos no modelo. Para sua atualização, é preciso definir claramente o momento em que o modelo se torna obsoleto. Se o modelo for atualizado muito tarde ou muito cedo, provavelmente resultará em um grande número de alarmes falsos.
Além disso, não se deve esquecer da busca e prevenção da ocorrência frequente de alarmes falsos. Presume-se que estes surgirão mais frequentemente em situações anômalas. No entanto, eles também podem ser consequência de falhas da rede neural devido à insuficiência de seu treinamento. É necessário minimizar o número de alarmes falsos do modelo. Caso contrário, previsões erradas consumirão muito tempo do administrador, que deveria ser dedicado à verificação do sistema. Tarde ou cedo, isso acabará resultando em o administrador simplesmente deixar de reagir a um sistema de monitoramento 'paranoico'.
Rede neural recorrente
Para a detecção de anomalias em séries temporais, pode-se aplicar com memória LSTM. O problema é que ela só pode ser aplicada a séries temporais previsíveis. No nosso caso, nem todas as métricas são previsíveis. A tentativa de aplicar RNN LSTM a uma série temporal é apresentada na figura 4.
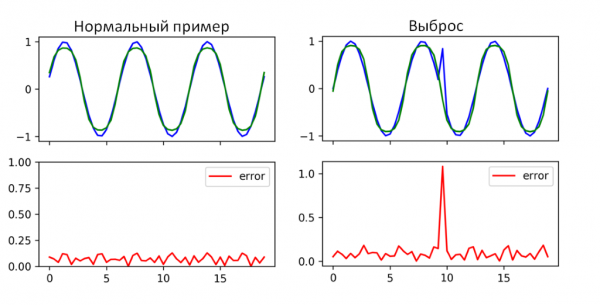
Figura 4. Exemplo de funcionamento de uma rede neural recorrente com células de memória LSTM
Como mostrado na Figura 4, a RNN LSTM conseguiu detectar anomalias neste intervalo de tempo. Onde o resultado apresenta um alto erro de previsão (erro médio), realmente houve uma anomalia nas métricas. Usar apenas uma RNN LSTM será claramente insuficiente, pois ela se aplica a um pequeno número de métricas. Pode-se utilizar como um método auxiliar na busca de anomalias.
Autoencoder para previsão de falhas
– essencialmente uma rede neural artificial. A camada de entrada é o encoder, a camada de saída é o decoder. A desvantagem de todas as redes neurais desse tipo é que elas localizam mal as anomalias. Foi escolhida a arquitetura de autoencoder síncrono.
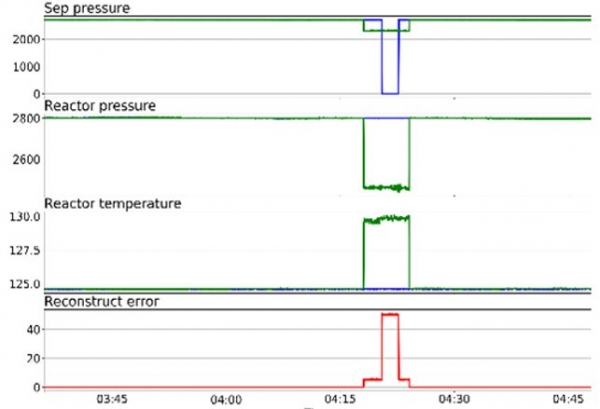
Figura 5. Exemplo de funcionamento do autoencoder
Os autoencoders são treinados em dados normais e, em seguida, encontram algo anômalo nos dados apresentados ao modelo. Exatamente o que é necessário para esta tarefa. Agora resta apenas escolher qual dos autoencoders se adequa a esta tarefa. A forma arquitetonicamente mais simples de um autoencoder é uma rede neural feedforward, que se assemelha muito a (multilayer perceptron, MLP), com uma camada de entrada, uma camada de saída e uma ou mais camadas ocultas que as conectam.
No entanto, as diferenças entre autoencoders e MLP estão no fato de que, no autoencoder, a camada de saída tem o mesmo número de nós que a camada de entrada, e que, em vez de aprender a prever um valor alvo Y dado a entrada X, o autoencoder aprende a reconstruir seu próprio X. Portanto, os autoencoders são modelos de aprendizado não supervisionados.
A tarefa do autoencoder é encontrar os índices temporais r0 … rn que correspondem aos elementos anômalos no vetor de entrada X. Este efeito é alcançado através da busca do erro quadrático.
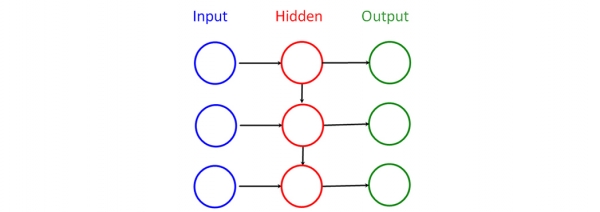
Figura 6. Autoencoder síncrono
Foi escolhida a . Suas vantagens: possibilidade de uso de modo de processamento em fluxo e um número relativamente menor de parâmetros da rede neural em relação a outras arquiteturas.
Mecanismo para minimização de alarmes falsos
Devido à ocorrência de várias situações imprevistas, bem como à possível falta de treinamento da rede neural, foi tomada a decisão de desenvolver um mecanismo para minimizar falsos positivos no modelo de detecção de anomalias em desenvolvimento. Este mecanismo é baseado em uma base de padrões que é classificada por um administrador.
(Algoritmo DTW, do inglês dynamic time warping) permite encontrar a correspondência ideal entre sequências temporais. Foi aplicado pela primeira vez no reconhecimento de fala: utilizado para determinar como dois sinais de voz representam a mesma frase proferida. Posteriormente, seu uso foi encontrado em outras áreas.
O princípio básico da minimização de falsos positivos é a coleta de uma base de referências por meio de um operador que classifica casos suspeitos detectados por redes neurais. A seguir, ocorre uma comparação entre a referência classificada e o caso identificado pelo sistema, e se conclui se o caso é um falso positivo ou se leva a uma falha. É exatamente para a comparação de duas séries temporais que o algoritmo DTW é utilizado. A classificação continua sendo a principal ferramenta de minimização. Presume-se que, após coletar uma grande quantidade de casos de referência, o sistema começará a solicitar menos ao operador devido à semelhança da maioria dos casos e à ocorrência de semelhantes.
Como resultado dos métodos de redes neurais descritos acima, um programa experimental foi desenvolvido para prever falhas no sistema 'Web-Consolidação'. O objetivo desse programa foi, utilizando o arquivo existente dos dados de monitoramento e informações sobre falhas já ocorridas, avaliar a competência dessa abordagem para os nossos sistemas de software. O esquema de funcionamento do programa é apresentado abaixo, na figura 7.
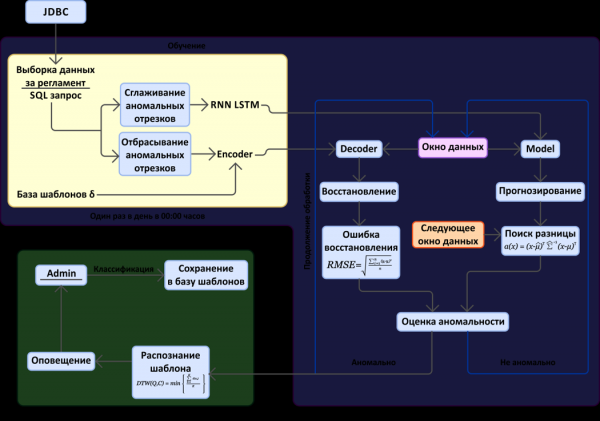
Figura 7. Esquema de previsão de falhas com base na análise do espaço métrico
No esquema, podem ser identificados dois blocos principais: a localização de segmentos anômalos no fluxo de dados de monitoramento (métricas) e o mecanismo de minimização de falsos positivos. Nota: para fins experimentais, os dados são obtidos através de uma conexão JDBC a uma base de dados na qual são armazenados pelo graphite.
A seguir está a interface resultante do desenvolvimento do sistema de monitoramento (Figura 8).
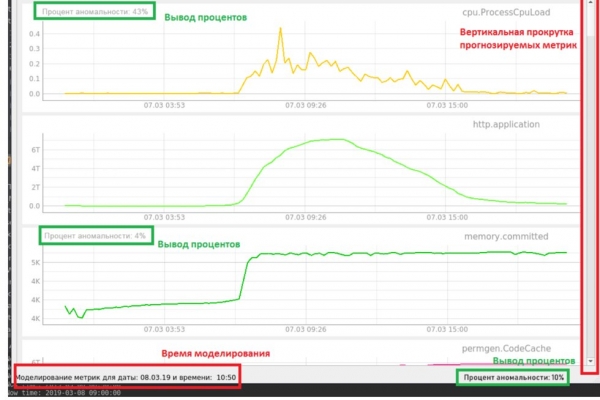
Figura 8. Interface do sistema experimental de monitoramento
Na interface, é exibido o percentual de anomalia das métricas recebidas. No nosso caso, a obtenção é simulada. Já temos todos os dados de várias semanas e os carregamos gradualmente para verificar o caso de anomalia que leva à falha. Na barra de status inferior, é exibido o percentual total de anomalia dos dados no momento, que é determinado por um autoencodificador. Também para as métricas projetadas, é exibido um percentual separado, que é calculado pela RNN LSTM.
Exemplo de detecção de anomalia nos indicadores de CPU usando a rede neural RNN LSTM (Figura 9).
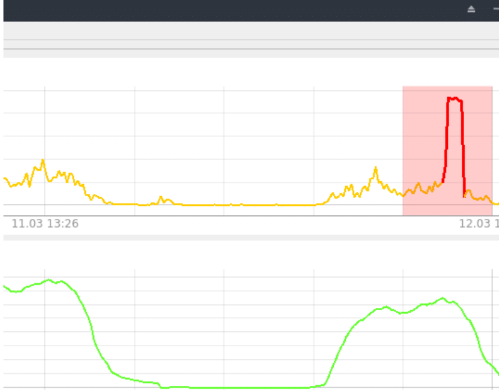
Figura 9. Detecção RNN LSTM
Um caso bastante simples, na verdade uma anomalia comum, mas que leva à falha do sistema, foi detectado com sucesso pela RNN LSTM. O índice de anomalia neste intervalo de tempo varia de 85 a 95%, tudo acima de 80% (limite definido experimentalmente), é considerado uma anomalia.
Exemplo de detecção de anomalia quando o sistema não conseguiu inicializar após a atualização. Essa situação é detectada pelo autoencodificador (Figura 10).
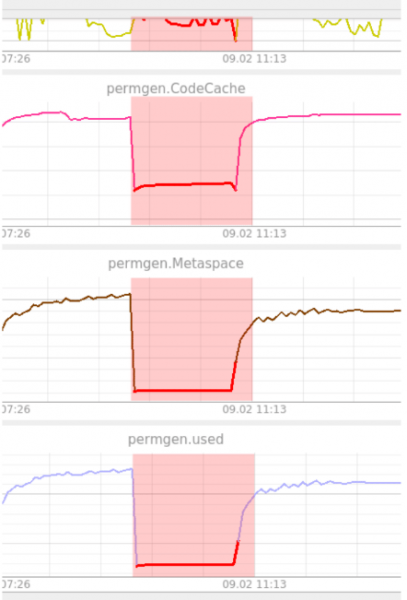
Figura 10. Exemplo de detecção pelo autoencodificador
Como pode ser observado na figura, o PermGen ficou estagnado em um nível. O autoencodificador considerou isso estranho, pois nunca havia visto algo semelhante antes. Aqui, a anomalia se manteve em 100% até a restauração do sistema ao estado operacional. A anomalia é exibida em todas as métricas. Como mencionado anteriormente, o autoencodificador não consegue localizar anomalias. O operador é designado para desempenhar essa função nessas situações.
Conclusão
O PC "Web-Consolidação" está em desenvolvimento há vários anos. O sistema está em um estado bastante estável e o número de incidentes registrados é pequeno. No entanto, foi possível identificar anomalias que levaram a falhas com uma antecedência de 5 a 10 minutos antes do colapso. Em alguns casos, o alerta de falha com antecedência poderia ter ajudado a economizar o tempo regulado reservado para a realização de trabalhos de 'manutenção'.
Ainda é cedo para fazer conclusões definitivas com base nos experimentos realizados. No momento, os resultados são contraditórios. Por um lado, é evidente que algoritmos baseados em redes neurais conseguem identificar anomalias "úteis". Por outro lado, ainda existem muitos falsos positivos, e nem todas as anomalias que um especialista qualificado identifica são detectadas pela rede neural. Um ponto negativo é que, atualmente, a rede neural requer aprendizado supervisionado para funcionar corretamente.
Para o desenvolvimento futuro do sistema de previsão de falhas e para que ele atinja um estado satisfatório, podem ser considerados vários caminhos. Um deles seria uma análise mais detalhada dos casos com anomalias que levam a falhas, complementando assim a lista de métricas importantes que influenciam fortemente o estado do sistema, e eliminando métricas irrelevantes. Além disso, seguindo por essa direção, também poderia se tentar a especialização dos algoritmos especificamente para nossos casos de anomalias que causam falhas. Existe um outro caminho, que é a melhoria das arquiteturas das redes neurais e, com isso, o aumento da precisão das detecções, reduzindo o tempo de treinamento.
Agradeço aos colegas que me ajudaram na redação e na atualização desta artigo: e Sergey Finogenev.
Fonte: habr.com
