

Provavelmente, hoje em dia ninguém se pergunta por que é necessário coletar métricas de serviços. O próximo passo lógico é configurar alertas para as métricas coletadas, que irão notificar sobre qualquer desvio nos dados nos canais que você preferir (e-mail, Slack, Telegram). No serviço de reservas de hotéis online todas as métricas dos nossos serviços são enviadas para o InfluxDB e são exibidas no Grafana, onde também está configurado o alerta básico. Para tarefas do tipo "preciso calcular algo e comparar com isso", usamos o Kapacitor.
Kapacitor é parte da pilha TICK, que consegue processar métricas do InfluxDB. Ele pode conectar várias medições entre si (join), calcular algo útil a partir dos dados obtidos, gravar o resultado de volta no InfluxDB e enviar um alerta pelo Slack/Twitter/e-mail.
Toda a pilha possui uma documentação incrível e detalhada , mas sempre há dicas úteis que não estão claramente especificadas nos manuais. Neste artigo, decidi reunir uma série de conselhos não óbvios e mostrar como eles podem ser aplicados, usando como exemplo a solução de uma de nossas tarefas. float & int, erros de cálculo
Vamos lá!
Um problema absolutamente padrão, que é resolvido com um cast:
var alert_float = 5.0 var alert_int = 10 data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Uso de default()
Se a tag/campo não estiver preenchida, ocorrerão erros nos cálculos:
|default() .tag('status', 'empty') .field('value', 0)
fill em join (inner vs outer)
Por padrão, join descarta pontos onde não há dados (inner).
Com fill('null') será executado um outer join, após o qual é necessário fazer default() e preencher os valores vazios:
var data = res1 |join(res2) .as('res1', 'res2') .fill('null') |default() .field('res1.value', 0.0) .field('res2.value', 100.0)
Aqui ainda há uma nuance. Se no exemplo acima uma das séries (res1 ou res2) estiver vazia, a série resultante (data) também ficará vazia. Existem alguns tickets sobre isso no GitHub (
) – estamos aguardando correções e passando um pouco de dificuldade., , Uso de condições nos cálculos (if em lambda)
|eval(lambda: if("value" > 0, true, false)
Últimos cinco minutos do pipeline por período
Por exemplo, você precisa comparar os valores dos últimos cinco minutos com a semana anterior. Você pode pegar dois conjuntos de dados em dois batchs separados ou extrair parte dos dados de um período maior:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Uma alternativa para os últimos cinco minutos pode ser o uso do nó BarrierNode, que corta os dados antes do tempo especificado:
|barrier()
        .period(5m)
Exemplos de uso de templates Go em mensagens
Os templates correspondem ao formato do pacote , abaixo algumas tarefas frequentemente encontradas.
if-else
Organizamos as coisas, sem acionar as pessoas com texto desnecessário:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Está tudo certo agora{{ else }}Chefe, tudo está quebrado{{end}}'
    )
Duas casas decimais na mensagem
Melhoramos a legibilidade da mensagem:
|alert()
    ...
    .message(
        'o valor agora é {{ index .Fields "value" | printf "%0.2f" }}'
    )
Expansão de variáveis na mensagem
Fornecemos mais informações na mensagem para responder à pergunta "Por que está gritando?"
var warnAlert = 10
  |alert()
    ...
    .message(
       'Hoje o valor é menor que '+string(warnAlert)+'%'
    )
Identificador único do alerta
Uma coisa necessária quando há mais de um grupo de dados, caso contrário, apenas um alerta será gerado:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Handlers personalizados
Na longa lista de handlers, existe o exec, que permite executar seu próprio script com parâmetros passados (stdin) – pura criatividade!
Um dos nossos personalizados é um pequeno script em Python para enviar notificações ao Slack.
Primeiro, queríamos enviar uma imagem do Grafana protegida por autorização na mensagem. Depois, enviar OK na thread do alerta anterior do mesmo grupo, e não como uma mensagem separada. Um pouco mais tarde, adicionar na mensagem o erro mais frequente dos últimos X minutos.
Um tema separado é a conexão com outros serviços e quaisquer ações iniciadas pelo alerta (somente se sua monitoração estiver funcionando bem o suficiente).
Exemplo de descrição do handler, onde slack_handler.py é nosso script personalizado:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Como debugar?
Opção de saída no log
|log()
      .level("error")
      .prefix("something")
Ver (cli): kapacitor -url :9092 logs lvl=error
Opção com httpOut
Mostra dados no pipeline atual:
|httpOut('something')
Ver (get): :9092\/kapacitor\/v1\/tasks\/task_name\/something
Esquema de execução
- Cada tarefa retorna uma árvore de execução com números úteis no formato .
- Pegamos o bloco .
- Inserimos no visualizador, .
Onde mais podemos obter registros
timestamp no influxdb ao reescrever
Por exemplo, configuramos um alerta com a quantidade de solicitações por hora (groupBy(1h)) e queremos registrar o alerta ocorrido no influxdb (para mostrar claramente a existência do problema no gráfico no grafana).
influxDBOut() registrará no timestamp o valor time do alerta, portanto, o ponto no gráfico será registrado antes/depois de a alerta chegar.
Quando precisa de precisão: contornamos esse problema através da chamada de um handler personalizado, que registrará os dados no influxdb com o timestamp atual.
docker, construção e deploy
Ao iniciar, o kapacitor pode carregar tarefas, modelos e handlers do diretório especificado na configuração, no bloco [load].
Para criar corretamente a tarefa, são necessárias as seguintes coisas:
- Nome do arquivo – se desdobra em id/nome do script
- Tipo – stream/batch
- dbrp – palavra-chave para indicar em qual banco de dados + política o script funciona (dbrp "supplier"."autogen")
Se em alguma tarefa batch não houver uma linha com dbrp, todo o serviço se recusará a iniciar e escreverá isso no log.
No chronograf, por outro lado, essa linha não deve existir, pois não é aceita pela interface e gera um erro.
Hack na construção do contêiner: o Dockerfile falha com -1 se houver linhas com //.+dbrp, o que permite entender imediatamente a razão da falha na construção.
join um para muitos
Exemplo de tarefa: é necessário pegar o percentil 95 do tempo de operação do serviço por uma semana, comparando cada minuto dos últimos 10 com esse valor.
Não é possível fazer join um para muitos, last/mean/median em um grupo de pontos transforma o nó em stream, retornará o erro "cannot add child mismatched edges: batch -> stream".
O resultado batch, como variável em uma expressão lambda, também não é passado.
Há uma opção de salvar os números necessários do primeiro batch em um arquivo através de udf e carregar esse arquivo via sideload.
O que resolvemos com isso?
Temos cerca de 100 fornecedores de hotéis, cada um pode ter várias conexões, chamaremos isso de canal. Há cerca de 300 desses canais, cada um pode falhar. Das métricas registradas, monitoraremos a taxa de erros (requests e errors).
Por que não grafana?
Os alertas por erros, configurados no grafana, têm várias desvantagens. Algumas são críticas, outras podem ser ignoradas, dependendo da situação.
Grafana não consegue fazer cálculos entre medições + alertas, e precisamos da taxa (requests-errors)/requests.
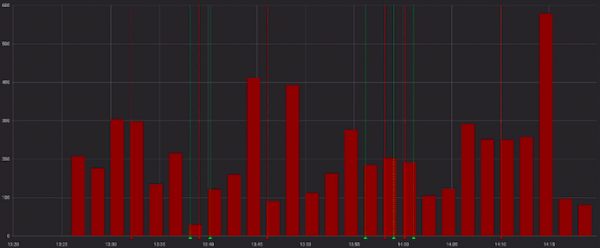
Os erros parecem severos:
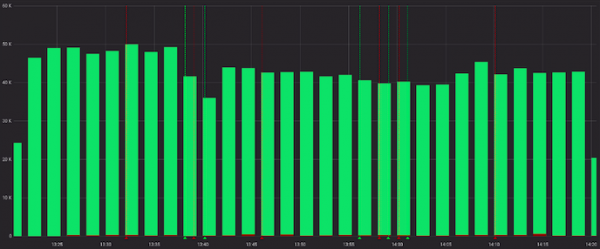
E menos severos, quando vistos junto com as solicitações bem-sucedidas:
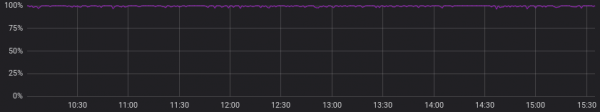
Ok, podemos calcular preliminarmente a taxa no serviço antes do Grafana, e em alguns casos isso funcionará. Mas não no nosso, pois para cada canal sua própria proporção é considerada "normal" e os alertas funcionam com valores estáticos (procuramos manualmente, mudamos se alertar com frequência).
Aqui estão exemplos de “normal” para diferentes canais:
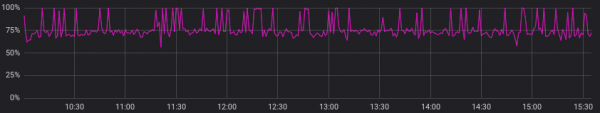
Ignorando o ponto anterior, vamos supor que todos os fornecedores tenham uma representação "normal" semelhante. Agora está tudo certo, e podemos nos virar apenas com alertas no Grafana?
Podemos, mas não queremos, porque precisamos escolher uma das opções:
a) fazer vários gráficos para cada canal separadamente (e sofrer para mantê-los)
b) deixar um gráfico com todos os canais (e nos perder nas linhas coloridas e alertas configurados)
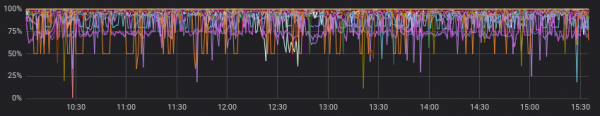
Como fizemos?
Novamente, a documentação tem um bom exemplo inicial (), podemos dar uma olhada ou usar como base em situações semelhantes.
O que fizemos no final:
- união de duas séries em algumas horas, agrupamento por canais;
- preenchemos séries por grupos, se não havia dados;
- comparamos a mediana dos últimos 10 minutos com dados anteriores;
- gritamos se descobrirmos algo;
- escrevemos as taxas calculadas e os alertas que ocorreram no influxdb;
- enviamos uma mensagem útil no slack.
Na minha opinião, conseguimos maximamente bonito tudo o que gostaríamos de obter como resultado (e até um pouco mais com os manipuladores personalizados).
No github.com você pode ver e do script obtido.
Exemplo do código resultante:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // preenche valores nulos com zeros se não houver
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // se no lambda: calcula a taxa somente se houver erros
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// grava os valores calculados no influx
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// seleciona dados dos últimos 10 minutos, calcula a mediana
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // coleta no message um link para o gráfico do dashboard do grafana
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} relação err/req ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}Está tudo bem agora{{ else }}
'+string(todayPeriod)+' mediana é {{ index .Fields "today.median" | printf "%0.2f" }}%, em comparação com a anterior '+string(period)+' é {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+'
?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }} / {{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" é duplicado como "value", além de enviar para influx os outros campos do alerta (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
E qual é a saída?
Kapacitor é excelente para monitoramento e alertas com diversas agrupamentos, realizando cálculos adicionais com métricas já registradas, executando ações personalizadas e rodando scripts (udf).
A barreira de entrada não é muito alta – experimente se o Grafana ou outras ferramentas não atendem completamente às suas necessidades.
Fonte: habr.com
