

Este artigo explora várias maneiras de determinar a equação matemática de uma linha de regressão simples (dupla).
Todos os métodos de solução da equação aqui discutidos são baseados no método dos mínimos quadrados. Denominaremos os métodos da seguinte forma:
- Solução analítica
- Descida do gradiente
- Descida do gradiente estocástico
Para cada método de solução da equação da linha, o artigo apresenta diferentes funções, que se dividem em aquelas escritas sem o uso de bibliotecas NumPy e aquelas que usam NumPy. Acredita-se que o uso habilidoso de NumPy reduzirá os custos de cálculo.
Todo o código apresentado no artigo é escrito na linguagem python 2.7 usando Jupyter Notebook. O código-fonte e o arquivo com os dados da amostra estão disponíveis no
O artigo é voltado tanto para iniciantes quanto para aqueles que já começaram a explorar esta ampla área da inteligência artificial — aprendizado de máquina.
Para ilustrar o material, utilizamos um exemplo muito simples.
Condições do exemplo
Temos cinco valores que caracterizam a dependência Y de X (Tabela nº 1):
Tabela nº 1 "Condições do exemplo"
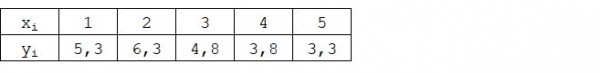
Consideraremos que os valores  — são os meses do ano, e
 — a receita nesse mês. Em outras palavras, a receita depende do mês do ano, e
 — é a única característica da qual a receita depende.
O exemplo é simples, tanto em relação à dependência da receita em relação ao mês do ano, quanto em relação à quantidade de valores — são muito poucos. No entanto, essa simplificação permitirá, de maneira resumida, explicar um material que nem sempre é facilmente assimilável para iniciantes. A simplicidade dos números também permitirá que aqueles que desejam resolvam o exemplo "no papel" sem exigir esforços significativos.
Supomos que a dependência apresentada no exemplo pode ser bem aproximada por uma equação matemática de uma linha de regressão simples (dupla) do tipo:

onde  — é o mês em que a receita foi obtida,
 — é a receita correspondente ao mês,
 e
 — são os coeficientes da linha de regressão avaliada.
Note que o coeficiente  é frequentemente chamado de coeficiente angular ou gradiente da linha avaliada; representa a quantidade pela qual
 mudará com a alteração de
 .
É evidente que nossa tarefa no exemplo é encontrar na equação esses coeficientes.  e
 , em que as discrepâncias entre nossos valores calculados de receita mensal e as respostas reais, ou seja, os valores apresentados na amostra, serão mínimas.
Método dos mínimos quadrados
De acordo com o método dos mínimos quadrados, a discrepância deve ser calculada elevando-a ao quadrado. Esse método evita a anulação mútua das discrepâncias quando têm sinais opostos. Por exemplo, se em um caso a discrepância é +5 (mais cinco), e em outro -5 (menos cinco), então a soma das discrepâncias se anulará e será igual a 0 (zero). Também podemos não elevar a discrepância ao quadrado, mas usar a propriedade do módulo, assim todas as discrepâncias serão positivas e se acumularão. Não nos deteremos muito nesse ponto, apenas indicaremos que, para facilitar os cálculos, é comum elevar a discrepância ao quadrado.
Assim é a fórmula com a qual determinaremos a menor soma dos quadrados das discrepâncias (erros):

onde  — é a função de aproximação das respostas reais (ou seja, a receita que calculamos),
 — são as respostas reais (a receita fornecida na amostra),
 — é o índice da amostra (o número do mês em que a discrepância é determinada)
Vamos diferenciar a função, determinar as equações das derivadas parciais e estaremos prontos para passar para a solução analítica. Mas, antes, faremos uma pequena excursão sobre o que é diferenciação e lembraremos o significado geométrico da derivada.
Diferenciação
Diferenciação é a operação de encontrar a derivada de uma função.
Para que serve a derivada? A derivada de uma função caracteriza a velocidade de mudança da função e nos indica sua direção. Se a derivada em um ponto dado for positiva, a função está aumentando; caso contrário, a função está diminuindo. E quanto maior o valor da derivada em módulo, maior a velocidade de mudança dos valores da função e mais íngreme será o ângulo de inclinação do gráfico da função.
Por exemplo, nas condições do sistema de coordenadas cartesiano, o valor da derivada no ponto M(0,0) que é +25 significa que, naquele ponto, ao deslocar o valor  para a direita em uma unidade, o valor
 aumenta em 25 unidades. No gráfico, isso aparece como um ângulo bastante íngreme de subida dos valores
 a partir do ponto dado.
Outro exemplo. O valor da derivada igual a -0,1 significa que, ao deslocar  uma unidade arbitrária, o valor
 diminui apenas 0,1 unidade arbitrária. Neste caso, no gráfico da função, podemos observar uma leve inclinação para baixo. Fazendo uma analogia com uma montanha, é como se estivéssemos descendo muito lentamente por uma encosta suave, ao contrário do exemplo anterior, onde tínhamos que enfrentar picos muito íngremes :)
Assim, ao realizar a diferenciação da função  pelos coeficientes
 e
 , definiremos as equações das derivadas parciais de 1ª ordem. Após a definição das equações, obteremos um sistema de duas equações, resolvendo o qual poderemos determinar tais valores dos coeficientes
 e
 , para os quais os valores das respectivas derivadas nos pontos especificados mudam apenas uma quantidade muito, muito pequena, e, no caso de uma solução analítica, não mudam de forma alguma. Em outras palavras, a função de erro com os coeficientes encontrados alcançará o mínimo, pois os valores das derivadas parciais nesses pontos serão zero.
Assim, segundo as regras de diferenciação, a equação da derivada parcial de 1ª ordem em relação ao coeficiente  assumirá a forma:

a equação da derivada parcial de 1ª ordem em relação a  assumirá a forma:

No final, obtivemos um sistema de equações que tem uma solução analítica bastante simples:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Antes de resolver a equação, vamos primeiro carregar, verificar a validade do carregamento e formatar os dados.
Carregamento e formatação de dados
É importante notar que, devido ao fato de que para a solução analítica, assim como para o gradiente e o gradiente estocástico, aplicaremos o código em duas variações: utilizando a biblioteca NumPy e sem o seu uso, precisaremos da formatação apropriada dos dados (veja o código).
Código de carregamento e processamento de dados
# импортируем все нужные нам библиотеки
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import math
import pylab as pl
import random

# графики отобразим в Jupyter
%matplotlib inline

# укажем размер графиков
from pylab import rcParams
rcParams['figure.figsize'] = 12, 6

# отключим предупреждения Anaconda
import warnings
warnings.simplefilter('ignore')

# загрузим значения
table_zero = pd.read_csv('data_example.txt', header=0, sep='t')

# посмотрим информацию о таблице и на саму таблицу
print table_zero.info()
print '********************************************'
print table_zero
print '********************************************'

# подготовим данные без использования NumPy

x_us = []
[x_us.append(float(i)) for i in table_zero['x']]
print x_us
print type(x_us)
print '********************************************'

y_us = []
[y_us.append(float(i)) for i in table_zero['y']]
print y_us
print type(y_us)
print '********************************************'

# подготовим данные с использованием NumPy

x_np = table_zero[['x']].values
print x_np
print type(x_np)
print x_np.shape
print '********************************************'

y_np = table_zero[['y']].values
print y_np
print type(y_np)
print y_np.shape
print '********************************************'
Visualização
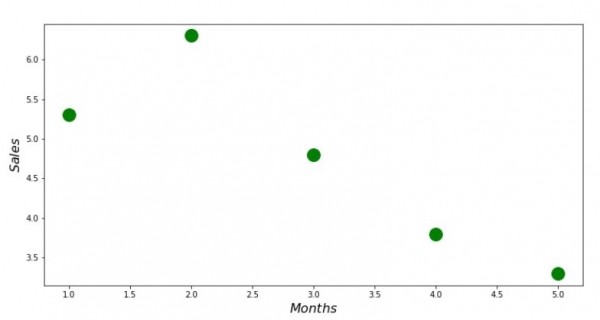
Agora, depois de termos, em primeiro lugar, carregado os dados, em segundo lugar, verificado a validade do carregamento e, finalmente, formatado os dados, realizaremos a primeira visualização. Muitas vezes, para isso, utiliza-se o método pairplot uma biblioteca Seaborn. No nosso exemplo, devido à limitação dos números, não faz sentido aplicar a biblioteca Seaborn. Usaremos a biblioteca comum Matplotlib e veremos apenas o gráfico de dispersão.
Código do diagrama de dispersão
print 'Gráfico nº 1 "Dependência da receita do mês do ano"'

plt.plot(x_us,y_us,'o',color='green',markersize=16)
plt.xlabel('$Meses$', size=16)
plt.ylabel('$Vendas$', size=16)
plt.show()
Gráfico nº 1 «Dependência da receita do mês do ano»
Solução analítica
Vamos usar as ferramentas mais simples em python e resolver o sistema de equações:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Pelo regra de Cramer encontraremos o determinante geral, bem como determinantes por  e por
 , após o que, ao dividir o determinante por
 pelo determinante geral — encontraremos o coeficiente
 , de forma análoga encontraremos o coeficiente
 .
Código da solução analítica
# определим функцию для расчета коэффициентов a и b по правилу Крамера
def Kramer_method (x,y):
        # сумма значений (все месяца)
    sx = sum(x)
        # сумма истинных ответов (выручка за весь период)
    sy = sum(y)
        # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x[i]*y[i]) for i in range(len(x))]
    sxy = sum(list_xy)
        # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x[i]**2) for i in range(len(x))]
    sx_sq = sum(list_x_sq)
        # количество значений
    n = len(x)
        # общий определитель
    det = sx_sq*n - sx*sx
        # определитель по a
    det_a = sx_sq*sy - sx*sxy
        # искомый параметр a
    a = (det_a / det)
        # определитель по b
    det_b = sxy*n - sy*sx
        # искомый параметр b
    b = (det_b / det)
        # контрольные значения (прооверка)
    check1 = (n*b + a*sx - sy)
    check2 = (b*sx + a*sx_sq - sxy)
    return [round(a,4), round(b,4)]

# запустим функцию и запишем правильные ответы
ab_us = Kramer_method(x_us,y_us)
a_us = ab_us[0]
b_us = ab_us[1]
print ' 33[1m' + ' 33[4m' + "Оптимальные значения коэффициентов a и b:"  + ' 33[0m'
print 'a =', a_us
print 'b =', b_us
print

# определим функцию для подсчета суммы квадратов ошибок
def errors_sq_Kramer_method(answers,x,y):
    list_errors_sq = []
    for i in range(len(x)):
        err = (answers[0] + answers[1]*x[i] - y[i])**2
        list_errors_sq.append(err)
    return sum(list_errors_sq)

# запустим функцию и запишем значение ошибки
error_sq = errors_sq_Kramer_method(ab_us,x_us,y_us)
print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений" + ' 33[0m'
print error_sq
print

# замерим время расчета
# print ' 33[1m' + ' 33[4m' + "Время выполнения расчета суммы квадратов отклонений:" + ' 33[0m'
# % timeit error_sq = errors_sq_Kramer_method(ab,x_us,y_us)
Eis o que conseguimos:
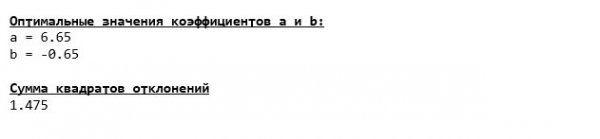
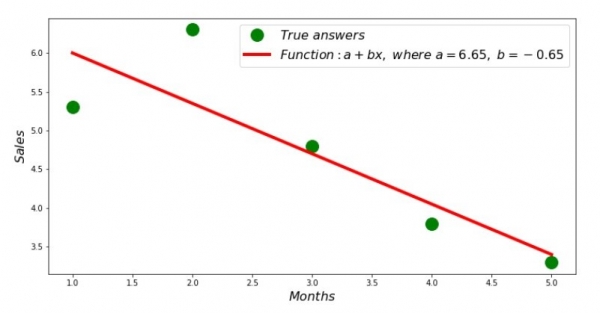
Assim, os valores dos coeficientes foram encontrados e a soma dos quadrados dos desvios foi estabelecida. Vamos traçar na histograma de dispersão uma linha reta de acordo com os coeficientes encontrados.
Código da linha de regressão
# определим функцию для формирования массива рассчетных значений выручки
def sales_count(ab,x,y):
    line_answers = []
    [line_answers.append(ab[0]+ab[1]*x[i]) for i in range(len(x))]
    return line_answers

# построим графики
print 'Грфик№2 "Правильные и расчетные ответы"'
plt.plot(x_us,y_us,'o',color='green',markersize=16, label = '$True$ $answers$')
plt.plot(x_us, sales_count(ab_us,x_us,y_us), color='red',lw=4,
         label='$Function: a + bx,$ $where$ $a='+str(round(ab_us[0],2))+',$ $b='+str(round(ab_us[1],2))+'$')
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.legend(loc=1, prop={'size': 16})
plt.show()
Gráfico nº 2 «Respostas corretas e calculadas»
Podemos observar o gráfico de desvios para cada mês. No nosso caso, não extrairemos qualquer valor prático significativo, mas satisfaremos a curiosidade sobre o quão bem a equação de regressão linear simples caracteriza a dependência da receita em relação ao mês do ano.
Código do gráfico de desvios
# определим функцию для формирования массива отклонений в процентах
def error_per_month(ab,x,y):
    sales_c = sales_count(ab,x,y)
    errors_percent = []
    for i in range(len(x)):
        errors_percent.append(100*(sales_c[i]-y[i])/y[i])
    return errors_percent

# построим график
print 'График№3 "Отклонения по-месячно, %"'
plt.gca().bar(x_us, error_per_month(ab_us,x_us,y_us), color='brown')
plt.xlabel('Months', size=16)
plt.ylabel('Calculation error, %', size=16)
plt.show()
Gráfico nº 3 «Desvios, %»
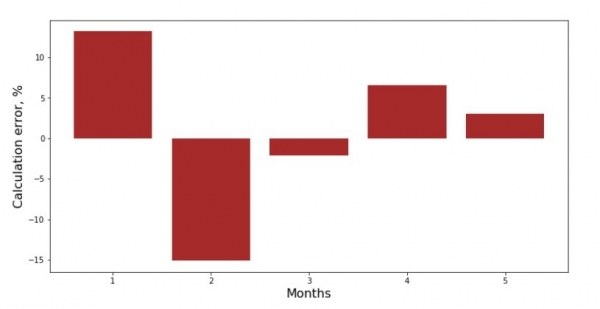
Não é perfeito, mas cumprimos nossa tarefa.
Vamos escrever uma função que, para determinar os coeficientes  e
 usa a biblioteca NumPy, mais precisamente — escreveremos duas funções: uma usando a matriz pseudo-inversa (não recomendada na prática, pois o processo é computacionalmente complicado e instável), a outra usando a equação matricial.
Código da solução analítica (NumPy)
# для начала добавим столбец с не изменяющимся значением в 1.
# Данный столбец нужен для того, чтобы не обрабатывать отдельно коэффицент a
vector_1 = np.ones((x_np.shape[0],1))
x_np = table_zero[['x']].values # на всякий случай приведем в первичный формат вектор x_np
x_np = np.hstack((vector_1,x_np))

# проверим то, что все сделали правильно
print vector_1[0:3]
print x_np[0:3]
print '***************************************'
print

# напишем функцию, которая определяет значения коэффициентов a и b с использованием псевдообратной матрицы
def pseudoinverse_matrix(X, y):
    # задаем явный формат матрицы признаков
    X = np.matrix(X)
    # определяем транспонированную матрицу
    XT = X.T
    # определяем квадратную матрицу
    XTX = XT*X
    # определяем псевдообратную матрицу
    inv = np.linalg.pinv(XTX)
    # задаем явный формат матрицы ответов
    y = np.matrix(y)
    # находим вектор весов
    return (inv*XT)*y

# запустим функцию
ab_np = pseudoinverse_matrix(x_np, y_np)
print ab_np
print '***************************************'
print

# напишем функцию, которая использует для решения матричное уравнение
def matrix_equation(X,y):
    a = np.dot(X.T, X)
    b = np.dot(X.T, y)
    return np.linalg.solve(a, b)

# запустим функцию
ab_np = matrix_equation(x_np,y_np)
print ab_np
Vamos comparar o tempo gasto na determinação dos coeficientes  e
 , de acordo com os 3 métodos apresentados.
Código para calcular o tempo das operações
print ' 33[1m' + ' 33[4m' + "Tempo de execução do cálculo dos coeficientes sem usar a biblioteca NumPy:" + ' 33[0m'
% timeit ab_us = Kramer_method(x_us,y_us)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Tempo de execução do cálculo dos coeficientes usando a matriz pseudo-inversa:" + ' 33[0m'
%timeit ab_np = pseudoinverse_matrix(x_np, y_np)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Tempo de execução do cálculo dos coeficientes usando a equação matricial:" + ' 33[0m'
%timeit ab_np = matrix_equation(x_np, y_np)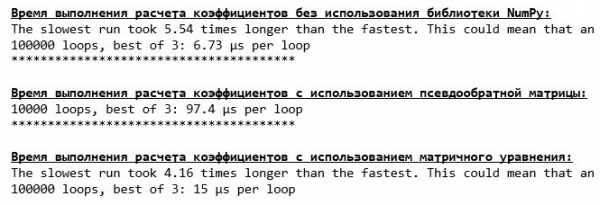
Com um pequeno número de dados, a função "feita à mão" que encontra os coeficientes pelo método de Cramer se destaca.
Agora podemos passar para outras formas de encontrar os coeficientes  e
 .
Descida do gradiente
Para começar, vamos definir o que é um gradiente. De forma simples, o gradiente é um segmento que indica a direção máxima de crescimento de uma função. Assim como subir uma montanha, onde o gradiente aponta, é onde está a subida mais acentuada para o topo. Seguindo o exemplo da montanha, lembramos que, na verdade, precisamos da descida mais íngreme, para chegarmos ao fundo mais rapidamente, ou seja, ao mínimo — o ponto onde a função não aumenta nem diminui. Neste ponto, a derivada será zero. Portanto, precisamos não do gradiente, mas do antigradiente. Para encontrar o antigradiente, basta multiplicar o gradiente por -1 (-1).
Vale ressaltar que uma função pode ter vários mínimos, e ao descer até um deles pelo algoritmo que será apresentado a seguir, não conseguiremos encontrar outro mínimo que possa estar abaixo do encontrado. Relaxem, isso não é um problema para nós! No nosso caso, lidamos com um único mínimo, pois nossa função  no gráfico é uma parábola comum. E como todos nós sabemos bem do curso de matemática da escola — uma parábola possui apenas um mínimo.
Depois de esclarecer para que precisamos do gradiente, e também que o gradiente é um segmento, ou seja, um vetor com coordenadas determinadas, que são precisamente os coeficientes  e
 podemos implementar o descenso do gradiente.
Antes de começarmos, sugiro ler literalmente algumas frases sobre o algoritmo de descida:
- Definimos aleatoriamente as coordenadas dos coeficientes
 e . No nosso exemplo, vamos definir os coeficientes próximos de zero. Isso é uma prática comum, no entanto, para cada caso pode haver uma prática específica.
- Da coordenada subtraímos o valor da derivada parcial de 1ª ordem no ponto . Assim, se a derivada for positiva, a função está crescendo. Portanto, subtraindo o valor da derivada, estaremos nos movendo na direção oposta ao crescimento, ou seja, na direção da descida. Se a derivada for negativa, significa que a função está diminuindo naquele ponto e, ao subtrair o valor da derivada, nos movemos em direção à descida.
- Realizamos uma operação semelhante com a coordenada : subtraímos o valor da derivada parcial no ponto .
- Para não pular o mínimo e não voar para o espaço distante, é necessário estabelecer o tamanho do passo na direção da descida. De um modo geral, poderia escrever um artigo inteiro sobre como configurar corretamente o passo e como mudá-lo durante o processo de descida, a fim de reduzir os custos de cálculo. Mas agora temos uma tarefa um pouco diferente, e através do método científico de 'tentativa e erro', ou como dizem popularmente, de maneira empírica, determinaremos o tamanho do passo.
- Depois que subtraímos os valores das derivadas das coordenadas dadas e , obtemos novas coordenadas e . Damos o próximo passo (subtração), já a partir das coordenadas calculadas. E assim, o ciclo reinicia, até que a convergência necessária seja alcançada.
 e
 . No nosso exemplo, vamos definir os coeficientes próximos de zero. Isso é uma prática comum, no entanto, para cada caso pode haver uma prática específica.
 subtraímos o valor da derivada parcial de 1ª ordem no ponto
 . Assim, se a derivada for positiva, a função está crescendo. Portanto, subtraindo o valor da derivada, estaremos nos movendo na direção oposta ao crescimento, ou seja, na direção da descida. Se a derivada for negativa, significa que a função está diminuindo naquele ponto e, ao subtrair o valor da derivada, nos movemos em direção à descida.
 : subtraímos o valor da derivada parcial no ponto
 .
 e
 , obtemos novas coordenadas
 e
 . Damos o próximo passo (subtração), já a partir das coordenadas calculadas. E assim, o ciclo reinicia, até que a convergência necessária seja alcançada.
Isso! Agora estamos prontos para partir em busca do mais profundo cânion da Fossa das Marianas. Vamos começar.
Código para descida em gradiente
# напишем функцию градиентного спуска без использования библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = sum(x_us)
    # сумма истинных ответов (выручка за весь период)
    sy = sum(y_us)
    # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x_us[i]*y_us[i]) for i in range(len(x_us))]
    sxy = sum(list_xy)
    # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x_us[i]**2) for i in range(len(x_us))]
    sx_sq = sum(list_x_sq)
    # количество значений
    num = len(x_us)
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = [a,b]
        errors.append(errors_sq_Kramer_method(ab,x_us,y_us))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)


print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print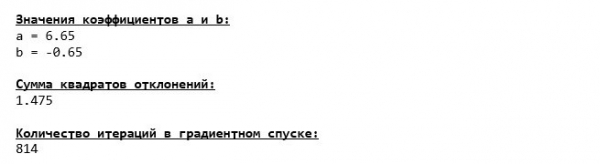
Descemos ao fundo da Fossa das Marianas e lá encontramos os mesmos valores dos coeficientes  e
 , como era de se esperar.
Faremos mais uma descida, mas desta vez, a tecnologia do nosso aparelho subaquático será diferente, ou seja, a biblioteca NumPy.
Código para descida em gradiente (NumPy)
# перед тем определить функцию для градиентного спуска с использованием библиотеки NumPy,
# напишем функцию определения суммы квадратов отклонений также с использованием NumPy
def error_square_numpy(ab,x_np,y_np):
    y_pred = np.dot(x_np,ab)
    error = y_pred - y_np
    return sum((error)**2)

# напишем функцию градиентного спуска с использованием библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = float(sum(x_np[:,1]))
    # сумма истинных ответов (выручка за весь период)
    sy = float(sum(y_np))
    # сумма произведения значений на истинные ответы
    sxy = x_np*y_np
    sxy = float(sum(sxy[:,1]))
    # сумма квадратов значений
    sx_sq = float(sum(x_np[:,1]**2))
    # количество значений
    num = float(x_np.shape[0])
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = np.array([[a],[b]])
        errors.append(error_square_numpy(ab,x_np,y_np))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print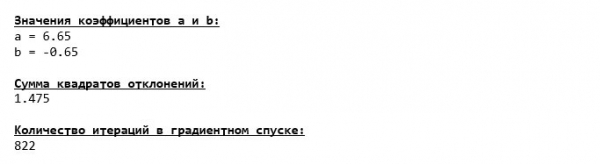
Os valores dos coeficientes  e
 são inalterados.
Vamos ver como o erro variou durante a descida em gradiente, ou seja, como a soma dos quadrados das divergências mudou a cada passo.
Código para o gráfico da soma dos quadrados das divergências
print 'Gráfico nº 4 "Soma dos quadrados das divergências passo a passo"'
plt.plot(range(len(list_parametres_gradient_descence[1])), list_parametres_gradient_descence[1], color='red', lw=3)
plt.xlabel('Passos (Iteração)', size=16)
plt.ylabel('Soma dos quadrados das divergências', size=16)
plt.show()
Gráfico nº 4 «Soma dos quadrados das divergências na descida em gradiente»
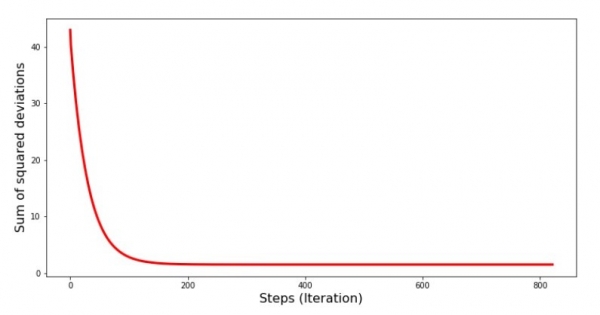
No gráfico, vemos que a cada passo o erro diminui, e após algumas iterações observamos uma linha praticamente horizontal.
Por fim, vamos avaliar a diferença no tempo de execução do código:
Código para determinar o tempo de cálculo da descida em gradiente
print ' 33[1m' + ' 33[4m' + "Tempo de execução do gradiente descendente sem utilizar a biblioteca NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' + "Tempo de execução do gradiente descendente utilizando a biblioteca NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)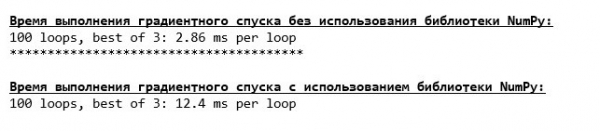
Talvez estejamos fazendo algo errado, mas novamente uma função «feita à mão» simples, que não utiliza a biblioteca NumPy supera em tempo de execução a função que utiliza a biblioteca NumPy.
Mas não estamos parados, estamos avançando para o estudo de mais uma maneira fascinante de resolver a equação de regressão linear simples. Conheçam!
Descida do gradiente estocástico
Para entender mais rapidamente o princípio do funcionamento do gradiente descendente estocástico, é melhor definir suas diferenças em relação ao gradiente descendente comum. No caso do gradiente descendente, nas equações das derivadas de  e
 utilizamos as somas dos valores de todas as características e das respostas verdadeiras disponíveis na amostra (ou seja, as somas de todos
 e
 ). No gradiente descendente estocástico, não utilizaremos todos os valores disponíveis na amostra, mas sim, selecionaremos aleatoriamente um índice de amostra e utilizaremos seus valores.
Por exemplo, se o índice for determinado como o número 3 (três), pegamos os valores  e
 , em seguida, inserimos os valores nas equações das derivadas e determinamos novas coordenadas. Depois, ao determinar as coordenadas, novamente selecionamos aleatoriamente um índice de amostra, inserimos os valores correspondentes ao índice nas equações das derivadas parciais, e novamente definimos as coordenadas
 e
 e assim por diante até que a convergência seja alcançada. À primeira vista, pode parecer que isso pode funcionar, mas funciona. Porém, vale a pena notar que nem a cada passo a erro diminui, mas a tendência com certeza existe.
Quais são as vantagens do gradiente descendente estocástico em relação ao comum? Se temos um tamanho de amostra muito grande e é medido em dezenas de milhares de valores, é muito mais fácil processar, digamos, mil aleatórias delas, em vez de toda a amostra. É nesse caso que o gradiente descendente estocástico é acionado. No nosso caso, é claro, não notaremos uma grande diferença.
Vamos ver o código.
Código para descida de gradiente estocástica
# определим функцию стох.град.шага
def stoch_grad_step_usual(vector_init, x_us, ind, y_us, l):
#     выбираем значение икс, которое соответствует случайному значению параметра ind
# (см.ф-цию stoch_grad_descent_usual)
    x = x_us[ind]
#     рассчитывыаем значение y (выручку), которая соответствует выбранному значению x
    y_pred = vector_init[0] + vector_init[1]*x_us[ind]
#     вычисляем ошибку расчетной выручки относительно представленной в выборке
    error = y_pred - y_us[ind]
#     определяем первую координату градиента ab
    grad_a = error
#     определяем вторую координату ab
    grad_b = x_us[ind]*error
#     вычисляем новый вектор коэффициентов
    vector_new = [vector_init[0]-l*grad_a, vector_init[1]-l*grad_b]
    return vector_new


# определим функцию стох.град.спуска
def stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800):
#     для самого начала работы функции зададим начальные значения коэффициентов
    vector_init = [float(random.uniform(-0.5, 0.5)), float(random.uniform(-0.5, 0.5))]
    errors = []
#     запустим цикл спуска
# цикл расчитан на определенное количество шагов (steps)
    for i in range(steps):
        ind = random.choice(range(len(x_us)))
        new_vector = stoch_grad_step_usual(vector_init, x_us, ind, y_us, l)
        vector_init = new_vector
        errors.append(errors_sq_Kramer_method(vector_init,x_us,y_us))
    return (vector_init),(errors)


# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])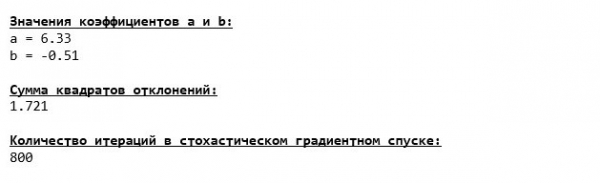
Observamos atentamente os coeficientes e nos pegamos pensando: "Como isso aconteceu?". Obtivemos valores de coeficientes diferentes  e
 . Pode ser que a descida de gradiente estocástica tenha encontrado parâmetros mais otimizados para a equação? Infelizmente, não. É suficiente observar a soma dos quadrados dos desvios e ver que, com os novos valores dos coeficientes, o erro é maior. Não precisamos desanimar. Vamos construir um gráfico da alteração do erro.
Código para o gráfico da soma dos quadrados dos desvios na descida de gradiente estocástica
print 'Gráfico nº 5 "Soma dos quadrados dos desvios passo a passo"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Passos (Iteração)', size=16)
plt.ylabel('Soma dos quadrados dos desvios', size=16)
plt.show()
Gráfico nº 5 "Soma dos quadrados dos desvios na descida de gradiente estocástica"
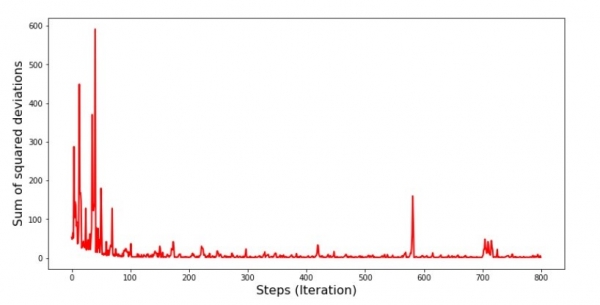
Depois de olhar o gráfico, tudo se torna claro e agora vamos corrigir isso.
Então, o que aconteceu? Aconteceu o seguinte. Quando escolhemos um mês aleatoriamente, o nosso algoritmo busca diminuir o erro no cálculo da receita para o mês escolhido. Em seguida, escolhemos outro mês e repetimos o cálculo, mas agora diminuímos o erro para o segundo mês escolhido. Agora, lembremos que os primeiros dois meses se desviam significativamente da linha da equação da regressão linear simples. Isso significa que, ao escolher qualquer um desses dois meses, ao diminuir o erro de cada um deles, nosso algoritmo aumenta drasticamente o erro em toda a amostra. Então, o que fazer? A resposta é simples: precisamos diminuir a taxa de descida. Pois, ao diminuir a taxa de descida, o erro também deixará de "saltar" para cima e para baixo. Na verdade, o erro não deixará de "saltar", mas fará isso de forma menos rápida :) Vamos verificar.
Código para executar o SGD com uma taxa de descida menor
# запустим функцию, уменьшив шаг в 100 раз и увеличив количество шагов соответсвующе
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])

print 'График №6 "Сумма квадратов отклонений по-шагово"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()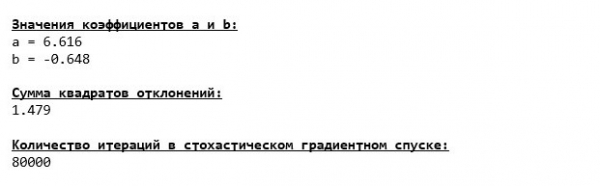
Gráfico nº 6 "Soma dos quadrados dos desvios na descida de gradiente estocástica (80 mil passos)"
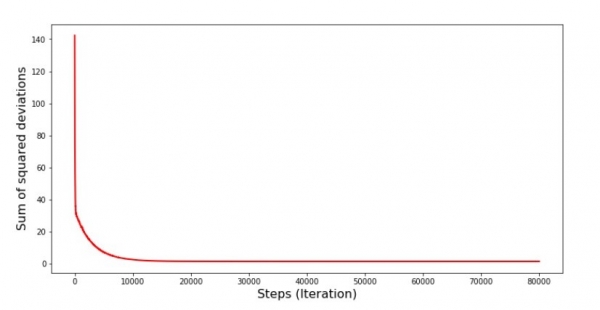
Os valores dos coeficientes melhoraram, mas ainda não estão ideais. Hipoteticamente, isso pode ser ajustado assim. Escolhemos, por exemplo, nas últimas 1000 iterações, os valores dos coeficientes com os quais houve o menor erro. Porém, para isso, teremos que registrar também os próprios valores dos coeficientes. Não faremos isso, mas vamos prestar atenção no gráfico. Ele parece suave e o erro diminui uniformemente. Na verdade, não é bem assim. Vamos olhar as primeiras 1000 iterações e compará-las com as últimas.
Código para o gráfico SGD (primeiros 1000 passos)
print 'Gráfico nº 7 "Soma dos quadrados das divergências passo a passo. Primeiras 1000 iterações"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][:1000])),
         list_parametres_stoch_gradient_descence[1][:1000], color='red', lw=2)
plt.xlabel('Passos (Iteração)', size=16)
plt.ylabel('Soma dos quadrados das divergências', size=16)
plt.show()

print 'Gráfico nº 7 "Soma dos quadrados das divergências passo a passo. Últimas 1000 iterações"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][-1000:])),
         list_parametres_stoch_gradient_descence[1][-1000:], color='red', lw=2)
plt.xlabel('Passos (Iteração)', size=16)
plt.ylabel('Soma dos quadrados das divergências', size=16)
plt.show()
Gráfico nº 7 "Soma dos quadrados das divergências SGD (primeiros 1000 passos)"
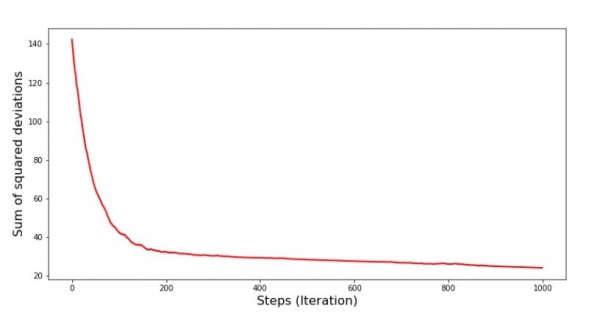
Gráfico nº 8 "Soma dos quadrados das divergências SGD (últimos 1000 passos)"
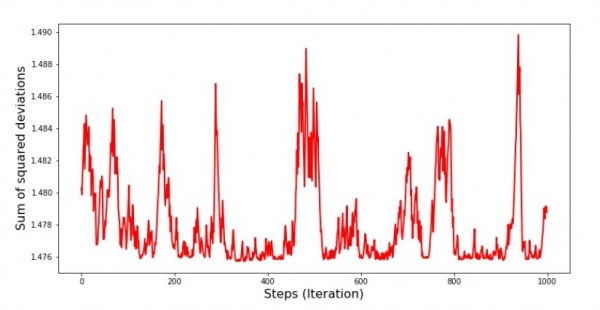
No início do descenso, observamos uma diminuição da erro bastante uniforme e acentuada. Nas últimas iterações, vemos que o erro oscila em torno de um valor de 1,475 e em alguns momentos até iguala esse valor ótimo, mas depois ainda assim sobe… Reitero, podemos registrar os valores dos coeficientes  e
 , e depois escolher aqueles em que o erro é mínimo. No entanto, temos um problema mais sério: tivemos que fazer 80 mil passos (veja o código) para obter valores próximos ao ideal. Isso, já contraria a ideia de economia de tempo de computação no descenso estocástico em relação ao gradiente. O que podemos ajustar e melhorar? Não é difícil notar que nas primeiras iterações estamos descendo com confiança e, portanto, deveríamos manter um passo grande nas primeiras iterações e, à medida que progredimos, diminuir esse passo. Não faremos isso neste artigo — ele já se prolongou demais. Os interessados podem pensar sozinhos sobre como fazer isso, não é difícil 🙂
Agora vamos executar o descenso estocástico do gradiente, utilizando a biblioteca NumPy (e não vamos tropeçar nas pedras que identificamos anteriormente)
Código para descida de gradiente estocástico (NumPy)
# для начала напишем функцию градиентного шага
def stoch_grad_step_numpy(vector_init, X, ind, y, l):
    x = X[ind]
    y_pred = np.dot(x,vector_init)
    err = y_pred - y[ind]
    grad_a = err
    grad_b = x[1]*err
    return vector_init - l*np.array([grad_a, grad_b])

# определим функцию стохастического градиентного спуска
def stoch_grad_descent_numpy(X, y, l=0.1, steps = 800):
    vector_init = np.array([[np.random.randint(X.shape[0])], [np.random.randint(X.shape[0])]])
    errors = []
    for i in range(steps):
        ind = np.random.randint(X.shape[0])
        new_vector = stoch_grad_step_numpy(vector_init, X, ind, y, l)
        vector_init = new_vector
        errors.append(error_square_numpy(vector_init,X,y))
    return (vector_init), (errors)

# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])
print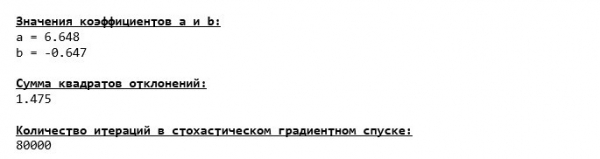
Os valores obtidos foram quase idênticos aos da descida sem uso de NumPy. No entanto, isso faz sentido.
Vamos descobrir quanto tempo levaram nossas descidas de gradiente estocástico.
Código para determinar o tempo de cálculo do SGD (80 mil passos)
print ' 33[1m' + ' 33[4m' +
"Tempo de execução da descida de gradiente estocástico sem usar a biblioteca NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' +
"Tempo de execução da descida de gradiente estocástico usando a biblioteca NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)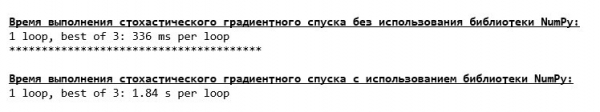
Quanto mais fundo na floresta, mais escuras se tornam as nuvens: novamente, a fórmula 'caseira' mostra um resultado melhor. Tudo isso nos leva a pensar que devem existir maneiras ainda mais sutis de utilizar a biblioteca NumPy, que realmente aceleram as operações de cálculo. Neste artigo, não saberemos sobre elas. Haverá o que pensar durante o tempo livre:)
Resumindo
Antes de resumir, gostaria de responder a uma pergunta que provavelmente surgiu ao nosso querido leitor. Para que, afinal, tais 'tormentos' com descidas, por que precisamos subir e descer (principalmente descer) uma montanha para encontrar o tão desejado vale, se temos em mãos um dispositivo tão poderoso e simples, na forma de uma solução analítica, que nos teletransporta instantaneamente ao lugar certo?
A resposta a essa pergunta é evidente. Agora examinamos um exemplo muito simples, em que a resposta verdadeira  depende de um sinal
 . Na vida real, isso não é comum, portanto vamos imaginar que temos 2, 30, 50 ou mais sinais. Adicionando a isso milhares, ou até dezenas de milhares de valores para cada sinal. Nesse caso, a solução analítica pode não suportar o teste e falhar. Por sua vez, a descida de gradiente e suas variações nos aproximarão lentamente, mas seguramente do objetivo — o mínimo da função. E quanto à velocidade, não se preocupe — certamente iremos explorar métodos que nos permitirão definir e regular o tamanho do passo (ou seja, a velocidade).
E agora, a breve conclusão.
Em primeiro lugar, espero que o material exposto no artigo ajude os iniciantes em "data science" a entender como resolver equações de regressão linear simples (e não só).
Em segundo lugar, analisamos várias maneiras de resolver a equação. Agora, dependendo da situação, podemos escolher a que melhor se adapta à tarefa proposta.
Em terceiro lugar, vimos a importância de ajustes adicionais, especificamente o tamanho do passo do método de descida de gradiente. Este parâmetro não pode ser negligenciado. Como mencionado anteriormente, para reduzir os custos de computação, o tamanho do passo deve ser ajustado à medida que avançamos na descida.
Em quarto lugar, no nosso caso, as funções "de nossa própria autoria" apresentaram um melhor tempo de cálculo. Provavelmente, isso se deve à aplicação não totalmente profissional das capacidades da biblioteca. NumPy. Mas, de qualquer forma, a conclusão é a seguinte. Por um lado, às vezes vale a pena questionar opiniões estabelecidas, e por outro lado, nem sempre é necessário complicar tudo — muitas vezes uma abordagem mais simples se mostra mais eficaz. E como nosso objetivo era analisar três abordagens na resolução da equação de regressão linear simples, o uso de funções "de nossa própria autoria" foi suficiente.
Literatura (ou algo do tipo)
1. Regressão Linear
2. Método dos Mínimos Quadrados
3. Derivada
4. Gradiente
5. Descida de Gradiente
6. Biblioteca NumPy
Fonte: habr.com
