

Em sua área de atuação, você pode se deparar com situações em que um desenvolvedor escreve uma consulta e pensa: “o banco é inteligente, ele resolve tudo sozinho!”«
Em alguns casos (parcialmente devido à falta de conhecimento sobre as capacidades do banco de dados, parcialmente devido a otimizações prematuras), essa abordagem resulta na criação de 'frankensteins'.
Primeiro, vou dar um exemplo dessa consulta:
-- para cada par chave, encontramos os valores associados dos campos
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- encontramos os valores min/max para cada primeira chave
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- conectamos pares chave pela primeira chave e valores min/max
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Para avaliar de forma concreta a qualidade da consulta, vamos criar um conjunto de dados aleatório:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
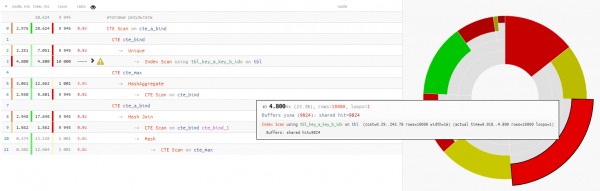
Aparentemente, a própria leitura de dados levou menos de um quarto do tempo total de execução da consulta:
Analisando detalhadamente
Vamos olhar bem para a consulta e nos questionar:
- Para que usar WITH RECURSIVE, se não há CTEs recursivos?
- Por que agrupar os valores min/max em um CTE separado, se depois eles ainda estão ligados à seleção original?
+25% do tempo - Por que usar no final uma leitura repetida do CTE anterior através do ‘SELECT * FROM’ incondicional?
+14% do tempo
Neste caso, tivemos muita sorte de que uma junção Hash foi escolhida em vez de Nested Loop, pois assim teríamos mais de uma única passagem de CTE Scan, mas 10K!
um pouco sobre CTE ScanAqui devemos lembrar que CTE Scan é análogo ao Seq Scan ou seja, sem indexação, apenas uma busca completa, que exigiria 10K x 0.3ms = 3000ms durante os ciclos por cte_max ou 1K x 1.5ms = 1500ms durante os ciclos por cte_bind!
Na verdade, o que se queria obter com isso? Ah, normalmente é essa a pergunta que aparece por volta do 5º minuto analisando consultas 'tridimensionais'.
Queríamos para cada par chave único apresentar min/max do grupo por key_a.
Então, vamos utilizar para isso :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 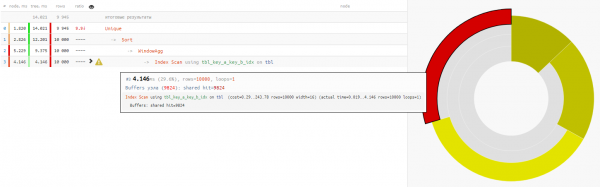
Como a leitura de dados em ambas as opções leva aproximadamente 4-5 ms, todo o nosso ganho de tempo -32% — é puro carga, removida da CPU do banco de dados, se tal solicitação for realizada com frequência suficiente.
Em geral, não devemos forçar o banco a "carregar redondo, empurrar quadrado".
Fonte: habr.com
