

Nota do tradutor.: Service mesh — um fenômeno que ainda não tem uma tradução estável para o português (mais de 2 anos atrás, sugerimos a expressão 'rede de serviços', e pouco depois alguns colegas começaram a promover ativamente a combinação 'malha de serviços'). As conversas constantes sobre essa tecnologia levaram a uma situação em que as partes de marketing e técnica estão entrelaçadas. Este material excepcional de um dos autores do termo original tem como objetivo trazer clareza para engenheiros e não só.
Quadrinho de
Introdução
Se você é um engenheiro de software trabalhando em sistemas de back-end, o termo 'service mesh' provavelmente já se firmou em sua mente nos últimos dois anos. Devido a uma estranha confluência de circunstâncias, essa expressão vem dominando a indústria cada vez mais, e o hype e as propostas de marketing associadas a ela estão crescendo como uma bola de neve descendo uma ladeira, sem mostrar sinais de desaceleração.
Service mesh nasceu em águas turvas e tendenciosas do ecossistema cloud native. Infelizmente, isso significa que uma parte significativa da polêmica relacionada varia de 'conversa vazio' a — se usarmos um termo técnico — pura bobagem. Mas se filtrarmos todo o ruído, podemos descobrir que a service mesh tem uma função real, definida e importante.
Nesta publicação, tentarei fazer exatamente isso: apresentar um guia honesto, profundo e voltado para engenheiros sobre service mesh. Pretendo responder não apenas à pergunta: “O que é isso?”, — mas também “Por quê?”, além de “Por que agora?”. Finalmente, tentarei descrever por que (na minha opinião) essa tecnologia específica gerou tanto alvoroço, que por si só é uma história interessante.
Quem sou eu?
Olá a todos! Meu nome é . Sou um dos criadores — do primeiro projeto service mesh e do projeto que é responsável pela criação do termo service mesh como tal (desculpe, pessoal!). (Nota de tradução.: A propósito, no início do surgimento desse termo, mais de 2,5 anos atrás, já traduzimos um material anterior do mesmo autor intitulado '».) Além disso, sou o responsável por — uma startup que cria coisas incríveis de service mesh, como Linkerd e .
Você deve suspeitar que eu tenho uma opinião bastante tendenciosa e subjetiva sobre este assunto. No entanto, farei o possível para minimizar a parcialidade (com exceção de uma seção: «Por que há tantas conversas sobre service mesh?», — na qual ainda assim compartilharei minhas ideias preconceituosas). Também farei todos os esforços para garantir que este guia seja o mais objetivo possível. Em exemplos específicos, eu principalmente me basearei na experiência do Linkerd, ao mesmo tempo em que indicarei as diferenças conhecidas que eu conheço (se houver) na implementação de outros tipos de service mesh.
Ok, é hora de passar para as partes interessantes.
O que é service mesh?
Apesar de todo o alvoroço, estruturalmente, a service mesh é bastante simples. Trata-se apenas de um conjunto de proxies de userspace localizados "perto" dos serviços (mais adiante falaremos um pouco sobre o que significa "perto"), além de um conjunto de processos de controle. Os proxies, em conjunto, são chamados de data plane, enquanto os processos de controle são denominados control plane. O data plane intercepta chamadas entre serviços e faz "diversas coisas" com elas; o control plane, por sua vez, coordena o comportamento dos proxies e proporciona acesso para você, ou seja, o operador, à API, permitindo manipular a rede e medi-la como um todo.
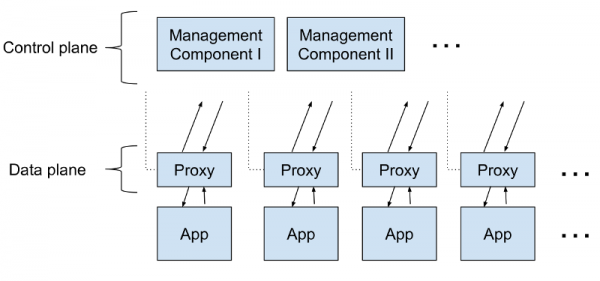
O que são esses proxies? São proxies TCP da categoria "Layer 7-aware" (ou seja, "conscientes" do nível 7 do modelo OSI) , como HAProxy e NGINX. Você pode escolher um proxy conforme sua preferência; o Linkerd utiliza um proxy em Rust, modestamente chamado de . Nós o construímos especialmente para a service mesh. Outras mesh preferem outros proxies (Envoy é uma escolha comum). No entanto, a escolha do proxy é apenas uma questão de implementação.
O que fazem esses proxies? Obviamente, eles encaminham chamadas para os serviços e deles (estritamente falando, eles atuam tanto como proxies regulares quanto como proxies reversos, lidando com chamadas de entrada e saída). E eles implementam um conjunto de funções que se concentra nas chamadas entre serviços. Esse foco no tráfego entre serviços é o que diferencia os proxies de service mesh de, por exemplo, gateways de API ou proxies de ingress (os últimos se concentram nas chamadas que chegam ao cluster do mundo externo). (Nota do tradutor.: comparação de controladores Ingress existentes para Kubernetes, muitos dos quais já utilizam o Envoy mencionado anteriormente, veja em .)
Agora que entendemos o data plane, o control plane é mais simples: trata-se de um conjunto de componentes que garantem toda a mecânica necessária para que o data plane opere de forma coordenada, incluindo a descoberta de serviços, a emissão de certificados TLS, a agregação de métricas, entre outros. O data plane informa o control plane sobre seu comportamento; por sua vez, o control plane fornece uma API que permite alterar e monitorar o comportamento do data plane como um todo.
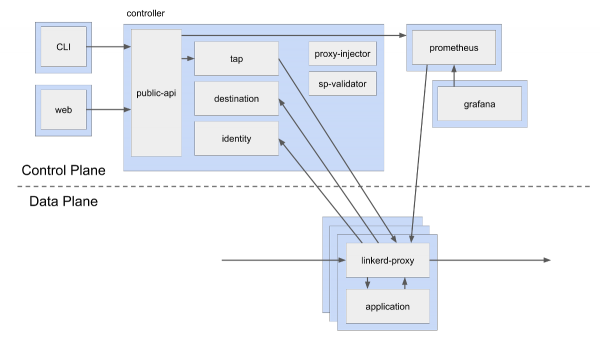
Abaixo está o diagrama do control plane e do data plane no Linkerd. Como pode ser visto, o control plane inclui vários componentes diferentes, incluindo uma instância do Prometheus que coleta métricas dos proxies, bem como outros componentes, como destino (descoberta de serviços), identidade (centro de certificação, CA) e public-api (endpoints para web e CLI). Ao contrário disso, o data plane consiste em um simples linkerd-proxy ao lado da instância do aplicativo. Este é apenas um diagrama lógico; em condições reais de implantação, você pode ter três réplicas de cada componente do control plane e centenas ou milhares de proxies no data plane.
(Os retângulos azuis neste diagrama simbolizam os limites dos pods do Kubernetes. É visível que os containers com o linkerd-proxy estão no mesmo pod que os containers do aplicativo. Esse tipo de diagrama é conhecido como container sidecar..)
A arquitetura de service mesh tem algumas implicações importantes. Primeiro, como a função do proxy é interceptar chamadas entre serviços, a service mesh só faz sentido se seu aplicativo for construído em um determinado conjunto de serviços. Mesh é possível pode ser utilizada com monólitos, mas isso é claramente excessivo para um único proxy, e sua funcionalidade provavelmente não será necessária.
Outra implicação importante é que a service mesh requer uma quantidade enorme de proxies. Na verdade, o Linkerd acopla o linkerd-proxy a cada instância de cada serviço (outras implementações adicionam proxies a cada nó/hospedeiro/máquina virtual. Em qualquer caso, isso não é pouco). O uso intensivo de proxies, por si só, traz uma série de complicações adicionais:
- Os proxies no data plane devem ser rápidos,pois para cada chamada há um par de acessos aos proxies: um do lado do cliente, um do lado do servidor.
- Além disso, os proxies devem ser pequenos, e levianos. Cada um consumirá recursos de memória e CPU, e esse consumo crescerá linearmente com o aplicativo.. Cada uma consumirá recursos de memória e CPU, e esse consumo crescerá linearmente junto com o aplicativo.
- Você precisará de um mecanismo para implantar e atualizar um grande número de proxies. Fazer isso manualmente não é uma opção.
Em geral, o service mesh parece assim (pelo menos do ponto de vista de um observador): você implanta um monte de proxies em userspace que "fazem algo" com o tráfego interno entre serviços, e usa o control plane para monitorar e gerenciá-los.
Chegou a vez da pergunta "Por quê?"
Para que serve o service mesh?
Aqueles que se deparam pela primeira vez com a ideia de service mesh podem sentir um leve tremor. A estrutura do service mesh significa que não apenas aumentará a latência no aplicativo, mas também consumirá recursos e adicionará uma infinidade de novos mecanismos à infraestrutura. Primeiro você instala o service mesh, e então de repente descobre que precisa gerenciar centenas (se não milhares) de proxies. A pergunta que fica é: quem se voluntariará para isso?
A resposta para essa pergunta consiste em duas partes. Primeiro, os custos operacionais associados à implantação desses proxies podem ser significativamente reduzidos devido a algumas mudanças que estão ocorrendo no ecossistema (mais sobre isso depois).
Em segundo lugar, esse tipo de dispositivo é, na verdade, uma ótima maneira de introduzir lógica adicional no sistema. E não apenas porque, com o service mesh, é possível adicionar muitas novas funcionalidades, mas também porque isso pode ser feito sem interferir no ecossistema. Na verdade, todo o modelo de service mesh é baseado nesse postulado: em um sistema multi-serviço, independentemente do que façam os serviços individuais, o tráfego entre eles é o ponto ideal para adicionar funcionalidade.
Por exemplo, no Linkerd (assim como na maioria dos mesh), a funcionalidade é predominantemente focada em chamadas HTTP, incluindo HTTP/2 e gRPC*. A funcionalidade é bastante rica — pode ser dividida em três categorias:
- Funções relacionadas a confiabilidade. Requisições reenviadas, timeouts, abordagem canária (divisão/redirecionamento de tráfego), etc.
- Funções relacionadas a monitoramento.Agregação de métricas de sucesso, latências e volumes de requisições para cada serviço ou para trajetórias específicas; construção de mapas topológicos de serviços, etc.
- Funções relacionadas a segurança. Mutual TLS, controle de acesso, etc.
* Do ponto de vista do Linkerd, gRPC não difere muito do HTTP/2: apenas utiliza protobuf na carga útil. Do ponto de vista do desenvolvedor, essas duas coisas são, obviamente, diferentes.
Muitos desses mecanismos operam no nível das solicitações (daí o ‘L7-proxy’). Por exemplo, se o serviço Foo faz uma chamada HTTP ao serviço Bar, o linkerd-proxy do lado de Foo pode realizar um balanceamento de carga inteligente e direcionar as chamadas de Foo para instâncias de Bar dependendo da latência observada; ele pode repetir a solicitação se necessário (e se for idempotente); ele pode registrar o código de resposta e o tempo de espera, etc. Da mesma forma, o linkerd-proxy do lado de Bar pode rejeitar uma solicitação se ela não for permitida ou se o limite de solicitações for excedido; pode registrar a latência do seu lado, etc.
Os proxies podem 'fazer algo' também no nível da conexão. Por exemplo, o linkerd-proxy do lado de Foo pode iniciar uma conexão TLS, enquanto o linkerd-proxy do lado de Bar pode encerrá-la, e ambas as partes podem verificar os certificados TLS uma da outra*. Isso garante não apenas a criptografia entre os serviços, mas também uma forma criptograficamente segura de identificar os serviços: Foo e Bar podem 'provar' que são quem dizem ser.
* 'Uma da outra' significa que o certificado do cliente também é verificado (mutual TLS). No TLS 'clássico', por exemplo, entre o navegador e o servidor, geralmente apenas o certificado de um dos lados (o servidor) é verificado.
Independentemente de funcionarem no nível das solicitações ou das conexões, é importante ressaltar que todas as funções da service mesh têm um caráter operacional. O Linkerd não é capaz de transformar a semântica da carga útil — por exemplo, adicionar campos a um fragmento JSON ou fazer modificações no protobuf. Vamos abordar essa importante característica mais tarde, quando falarmos sobre ESB e middleware.
Esse é o conjunto de funcionalidades que a service mesh oferece. Surge a pergunta: por que não implementá-las diretamente no aplicativo? E por que se envolver com proxies?
Por que a service mesh é uma boa ideia
Embora as capacidades da service mesh sejam fascinantes, seu valor real não reside nas funcionalidades. Afinal, nós baixar o preço, nós o faremos. De fato, nossos computadores custam menos do que alguns anos atrás ou até mesmo no ano passado. Mas o mesmo pode ser dito sobre a IBM. Nosso objetivo é fornecer computadores para dezenas de milhões de pessoas, e quanto mais baratos forem esses computadores, mais fácil será fazê-lo. Se o Macintosh custasse mil dólares, eu estaria implementá-los diretamente na aplicação (mais adiante veremos que essa foi a origem da service mesh). Se tentarmos expressar este pensamento em uma frase, o valor da service mesh é o seguinte: ela fornece funcionalidades essenciais para o funcionamento do software de servidor moderno, de forma uniforme para toda a pilha e independente do código da aplicação.
Vamos analisar esta frase.
«Funcionalidades essenciais para o funcionamento do software de servidor modernoSe você está criando uma aplicação de servidor transacional, conectada à internet pública, que recebe solicitações do mundo exterior e responde a elas em curto período — como um aplicativo web, um servidor API, e de fato a grande maioria de outras aplicações modernas — e se você o implementa como um conjunto de serviços que interagem entre si de forma síncrona, e se você está constantemente modernizando esse software, adicionando novas funcionalidades, e se você precisa manter esse sistema em funcionamento durante o processo de modificação — nesse caso, parabéns, você está criando software de servidor moderno. E todas essas funcionalidades fantásticas mencionadas acima são, na verdade, essenciais para você. A aplicação deve ser confiável, segura e você deve ter a capacidade de monitorar o que ela está fazendo. É exatamente essas questões que a service mesh ajuda a resolver.
(Ok, ainda assim, minha convicção de que essa abordagem é o modo moderno de criar software de servidor acabou infiltrando-se no parágrafo anterior. Outros preferem desenvolver monólitos, 'microsserviços reativos' e outras coisas que não se encaixam na definição acima. Essas pessoas certamente têm uma opinião diferente da minha. Por sua vez, eu acredito que elas 'estão erradas' — embora, de qualquer forma, a service mesh não seja muito útil para elas).
«Uniforme para toda a pilhaAs funcionalidades fornecidas pela service mesh não são apenas essenciais. Elas se aplicam a todos os serviços na aplicação, independentemente da linguagem em que foram escritas, qual framework utilizam, quem as escreveu, como foram implementadas e todas as outras nuances de seu desenvolvimento e uso.
«Independente do código da aplicaçãoPor fim, o service mesh não apenas fornece funcionalidades unificadas para toda a pilha, mas o faz de uma maneira que não requer a modificação do aplicativo. A base fundamental da funcionalidade do service mesh, incluindo tarefas de configuração, atualização, operação, manutenção, etc., está exclusivamente no nível da plataforma e é independente do aplicativo. O aplicativo pode mudar sem afetar o service mesh. Por sua vez, o service mesh pode mudar sem qualquer participação do aplicativo.
Em resumo, o service mesh não apenas fornece funções vitais, mas o faz de maneira global, uniforme e independente do aplicativo. Portanto, embora a funcionalidade do service mesh possa ser implementada no código do serviço (por exemplo, na forma de uma biblioteca incluída em cada serviço), essa abordagem não garantirá a homogeneidade e a independência que são tão valiosas no caso do service mesh.
E tudo que é necessário para isso é adicionar um monte de proxies! Prometo que em breve discutiremos os custos operacionais associados à adição desses proxies. Mas primeiro, vamos parar e olhar para essa ideia de independência sob diferentes perspectivas. as pessoas.
Quem se beneficia do service mesh?
Por mais inconveniente que seja, para que uma tecnologia se torne uma parte importante do ecossistema, ela precisa ser adotada pelas pessoas. Então, quem está interessado no service mesh? Quem se beneficia do seu uso?
Se você está desenvolvendo software de servidor moderno, pode imaginar sua equipe como um grupo de proprietários de serviços, que juntos desenvolvem e implementam a lógica de negócios, e de proprietários de plataformas, que se ocupam do desenvolvimento da plataforma interna sobre a qual esses serviços operam. Em organizações menores, essas podem ser as mesmas pessoas, mas com o crescimento da empresa, esses papéis tendem a se tornar mais distintos e até se dividir em subpapéis... (Muita coisa pode ser dita sobre a natureza em mudança do devops, a influência organizacional dos microsserviços, etc. Mas, por enquanto, vamos aceitar essas descrições como um dado.)
Sob essa perspectiva, os beneficiários claros da service mesh são os proprietários da plataforma. Afinal, o objetivo da equipe da plataforma é criar uma plataforma interna onde os proprietários dos serviços possam implementar a lógica de negócios de uma forma que garanta a máxima independência dos complicados detalhes de sua exploração. A service mesh não apenas oferece recursos críticos para alcançar esse objetivo, mas o faz de uma maneira que, por sua vez, não impõe dependências aos proprietários dos serviços.
Os proprietários dos serviços também se beneficiam, embora de maneira mais indireta. O objetivo do proprietário do serviço é ser o mais produtivo possível na implementação da lógica do processo de negócios, e quanto menos ele precisar se preocupar com questões de operação, melhor. Em vez de lidar com a implementação de, digamos, políticas de reenvio ou TLS, eles podem se concentrar exclusivamente nas tarefas de negócios e esperar que a plataforma cuide do restante. Para eles, isso é uma grande vantagem.
O valor organizacional desse tipo de separação entre os proprietários de plataformas e serviços é difícil de superestimar. Eu acredito que ele contribui o principal para o valor da service mesh.
Aprendemos essa lição quando um dos primeiros fãs do Linkerd nos contou por que escolheram a service mesh: porque ela lhes permitiu "minimizar a conversa desnecessária". Aqui estão alguns detalhes: a equipe de uma grande empresa migrou sua plataforma para Kubernetes. Como o aplicativo lidava com informações confidenciais, eles queriam criptografar todas as comunicações nos clusters. No entanto, a situação se complicou com a presença de centenas de serviços e centenas de equipes de desenvolvedores. A perspectiva de entrar em contato com todos e convencê-los a incluir suporte para TLS em seus planos não os agradava nem um pouco. Ao instalar o Linkerd, eles transferiram a responsabilidade dos desenvolvedores (para quem isso era um incômodo extra) para os membros da equipe de plataformas, para quem isso era uma prioridade de alto nível. Em outras palavras, o Linkerd resolveu para eles não apenas um problema técnico, mas também uma questão organizacional.
Em suma, a service mesh é mais uma solução não técnica, mas sim socio-técnica do problema. (Obrigado por apresentar esse termo.)
A service mesh resolverá todos os meus problemas?
Sim. Quero dizer, não!
Ao olhar para as três classes de funções mencionadas acima: confiabilidade, segurança e observabilidade, fica claro que um service mesh não é uma solução completa para nenhum desses problemas. Embora o Linkerd possa enviar solicitações de repetição (se souber que são idempotentes), ele não é capaz de decidir o que retornar ao usuário se o serviço falhar completamente — tais decisões devem ser tomadas pelo aplicativo. O Linkerd pode rastrear estatísticas de solicitações bem-sucedidas, no entanto, não consegue inspecionar o serviço e fornecer suas métricas internas — tal ferramenta deve estar no aplicativo. E embora o Linkerd seja capaz de organizar mTLS, soluções abrangentes em segurança exigem muito mais.
Um subconjunto de funções nessas áreas, oferecidas pelo service mesh, refere-se a funcionalidades da plataforma. Com isso, quero dizer funções que:
- São independentes da lógica de negócios. A maneira como os histogramas de chamadas entre Foo e Bar são construídos não depende de por que Foo chamando Bar.
- É difícil implementar corretamente. No Linkerd, as tentativas de repetição são parametrizadas com recursos sofisticados, como orçamentos de tentativas de repetição (retry budgets), pois uma abordagem direta na implementação dessas coisas provavelmente levará à chamada 'avalanche de solicitações' (retry storm) e outros problemas característicos de sistemas distribuídos.
- São mais eficazes quando aplicadas de maneira uniforme. O mecanismo TLS só faz sentido se for aplicado em todos os lugares.
Como essas funções são implementadas no nível de proxy (e não no nível do aplicativo), o service mesh as fornece no nível plataforma, e não do aplicativo. Assim, não importa em que linguagem os serviços são escritos, qual framework eles usam, quem os escreveu e por quê. Os proxies operam além de todos esses detalhes, e a base fundamental dessa funcionalidade, incluindo tarefas de configuração, atualização, operação, manutenção, etc., está exclusivamente no nível da plataforma.
Exemplos de recursos do service mesh
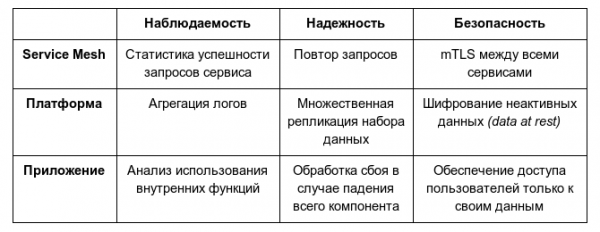
Em resumo, quero dizer que o service mesh não é uma solução completa para garantir confiabilidade, observabilidade ou segurança. A abrangência dessas áreas implica a participação obrigatória dos proprietários dos serviços, das equipes de Ops/SRE e de outros atores da empresa. O service mesh oferece apenas um "recorte" em nível de plataforma para cada uma dessas áreas.
Por que o service mesh se tornou popular agora?
Provavelmente, neste momento você está se perguntando: ok, se o service mesh é tão bom, por que não começamos a implantar milhões de proxies na pilha há aproximadamente dez anos?
Há uma resposta óbvia para essa pergunta: há dez anos, todos construíam monólitos, e o service mesh não era necessário para ninguém. Isso é verdade, mas, a meu ver, essa resposta perde a essência. Mesmo há dez anos, o conceito de microserviços como uma maneira promissora de construir sistemas em larga escala era amplamente discutido e aplicado em empresas como Twitter, Facebook, Google e Netflix. A percepção geral — pelo menos nas partes da indústria com as quais eu entrei em contato — era de que microserviços eram a "maneira certa" de criar grandes sistemas, mesmo que isso fosse incrivelmente difícil.
Claro, embora há dez anos houvesse empresas explorando microserviços, elas não estavam simplesmente enfiando proxies por todo lado para formar um service mesh. No entanto, ao olhar mais de perto, elas estavam fazendo algo similar: muitas dessas empresas exigiam o uso de uma biblioteca interna especial para interações de rede (às vezes chamada de biblioteca de cliente robusto, fat client library).
A Netflix tinha o Hysterix, o Google tinha o Stubby, o Twitter tinha a biblioteca Finagle. A Finagle, por exemplo, era obrigatória para cada novo serviço no Twitter. Ela gerenciava tanto a parte cliente quanto a parte servidor das conexões, permitia a realização de chamadas de repetição, suportava roteamento de solicitações, balanceamento de carga e medições. Ela fornecia uma camada consistente de confiabilidade e observabilidade para toda a pilha do Twitter, independentemente do que o serviço estava fazendo. Claro, ela funcionava apenas para linguagens da JVM e se baseava no modelo de programação que precisava ser utilizado por toda a aplicação. No entanto, suas funcionalidades eram quase as mesmas que as de um service mesh. (Na verdade, a primeira versão do Linkerd era apenas o Finagle envolto em uma forma de proxy.)
Dessa forma, há dez anos, não existiam apenas microsserviços, mas também bibliotecas de proto-service-mesh que abordavam os mesmos problemas que o service mesh resolve hoje. No entanto, o próprio service mesh ainda não existia. Um novo movimento precisava acontecer antes que ele surgisse.
E é aqui que reside uma resposta mais profunda, oculta em outra mudança que ocorreu nos últimos 10 anos: houve uma queda acentuada nos custos de implantação de microsserviços. As empresas mencionadas anteriormente, que usavam microsserviços há dez anos: Twitter, Netflix, Facebook, Google - eram empresas de enorme escala e recursos. Elas tinham não apenas a necessidade, mas também a capacidade de construir, implantar e operar grandes aplicativos baseados em microsserviços. A energia e o esforço que os engenheiros do Twitter dedicaram à transição de um modelo monolítico para um modelo de microsserviços são verdadeiramente impressionantes. (Sinceramente, assim como o fato de que isso foi alcançado.) Esse tipo de manobra de infraestrutura era impossível para empresas menores naquela época.
Vamos para o presente. Hoje, existem startups onde a relação de microsserviços por desenvolvedor é de 5:1 (ou até ), e mais, elas estão lidando com isso com sucesso! Se uma startup de 5 pessoas pode, sem esforço, operar 50 microsserviços, isso significa que algo claramente reduziu o custo de sua implementação.
1500 microsserviços na Monzo; cada linha - uma regra de rede prescrita que permite o tráfego
A queda acentuada no custo de operação dos microsserviços é resultado de um único processo: o aumento da popularidade dos contêineres e dos orquestradores. É exatamente aqui que reside a resposta profunda para a pergunta sobre o que favoreceu o surgimento do service mesh. A mesma tecnologia tornou atraentes tanto o service mesh quanto os microsserviços: Kubernetes e Docker.
Por quê? Bem, o Docker resolve um grande problema - o problema do empacotamento. Ao empacotar um aplicativo e suas dependências de runtime (não relacionadas à rede) em um contêiner, o Docker transforma o aplicativo em uma unidade intercambiável que pode ser implantada e executada em qualquer lugar. Ao mesmo tempo, ele simplifica significativamente a operação multilíngue stack: uma vez que o contêiner é uma unidade atômica de execução, para fins de implementação e operação não importa o que está dentro, seja um aplicativo em JVM, Node, Go, Python ou Ruby. Você simplesmente o inicia, e pronto.
Kubernetes leva tudo a um novo nível. Agora que há um monte de "coisas executáveis" e várias máquinas onde podem ser executadas, surge a necessidade de uma ferramenta capaz de mapeá-las umas às outras. Em termos amplos, você fornece ao Kubernetes muitos contêineres e muitas máquinas, e ele os alinha uns com os outros (claro, este é um processo dinâmico e em constante mudança: novos contêineres se movem pelo sistema, máquinas são ligadas e desligadas, etc. No entanto, o Kubernetes leva tudo isso em consideração).
Depois de configurar o Kubernetes, o tempo gasto na implementação e operação de um serviço não difere muito do gasto na implementação e operação de dez serviços (na verdade, eles são praticamente semelhantes até mesmo para 100 serviços). Adicione a isso os contêineres como um mecanismo de embalagem, que incentiva a implementação multilíngue, e você terá uma abundância de novos aplicativos implementados na forma de microsserviços, escritos em várias linguagens — exatamente o tipo de ambiente que se adapta tão bem ao service mesh.
Então, chegamos à resposta da pergunta, por que a ideia de service mesh se tornou popular agora: a homogeneidade que o Kubernetes oferece para os serviços é diretamente aplicável às tarefas operacionais enfrentadas pelo service mesh. Você empacota proxies em contêineres, fornece ao Kubernetes a tarefa de colocá-los onde for possível, e voilà! O resultado é um service mesh, sendo todo o mecanismo de sua implementação alimentado pelo Kubernetes. (Pelo menos, visto de uma perspectiva ampla. Claro, neste processo há muitos detalhes.)
Em resumo: a razão pela qual o service mesh se tornou popular agora, e não há dez anos, é que o Kubernetes e o Docker não apenas aumentaram significativamente a demanda por isso, simplificando a implementação de aplicativos como conjuntos de microsserviços multilíngues, mas também reduziram substancialmente os custos de sua operação, fornecendo mecanismos de implementação e suporte para grupos de proxies sidecar.
Por que há tanta conversa sobre service mesh?
Aviso: nesta seção, recorro a todas as suposições, adivinhações, conjecturas e informações internas.
Ao pesquisar pela expressão "service mesh", você encontrará uma abundância de conteúdos reprocessados com baixo valor, projetos estranhos e um caleidoscópio de distorções que parecem dignas de uma câmara de eco. Essa é uma característica comum a qualquer nova tecnologia em voga, mas no caso do service mesh, o problema é especialmente agudo. Por quê?
Bem, parte da culpa é minha. Eu me esforcei ao máximo para promover o Linkerd e o service mesh sempre que tive a oportunidade, através de inúmeras publicações em blogs e artigos como este. Mas eu não sou tão poderoso. Para realmente responder a essa pergunta, precisamos falar um pouco sobre a situação geral. E para discutir isso, não podemos deixar de mencionar um projeto: — um service mesh de código aberto, desenvolvido em conjunto pela Google, IBM e Lyft.
(Essas três empresas têm papéis muito diferentes: a participação da Lyft parece se restringir apenas ao nome; eles são os criadores do Envoy, mas não utilizam o Istio nem participam de seu desenvolvimento. A IBM participa do desenvolvimento do Istio e o utiliza. A Google está ativamente envolvida no desenvolvimento do Istio, mas, pelo que posso perceber, na verdade não o usa.)
O projeto Istio é notável por duas características. Em primeiro lugar, os enormes esforços de marketing que a Google, em particular, dedica à sua promoção. De acordo com minhas estimativas, a maioria das pessoas que conhece o conceito de service mesh atualmente tomou conhecimento dele pela primeira vez graças ao Istio. A segunda característica é o quão mal o Istio foi recebido. Isso pode parecer uma opinião enviesada, mas mesmo tentando ser o mais objetivo possível, eu não posso deixar de , que não é exatamente tipicamente característico (embora não seja único: penso no systemd, …) para um projeto de código aberto.
(Na prática, o Istio parece ter problemas não apenas com a complexidade e a experiência do usuário, mas também com o desempenho. Por exemplo, durante a , conduzida por terceiros, especialistas encontraram situações em que as caudas de latência do Istio eram 100 vezes maiores do que o pontuais correspondentes do Linkerd, além de situações de falta de recursos, onde o Linkerd continuou funcionando com sucesso, enquanto o Istio parava completamente.)
Deixando de lado minhas teorias sobre o porquê disso ter acontecido, acredito que o grande alvoroço em torno do service mesh se explica principalmente pela participação do Google. Especificamente, pela combinação dos seguintes três fatores:
- a promoção insistente do Istio por parte do Google;
- a correspondente reação crítica e desaprovadora ao projeto;
- o recente crescimento acelerado da popularidade do Kubernetes, cujas lembranças ainda estão frescas.
Juntos, esses fatores se combinam em um ambiente sedutor e sem oxigênio, onde a capacidade de raciocínio racional se enfraquece, deixando apenas uma maravilhosa variedade de .
Do ponto de vista do Linkerd, eu diria que isso é... uma bênção ambígua. Quero dizer, é maravilhoso que o service mesh tenha se tornado mainstream — o que não acontecia em 2016, quando o Linkerd foi introduzido e era realmente difícil chamar a atenção das pessoas para o projeto. Agora, esse problema não existe mais! Mas o lado negativo é que a situação com o service mesh hoje está tão confusa que é praticamente impossível entender quais projetos realmente pertencem à categoria de service mesh (sem mencionar que, em alguns casos, o Istio ou outro projeto pode ser mais adequado do que o Linkerd, uma vez que este último ainda não é uma solução universal).
Da parte do Linkerd, nossa estratégia tem sido ignorar o barulho, continuar focando na resolução de problemas reais da comunidade e, essencialmente, esperar até que o alvoroço diminua. No final, o hype vai passar e poderemos continuar nosso trabalho em paz.
Por enquanto, todos nós teremos que ter um pouco de paciência.
O service mesh será útil para mim, um simples software engineer?
A resposta para essa pergunta pode ser ajudada pelo seguinte questionário:
Você se dedica exclusivamente à implementação da lógica de negócios? Nesse caso, o service mesh não será útil para você. Claro, você pode se interessar por isso, mas, idealmente, o service mesh não deveria impactar diretamente nada em seu ambiente. Continue trabalhando no que você é pago para fazer.
Você mantém uma plataforma em uma empresa que utiliza Kubernetes? Sim, nesse caso você precisa de um service mesh (claro, a menos que você esteja usando o K8s apenas para rodar um monolito ou processamento em lote — mas então eu gostaria de saber por que você precisa do K8s). É bem provável que você se encontre em uma situação com vários microserviços escritos por pessoas diferentes. Todos eles interagem uns com os outros e estão entrelaçados em uma teia de dependências em tempo de execução, e você precisa encontrar uma maneira de lidar com tudo isso. A aplicação do Kubernetes permite escolher um service mesh que se adapte às suas necessidades. Para isso, familiarize-se com suas capacidades e características e responda à pergunta se algum projeto existente se encaixa para você (recomendo começar a pesquisa com o Linkerd).
Você está gerenciando a plataforma em uma empresa que NÃO usa Kubernetes, mas utiliza microserviços? Nesse caso, um service mesh será útil, porém seu uso não será trivial. Claro, você pode emular o funcionamento de um service mesh, instalando uma quantidade de proxies, mas a grande vantagem do Kubernetes é exatamente o modelo de implantação: gerenciar esses proxies manualmente exigirá muito mais tempo, esforço e custo.
Você é responsável pela plataforma em uma empresa que trabalha com monolitos? Nesse caso, um service mesh provavelmente não é necessário. Se você trabalha com monolitos (ou até com conjuntos de monolitos) que possuem padrões de interação bem definidos e raramente mudam, então um service mesh pouco poderá lhe oferecer. Portanto, você pode simplesmente ignorá-lo e esperar que ele desapareça como um pesadelo...
Conclusão
Acho que não devemos chamar o service mesh de "a tecnologia mais hypada do mundo" — essa honra duvidosa provavelmente pertence ao bitcoin ou à IA. Talvez ele esteja entre os cinco primeiros. Mas se você conseguir olhar além do ruído e da agitação, fica claro que o service mesh oferece benefícios reais para quem está criando aplicativos no Kubernetes.
Eu gostaria que você experimentasse o Linkerd — sua instalação em um cluster Kubernetes (ou mesmo no Minikube em um notebook) , e você poderá ver por si mesmo o que eu estou dizendo.
FAQ
— Se eu ignorar o service mesh, ele vai desaparecer?
— Sinto lhe informar: o service mesh está aqui para ficar.
— Mas eu NÃO QUERO usar service mesh!
— Bem, então não use! Apenas leia meu questionário acima para entender se deve conhecer pelo menos os conceitos básicos.
— Não é esse o velho e bom ESB/middleware com um novo molho?
— O service mesh lida com a lógica operacional, e não com o significado. da barra de serviços da empresa (). Manter essa separação ajuda o service mesh a evitar o mesmo destino.
— Como o service mesh se diferencia das APIs gateway?
— Existem milhões de artigos sobre o tema. Basta pesquisar no Google.
— O Envoy é um service mesh?
— Não, o Envoy não é um service mesh, é um servidor proxy. Ele pode ser usado para organizar um service mesh (e muito mais — é um proxy de uso geral). Mas por si só, não é um service mesh.
— O Network Service Mesh é um service mesh?
— Não. Apesar do nome, não é um service mesh (maravilhas do marketing, não é mesmo?).
— O service mesh vai ajudar meu sistema assíncrono reativo baseado em filas de mensagens?
— Não, o service mesh não vai ajudar.
— Qual service mesh eu devo usar?
— , é óbvio.
— O artigo é uma porcaria! / O autor deve ir para a m...!
— Por favor, compartilhe o link com todos os seus amigos, para que eles possam ver isso!
Agradecimentos
Como você provavelmente adivinhou pelo título, este artigo foi inspirado pelo fantástico tratado de Jay Kreps "". Conheci o Jay há dez anos, quando fiz uma entrevista no LinkedIn, e desde então ele tem sido uma inspiração para mim.
Embora eu goste de me chamar de "desenvolvedor do Linkerd", a realidade é que sou mais um mantenedor do arquivo README.md do projeto. Hoje, o Linkerd é desenvolvido por , , pessoas, e esse projeto não teria acontecido sem a participação da comunidade incrível de colaboradores e usuários.
E, para finalizar, um agradecimento especial ao criador do Linkerd, (primus inter pares), que junto comigo mergulhou de cabeça há muitos anos nessa confusão do service mesh.
P.S. do tradutor
Confira também em nosso blog:
- «»;
- «»;
- «»;
- «»;
- «».
Fonte: habr.com
