

Com o fim das vendas do sistema de log e analytics Splunk na Rússia, surgiu a questão de qual solução pode ser utilizada como substituta. Após dedicar um tempo para explorar diferentes opções, decidi pela solução para um verdadeiro macho — «ELK stack». Este sistema requer tempo para configuração, mas, em resultado, é possível obter um sistema muito poderoso para análise do estado e resposta rápida a incidentes de segurança da informação na organização. Neste ciclo de artigos, iremos examinar as funcionalidades básicas (e talvez não tão básicas) da pilha ELK, como podemos fazer o parsing de logs, construir gráficos e dashboards, e quais funções interessantes podem ser realizadas a partir dos logs de um firewall Check Point ou um scanner de segurança OpenVas. Para começar, vamos analisar o que é a pilha ELK e quais componentes a compõem.
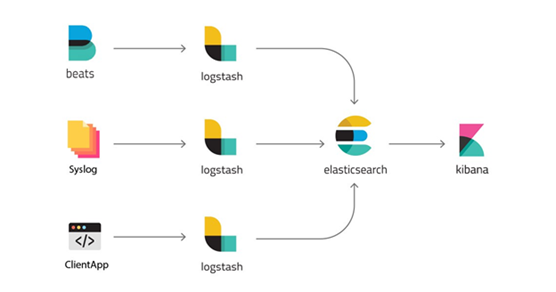
«ELK stack» — é uma abreviação de três projetos de código aberto: Elasticsearch, Logstash e Kibana. Desenvolvido pela empresa Elastic juntamente com todos os projetos relacionados. Elasticsearch é o núcleo de todo o sistema, que combina funções de banco de dados, sistema de busca e análise. Logstash é um pipeline de processamento de dados no lado do servidor que coleta dados de várias fontes simultaneamente, faz o parsing de logs, e em seguida envia para o banco de dados Elasticsearch. Kibana permite que os usuários visualizem os dados por meio de gráficos e diagramas no Elasticsearch. Também é possível administrar o banco de dados através do Kibana. Vamos analisar cada sistema separadamente em mais detalhes.
Logstash
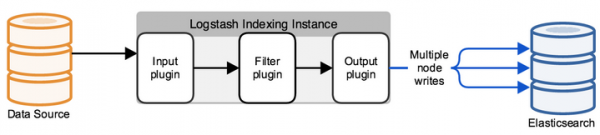
Logstash é uma ferramenta para processar logs de eventos de várias fontes, permitindo que você extraia campos e seus valores de uma mensagem, além de configurar filtragem e edição de dados. Após todas as manipulações, o Logstash redireciona os eventos para o armazenamento de dados final. A ferramenta é configurada apenas através de arquivos de configuração.
Uma configuração típica do Logstash consiste em arquivo(s) contendo várias entradas de fluxo de informação (input), vários filtros para essa informação (filter) e várias saídas (output). Isso se apresenta como um ou mais arquivos de configuração que, na sua forma mais simples (que não faz nada), se parece com isso:
input {
}

filter {
}

output {
}
No INPUT, configuramos a qual porta os logs serão enviados e por qual protocolo, ou de qual pasta ler arquivos novos ou que estão sempre sendo gravados. No FILTER, configuramos o parser de logs: a análise de campos, a edição de valores, a adição de novos parâmetros ou a remoção. FILTER é um campo para gerenciar a mensagem que chega ao Logstash com uma variedade de opções de edição. No output, configuramos para onde enviamos o log já analisado; caso seja Elasticsearch, enviamos uma solicitação JSON, contendo os campos com os valores, ou, no âmbito do debug, podemos exibir no stdout ou gravar em um arquivo.
ElasticSearch
Inicialmente, o Elasticsearch é uma solução para busca de texto completo, mas com recursos adicionais como fácil escalabilidade, replicação e outros, que tornam o produto muito conveniente e uma boa solução para projetos de alta carga com grandes volumes de dados. Elasticsearch é um armazenamento de documentos não relacional (NoSQL) no formato JSON e um mecanismo de busca baseado na busca de texto completo Lucene. A plataforma de hardware é a Java Virtual Machine, portanto, o sistema requer uma quantidade significativa de recursos de CPU e memória para funcionar.
Cada mensagem recebida, seja do Logstash ou através de uma solicitação API, é indexada como um "documento" – análogo a uma tabela em SQL relacional. Todos os documentos são armazenados em um índice – análogo a um banco de dados em SQL.
Exemplo de documento no banco:
{
  "_index": "checkpoint-2019.10.10",
  "_type": "_doc",
  "_id": "yvNZcWwBygXz5W1aycBy",
  "_version": 1,
  "_score": null,
  "_source": {
	"layer_uuid": [
      "dae7f01c-4c98-4c3a-a643-bfbb8fcf40f0",
      "dbee3718-cf2f-4de0-8681-529cb75be9a6"
	],
	"outzone": "External",
	"layer_name": [
  	"TSS-Standard Security",
  	"TSS-Standard Application"
	],
	"time": "1565269565",
	"dst": "103.5.198.210",
	"parent_rule": "0",
	"host": "10.10.10.250",
	"ifname": "eth6",
    ]
}
Todo o trabalho com o banco de dados é baseado em solicitações JSON através da REST API, que retornam documentos por índice ou alguma estatística no formato: pergunta – resposta. Para que todas as respostas às solicitações fossem visualizadas, foi criada a Kibana, que é um serviço web.
Kibana
O Kibana permite buscar e consultar dados e estatísticas do banco de dados Elasticsearch, mas com base nas respostas, são construídos muitos gráficos bonitos e painéis. Além disso, o sistema possui funcionalidade de administração do banco de dados Elasticsearch; nas próximas postagens, vamos explorar este serviço com mais detalhes. Agora, vamos mostrar um exemplo de painéis para o firewall Check Point e o scanner de vulnerabilidades OpenVas, que podem ser construídos.
Exemplo de painel para Check Point, a imagem é clicável:
Exemplo de painel para OpenVas, a imagem é clicável:
Conclusão
Nós analisamos do que consiste ELK stack, conhecemos um pouco os principais produtos, e no curso veremos separadamente como escrever o arquivo de configuração Logstash, configurar painéis no Kibana, conhecer as solicitações de API, automação e muito mais!
Então fiquem de olho nas atualizações (, , , ), .
Fonte: habr.com
