

segunda parte:
Qualquer imagem rasterizada pode ser representada como uma matriz bidimensional . Quando falamos sobre cores, a ideia pode ser desenvolvida considerando a imagem como umamatriz tridimensional , onde dimensões adicionais são utilizadas para armazenar dados sobre cada uma das cores.Se considerarmos a cor final como uma combinação dos chamados cores primárias (vermelho, verde e azul), em nossa matriz tridimensional definimos três planos: o primeiro para a cor vermelha, o segundo para a verde e o último para a azul.
Chamaremos cada ponto dessa matriz de pixel (elemento da imagem). Cada pixel contém informações sobre a intensidade (geralmente em forma de um valor numérico) de cada cor. Por exemplo,
um pixel vermelho significa que ele tem 0 de verde, 0 de azul e o máximo de vermelho. Um pixel rosa pode ser formado através da combinação das três cores. Usando uma faixa numérica de 0 a 255, um pixel rosa é definido como Vermelho = 255 Verde = 192, Azul = 203 e Este artigo foi publicado com o apoio da empresa EDISON..
Desenvolvemosaplicativos para vigilância, vídeo sob demanda , além de nos dedicarmos .
Para representar as cores que compõem a imagem, há várias outras modelos. Por exemplo, é possível usar uma paleta indexada, onde apenas um byte é necessário para representar cada pixel, ao invés de três exigidos pela modelo RGB. Neste modelo, uma matriz 2D pode ser usada no lugar da matriz 3D para representar cada cor. Isso economiza memória, mas oferece uma gama de cores menor.
RGB
Por exemplo, veja esta imagem abaixo. O primeiro rosto é totalmente colorido. Os outros são os planos vermelho, verde e azul (intensidade das cores correspondentes mostrada em tons de cinza).
Nota-se que os matizes de vermelho no original estarão nos mesmos lugares onde as partes mais brilhantes do segundo rosto são observadas. Enquanto a contribuição da cor azul pode ser vista principalmente apenas nos olhos de Mario (o último rosto) e nos elementos de suas roupas. Observe onde todos os três planos de cores contribuem menos (as partes mais escuras das imagens) — isso está nos bigodes de Mario.
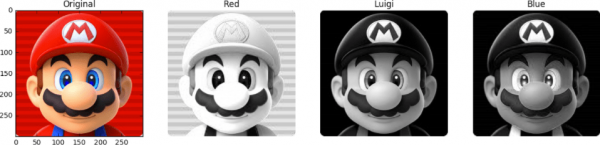
Podemos ver que os tons de vermelho no original estarão nos mesmos locais onde são observadas as partes mais brilhantes do segundo rosto. Enquanto a contribuição da cor azul pode ser vista principalmente apenas nos olhos de Mario (o último rosto) e em elementos de suas roupas. Note onde todas as três superfícies de cor têm a menor contribuição (as partes mais escuras das imagens) — isso está nos bigodes de Mario.
Para armazenar a intensidade de cada cor, é necessário um determinado número de bits — essa quantidade é chamada de profundidade de bits. Suponha que sejam utilizados 8 bits (considerando valores de 0 a 255) para um plano de cor. Então, temos uma profundidade de cor de 24 bits (8 bits * 3 planos R/G/B).
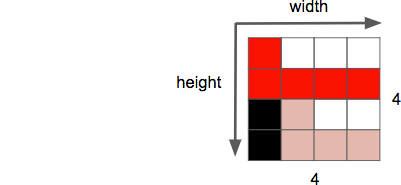
Outra propriedade da imagem é resolução, que representa o número de pixels em uma dimensão. Frequentemente é indicado como largura × altura, como mostrado na imagem de exemplo 4 por 4.
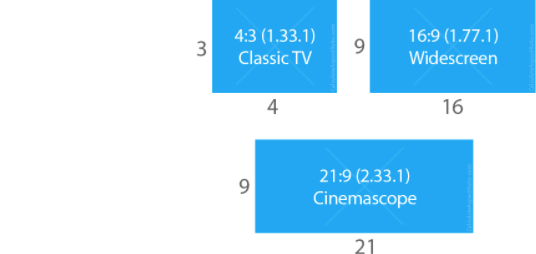
Mais uma propriedade que lidamos ao trabalhar com imagens/vídeos é a proporção, descrevendo a relação proporcional comum entre a largura e a altura da imagem ou do pixel.
Quando se diz que um filme ou imagem possui um tamanho de 16 por 9, geralmente se refere à proporção de exibição (DAR — da Display Aspect Ratio). No entanto, às vezes podem haver diferentes formas de pixels individuais — nesse caso, fala-se sobre a proporção de pixels (PAR — da Pixel Aspect Ratio).
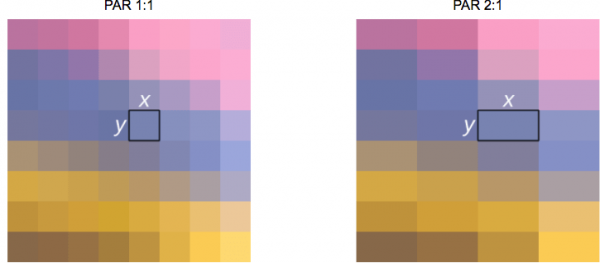
Dica para as donas de casa: DVD -nó, e o outro — DAR 4 por 3
Embora a resolução real do DVD seja 704×480, ela mantém a proporção de 4:3, pois o PAR é 10:11 (704×10 / 480×11).
E, finalmente, podemos definir vídeo como uma sequência de n quadros ao longo de um período de tempo, que pode ser considerado uma dimensão adicional. E n então — é a taxa de quadros ou o número de quadros por segundo (FPS — da Frames per Second).
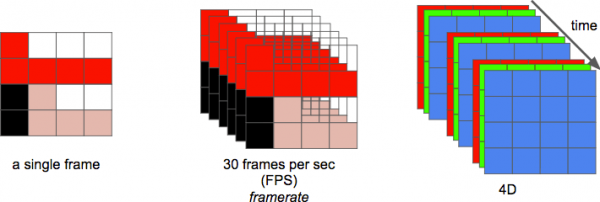
O número de bits por segundo necessário para exibir o vídeo é sua taxa de transferência — bitrate.
bitrate = largura * altura * profundidade de bits * quadros por segundo
Por exemplo, para um vídeo com 30 quadros por segundo, 24 bits por pixel, e resolução de 480×240, serão necessários 82.944.000 bits por segundo ou 82,944 Mbit/s (30x480x240x24) — mas isso se não for usado nenhum método de compressão.
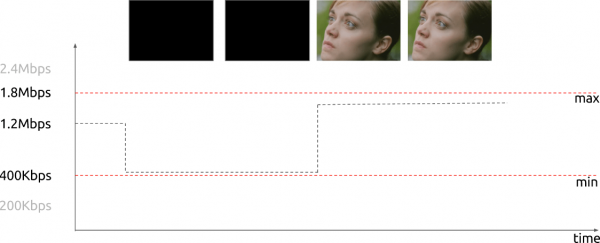
Se a taxa de transferência for quase constante, ela é chamada de taxa de transferência constante (CBR — da constant bit rate). Mas também pode variar, nesse caso é chamada de taxa de transferência variável (VBR — da variable bit rate).
Este gráfico demonstra um VBR limitado, onde não são utilizados muitos bits em um quadro totalmente escuro.
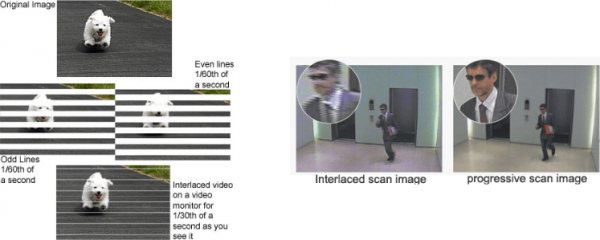
Inicialmente, os engenheiros desenvolveram um método para dobrar a frequência percebida dos quadros do vídeo sem usar largura de banda adicional. Esse método é conhecido como vídeo entrelaçado; essencialmente, ele envia metade da tela no primeiro "quadro", e a outra metade no próximo "quadro".
Atualmente, a visualização de cenas ocorre principalmente usando tecnologia de varredura progressiva. É uma forma de exibir, armazenar ou transmitir imagens em movimento, onde todas as linhas de cada quadro são desenhadas sequencialmente.
Bem! Agora sabemos como uma imagem é apresentada digitalmente, como suas cores são compostas, quantos bits por segundo gastamos para mostrar um vídeo, se a taxa de transmissão é constante (CBR) ou variável (VBR). Conhecemos a resolução estabelecida com uma taxa de quadros determinada e familiarizamos-nos com muitos outros termos, como vídeo entrelaçado, PAR e alguns outros.
Remoção de redundância
É sabido que vídeos sem compressão não podem ser usados normalmente. Um vídeo de uma hora com resolução 720p e taxa de 30 quadros por segundo ocuparia 278 GB. Chegamos a esse valor multiplicando 1280 x 720 x 24 x 30 x 3600 (largura, altura, bits por pixel, FPS e tempo em segundos).
Uso algoritmos de compressão sem perdas, como DEFLATE (usado em PKZIP, Gzip e PNG), não proporcionará uma redução de largura de banda suficiente. Precisamos procurar outras formas de compressão de vídeo.
Para isso, podemos usar características da nossa visão. Nós percebemos melhor a luminosidade do que as cores. O vídeo é um conjunto de imagens sequenciais que se repetem com o tempo. Entre quadros adjacentes de uma cena, as diferenças são pequenas. Além disso, cada quadro contém muitas áreas que usam a mesma (ou similar) cor.
Cor, luminosidade e nossos olhos
Nossos olhos são mais sensíveis à luminosidade do que à cor. Você pode verificar isso pessoalmente, observando esta imagem.
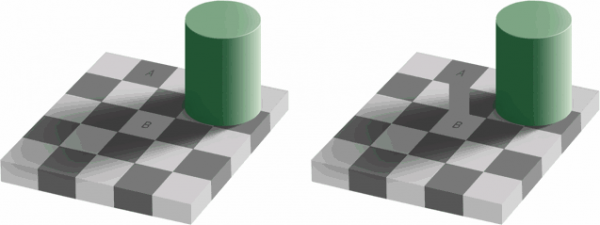
Se você não vê que na metade esquerda da imagem as cores dos quadrados A e B são na verdade iguais, isso é normal. Nosso cérebro nos faz prestar mais atenção às sombras e à luz do que à cor. À direita, entre os quadrados destacados, há um espaço da mesma cor — por isso nós (ou seja, nosso cérebro) facilmente determinamos que, na verdade, ali está a mesma cor.
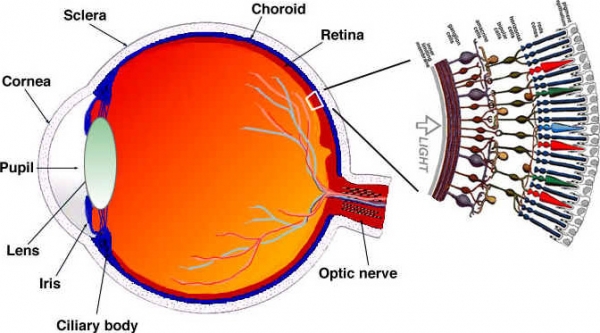
Vamos analisar (simplificadamente) como funcionam nossos olhos. O olho é um órgão complexo, composto por muitas partes. No entanto, o que mais nos interessa são os cones e bastonetes. O olho contém cerca de 120 milhões de bastonetes e 6 milhões de cones.
Vamos considerar a percepção de cor e luminosidade como funções separadas de determinadas partes do olho (na verdade, a situação é um pouco mais complexa, mas vamos simplificar). As células do tipo bastonete são principalmente responsáveis pela luminosidade, enquanto as células do tipo cone respondem pela cor. Os cones são divididos em três tipos, dependendo do pigmento contido: cones S (azul), cones M (verde) e cones L (vermelho).
Como temos muito mais bastonetes (luminosidade) do que cones (cor), podemos concluir que somos mais capazes de distinguir transições entre escuridão e luz do que entre cores.
Funções de sensibilidade ao contraste
Pesquisadores de psicologia experimental e de muitas outras áreas desenvolveram diversas teorias sobre a visão humana. E uma delas se chama funções de sensibilidade ao contraste. Elas estão relacionadas à iluminação espacial e temporal. Em resumo, trata-se de quantas mudanças são necessárias antes que o observador as perceba. Observe que a palavra "função" está no plural. Isso se deve ao fato de que podemos medir funções de sensibilidade ao contraste não apenas para imagens em preto e branco, mas também para imagens coloridas. Os resultados desses experimentos mostram que, na maioria das vezes, nossos olhos são mais sensíveis à luminosidade do que à cor.
Sabendo que somos mais sensíveis à luminosidade da imagem, podemos tentar utilizar esse fato.
Modelo de cor
Nós entendemos um pouco sobre como trabalhar com imagens coloridas usando o esquema RGB. Existem outros modelos. Há um modelo que separa a luminosidade da cromaticidade e é conhecido como YCbCr. A propósito, existem outros modelos que fazem separações semelhantes, mas vamos considerar apenas este.
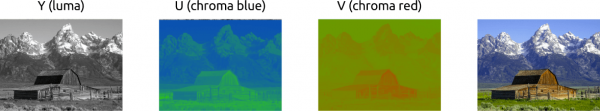
Neste modelo de cor Y — é a representação da luminosidade, e também são utilizados dois canais de cor: Cb (azul saturado) e Cr (vermelho vibrante). YCbCr pode ser derivado do RGB, assim como a conversão inversa é possível. Usando este modelo, podemos criar imagens coloridas, como vemos abaixo:
Conversão entre YCbCr e RGB
Alguém pode argumentar: como é possível obter todas as cores sem o verde?
Para responder a essa pergunta, vamos converter RGB em YCbCr. Usaremos os coeficientes aceitos no padrão BT.601, que foi recomendado pela divisão ITU-R. Esta divisão define normas para vídeo digital. Por exemplo: o que é 4K? Quais devem ser a taxa de quadros, a resolução, o modelo de cores?
Primeiro, vamos calcular o brilho. Usaremos as constantes sugeridas pela ITU e substituiremos os valores RGB.
Y = 0.299R + 0.587G + 0.114B
Depois de obtermos o brilho, separaremos as cores azul e vermelha:
Cb = 0.564(B — Y)
Cr = 0.713(R — Y)
E também podemos converter de volta e até obter o verde usando YCbCr:
R = Y + 1.402Cr
B = Y + 1.772Cb
G = Y — 0.344Cb — 0.714Cr
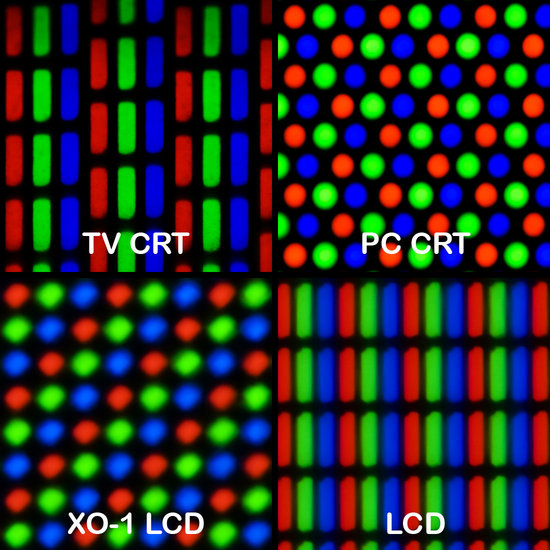
Geralmente, os displays (monitores, televisores, telas etc.) utilizam apenas o modelo RGB. Mas esse modelo pode ser organizado de várias maneiras:
Subamostragem de cor
Com a imagem representada como uma combinação de brilho e cromaticidade, podemos usar a maior sensibilidade do sistema visual humano ao brilho do que à cromaticidade, ao eliminar seletivamente informações. A subsamplaçagem de cores é um método de codificação de imagens que usa uma resolução menor para cromaticidade do que para brilho.
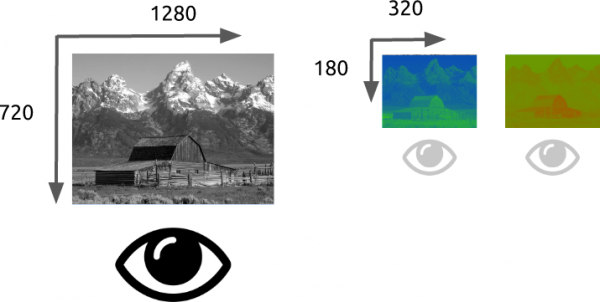
Quão aceitável é reduzir a resolução da cromaticidade?! Aparentemente, já existem alguns esquemas que descrevem como manipular a resolução e a fusão (Cor final = Y + Cb + Cr).
Esses esquemas são conhecidos como sistemas de subsamplaçagem e são expressos como uma razão de 3 a a:x:y, que define o número de amostras dos sinais de brilho e diferença de cor.
a — amostra horizontal padrão (normalmente igual a 4)
x — número de amostras de cromaticidade na primeira linha de pixels (resolução horizontal em relação a a)
y — número de mudanças nas amostras de cromaticidade entre a primeira e a segunda linha de pixels.
A exceção é 4:1:0, que fornece uma amostra de cromaticidade em cada bloco de resolução de brilho 4 por 4.
Esquemas comuns usados em codecs modernos:
- 4:4:4 (sem subsamplaçagem)
- 4:2:2
- 4:1:1
- 4:2:0
- 4:1:0
- 3:1:1
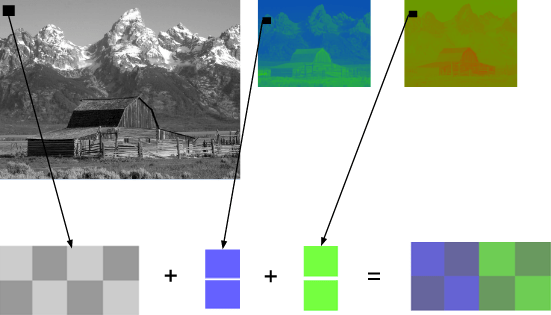
YCbCr 4:2:0 — exemplo de fusão
Este é um fragmento de imagem combinado usando YCbCr 4:2:0. Observe que estamos utilizando apenas 12 bits por pixel.
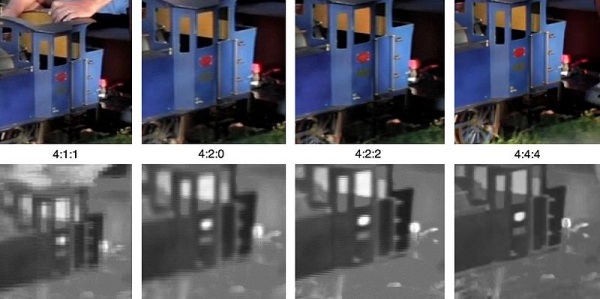
Aqui está a mesma imagem, codificada com os principais tipos de subamostragem de cores. A primeira linha é o YCbCr final, e a linha inferior mostra a resolução da cor. Resultados bastante dignos, considerando as pequenas perdas de qualidade.
Lembre-se de que calculamos 278 GB de espaço em disco para armazenar uma hora de vídeo com resolução 720p a 30 quadros por segundo? Usando YCbCr 4:2:0, esse tamanho será reduzido pela metade — 139 GB. Ainda está longe de um resultado aceitável.
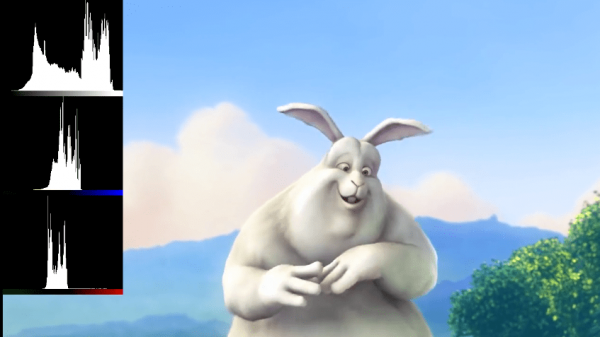
Você pode gerar um histograma YCbCr usando o FFmpeg. Nesta imagem, o azul prevalece sobre o vermelho, como pode ser visto no próprio histograma.
Saturação, brilho, paleta de cores — vídeo de revisão
Recomendamos assistir a este vídeo incrível. Ele explica o que é brilho e esclarece vários pontos sobre o brilho e a cor. Tipos de quadros
Vamos em frente. Tentaremos eliminar a redundância temporal. Mas primeiro, vamos definir alguma terminologia básica. Suponha que temos um filme com 30 quadros por segundo, aqui estão seus primeiros 4 quadros:
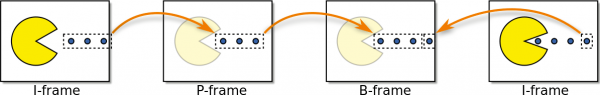
Podemos ver muitas repetições nos quadros: por exemplo, o fundo azul, que não muda de um quadro para outro. Para resolver esse problema, podemos classificar abstratamente esses quadros em três tipos.


Quadro I (
ntro Frame)IO Quadro I (quadro-chave) é autônomo. Independentemente do que precisa ser visualizado, o Quadro I é, na essência, uma foto estática. O primeiro quadro é geralmente um Quadro I, no entanto, veremos regularmente Quadros I entre quadros que não são os primeiros.
Quadro P (

redicted Frame)PO Quadro P (quadro predito) tira proveito do fato de que quase sempre a imagem atual pode ser reproduzida usando o quadro anterior. Por exemplo, no segundo quadro, a única mudança é a bola se movendo para frente. Podemos obter o quadro 2 apenas modificando um pouco o quadro 1, usando apenas a diferença entre esses quadros. Para construir o quadro 2, referimos ao quadro anterior, que é o quadro 1.
←
 Quadro B (

i-predictive Frame)BBi-predictive Frame)
E quanto às referências não apenas a quadros passados, mas também a futuros, para garantir uma compressão ainda melhor?! Isso é, basicamente, o que chamamos de quadro B (quadro bidirecional).
 Quadro B (
 →

Resultado Intermediário
Esses tipos de quadros são usados para garantir a melhor compressão. Vamos discutir como isso acontece na próxima seção. Mas, por enquanto, notamos que o tipo mais "caro" em termos de memória é o quadro I, enquanto o quadro P custa significativamente menos e o quadro B é a opção mais econômica para vídeos.
Redundância Temporal (Previsão Inter-quadro)
Vamos explorar quais opções temos para minimizar repetições ao longo do tempo. Esse tipo de redundância será abordado através de métodos de previsão mútua.
O objetivo é gastar o menor número de bits possível para codificar a sequência de quadros 0 e 1.
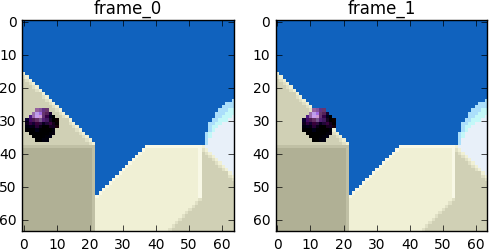
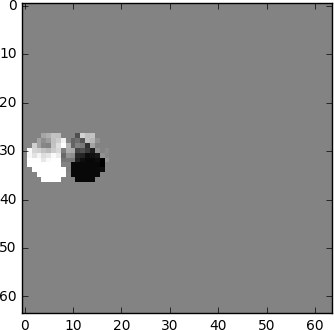
Podemos realizar subtração, simplesmente subtraindo o quadro 1 do quadro 0. Obtemos o quadro 1, mas usamos apenas a diferença entre ele e o quadro anterior, efetivamente codificando apenas o restante resultante.
Mas e se eu te disser que existe um método ainda melhor que usa menos bits?! Primeiro, vamos dividir o quadro 0 em uma grade clara composta por blocos. Então, tentaremos corresponder os blocos do quadro 0 com os do quadro 1. Em outras palavras, vamos avaliar o movimento entre os quadros.
Da Wikipédia — compensação de movimento em blocos
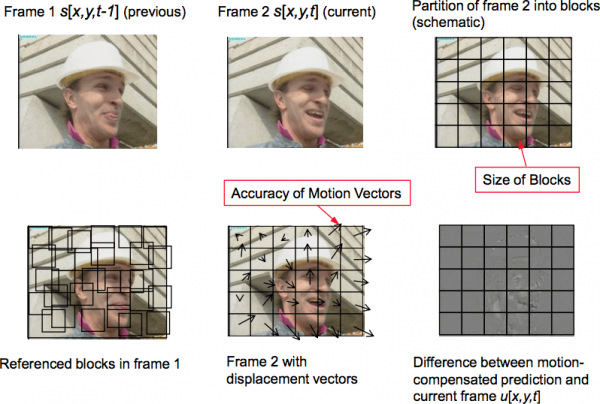
A compensação de movimento em blocos divide o quadro atual em blocos não sobrepostos e o vetor de compensação de movimento indica a origem dos blocos (um equívoco comum é que o quadro anterior é dividido em blocos não sobrepostos, e os vetores de compensação de movimento dizem para onde esses blocos vão. Na verdade, é o contrário — não se analisa o quadro anterior, mas o seguinte, e não se verifica para onde os blocos se movem, mas de onde eles vieram). Normalmente, os blocos de origem se sobrepõem no quadro original. Alguns algoritmos de compressão de vídeo constroem o quadro atual a partir de partes de vários quadros transmitidos anteriormente.
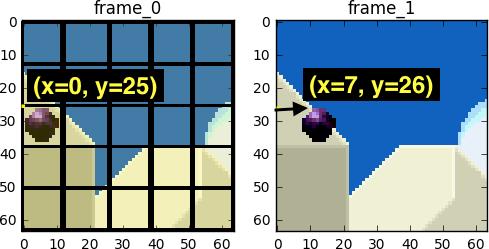
Durante a avaliação, vemos que a bola se moveu de (x=0, y=25) para (x=6, y=26), os valores x e y definem a direção do movimento. Outro passo que podemos dar para economizar bits é codificar apenas a diferença nos vetores de movimento entre a última posição do bloco e a prevista, assim o vetor de movimento final será (x=6-0=6, y=26-25=1).
Na situação real, esta bolinha seria dividida em n blocos, mas a essência do assunto não muda.
Os objetos na cena se movem em três dimensões, portanto, ao mover a bolinha, ela pode parecer visualmente menor (ou maior, se se mover em direção ao espectador). É normal que não haja uma correspondência perfeita entre os blocos. Aqui está uma visão combinada da nossa estimativa e da imagem real.
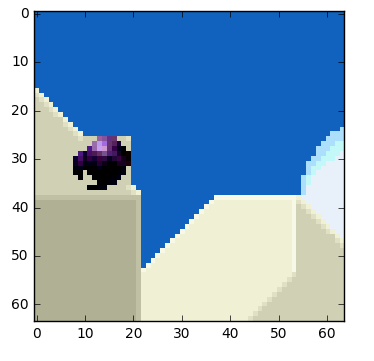
Mas vemos que quando aplicamos a estimativa de movimento, os dados para codificação são significativamente menores do que ao usar um método mais simples de calcular a diferença entre os quadros.
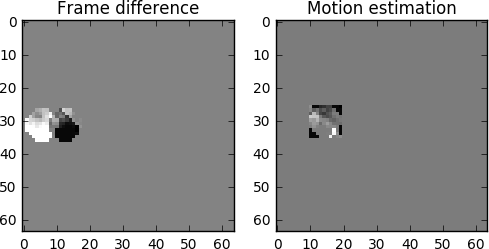
Como seria a verdadeira compensação de movimento
Esta técnica é aplicada a todos os blocos de uma vez. Muitas vezes, nossa bolinha em movimento hipotética será dividida imediatamente em vários blocos.
Você pode explorar esses conceitos por conta própria, usando .
Para ver os vetores de movimento, pode-se criar um vídeo com previsão externa usando .
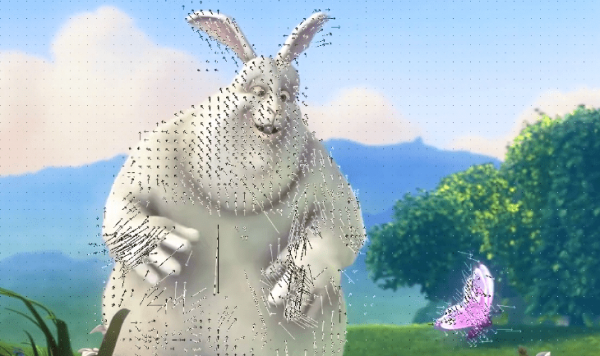
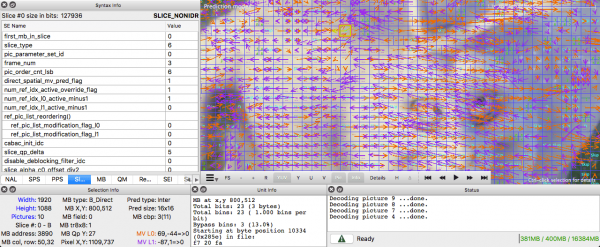
Ainda é possível utilizar (é pago, mas há uma versão de teste gratuita, limitada apenas aos primeiros dez quadros).
Redundância espacial (previsão interna)
Se analisarmos cada quadro no vídeo, encontraremos várias áreas interconectadas.
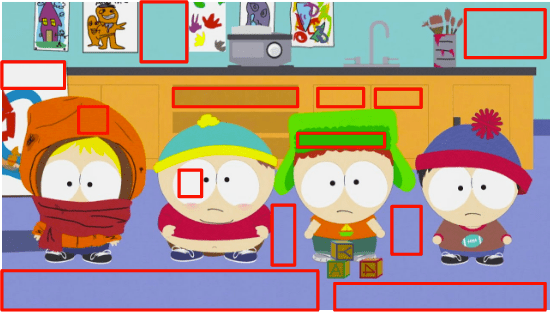
Vamos utilizar este exemplo. Esta cena consiste principalmente de cores azul e branca.
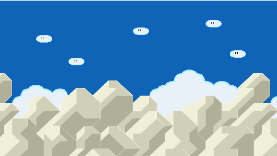
Este é o quadro I. Não podemos usar os quadros anteriores para previsão, mas conseguimos compactá-lo. Vamos codificar a seleção do bloco vermelho. Se olharmos para os seus vizinhos, notamos que há algumas tendências de cor ao seu redor.
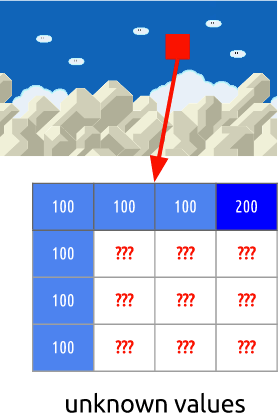
Vamos supor que as cores no quadro se espalhem verticalmente. O que significa que as cores dos pixels desconhecidos conterão valores de seus vizinhos.
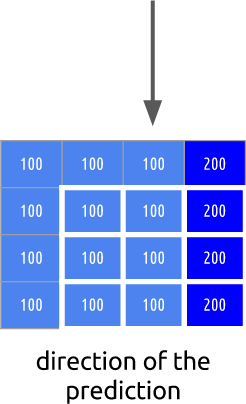
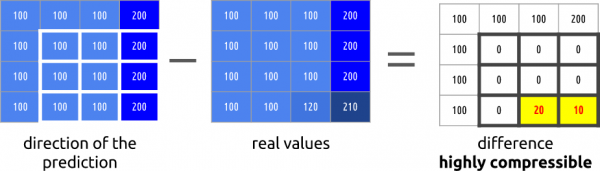
Tal previsão pode estar errada. É exatamente por isso que este método deve ser aplicado (previsão interna), e então os valores reais devem ser subtraídos. Isso nos dará um bloco residual, que resultará em uma matriz muito mais compacta em comparação com a original.
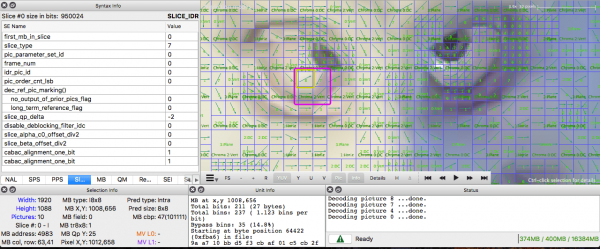
Se você quiser praticar com previsões internas, pode criar um vídeo com macrobloques e suas previsões usando ffmpeg. Para entender o significado de cada cor do bloco, será necessário consultar a documentação do ffmpeg.
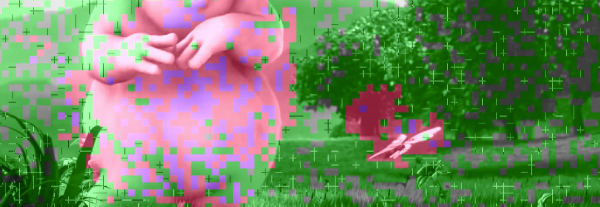
Ou você pode usar o Intel Video Pro Analyzer (como mencionei acima, na versão de teste gratuita há um limite para os primeiros 10 quadros, mas isso será suficiente para começar).
segunda parte:
Fonte: habr.com
