

Quanto mais complexa a sistema, mais ela se enche de diversos alertas. Surge então a necessidade de reagir, agregar e visualizar esses alertas. Acho que essa situação é familiar para muitos, a ponto de causar um tique nervoso.
A solução sobre a qual iremos falar não é das mais inesperadas, mas uma pesquisa revela que não há um artigo completo sobre o tema.
Por isso, decidi compartilhar a experiência da FunCorp e contar como é estruturado o processo de plantão, quem liga, por que e como tudo isso pode ser monitorado.
O que é o PagerDuty?
Então, para resolver todas essas tarefas, começamos a buscar uma ferramenta conveniente. Após breves pesquisas, optamos pelo PagerDuty. O PD nos pareceu uma solução bastante completa e concisa, com uma grande quantidade de integrações e configurações. Do que se trata?
Em resumo, o PagerDuty é uma plataforma de gerenciamento de incidentes que consegue processar incidentes recebidos por meio de várias integrações, configurar a ordem de plantões e, em seguida, alertar o engenheiro de plantão com base no nível do incidente (em caso de alto nível - uma chamada, e em caso de baixo - um push do aplicativo/sms).
Quem é o servidor?
Provavelmente, esse é o primeiro ponto de partida para configurar o PD.
Na FunCorp, assim como em outras empresas, existe o cargo honorário de servidor. Ele é passado de engenheiro a engenheiro uma vez ao dia. Há uma chamada de primeira e segunda linha para responder a um alerta do PagerDuty. Suponhamos que um alerta de alta prioridade chegue e, se após 10 minutos da chamada para o servidor da primeira linha não houver resposta (ou seja, não for mudado para o status de acknowledge ou resolved), a chamada é transferida para o segundo engenheiro de plantão. Isso é configurado no próprio PagerDuty através de Políticas de Escalonamento.
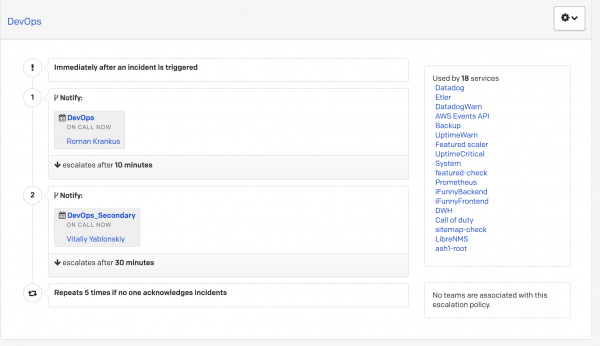
Se o segundo servidor também não responder, o alerta retorna para o principal servidor.
Dessa forma, qualquer alerta de alta prioridade que chegue não pode permanecer sem resposta.
Agora vamos ver de onde podem vir os incidentes.
Quais integrações utilizamos?
No PD, recebemos muitos incidentes variados de diversos serviços. Atualmente, temos cerca de 25 desses serviços, e para processá-los, utilizamos algumas integrações prontas.
- Prometheus
O sistema principal de coleta de métricas é o Prometheus. Já foi muito escrito sobre isso no Habr, e eu apenas direi que temos vários para diferentes ambientes: um coleta métricas de máquinas virtuais e contêineres Docker, outro dos serviços da Amazon, e o terceiro de servidores físicos. O Telegraf é principalmente utilizado como exportador de métricas.
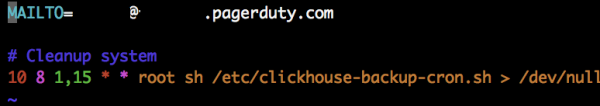
Aqui também, creio que tudo está claro pelo nome. Essa integração é usada para enviar notificações de alguns scripts executados pelo cron. O PD fornece um endereço ao qual você envia os e-mails. Ao criar um serviço com essa integração, você pode definir prioridades, na ordem em que os incidentes serão processados, e como os alertas serão criados (para cada e-mail recebido, para cada e-mail recebido + alguma regra, etc.).
- Slack
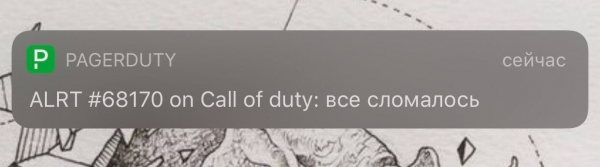
Na minha opinião, é uma integração bastante interessante. Há casos em que acontece algo mas não é coberto por incidentes. Portanto, adicionamos uma integração com o Slack para a criação de incidentes. Ou seja, no Slack corporativo, você pode escrever /callofduty все тормозит и скоро сломается e o PD irá processar isso e enviar o incidente ao engenheiro de plantão.
Fazemos:
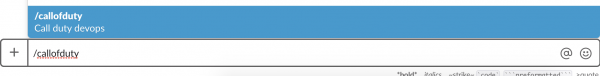
Vemos:
- API
Integração via HTTP. Aqui, na verdade, não há nada de muito interessante, apenas uma solicitação POST com um corpo em formato JSON. Por exemplo, algo interessante: usamos isso para monitoramento externo por meio de . Este serviço verifica a disponibilidade de nossos sites a partir de diferentes pontos do mundo. Quando recebemos um código de resposta inaceitável (por exemplo, 502), um incidente é criado e o processo segue a cadeia descrita acima. No StatusCake, há a possibilidade de monitorar URLs internas, expiração de certificados SSL ou domínios.
- LibreNMS
Este é outro sistema de monitoramento, que pode ser lido com mais detalhes em seu site . Com ele, realizamos o monitoramento de interfaces de rede e iDRAC dos servidores.
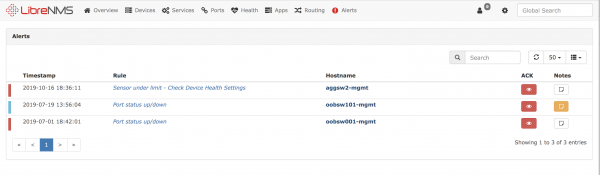
Houve também integrações como Datadog, CloudWatch. Mais detalhes sobre o que aconteceu com eles podem ser vistos .
Visualização
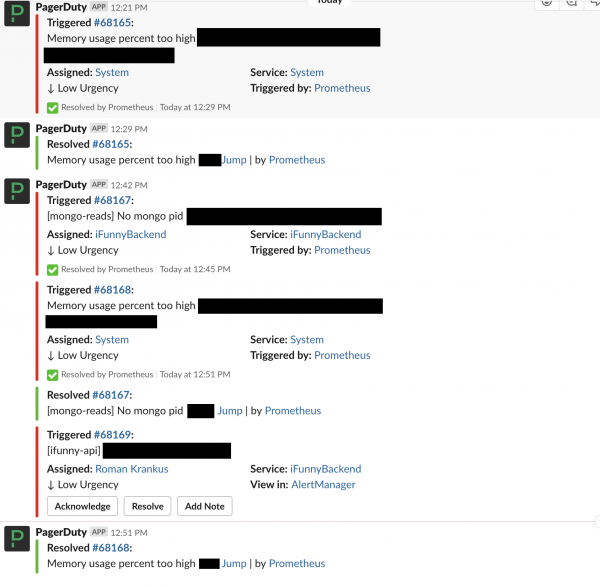
O principal sistema de notificação de incidentes é o Slack. Todos os incidentes recebidos no PD são escritos em um chat específico, e se seu status mudar, isso também é exibido no chat.
Quando surgiu a possibilidade de exibir dados úteis nas telas penduradas no teto, percebemos de repente que nós (no departamento de devops) não tínhamos o que mostrar nelas. Existe um excelente Grafana, mas ele não consegue abranger tudo, e os funcionários reagem a alertas, não a gráficos.
Após uma busca cuidadosa, mas infrutífera, no GitHub por um «painel» conciso e informativo para PD, decidimos criar o nosso — apenas com o que realmente precisamos. Embora a princípio a ideia fosse exibir a interface do PD na tela, isso pareceria ainda mais inconveniente.
Para escrevê-lo, basta obter uma chave do PD com permissões de leitura apenas.
E isso é o que conseguimos:
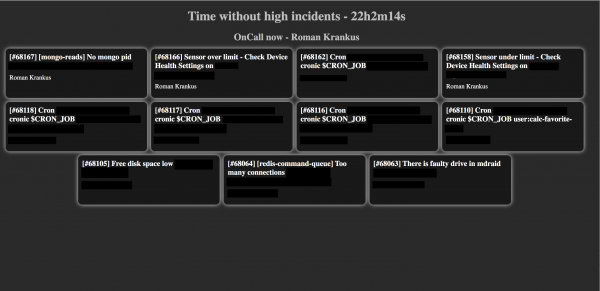
Na tela são exibidos os incidentes abertos atuais, o nome do engenheiro de plantão atual do cronograma selecionado e o tempo sem um incidente de alta prioridade (o painel com o incidente de alta prioridade será destacado em vermelho).
.
No final, conseguimos um painel conveniente para visualizar todos os nossos incidentes. Ficarei feliz se a nossa experiência for útil para algum de vocês.
Fonte: habr.com
