

No ano de 2019, ainda não tínhamos uma solução padrão para a agregação de logs no Kubernetes. Neste artigo, gostaríamos de compartilhar nossas buscas, os problemas encontrados e suas soluções, usando exemplos da prática real.
No entanto, para começar, devo observar que diferentes clientes entendem a coleta de logs de maneiras muito variadas:
- alguns querem ver logs de segurança e auditoria;
- outros desejam uma centralização dos logs de toda a infraestrutura;
- e há quem considere suficiente coletar apenas os logs da aplicação, excluindo, por exemplo, os balanceadores.
Sobre como implementamos diversas "vontades" e com quais dificuldades nos deparamos, você pode ler a seguir.
Teoria: sobre ferramentas para logs
Contexto sobre os componentes do sistema de log
A logging passou por um longo caminho, que resultou na elaboração de metodologias de coleta e análise de logs, que aplicamos hoje. Já na década de 1950, no Fortran, surgiu o equivalente aos fluxos padrão de entrada e saída, que ajudavam os programadores na depuração de seus programas. Esses foram os primeiros logs computacionais, que facilitaram a vida dos programadores daquela época. Hoje, neles vemos o primeiro componente do sistema de log — a fonte ou "produtor" (producer) de logs.
A ciência da computação não ficou parada: surgiram redes de computadores, os primeiros clusters... Começaram a funcionar sistemas complexos compostos por várias máquinas. Agora, os administradores de sistemas precisavam coletar logs de várias máquinas e, em casos especiais, podiam adicionar mensagens do kernel do SO caso fosse necessário investigar uma falha do sistema. Para descrever sistemas de coleta centralizada de logs, no início dos anos 2000 foi publicado o , que padronizou o remote_syslog. Assim surgiu mais um componente importante: o coletor (scollector) de logs e seu armazenamento.
Com o aumento do volume de logs e a ampla adoção de tecnologias web, surgiram questões sobre como exibir logs de maneira conveniente para os usuários. Os simples ferramentas de console (awk/sed/grep) foram substituídas por ferramentas mais avançadas de visualização de logs — o terceiro componente.
Com o aumento do volume de logs, ficou claro também: os logs são necessários, mas nem todos. E os diferentes logs exigem diferentes níveis de retenção: alguns podem ser perdidos em um dia, enquanto outros precisam ser armazenados por 5 anos. Assim, um componente de filtragem e roteamento de dados foi adicionado ao sistema de logging — vamos chamá-lo de filtro.
Os repositórios também deram um salto significativo: de arquivos comuns, passaram para bancos de dados relacionais, e depois para repositórios orientados a documentos (por exemplo, Elasticsearch). Assim, o repositório se separou do coletor.
No final das contas, o próprio conceito de log se expandiu para um fluxo abstrato de eventos que queremos manter para a história. Mais precisamente — para aqueles momentos em que precisamos realizar uma investigação ou elaborar um relatório analítico...
Como resultado, em um tempo relativamente curto, a coleta de logs evoluiu para um subsistema importante, que podemos chamar legitimamente de um dos subcampos em Big Data.
Se outrora os prints comuns eram suficientes para um "sistema de logging", agora a situação mudou bastante.
Kubernetes e logs
Quando o Kubernetes chegou à infraestrutura, o problema de coleta de logs, que já existia, não o evitou. De certa forma, tornou-se ainda mais doloroso: gerir a plataforma de infraestrutura foi não apenas simplificado, mas também ao mesmo tempo complicado. Muitos serviços antigos começaram a migrar para a arquitetura de microsserviços. No contexto dos logs, isso se manifestou no número crescente de fontes de logs, seu ciclo de vida exclusivo e a necessidade de monitorar as interconexões de todos os componentes do sistema através dos logs...
Antecipando um pouco, posso afirmar que atualmente, infelizmente, não existe uma variante padronizada de logging para Kubernetes que se diferencie favoravelmente de todas as outras. Os esquemas mais populares na comunidade resumem-se aos seguintes:
- alguém está implementando a pilha EFK (Elasticsearch, Fluentd, Kibana);
- alguém — está tentando o recém-lançado ou usa ;
- nós (e talvez não apenas nós?...) muito em parte fica satisfeito com o desenvolvimento próprio — …
Normalmente, usamos essas combinações em clusters K8s (para soluções self-hosted):
- ;
- .
No entanto, não vou me deter nas instruções de instalação e configuração. Em vez disso, vou me concentrar em suas desvantagens e em conclusões mais amplas sobre a situação dos logs como um todo.
Prática com logs no K8s
"Logs do dia a dia", quantos de vocês existem?..
A coleta centralizada de logs em uma infraestrutura suficientemente grande requer recursos consideráveis, que serão utilizados para coleta, armazenamento e processamento de logs. Durante a operação de vários projetos, nos deparamos com diferentes exigências e problemas decorrentes delas.
Vamos tentar o ClickHouse
Vamos considerar um repositório centralizado em um projeto com um aplicativo que gera logs de forma bastante ativa: mais de 5000 linhas por segundo. Começaremos a trabalhar com seus logs, armazenando-os no ClickHouse.
Assim que for necessário o máximo de tempo real, um servidor de 4 núcleos com ClickHouse já estará sobrecarregado em relação ao subsistema de disco:
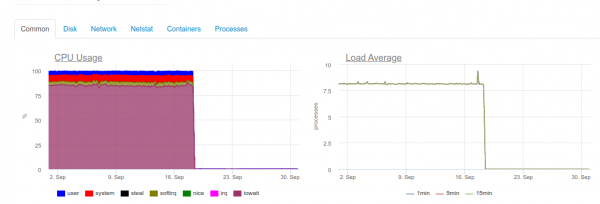
Esse tipo de carga está relacionado ao fato de que estamos tentando escrever no ClickHouse o mais rápido possível. E o banco de dados reage a isso com uma carga de disco elevada, o que pode resultar em erros como:
DB::Exception: Muitas partes (300). As mesclagens estão processando significativamente mais lentamente do que os inserts.
O fato é que no ClickHouse (onde os dados dos logs estão armazenados) têm suas complexidades em operações de gravação. Os dados inseridos nelas geram uma partição temporária, que depois é mesclada com a tabela principal. Como resultado, a gravação se torna muito exigente para o disco, e também está sujeita a uma limitação, da qual recebemos a notificação acima: não mais de 300 subpartições podem ser mescladas em 1 segundo (basicamente, isso significa 300 inserts por segundo).
Para evitar esse comportamento, em blocos o mais grandes possível e não mais frequentemente do que 1 vez a cada 2 segundos. No entanto, gravar em grandes lotes pressupõe que devemos escrever menos frequentemente no ClickHouse. Isso, por sua vez, pode levar ao estouro do buffer e à perda de logs. A solução é aumentar o buffer do Fluentd, mas isso aumentará o consumo de memória.
Nota: Outro lado problemático da nossa solução com o ClickHouse estava relacionado ao fato de que a partição no nosso caso (loghouse) é realizada por meio de tabelas externas, relacionadas . Isso leva a um consumo excessivo de memória ao buscar longos intervalos de tempo, uma vez que a metatabela percorre todas as partições — mesmo aquelas que não contêm os dados necessários. No entanto, hoje em dia esse método pode ser considerado obsoleto para as versões atuais do ClickHouse (c ).
Como resultado, fica claro que para coletar logs em tempo real no ClickHouse, os recursos não são suficientes para todos os projetos (especificamente, sua distribuição não será adequada). Além disso, será necessário usar um acumulador, ao qual ainda voltaremos. O caso descrito acima é real. E naquele momento não conseguimos oferecer uma solução confiável e estável que satisfizesse o cliente e permitisse a coleta de logs com a mínima latência…
E o Elasticsearch?
É sabido que o Elasticsearch lida bem com grandes cargas. Vamos testá-lo no mesmo projeto. Agora a carga parece a seguinte:
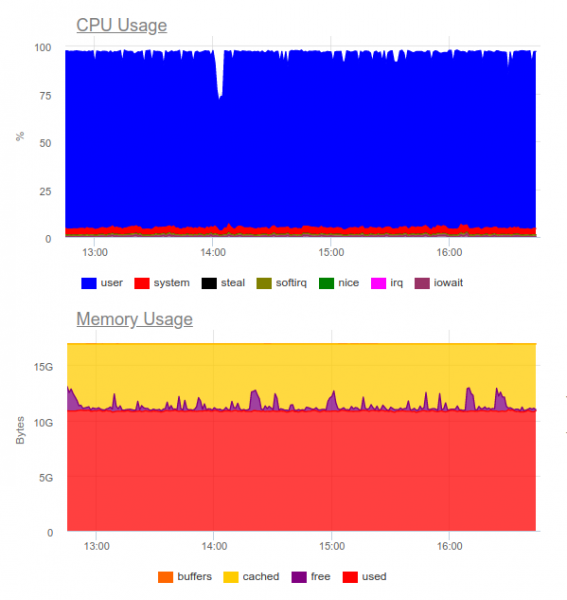
O Elasticsearch conseguiu processar o fluxo de dados, no entanto, a gravação de tais volumes nele utiliza muito a CPU. Isso é resolvido organizando um cluster. Tecnicamente, isso não é um problema, mas realmente resulta em usarmos cerca de 8 núcleos apenas para a operação do sistema de coleta de logs, juntamente com um componente de alta carga no sistema…
Resultado: essa opção pode ser justificável, mas somente se o projeto for grande e sua gestão estiver disposta a gastar recursos significativos em um sistema de log centralizado.
Então surge uma pergunta lógica:
Quais logs são realmente necessários?
 Vamos tentar mudar a abordagem: os logs devem ser simultaneamente informativos e não cobrir cada evento no sistema.
Suponha que temos uma loja online de sucesso. Quais logs são importantes? Coletar o máximo de informações, como do gateway de pagamento — é uma excelente ideia. Mas em relação ao serviço de corte de imagens no catálogo de produtos, não precisamos de todos os logs: apenas os erros e monitoramento avançado (por exemplo, a porcentagem de erros 500 gerados por esse componente) são suficientes.
Aqui chegamos à conclusão de que o log centralizado não é justificável em todos os casos. Muitas vezes, o cliente deseja coletar todos os logs em um só lugar, embora, na verdade, apenas cerca de 5% das mensagens sejam críticas para o negócio:
- Às vezes, basta ajustar, digamos, apenas o tamanho do log do contêiner e o coletor de erros (por exemplo, Sentry).
- Para a investigação de incidentes, um alerta de erro e um grande log local podem ser suficientes.
- Tivemos projetos que apenas utilizavam testes funcionais e sistemas de coleta de erros. O desenvolvedor não precisava de logs como tal — eles viam tudo através das trilhas de erros.
Ilustração da vida real
Um bom exemplo pode ser uma outra história. Recebemos um pedido da equipe de segurança de um de nossos clientes, que já utilizava uma solução comercial desenvolvida muito antes da implementação do Kubernetes.
Foi necessário "conectar" o sistema de coleta de logs centralizada com o sensor corporativo de detecção de problemas — QRadar. Este sistema aceita logs pelo protocolo syslog, coletando via FTP. No entanto, a integração com o plugin remote_syslog para fluentd não foi imediata. (como se descobriu, ). Os problemas na configuração do QRadar estavam do lado da equipe de segurança do cliente.
Como resultado, parte dos logs críticos para os negócios foi enviada via FTP para o QRadar, enquanto outra parte foi redirecionada diretamente dos nós via remote syslog. Para isso, até criamos — talvez ele ajude alguém a resolver uma tarefa semelhante... Graças ao esquema resultante, o cliente podia receber e analisar logs críticos (usando sua ferramenta favorita), enquanto conseguíamos reduzir os custos do sistema de logging, mantendo apenas o último mês.
Outro exemplo é bastante ilustrativo do que não se deve fazer. Um de nossos clientes gerava um cada output não estruturado de múltiplas linhas de informações em logs para eventos recebidos dos usuários. Como é fácil adivinhar, esses logs eram extremamente difíceis de ler e armazenar. Critérios para logs
Exemplos como esses nos levam à conclusão de que, além de escolher o sistema de coleta de logs, deve-se também
projetar os próprios logs ! Quais são os requisitos aqui?Os logs devem estar em um formato legível por máquina (por exemplo, JSON).
- Os logs devem ser compactos e ter a possibilidade de alterar o nível de logging para solucionar possíveis problemas. Ao mesmo tempo, em ambientes de produção, os sistemas devem ser executados com um nível de logging como
- Os logs devem ser compactos e permitir o ajuste do nível de registro, a fim de depurar possíveis problemas. Em ambientes de produção, os sistemas devem ser executados com níveis de registro adequados. Aviso ou Erro.
- Os logs devem ser normalizados, ou seja, no objeto do log, todas as linhas devem ter o mesmo tipo de campo.
Logs não estruturados podem levar a problemas com o carregamento dos logs no armazenamento e provocar a interrupção total do seu processamento. Como ilustração, veja um exemplo de erro 400, com o qual muitos já se depararam nos logs do fluentd:
2019-10-29 13:10:43 +0000 [warn]: dump an error event: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError error="400 - Rejected by Elasticsearch"
O erro significa que você está enviando para o índice com um mapping preparado um campo cujo tipo é instável. Um exemplo simples é o campo no log do nginx com a variável $upstream_status. Nele pode haver tanto um número quanto uma string. Por exemplo:
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29/Out/2019:16:18:57 +0300", "method": "GET", "uri": "\/staffs\/265.png", "protocol": "HTTP\/1.1", "status": "200", "body_size": "906", "referrer": "https:\/\/example.com\/staff", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29/Out/2019:16:18:57 +0300", "method": "GET", "uri": "\/staff", "protocol": "HTTP\/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
Nos logs vemos que o servidor 10.100.0.10 respondeu com o erro 404 e a solicitação foi direcionada para outro armazenamento de conteúdo. Como resultado, nos logs, o valor ficou assim:
"upstream_response_time": "0.001, 0.007"
Essa situação é tão comum que até recebeu uma menção específica na .
E quanto à confiabilidade?
Há casos em que todos os logs sem exceção são vitais. E com isso, os esquemas típicos de coleta de logs para K8s, sugeridos/discutidos acima, apresentam problemas.
Por exemplo, o fluentd não consegue coletar logs de contêineres de curta duração. Em um de nossos projetos, um contêiner de migração de bancos de dados viveu menos de 4 segundos e depois foi removido — de acordo com a anotação correspondente:
"helm.sh/hook-delete-policy": hook-succeeded
Devido a isso, o log da execução da migração não chegou ao armazenamento. Uma política que pode ajudar neste caso é before-hook-creation.
Outro exemplo é a rotação de logs do Docker. Suponha que há um aplicativo que escreve ativamente nos logs. Em condições normais, conseguimos processar todos os logs, mas assim que surge um problema — como o descrito acima com o formato incorreto — o processamento para, e o Docker rotaciona o arquivo. O resultado é que logs críticos para o negócio podem ser perdidos.
É por isso que é importante separar os fluxos de logs, integrando o envio dos mais valiosos diretamente no aplicativo, para garantir sua preservação. Além disso, não seria desnecessário criar um «acumulador» de logs, que consiga sobreviver a uma breve indisponibilidade do armazenamento, preservando mensagens críticas.
Finalmente, não devemos esquecer que é crucial monitorar qualquer subsistema com qualidade. Do contrário, é fácil enfrentar uma situação em que o fluentd está em estado CrashLoopBackOff e nada é enviado, o que promete a perda de informações importantes.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Neste artigo, não abordamos soluções SaaS como o Datadog. Muitos dos problemas descritos aqui já foram, de alguma forma, resolvidos por empresas comerciais especializadas na coleta de logs, mas nem todos podem usar SaaS por diferentes razões. (as principais são custo e conformidade com a Lei 152-FZ).
A coleta centralizada de logs pode parecer uma tarefa simples no início, mas não é. É importante lembrar que:
- É válido registrar detalhadamente apenas os componentes críticos, enquanto para os demais sistemas pode-se configurar monitoramento e coleta de erros.
- Os logs em produção devem ser minimizados para não gerar carga excessiva.
- Os logs devem ser legíveis por máquina, normalizados e ter um formato rigoroso.
- Logs realmente críticos devem ser enviados em um fluxo separado, que deve estar separado dos principais.
- É prudente pensar em um acumulador de logs que pode proteger contra picos de carga elevada e tornar a carga de armazenamento mais uniforme.
Estas regras simples, se aplicadas em todos os lugares, permitiriam que os esquemas descritos acima funcionassem — mesmo que lhes faltem componentes importantes (acumulador). Caso contrário, não seguir esses princípios facilmente levará você e sua infraestrutura a mais um componente de sistema com alta carga (e ao mesmo tempo pouco eficiente).
P.S.
Confira também em nosso blog:
- «»;
- «»;
- «».
Fonte: habr.com
