

É sabido que a competência de um CTO é testada apenas na segunda vez em que ocupa esse cargo. Porque é uma coisa passar vários anos trabalhando em uma empresa, evoluindo junto com ela e, estando no mesmo contexto cultural, gradualmente assumir mais responsabilidades. E é completamente diferente chegar diretamente ao cargo de diretor técnico em uma empresa com um histórico de legados e muitos problemas, cuidadosamente varridos para debaixo do tapete.
Nesse sentido, a experiência de Leon Fire, que ele compartilhou em , não é exatamente única, mas, somada à sua bagagem e à quantidade de papéis que ele conseguiu desempenhar ao longo de 20 anos, é muito valiosa. Abaixo, estão a cronologia dos acontecimentos nos últimos 90 dias e muitas histórias divertidas, sobre as quais é agradável rir quando acontecem com outra pessoa, mas que não são tão legais de enfrentar pessoalmente.
Leon conta suas histórias de forma muito colorida em russo, então, se você tiver 35-40 minutos, recomendo assistir ao vídeo. A versão texto está disponível abaixo para economizar tempo.
A primeira versão do relatório era uma descrição bem estruturada sobre o trabalho com pessoas e processos, contendo recomendações úteis. Mas não transmitia todas as surpresas que surgiram ao longo do caminho. Portanto, mudei o formato e apresentei os problemas que surgiram na nova empresa como um gênio da lâmpada, e os métodos para resolvê-los em ordem cronológica.
Um mês antes de
Como muitas boas histórias, esta começou com álcool. Estávamos em um bar com conhecidos e, como é comum entre os profissionais de TI, todos falavam sobre seus problemas. Um deles tinha acabado de mudar de emprego e contava sobre suas dificuldades tanto com tecnologias quanto com pessoas e equipe. Quanto mais eu escutava, mais percebia que ele precisava apenas me contratar, pois eram exatamente esses problemas que eu resolvia nos últimos 15 anos. Foi isso que eu lhe disse, e no dia seguinte nos encontramos em um ambiente de trabalho. A empresa chamava-se Teaching Strategies.
Teaching Strategies é líder no mercado de programas educacionais para crianças na primeira infância — de zero a três anos. A empresa tradicional de "papel" já existe há 40 anos, enquanto a versão digital SaaS da plataforma tem 10 anos. Recentemente, começou o processo de adaptação da tecnologia digital aos padrões da empresa. A "nova" versão foi lançada em 2017 e era quase como a antiga, apenas funcionava pior.
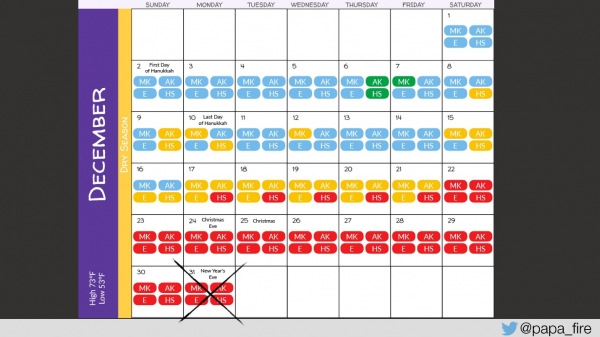
O mais interessante é que o tráfego desta empresa é muito previsível - dia após dia, ano após ano, é possível prever com bastante precisão quantas pessoas virão e quando. Por exemplo, entre 13h e 15h, todas as crianças nos jardins de infância vão dormir, enquanto os professores começam a inserir informações. E isso acontece todos os dias, exceto nos fins de semana, pois quase ninguém trabalha nos fins de semana.
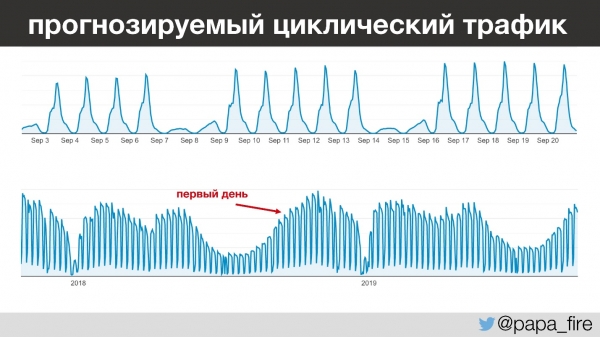
Antecipando um pouco, devo mencionar que comecei meu trabalho durante o período de maior tráfego anual, o que é interessante por várias razões.
A plataforma, que parecia ter apenas 2 anos, tinha uma pilha peculiar: ColdFusion & SQL Server de 2008. ColdFusion, se você não sabe, e provavelmente não sabe, é como um PHP empresarial, que surgiu no meio dos anos 90, e desde então nunca mais ouvi falar dele. Também havia: Ruby, MySQL, PostgreSQL, Java, Go, Python. Mas o monolito principal funcionava em ColdFusion e SQL Server.
Problemas
Quanto mais conversava com os funcionários da empresa sobre o trabalho e os problemas que surgiam, mais percebia que as dificuldades não eram apenas técnicas. Ok, a tecnologia é antiga - já trabalhei com coisas assim, mas havia problemas com a equipe e com os processos, e a empresa começou a perceber isso.
Tradicionalmente, os técnicos ficavam em um canto fazendo algum trabalho próprio. Mas cada vez mais negócios começaram a passar pela versão digital. Portanto, na empresa, no último ano antes do meu início, apareceram novos: conselho de diretores, CTO, CPO e diretor de QA. Ou seja, a empresa começou a investir na área tecnológica.
Os vestígios de um legado pesado não estavam apenas nos sistemas. Havia processos legados, pessoas legadas, cultura legada na empresa. Tudo isso precisava mudar. Pensei que definitivamente não seria chato e decidi tentar.
Dois dias antes
Dois dias antes do início do novo trabalho, fui ao escritório, preenchi os últimos documentos, conheci a equipe e descobri que naquele momento a equipe estava lidando com um problema. A questão era que o tempo médio de carregamento das páginas subiu para 4 segundos, ou seja, dobrou.
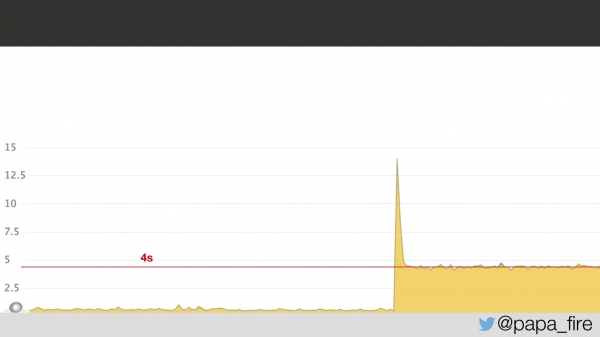
Pelo gráfico, algo claramente aconteceu, mas não estava claro o que. Aparentemente, o problema estava na latência da rede no data center: 5 ms de latência no data center se transformaram em 2 segundos para os usuários. Por que isso aconteceu, eu não sabia, mas de qualquer forma ficou claro que o problema estava no data center.
Dia um
Passaram-se dois dias, e no meu primeiro dia de trabalho percebi que o problema ainda persistia.
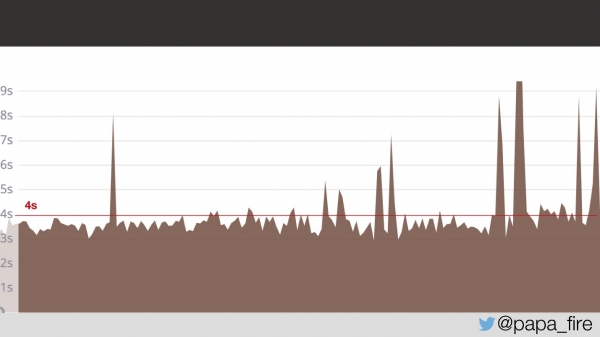
Durante dois dias, as páginas estavam carregando em média 4 segundos. Perguntei se descobriram qual era o problema.
— Sim, abrimos um ticket.
— E?
— Bem, ainda não recebemos resposta deles.
Foi então que percebi que tudo o que me contaram até agora era apenas a ponta do iceberg com o qual eu tinha que lidar.
Há uma boa citação que se encaixa bem nesse caso:
«Às vezes, para mudar a tecnologia, é preciso mudar a organização».
Mas como comecei meu trabalho na época mais movimentada do ano, era necessário considerar ambas as opções para resolver o problema: uma solução rápida e outra a longo prazo. Devia começar pelo que era crítico naquele momento.
Dia três
Assim, o carregamento leva 4 segundos, e entre 13 e 15 horas há os maiores picos.
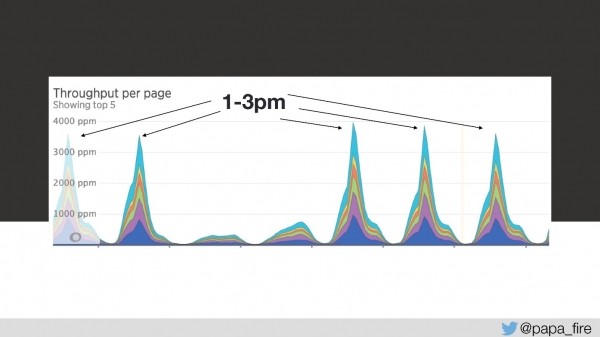
No terceiro dia, a velocidade de carregamento nesse intervalo de tempo era a seguinte:
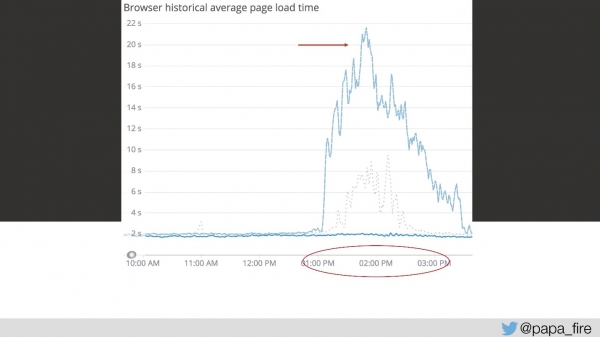
Na minha perspectiva, nada estava funcionando. Para todos os outros, funcionava um pouco mais lento do que o habitual. Mas isso não acontece simplesmente: é um problema sério.
Tentei convencer a equipe, mas a resposta foi que precisávamos de mais servidores. Isso, claro, resolve o problema, mas não é sempre a única e mais eficaz solução. Perguntei por que estávamos sem servidores, qual era o volume de tráfego. Extrapolei os dados e descobri que tínhamos cerca de 150 requisições por segundo, o que está dentro de limites razoáveis.
Mas não devemos esquecer que, antes de obter a resposta correta, precisamos fazer a pergunta certa. Minha próxima pergunta foi: quantos servidores front-end temos? A resposta me «deixou um pouco perplexo»: tínhamos 17 servidores front-end!
— Desculpe a pergunta, se dividirmos 150 por 17, dá cerca de 8? Quer dizer que cada servidor processa 8 requisições por segundo, e se amanhã tivermos 160 requisições por segundo, precisaremos de mais 2 servidores?
Claro, não precisamos de servidores adicionais. A solução estava no próprio código, à vista de todos:
var currentClass = classes.getCurrentClass();
return currentClass;
Havia uma função getCurrentClass(), pois tudo no site funciona no contexto da classe — correto. E essa função sozinha em cada página gerava 200+ requisições.
Dessa forma, a solução era muito simples, nem era necessário reescrever nada: simplesmente não solicitar a mesma informação repetidamente.
if ( !isDefined("REQUEST.currentClass") ) {
    var classes = new api.private.classes.base();
   REQUEST.currentClass = classes.getCurrentClass();
}
return REQUEST.currentClass;
Fiquei muito feliz, porque decidi que, no terceiro dia, havia encontrado o principal problema. Como fui ingênuo, isso era apenas um entre muitos problemas.
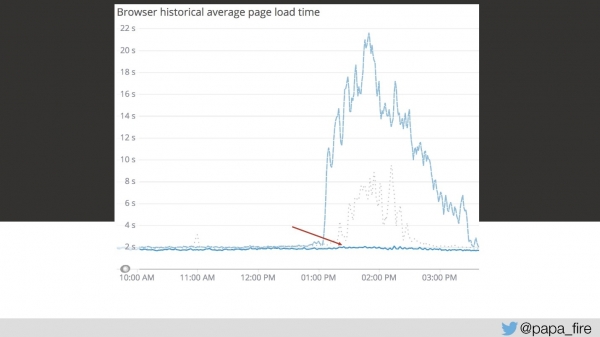
Mas a solução desse primeiro problema fez o cronograma cair muito.
Ao mesmo tempo, estávamos trabalhando em outras otimizações. Havia muita coisa visível que poderia ser corrigida. Por exemplo, no mesmo terceiro dia, descobri que havia de fato um cache no sistema (a princípio pensei que todas as solicitações vinham diretamente do banco de dados). Quando penso em cache, imagino os padrões Redis ou Memcached. Mas só eu pensava assim, porque para cache naquele sistema usavam-se MongoDB e SQL Server — o mesmo do qual acabamos de ler os dados.
Décimo dia
Na primeira semana, eu lidava com os problemas que precisavam ser resolvidos imediatamente. Por volta da segunda semana, fui à primeira reunião de stand-up para conversar com a equipe, ver o que estava acontecendo e como todo o processo estava andando.
Novamente, algo interessante foi descoberto. A equipe era composta por: 18 desenvolvedores; 8 testadores; 3 gerentes; 2 arquitetos. E todos eles participavam dos rituais comuns, ou seja, mais de 30 pessoas compareciam ao stand-up todas as manhãs e contavam o que estavam fazendo. É claro que a reunião não durava 5 ou 15 minutos. Ninguém ouvia ninguém, porque todos trabalhavam em sistemas diferentes. Nessa configuração, 2-3 tickets por hora em uma sessão de grooming já eram um bom resultado.
A primeira coisa que fizemos foi dividir a equipe em várias de acordo com a linha de produtos. Para diferentes seções e sistemas, destacamos equipes separadas, que incluíam desenvolvedores, testadores, gerentes de produto, analistas de negócios.
Como resultado, obtivemos:
- Redução dos stand-ups e reuniões.
- Conhecimento profundo do produto.
- Consideração pela propriedade. Quando as pessoas estavam sempre rotacionando pelos sistemas, sabiam que tampouco teriam que lidar com seus erros provavelmente seria alguém mais, mas não elas mesmas.
- Colaboração entre grupos. Não é necessário dizer que QA e os programadores até então não se comunicavam muito, e o gerente de produto fazia o seu próprio trabalho, etc. Agora eles tinham um ponto comum de responsabilidade.
Principalmente, focamos em eficiência, desempenho e qualidade — foram esses os problemas que tentamos resolver com a transformação da equipe.
Dia onze
Durante o processo de mudança da estrutura da equipe, descobri como são contabilizados HistóriaPontos. 1 SP equivalia a um dia, e cada ticket continha SP tanto para desenvolvimento quanto para QA, ou seja, pelo menos 2 SP.
Como descobri isso?
Encontramos um bug: em um dos relatórios, onde se insere a data de início e fim do período para o qual o relatório é necessário, o último dia não era considerado. Ou seja, em algum lugar da consulta estava <= ao invés de apenas <. Disseram-me que isso era três Story Points, ou seja, 3 dias.
Depois disso nós:
- Revisamos o sistema de avaliação de Story Points. Agora, a correção de bugs menores, que podem ser rapidamente processados pelo sistema, chega mais rapidamente ao usuário.
- Começamos a agrupar tickets relacionados para desenvolvimento e testes. Antes, cada ticket, cada bug, era um ecossistema isolado, desvinculado de qualquer outra coisa. A alteração de três botões em uma página poderia ser três tickets diferentes com três processos de QA distintos ao invés de um único teste automático na página.
- Passamos a trabalhar com os desenvolvedores sobre a abordagem para avaliação de esforço. Três dias para trocar um botão — isso não é aceitável.
Dia vinte
Por volta da metade do primeiro mês, a situação ficou um pouco mais estável, consegui entender o que estava acontecendo na maior parte e já comecei a olhar para o futuro, pensando em soluções de longo prazo.
Objetivos de longo prazo:
- Plataforma gerenciada. Centenas de solicitações em cada página — isso é inaceitável.
- Tendências previsíveis. Havia picos periódicos de tráfego que, à primeira vista, não correlacionavam com outras métricas — precisávamos entender por que isso acontecia e aprender a prever.
- Expansão da plataforma. O negócio está sempre crescendo, mais usuários estão chegando, e o tráfego está aumentando.
No passado, frequentemente se dizia: “Vamos reescrever tudo em [linguagem/framework], tudo vai funcionar melhor!”
Na maioria dos casos, isso não funciona, e é uma sorte se o que foi reescrito realmente funciona. Então, precisávamos criar um roadmap — uma estratégia concreta, que ilustra passo a passo como os objetivos de negócio serão alcançados (o que vamos fazer e para quê), que:
- reflete a missão e os objetivos do projeto;
- prioriza os objetivos principais;
- contém um gráfico de suas conquistas.
Antes disso, ninguém havia conversado com a equipe sobre o propósito de quaisquer mudanças. Para isso, são necessárias métricas de sucesso adequadas. Pela primeira vez na história da empresa, estabelecemos KPIs para a equipe técnica, e essas métricas estão vinculadas aos objetivos organizacionais.
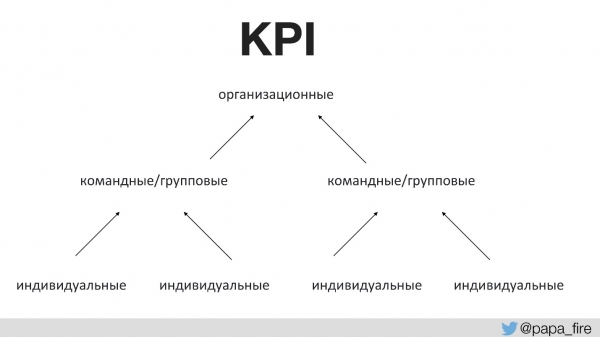
Isto é, os KPIs organizacionais são apoiados pelas equipes, enquanto os KPIs das equipes são apoiados por indivíduos. Caso contrário, se os KPIs tecnológicos não estiverem alinhados com os organizacionais, cada um puxará a coberta para si.
Por exemplo, um dos KPIs organizacionais é aumentar a participação de mercado através de novos produtos.
Como podemos apoiar a meta de ter mais novos produtos?
- Primeiro, queremos gastar mais tempo desenvolvendo novos produtos em vez de corrigir defeitos. Esta é uma solução lógica e fácil de medir.
- Em segundo lugar, queremos apoiar o aumento do volume de transações, pois quanto maior a participação de mercado, mais usuários e, consequentemente, mais tráfego.
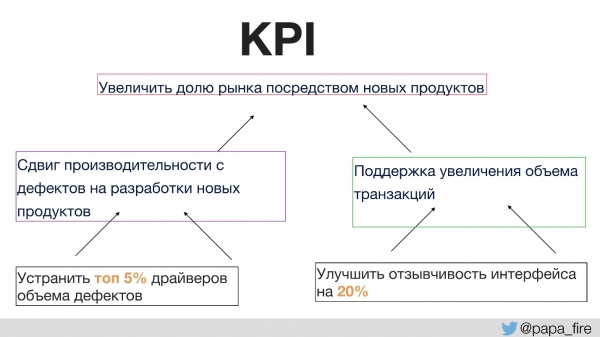
Então, os KPIs individuais que podem ser executados dentro do grupo serão, por exemplo, na área de onde vêm os principais defeitos. Se nos concentrarmos exatamente nessa seção, podemos reduzir significativamente o número de defeitos, aumentando assim o tempo para o desenvolvimento de novos produtos e novamente apoiando os KPIs organizacionais.
Assim, cada decisão, incluindo reescrever código, deve apoiar objetivos específicos que a empresa nos estabeleceu (crescimento da organização, novas funcionalidades, contratação de pessoal).
Durante esse processo, surgiu algo interessante que não foi apenas uma novidade para os técnicos, mas para toda a empresa: todos os tickets devem estar orientados para pelo menos um KPI. Ou seja, se o product manager diz que quer fazer uma nova função, a primeira pergunta deve ser: "Qual KPI essa função apoia?" Se não houver nenhum, desculpe, parece que essa é uma função desnecessária.
Trigésimo dia
No final do mês, percebi mais um detalhe: ninguém da minha equipe de operações nunca tinha visto os contratos que assinamos com os clientes. Você pode se perguntar por que ver os contratos.
- Primeiro, porque os SLA estão descritos nos contratos.
- Em segundo lugar, os SLAs são todos diferentes. Cada cliente vinha com suas próprias exigências, e o departamento de vendas assinava sem olhar.
Outro ponto interessante — no contrato com um dos maiores clientes está escrito que todas as versões do software suportadas pela plataforma devem ser n-1, ou seja, não a versão mais recente, mas a penúltima.
Fica claro quão distantes estávamos do n-1, uma vez que a plataforma estava em ColdFusion e SQL Server de 2008, que deixou de ser suportado em julho.
Dia quarenta e cinco
Mais ou menos na metade do segundo mês, eu consegui liberar tempo suficiente para me sentar e fazer valorstreammapeamento completamente de todo o processo. Esses são os passos necessários a serem tomados, desde a criação do produto até a entrega ao consumidor, descrevendo-os da maneira mais detalhada possível.
Divida o processo em pedaços pequenos e observe o que leva muito tempo, o que pode ser otimizado, melhorado, etc. Por exemplo, quanto tempo uma solicitação leva, passando pelo grooming, até chegar ao ticket que o desenvolvedor pode pegar, QA, etc. Você analisa em detalhes cada passo separado e pensa no que pode ser otimizado.
Quando fiz isso, duas coisas se destacaram:
- uma alta porcentagem de tickets retornando do QA para os desenvolvedores;
- as revisões de pull request estavam demorando muito.
O problema era que essas eram conclusões como: parece levar muito tempo, mas não temos certeza de quanto exatamente.
Não se pode melhorar o que não se pode medir.
Como justificar quão séria é a questão? Isso consome dias ou horas?
Para medir isso, adicionamos alguns passos no processo do Jira: "pronto para o dev" e "pronto para QA", para medir quanto tempo cada ticket aguarda e quantas vezes retorna a uma etapa específica.
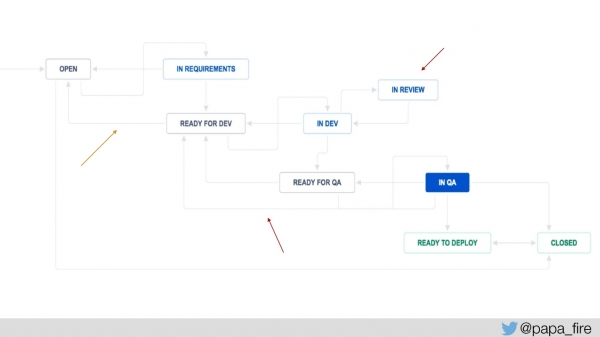
Também adicionamos "em revisão" para saber quanto tempo, em média, os tickets ficam em revisão, e a partir disso trabalhar. Tínhamos métricas de sistema, agora adicionamos novas métricas e começamos a medir:
- Eficiência do processo: produtividade e planejado/entregue.
- Qualidade do processo: número de defeitos, defeitos do QA.
Isso realmente ajuda a entender o que está indo bem e o que está indo mal.
Dia cinquenta
Isso tudo é, claro, bom e interessante, mas perto do final do segundo mês ocorreu algo que, em princípio, era previsível, embora eu não esperasse tal escala. As pessoas começaram a sair porque a liderança mudou. Novas pessoas chegaram à gestão, que começaram a fazer mudanças, e os antigos foram demitidos. Normalmente, em uma empresa que existe há alguns anos, todos são amigos e se conhecem.
Isso era esperado, mas a escala das demissões foi surpreendente. Por exemplo, em uma semana, dois líderes de equipe pediram demissão ao mesmo tempo. Portanto, eu tive que não só esquecer outros problemas, mas focar na formação da equipe. É um problema longo e difícil de resolver, mas precisava ser abordado, pois queria manter as pessoas que estavam (ou a maioria delas). Era necessário reagir de alguma forma ao fato de que as pessoas foram embora, para manter a moral da equipe.
Em teoria, isso é bom: chega uma nova pessoa, que tem carta branca, pode avaliar as habilidades da equipe e substituir cargos. Na prática, não se pode simplesmente trazer novas pessoas por muitas razões. Sempre é necessário equilíbrio.
- Entre o antigo e o novo. É preciso manter as pessoas antigas, que possam se adaptar e sustentar a missão. Mas, ao mesmo tempo, é necessário trazer novos talentos, o que vamos discutir mais adiante.
- Experiência. Eu conversei muito com bons juniores que estavam animados e queriam trabalhar conosco. Mas eu não pude contratá-los, porque não havia seniores suficientes para apoiar os juniores e serem seus mentores. Era preciso primeiro formar a liderança e apenas depois trazer os jovens.
- Recompensa e punição.
Não tenho uma boa resposta para a pergunta de qual é o equilíbrio certo, como mantê-lo, quantas pessoas manter e quão firme ser. É um processo puramente individual.
Dia cinquenta e um
Comecei a observar a equipe para entender quem eu tinha, e mais uma vez lembrei:
«A maioria dos problemas são problemas com as pessoas».
Descobri que havia três grandes problemas na equipe, tanto com os desenvolvedores quanto com as operações:
- Satisfação com a situação atual.
- Falta de responsabilidade — porque ninguém nunca vinculou os resultados do trabalho dos executores ao impacto nos negócios.
- Medo de mudanças.
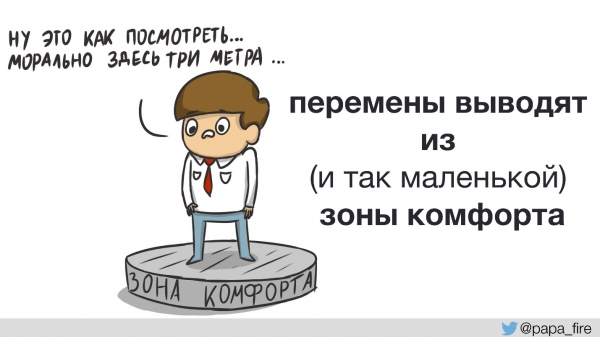
Mudanças sempre tiram as pessoas da zona de conforto, e quanto mais jovens as pessoas são, mais elas não gostam de mudanças, porque não entendem o porquê e não compreendem como. A resposta mais comum que ouvi foi: “Nunca fizemos assim”. Chegou a um ponto de puro absurdo — as menores mudanças não aconteciam sem que alguém se revoltas-se. E não importava o quanto as mudanças afetassem o trabalho deles, as pessoas diziam: “Não, por quê? Isso não vai funcionar”.
Mas não se pode melhorar nada sem fazer mudanças.
Tive uma conversa absolutamente absurda com um funcionário, eu estava compartilhando minhas ideias para otimização, e ele me disse:
— Ah, você não viu o que tivemos no ano passado!
— E daí?
— Agora está muito melhor do que era.
— Então, não pode ficar melhor ainda?
— Por quê?
Boa pergunta — por quê? Como se, se agora está melhor do que era, tudo fosse suficientemente bom. Isso leva à falta de responsabilidades, o que, no fundo, é absolutamente normal. Como eu disse, a equipe técnica estava um pouco à parte. Na empresa, acreditava-se que deveriam estar, mas ninguém nunca estabeleceu padrões. No suporte técnico, nunca viram um SLA, então, para o grupo, era perfeitamente "aceitável" (e isso me surpreendeu mais):
- 12 segundos de carregamento;
- 5-10 minutos de downtime a cada entrega;
- resolver problemas críticos leva dias e semanas;
- não havia plantões 24x7 / on-call.
Ninguém nunca tentou perguntar por que não poderíamos fazer isso melhor, e ninguém nunca entendeu que as coisas não deveriam ser assim.
Como bônus, havia mais um problema: a falta de experiência. Os seniores saíram, e a equipe jovem restante cresceu sob o mesmo regime e foi envenenada por isso.
Além disso, as pessoas também tinham medo de falhar, de parecerem incompetentes. Isso se manifesta no fato de que, em primeiro lugar, nunca pediram ajuda, sob nenhuma circunstância.Quantas vezes conversamos em grupo e individualmente, e eu dizia: “Pergunte, se não souber como fazer algo”. Eu tenho confiança em mim mesmo e sei que posso resolver qualquer problema, mas isso vai levar tempo. Portanto, se posso perguntar a alguém que sabe como resolver isso em 10 minutos, eu pergunto. Quanto menor for sua experiência, mais você tem medo de perguntar, porque acha que vão te considerar incompetente.
Esse medo de fazer perguntas se manifesta de maneiras interessantes. Por exemplo, você pergunta: "Como está essa tarefa?" — "Faltam umas horas, já estou terminando". No dia seguinte, você pergunta novamente, recebe a resposta de que está tudo bem, mas surgiu um probleminha, que definitivamente estará pronto até o final do dia. Mais um dia passa, e enquanto você não pressionar alguém e não forçar uma conversa, tudo continua assim. A pessoa quer resolver a tarefa sozinha, acha que se não resolver, isso será um grande fracasso.
É por isso que os desenvolvedores exageravam nas estimativas. Foi uma piada quando discutíamos uma determinada tarefa, me foi dada uma cifra que me surpreendeu muito. Ao que me disseram que nas estimativas o desenvolvedor inclui também o tempo que o ticket levará para voltar do QA, porque eles encontrarão erros, e o tempo que o PR levará, e o tempo enquanto as pessoas que devem revisá-lo estarão ocupadas — ou seja, tudo o que for possível.
Em segundo lugar, as pessoas que têm medo de parecer incompetentes analisam demais. Quando você diz o que precisa ser feito, começa: "Não, e se pensarmos sobre isso aqui?" Nesse sentido, nossa empresa não é única, é um problema padrão da juventude.
Como resposta, introduzi as seguintes práticas:
- Regra de 30 minutos. Se em meia hora você não consegue resolver o problema, peça ajuda a alguém. Isso funciona com sucesso variável, porque as pessoas ainda assim não pedem, mas pelo menos o processo começou.
- Excluir tudo, exceto a essência, na avaliação do prazo de execução da tarefa, ou seja, contar apenas o tempo que levará para escrever o código.
- Aprendizado contínuo para aqueles que analisam demais. É um trabalho constante com as pessoas.
Dia sessenta
Enquanto eu lidava com tudo isso, chegou a hora de entender o orçamento. Claro, encontrei muita coisa interessante sobre onde estávamos gastando dinheiro. Por exemplo, tínhamos um rack inteiro em um data center separado, que tinha um servidor FTP, usado por um único cliente. Descobriu-se que “... estávamos nos mudando, e ele ficou lá, não trocamos”. Isso foi há 2 anos.
Um ponto de especial interesse era a fatura pelos serviços de nuvem. Estou certo de que a principal razão para a alta fatura dos serviços em nuvem é que os desenvolvedores, pela primeira vez em suas vidas, possuem acesso ilimitado aos servidores. Eles não precisam pedir: "Por favor, me deem um servidor de teste", pois podem pegar um por conta própria. Além disso, os desenvolvedores sempre querem construir um sistema tão impressionante que até o Facebook e a Netflix ficariam com inveja.
Mas os desenvolvedores não têm experiência em adquirir servidores e não sabem como determinar o tamanho correto dos servidores, pois isso nunca foi necessário para eles antes. E geralmente não entendem completamente a diferença entre escalabilidade e desempenho.
Resultados da inventariação:
- Saímos de um data center.
- Rescindimos contratos com 3 serviços de log. Porque tínhamos 5 — cada desenvolvedor que começava a brincar, pegava um novo.
- Desligamos 7 sistemas AWS. Novamente, projetos mortos ninguém parou, todos continuaram funcionando.
- Reduzimos os gastos com software em 6 vezes.
Dia setenta e cinco
O tempo passou e, após dois meses e meio, eu deveria me encontrar com o conselho de administração. Nosso conselho de administração não é melhor nem pior do que os outros, como todos os conselhos de administração, eles querem saber tudo. As pessoas investem dinheiro e querem entender como o que fazemos se encaixa nos KPIs estabelecidos.
O conselho de administração recebe muitas informações todos os meses: número de usuários, seu crescimento, quais serviços eles utilizam e como, a performance e produtividade, finalmente, a média de tempo de carregamento da página.
O problema é que eu considero a média um verdadeiro mal. Mas é muito difícil explicar isso ao conselho de administração. Eles estão acostumados a lidar com números agregados, e não, por exemplo, com a variação do tempo de carregamento em segundos.
Em relação a isso, surgiram momentos interessantes. Por exemplo, eu disse que precisamos dividir o tráfego entre servidores web separados, dependendo do tipo de conteúdo.
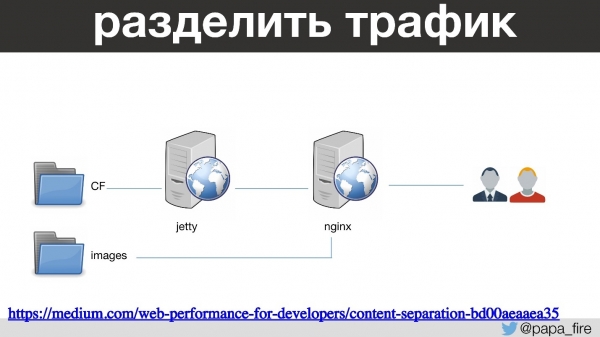
Ou seja, o ColdFusion passa pelo Jetty e nginx e carrega as páginas. E as imagens, JS e CSS são servidos através de um nginx separado com suas próprias configurações. É uma prática bastante padrão, sobre a qual eu já falei alguns anos atrás. Como resultado, as imagens são carregadas muito mais rapidamente, e … a média de tempo de carregamento aumentou em 200 ms.
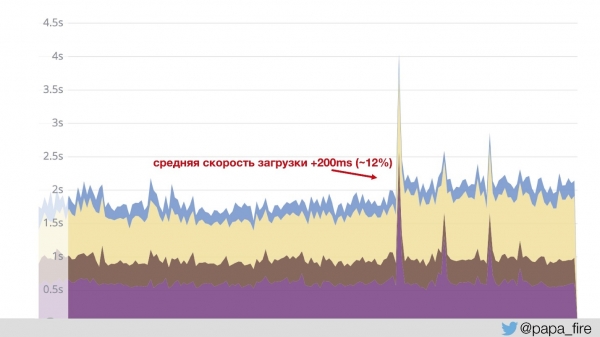
Isso aconteceu porque o gráfico é construído com base em dados que vêm do Jetty. Ou seja, o conteúdo rápido não é levado em conta — a média disparou. Nós entendemos isso, rimos, mas como explicar ao conselho de diretores por que fizemos algo que resultou em uma piora de 12%?
Oitava quinta dia
Ao final do terceiro mês, percebi que havia uma coisa da qual eu não esperava — o tempo. Tudo que mencionei leva tempo.
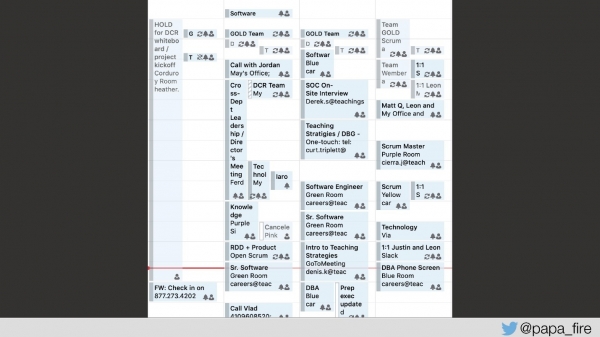
Este é o meu calendário real para a semana — apenas uma semana de trabalho, não muito intensa. Não há tempo suficiente para tudo. Portanto, novamente precisamos contratar pessoas que ajudem a resolver os problemas.
Conclusão
Isso não é tudo. Nesta narrativa, ainda nem cheguei a como trabalhamos com o produto e tentamos sintonizar em uma onda comum, ou como integramos o suporte técnico, ou como resolvemos outros problemas técnicos. Por exemplo, descobri acidentalmente que nas maiores tabelas do banco de dados não estamos utilizando SEQUÊNCIA. Temos uma função personalizada nextID, e ela não é utilizada em transações.
Havia ainda um milhão de coisas semelhantes sobre as quais se poderia falar por muito tempo. Mas o mais importante a mencionar é a cultura.
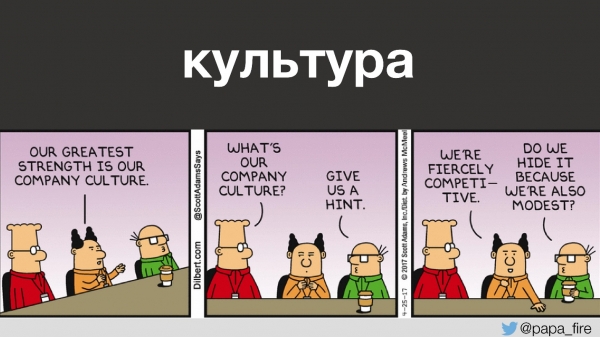
É essa cultura, ou a falta dela, que leva a todos os outros problemas. Estamos tentando construir uma cultura na qual as pessoas:
- não têm medo de fracassos;
- aprendem com os erros;
- colaboram com outras equipes;
- tomam iniciativa;
- assumem a responsabilidade;
- saudam o resultado como um objetivo;
- celebram o sucesso.
Com isso, o resto virá.
Leon Fire , e no .
Em relação ao legado, existem duas estratégias: evitar trabalhar com ele a todo custo ou enfrentar bravamente as dificuldades associadas. Nós estamos seguindo o segundo caminho, mudando processos e abordagens. Junte-se a nós no , e , e vamos juntos implementar a cultura DevOps.
Fonte: habr.com
