

Como converter requisitos de negócios em estruturas de dados concretas, usando como exemplo o design de um banco de dados "do zero" para um mensageiro.
- Parte 1: projetando a estrutura do banco
Nosso banco de dados não será tão escalável e distribuído como o do VKontakte, ou caber em um único servidor. PostgreSQL — para que seja possível implantar uma instância separada do serviço em algum lugar, por exemplo. Portanto, não vamos abordar questões de sharding, replicação e sistemas geodistribuídos, mas nos concentrar nas soluções esquemáticas dentro do banco de dados.
Passo 1: Um pouco de especificidade de negócios.
Nossa troca de mensagens não será projetada de forma abstrata, mas sim integrada ao ambiente
de uma rede social corporativa. E quais tarefas um negócio pode ter?... Vamos observar pelo exemplo de Vasily — gerente do departamento de desenvolvimento.
"Nikolai, este patch precisa ser feito hoje!"
- Portanto, a troca de mensagens pode ocorrer no contexto de algo como
"Kolya, vamos jogar Dota esta noite?" do documento.. - Ou seja, mesmo entre um par de interlocutores, a comunicação pode ocorrer simultaneamente
sobre diferentes temas. "Petr, Nikolai, olhem em anexo o preço do novo servidor.". - Assim, uma mensagem pode ter
vários destinatários. Nesse caso, a mensagem pode conterarquivos anexados. "Semen, você também dê uma olhada.". - E deve haver a possibilidade de convidar um novo participante
para uma conversa já existente. Vamos ficar por aqui com esta lista de necessidades "óbvias"..
Sem compreensão da especificidade aplicada da tarefa e das restrições impostas a ela, projetar
um esquema eficaz de banco de dados para sua solução é praticamente impossível. Passo 2: Esquema lógico mínimo.
O esquema ainda se assemelha muito a um correio eletrônico - uma ferramenta tradicional de condução de negócios. De fato, "algoritmicamente" muitas tarefas de negócios se parecem entre si, portanto, as ferramentas para resolvê-las também serão estruturalmente semelhantes.
Vamos registrar o esquema lógico de relações entre entidades que já obtivemos. Para simplificar a compreensão do nosso modelo, usaremos a versão mais primitiva de representação
de um modelo ER sem complicações de UML ou notações IDEF:
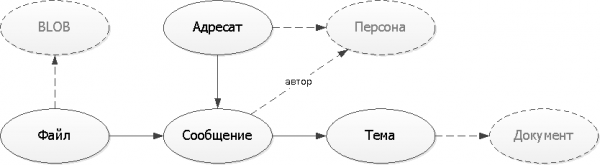
Em nosso exemplo, a entidade, o documento e o 'corpo' binário do arquivo são entidades 'externas' que existem independentemente do nosso serviço. Portanto, vamos tratá-las como alguns links 'para algum lugar' via UUID.
Desenhe esquemas o mais simples possível — a maioria das pessoas para quem você os mostrará não são especialistas em ler UML/IDEF. Mas — definitivamente desenhe.
Passo 3: Esboçando a estrutura das tabelas
Sobre os nomes das tabelas e camposOs nomes 'russos' dos campos e tabelas podem ser encarados de diferentes maneiras, mas isso é uma questão de gosto. Como estiverem entre aspas , preferimos nomear os objetos de forma clara e inequívoca, para evitar mal-entendidos., preferimos nomear os objetos de forma clara e inequívoca, para evitar ambiguidades.
Como muitas pessoas escrevem mensagens ao mesmo tempo, algumas podem fazê-lo offline, a opção mais simples é usar UUID como identificadores não apenas para entidades externas, mas para todos os objetos dentro do nosso serviço. E é possível gerá-los até no lado do cliente — isso nos ajudará a manter o envio de mensagens em caso de indisponibilidade temporária do BD, e a probabilidade de colisão é extremamente baixa.
A estrutura preliminar das tabelas em nosso banco de dados será assim:
Tabelas : RU
CREATE TABLE "Tema"(
  "Tema"
    uuid
      PRIMARY KEY
, "Documento"
    uuid
, "Título"
    text
);

CREATE TABLE "Mensagem"(
  "Mensagem"
    uuid
      PRIMARY KEY
, "Tema"
    uuid
, "Autor"
    uuid
, "DataHora"
    timestamp
, "Texto"
    text
);

CREATE TABLE "Destinatário"(
  "Mensagem"
    uuid
, "Entidade"
    uuid
, PRIMARY KEY("Mensagem", "Entidade")
);

CREATE TABLE "Arquivo"(
  "Arquivo"
    uuid
      PRIMARY KEY
, "Mensagem"
    uuid
, "BLOB"
    uuid
, "Nome"
    text
);
Tabelas : EN
CREATE TABLE theme(
  theme
    uuid
      PRIMARY KEY
, document
    uuid
, title
    text
);

CREATE TABLE message(
  message
    uuid
      PRIMARY KEY
, theme
    uuid
, author
    uuid
, dt
    timestamp
, body
    text
);

CREATE TABLE message_addressee(
  message
    uuid
, person
    uuid
, PRIMARY KEY(message, person)
);

CREATE TABLE message_file(
  file
    uuid
      PRIMARY KEY
, message
    uuid
, content
    uuid
, filename
    text
);
A maneira mais simples de descrever o formato é começar a 'desenrolar' o gráfico de relações a partir de tabelas que não referenciam nenhuma outra.
Passo 4: Descobrindo necessidades não óbvias
Pronto, projetamos um banco de dados no qual é possível escrever bem e de alguma forma ler.
Vamos nos colocar no lugar do usuário do nosso serviço — o que queremos fazer com a ajuda dele?
- Mensagens recentes
Isso é classificadas cronologicamente por vários critérios, um registro das minhas mensagens. Onde sou um dos destinatários, onde sou o autor, onde me escreveram, mas eu não respondi, onde não me responderam, … - Participantes da conversa
Quem está realmente participando deste chat longo e extenso?
Nossa estrutura permite resolver ambas as tarefas "em geral", mas rapidamente — não. O problema é que, para a classificação na primeira tarefa é impossível criar um índice, adequado para cada um dos participantes (tendo que extrair todos os registros), e para resolver o segundo é necessário extrair todas as mensagens sobre o assunto.
Tarefas do usuário não previstas podem colocar um forte fator contra a performance.
Passo 5: Desnormalização razoável
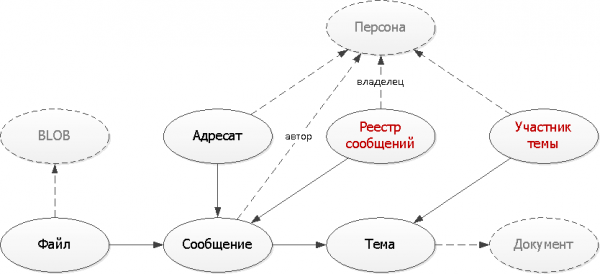
Ambos os nossos problemas podem ser resolvidos com tabelas adicionais, nas quais vamos duplicar parte dos dados, necessários para formar índices adequados às nossas necessidades.
Tabelas : RU
CREATE TABLE "RegistroMensagens"(
  "Proprietário"
    uuid
, "TipoRegistro"
    smallint
, "DataHora"
    timestamp
, "Mensagem"
    uuid
, PRIMARY KEY("Proprietário", "TipoRegistro", "Mensagem")
);
CREATE INDEX ON "RegistroMensagens"("Proprietário", "TipoRegistro", "DataHora" DESC);

CREATE TABLE "ParticipanteTema"(
  "Tema"
    uuid
, "Pessoa"
    uuid
, PRIMARY KEY("Tema", "Pessoa")
);
Tabelas : EN
CREATE TABLE message_registry(
  owner
    uuid
, registry
    smallint
, dt
    timestamp
, message
    uuid
, PRIMARY KEY(owner, registry, message)
);
CREATE INDEX ON message_registry(owner, registry, dt DESC);

CREATE TABLE theme_participant(
  theme
    uuid
, person
    uuid
, PRIMARY KEY(theme, person)
);
Aqui aplicamos duas abordagens típicas usadas na criação de tabelas auxiliares:
- Multiplicação de registros
Geramos várias gravações resultantes a partir de uma única gravação original de mensagem em diferentes tipos de registros para diferentes proprietários — tanto para o remetente quanto para o destinatário. Assim, cada registro agora se encaixa em um índice — pois, em geral, queremos ver apenas a primeira página. - Uniqueness of records
Ao enviar uma mensagem dentro de um tema específico, é suficiente verificar se esse registro já existe. Se não existir — adicionamos ao nosso "dicionário".
Na próxima parte do artigo, falaremos sobre na estrutura do nosso banco de dados.
Fonte: habr.com
