

Projetamos com sucesso a estrutura do nosso banco de dados PostgreSQL para armazenar conversas; um ano se passou e os usuários estão ativamente preenchendo-o, já há milhões de registros, e… algo começou a ficar lento.
- Parte 2: seccionando ‘ao vivo’
O fato é que com o aumento do volume da tabela, a ‘profundidade’ dos índices também cresce — embora de forma logarítmica. Mas, com o tempo, isso faz com que o servidor processe um número muito maior de páginas de dados, em comparação ao começo.
É aqui que entra em cena o particionamento..
Vale ressaltar que estamos falando não de sharding, ou seja, de distribuir dados entre diferentes bancos ou servidores. Porque, mesmo dividindo os dados em alguns servidores, você não se livra do problema de ‘inchaço’ dos índices ao longo do tempo. É claro que, se você pode se dar ao luxo de adicionar um novo servidor todos os dias, seus problemas estarão em uma dimensão completamente diferente da base de dados específica.
Nós iremos examinar não scripts específicos para implementar o particionamento ‘no hardware’, mas sim a abordagem — o que e como deve ser ‘cortado em fatias’, e quais consequências esse desejo traz.
Conceito
Vamos redefinir nosso objetivo: queremos garantir que, hoje, amanhã e daqui um ano, a quantidade de dados lidos do PostgreSQL em qualquer operação de leitura/escrita permaneça aproximadamente a mesma.
Para quaisquer dados acumulados cronologicamente (mensagens, documentos, logs, arquivos, …) a escolha natural como chave de particionamento é data/hora do evento. Neste caso, tal evento é o momento do envio da mensagem..
Notamos que os usuários quase sempre trabalham apenas com os ‘últimos’ dados — leem as últimas mensagens, analisam os últimos logs,… Não, claro, eles podem rolar para trás no tempo, mas fazem isso muito raramente.
Dessas limitações, é evidente que a solução ideal para mensagens será seções ‘diárias’ — pois quase sempre nosso usuário estará lendo o que lhe chegou ‘hoje’ ou ‘ontem’.
Se durante o dia escrevemos e lemos praticamente apenas em uma seção, isso nos proporciona um uso mais eficiente de memória e disco. — uma vez que todos os índices da seção cabem facilmente na memória, ao contrário dos "grandes e robustos" em toda a tabela.
passo a passo
No geral, tudo o que foi dito acima soa como um ganho contínuo. E isso é alcançável, mas para isso precisamos nos esforçar bastante — porque a decisão de seccionar uma das entidades leva à necessidade de "dividir" as relacionadas.
Mensagem, suas propriedades e projeções
Já que decidimos dividir as mensagens por datas, é razoável também dividir as entidades relacionadas a elas (arquivos anexos, lista de destinatários), e também pela data da mensagem.
Como uma das nossas tarefas típicas é exatamente a visualização dos registros de mensagens (não lidas, recebidas, todas), é lógico "incluir" também isso na seccionamento por datas das mensagens.
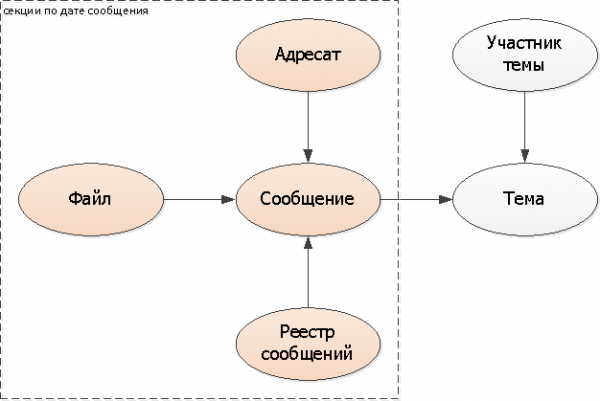
Adicionamos a chave de seccionamento (data da mensagem) em todas as tabelas: destinatários, arquivo, registros. Na própria mensagem, não é necessário adicionar, pode-se usar a existente DataHora.
Temas
Como o tema é um para várias mensagens, não dá para "dividi-lo" na mesma modelagem, devemos nos basear em outra coisa. No nosso caso, se encaixa perfeitamente a data da primeira mensagem na conversa — ou seja, o momento da criação, propriamente dito, do tema.
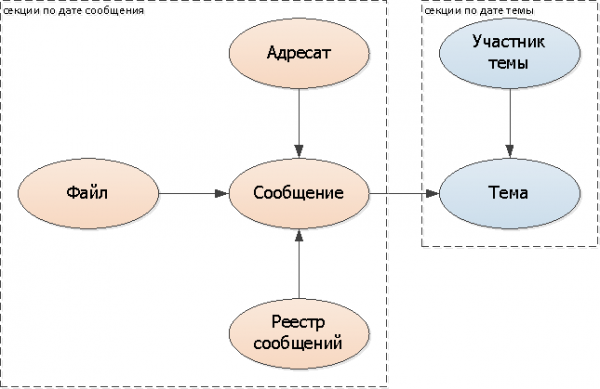
Adicionamos a chave de seccionamento (data do tema) em todas as tabelas: tema, participante.
Mas agora temos imediatamente dois problemas:
- em qual seção procurar mensagens pelo tema?
- em qual seção procurar o tema a partir da mensagem?
Podemos, é claro, continuar procurando em todas as seções, mas isso seria muito triste, e anularia todos os nossos ganhos. Portanto, para saber onde procurar especificamente, faremos referências lógicas / indicadores para as seções:
- na mensagem adicionaremos um campo com a data do tema
- ao tema adicionaremos um conjunto de datas das mensagens dessa conversa (pode ser uma tabela separada ou um array de datas)
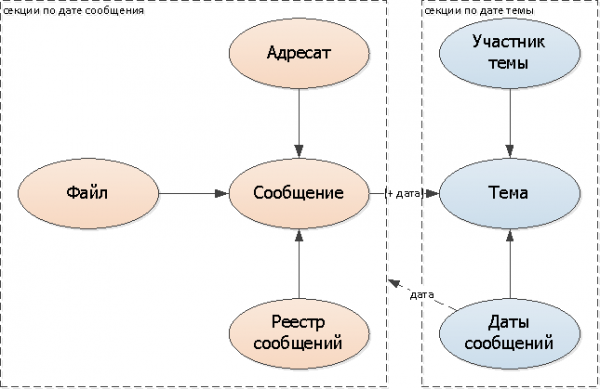
Como as modificações da lista de datas das mensagens para cada conversa específica serão poucas (afinal, quase todas as mensagens caem em 1-2 dias vizinhos), vou exatamente me ater a essa opção.
Em resumo, a estrutura do nosso banco assumiu a seguinte forma, considerando o seccionamento:
Tabelas: RU, ao aversar-se à escrita em cirílico nos nomes das tabelas/campos, é melhor não olhar
-- seções por data da mensagem
CREATE TABLE "Mensagem_YYYYMMDD"(
  "Mensagem"
    uuid
      PRIMARY KEY
, "Tema"
    uuid
, "DataTema"
    date
, "Autor"
    uuid
, "DataHora" -- utilizado como data
    timestamp
, "Texto"
    text
);

CREATE TABLE "Destinatario_YYYYMMDD"(
  "DataMensagem"
    date
, "Mensagem"
    uuid
, "Pessoa"
    uuid
, PRIMARY KEY("Mensagem", "Pessoa")
);

CREATE TABLE "Arquivo_YYYYMMDD"(
  "DataMensagem"
    date
, "Arquivo"
    uuid
      PRIMARY KEY
, "Mensagem"
    uuid
, "BLOB"
    uuid
, "Nome"
    text
);

CREATE TABLE "RegistroMensagens_YYYYMMDD"(
  "DataMensagem"
    date
, "Proprietário"
    uuid
, "TipoRegistro"
    smallint
, "DataHora"
    timestamp
, "Mensagem"
    uuid
, PRIMARY KEY("Proprietário", "TipoRegistro", "Mensagem")
);
CREATE INDEX ON "RegistroMensagens_YYYYMMDD"("Proprietário", "TipoRegistro", "DataHora" DESC);

-- seções por data do tema
CREATE TABLE "Tema_YYYYMMDD"(
  "DataTema"
    date
, "Tema"
    uuid
      PRIMARY KEY
, "Documento"
    uuid
, "Título"
    text
);

CREATE TABLE "ParticipanteTema_YYYYMMDD"(
  "DataTema"
    date
, "Tema"
    uuid
, "Pessoa"
    uuid
, PRIMARY KEY("Tema", "Pessoa")
);

CREATE TABLE "DatasMensagensTema_YYYYMMDD"(
  "DataTema"
    date
, "Tema"
    uuid
      PRIMARY KEY
, "Data"
    date
);
Economizando um trocado
Bem, e se não usarmos baseada na distribuição dos valores do campo (através de gatilhos e herança ou PARTITION BY), mas sim ‘manualmente’ no nível da aplicação, podemos notar que o valor da chave de particionamento já está armazenado no nome da própria tabela.
Portanto, se você está tão preocupado com o volume de dados armazenados, então você pode se livrar desses ‘campos a mais’ e acessar diretamente tabelas específicas. Porém, todas as consultas envolvendo várias seções terão que ser movidas para o lado da aplicação.
Fonte: habr.com
