

O lançamento do Pandas 1.0.0rc ocorreu em 9 de janeiro. A versão anterior da biblioteca era 0.25.
O primeiro lançamento major contém muitas novidades incríveis, incluindo uma melhor soma automática de DataFrames, mais formatos de saída, novos tipos de dados e até mesmo um novo site de documentação.
Todas as alterações podem ser vistas , neste artigo, faremos uma breve visão geral menos técnica do que há de mais importante.
Você pode instalar a biblioteca como de costume usando pip, mas como, no momento da redação deste artigo, o Pandas 1.0 ainda é um release candidate, será necessário indicar explicitamente a versão:
pip install --upgrade pandas==1.0.0rc0Tenha cuidado: como é um lançamento major, a atualização pode quebrar o código antigo!
Aliás, nesta versão, o suporte ao Python 2 foi completamente encerrado (o que pode ser um bom motivo — nota do tradutor.). O Pandas 1.0 requer pelo menos Python 3.6+, então, se não tiver certeza, verifique qual está instalado em seu sistema:
$ pip --version
pip 19.3.1 from /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Verificar a versão do Pandas é mais fácil assim:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Soma automática aprimorada com DataFrame.info
Minha novidade favorita foi a atualização do método DataFrame.info. A função agora é muito mais legível, tornando o processo de exploração dos dados ainda mais simples:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["adeus", "cruel", "mundo"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entradas, 0 a 2
Colunas de dados (total 3 colunas):
 #   Coluna  Contagem Não Nula  Tipo
---  ------  ------------------  -----
 0   A       3 não nulos       int64
 1   B       3 não nulos       objeto
 2   C       3 não nulos       objeto
tipos: int64(1), objeto(2)
uso de memória: 200.0+ bytes
Exportação de tabelas no formato Markdown
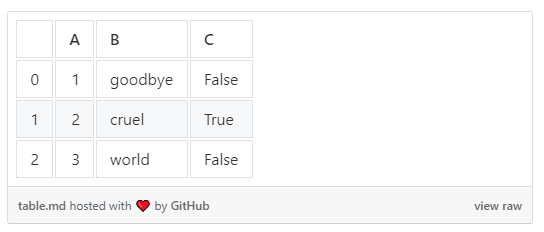
Outra novidade interessante foi a capacidade de exportar DataFrames para tabelas Markdown usando DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | adeus   | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | mundo   | False |
Isso facilita muito a publicação de tabelas em sites como Medium usando gists do GitHub.
Novos tipos para strings e valores lógicos
No lançamento do Pandas 1.0, também foram adicionados novos tipos experimentais. Sua API ainda pode mudar, então use com cautela. Mas, de modo geral, o Pandas recomenda o uso dos novos tipos onde fizer sentido.
Por enquanto, a conversão precisa ser feita explicitamente:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Observe como a coluna Dtype exibe novos tipos — string e bool.
A característica mais útil do novo tipo de string é a possibilidade de selecionar apenas colunas de string dos dataframes. Isso pode simplificar significativamente a análise de dados textuais:
df.select_dtypes("string")Anteriormente, não era possível selecionar colunas de string sem especificar seus nomes claramente.
Você pode ler mais sobre os novos tipos .
Obrigado por ler até aqui! A lista completa de alterações, como já mencionado, pode ser vista .
Fonte: habr.com
