

Bom dia! Meu nome é Danil Lipovoy, nossa equipe na Sbertech começou a usar HBase como um repositório de dados operacionais. Durante seu estudo, acumulamos experiência que gostaríamos de sistematizar e descrever (esperamos que seja útil para muitos). Todos os experimentos realizados abaixo foram feitos com as versões HBase 1.2.0-cdh5.14.2 e 2.0.0-cdh6.0.0-beta1.
- Arquitetura Geral
- Gravação de Dados em HBASE
- Leitura de Dados de HBASE
- Cache de Dados
- Processamento de Dados em Lote MultiGet/MultiPut
- Estratégia de Divisão de Tabelas em Regiões (Split)
- Alta Disponibilidade, Compactação e Localidade de Dados
- Configurações e Desempenho
- Testes de carga
- Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
1. Arquitetura Geral
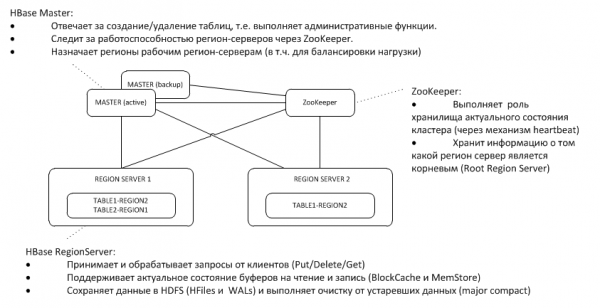
O Master de backup escuta o heartbeat do ativo no nó do ZooKeeper e, em caso de desaparecimento, assume as funções de Master.
2. Gravação de Dados em HBASE
Primeiro, consideramos o caso mais simples – a gravação de um objeto chave-valor em uma tabela usando put(rowkey). O cliente precisa primeiro descobrir onde está o servidor da região raiz (Root Region Server - RRS), que armazena a tabela hbase:meta. Essa informação é obtida do ZooKeeper. Em seguida, ele se conecta ao RRS e lê a tabela hbase:meta, da qual extrai informações sobre qual RegionServer (RS) é responsável por armazenar os dados para a chave rowkey na tabela de interesse. Para uso futuro, a meta-tabela é armazenada em cache pelo cliente, e, portanto, as chamadas subsequentes são mais rápidas, indo diretamente para o RS.
Após o RRS receber a solicitação, ele primeiramente a escreve no WriteAheadLog (WAL), o que é necessário para recuperação em caso de falha. Em seguida, os dados são salvos no MemStore. Este é um buffer na memória que contém um conjunto classificado de chaves desta região. A tabela pode ser dividida em regiões (partições), cada uma contendo um conjunto exclusivo de chaves. Isso permite que, ao distribuir as regiões em diferentes servidores, se obtenha um desempenho mais alto. No entanto, apesar da obviedade dessa afirmação, veremos a seguir que isso não se aplica a todos os casos.
Após a gravação no MemStore, o cliente recebe uma resposta informando que a gravação foi concluída com sucesso. No entanto, na realidade, ela é armazenada apenas no buffer e será gravada no disco apenas após um determinado intervalo de tempo ou quando for preenchida com novos dados.
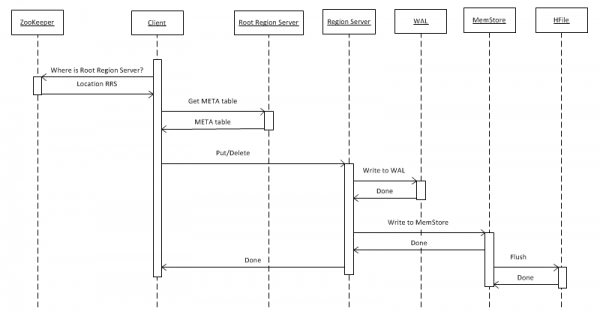
Ao executar a operação 'Delete', não ocorre a exclusão física dos dados. Eles simplesmente são marcados como excluídos, e a exclusão real acontece no momento da chamada da função major compact, sobre a qual há mais informações no item 7.
Os arquivos no formato HFile se acumulam no HDFS e, de tempos em tempos, é iniciado um processo de minor compact, que apenas junta pequenos arquivos em arquivos maiores, sem excluir nada. Com o tempo, isso se torna um problema que se manifesta apenas ao ler os dados (voltaremos a isso mais adiante).
Além do processo de carregamento descrito acima, existe um procedimento muito mais eficiente, que é talvez o ponto mais forte deste banco de dados – o BulkLoad. Isso envolve a criação manual de HFiles e seu armazenamento em disco, o que permite uma escalabilidade excelente e velocidades bastante altas. Na verdade, a limitação aqui não é o HBase, mas as capacidades do hardware. Abaixo estão os resultados do carregamento em um cluster composto por 16 RegionServers e 16 NodeManagers YARN (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads), versão HBase 1.2.0-cdh5.14.2.
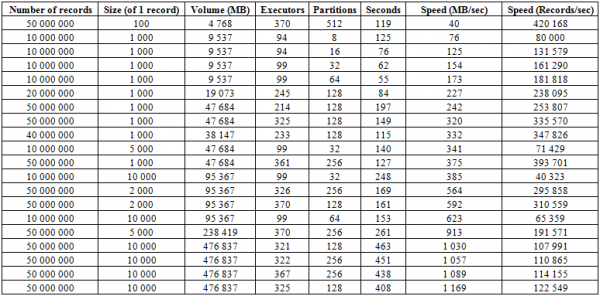
Aqui, é visível que aumentando o número de partições (regiões) na tabela, bem como os executores Spark, obtemos um aumento na velocidade de carregamento. A velocidade também depende do volume de gravação. Blocos grandes proporcionam um aumento em termos de MB/segundo, enquanto blocos pequenos aumentam a quantidade de registros inseridos por unidade de tempo, mantendo todas as outras variáveis constantes.
Também é possível iniciar o carregamento em duas tabelas simultaneamente e obter o dobro da velocidade. Abaixo, é mostrado que a gravação de blocos de 10 KB em duas tabelas vai a uma velocidade de cerca de 600 MB/segundo cada (totalizando 1275 MB/segundo), que corresponde à velocidade de gravação em uma tabela de 623 MB/segundo (ver nº 11 acima).
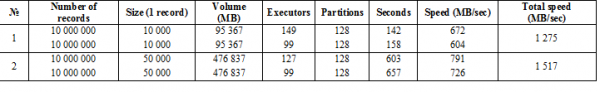
Por outro lado, a segunda execução com gravações de 50 KB mostra que a velocidade de carregamento cresce de forma insignificante, o que indica uma aproximação aos limites máximos. É importante considerar que a carga no próprio HBASE é praticamente inexistente; tudo o que é necessário dele é, primeiro, fornecer os dados do hbase:meta e, depois, ao adicionar os HFiles, liberar os dados do BlockCache e salvar o buffer MemStore no disco, caso não esteja vazio.
3. Leitura de dados do HBASE
Se considerarmos que todas as informações de hbase:meta já estão com o cliente (ver item 2), a consulta vai diretamente para o RS que armazena a chave necessária. Primeiro, a busca é realizada no MemCache. Independentemente de haver ou não dados lá, a busca também é feita no buffer BlockCache e, se necessário, nos HFiles. Se os dados forem encontrados no arquivo, eles são armazenados no BlockCache e, na próxima solicitação, serão retornados mais rapidamente. A busca no HFile acontece relativamente rápido devido ao uso do filtro de Bloom, ou seja, ao ler um pequeno volume de dados, ele imediatamente determina se esse arquivo contém a chave necessária e, se não, passa para o próximo.
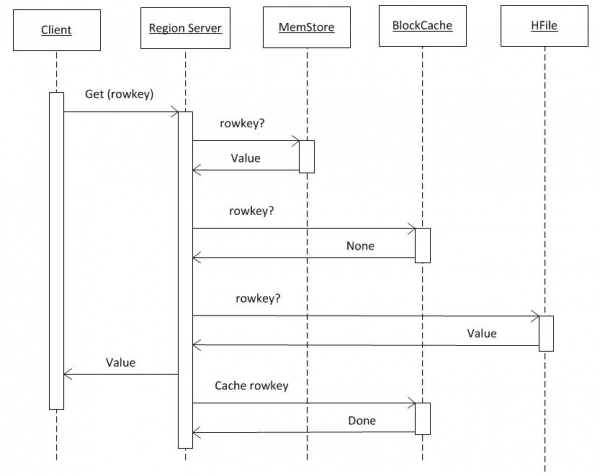
Recebendo dados dessas três fontes, o RS forma a resposta. Em particular, ele pode transmitir várias versões encontradas de um objeto se o cliente solicitar versionamento.
4. Cache de dados
Os buffers MemStore e BlockCache ocupam até 80% da memória heap alocada do RS (o restante é reservado para tarefas de serviço do RS). Se o modo típico de uso for tal que os processos escrevam e leiam esses mesmos dados imediatamente, faz sentido diminuir o BlockCache e aumentar o MemStore, pois ao gravar, os dados no cache de leitura não são acessados, o que fará com que o uso do BlockCache ocorra com menos frequência. O buffer BlockCache consiste em duas partes: LruBlockCache (sempre on-heap) e BucketCache (geralmente off-heap ou em SSD). O BucketCache deve ser utilizado quando há muitas solicitações de leitura que não cabem no LruBlockCache, o que leva a um trabalho ativo do Garbage Collector. Contudo, não se deve esperar um aumento drástico de desempenho da utilização do cache de leitura, mas voltaremos a isso no item 8.
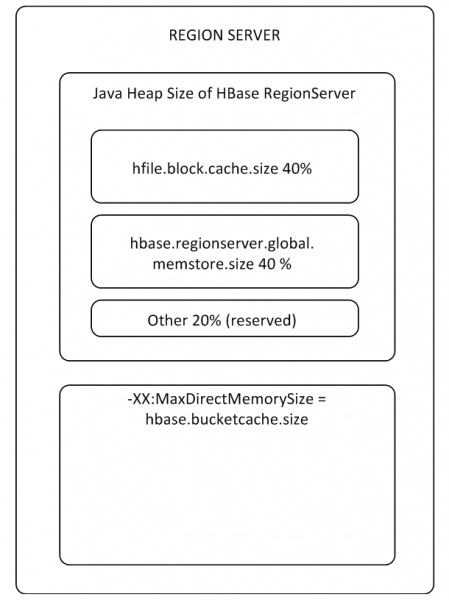
O BlockCache é único para todo o RS, enquanto o MemStore é específico para cada tabela (um por cada Column Family).
Como Na teoria, ao gravar, os dados não vão para o cache e, de fato, esses parâmetros CACHE_DATA_ON_WRITE para a tabela e "Cache DATA on Write" para o RS estão configurados como false. No entanto, na prática, se gravarmos dados no MemStore, depois o descarregarmos no disco (limpando assim), e em seguida deletarmos o arquivo resultante, ao executar uma solicitação get, conseguiremos obter os dados com sucesso. Além disso, mesmo se desativarmos completamente o BlockCache e preenchermos a tabela com novos dados, depois conseguirmos descarregar o MemStore no disco, deletá-los e solicitá-los de outra sessão, eles ainda serão recuperados de algum lugar. Portanto, o HBase armazena não apenas dados, mas também mistérios enigmáticos.
hbase(main):001:0> criar 'ns:magic', 'cf'
Tabela ns:magic criada
Demorou 1.1533 segundos
hbase(main):002:0> colocar 'ns:magic', 'key1', 'cf:c', 'tente_me_deletar'
Demorou 0.2610 segundos
hbase(main):003:0> esvaziar 'ns:magic'
Demorou 0.6161 segundos
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> obter 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, valor=tente_me_deletar
O parâmetro "Cache DATA on Read" está definido como falso. Se tiver alguma ideia, fique à vontade para discutir nos comentários.
5. Processamento em Lote de Dados MultiGet/MultiPut
O processamento de solicitações individuais (Get/Put/Delete) é uma operação bastante cara, portanto, deve-se tentar agrupá-las em List ou List, o que pode resultar em um aumento significativo de desempenho. Isso é especialmente verdadeiro para operações de gravação, mas há uma armadilha ao ler. No gráfico abaixo está o tempo para ler 50.000 registros do MemStore. A leitura foi realizada em um único thread e no eixo horizontal está o número de chaves na solicitação. Pode-se ver que ao aumentar para mil chaves em uma única solicitação, o tempo de execução diminui, ou seja, a velocidade aumenta. No entanto, com o modo MSLAB ativado por padrão, após esse limite, há uma queda drástica no desempenho, e quanto maior o volume de dados no registro, maior o tempo de execução.
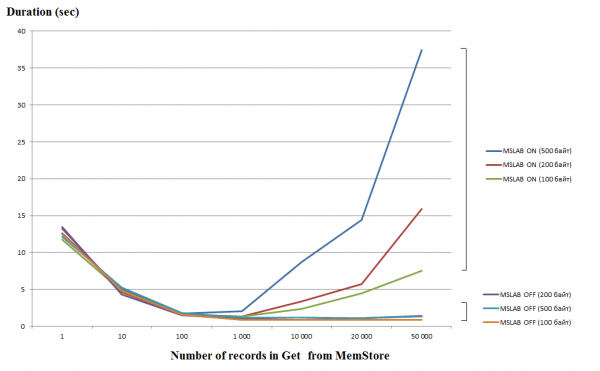
Os testes foram realizados em uma máquina virtual, 8 núcleos, versão HBase 2.0.0-cdh6.0.0-beta1.
O modo MSLAB foi projetado para reduzir a fragmentação do heap, que ocorre devido à mistura de dados de gerações novas e antigas. Para resolver esse problema, ao ativar o MSLAB, os dados são colocados em células (chunk) relativamente pequenas e processados em lotes. Como resultado, quando o volume no pacote de dados solicitado excede o tamanho alocado, o desempenho cai drasticamente. Por outro lado, desativar esse modo também não é desejável, pois levará a pausas devido ao GC em momentos de intenso trabalho com dados. Uma boa saída é aumentar o tamanho da célula, especialmente ao gravar através de put ao mesmo tempo que se lê. Vale ressaltar que o problema não ocorre se, após a gravação, a comando flush que descarrega o MemStore no disco for executada ou se a carga for realizada usando BulkLoad. Na tabela abaixo, mostra-se que solicitações de dados maiores do MemStore (e com a mesma quantidade) levam a uma desaceleração. No entanto, aumentando o chunksize, podemos retornar o tempo de processamento ao normal.
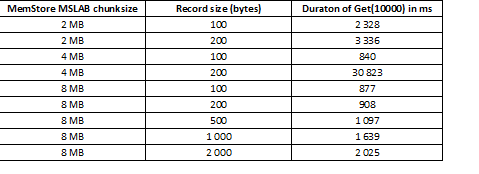
Além de aumentar o chunksize, a fragmentação dos dados por regiões, ou seja, o partitioning das tabelas, ajuda. Isso resulta em um menor número de solicitações para cada região, e se elas forem armazenadas em uma célula, a resposta permanece boa.
6. Estratégia de partitioning de tabelas por regiões
Como o HBase é um repositório de chave-valor e o particionamento é feito pela chave, é crucial distribuir os dados uniformemente entre todas as regiões. Por exemplo, particionar uma tabela em três partes resultará em três regiões:
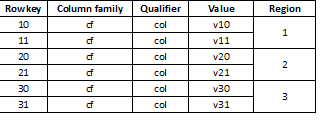
Às vezes, isso leva a uma desaceleração drástica, se os dados carregados posteriormente forem, por exemplo, valores longos que na sua maioria começam com o mesmo dígito, como por exemplo:
1000001
1000002
…
1100003
Como as chaves são armazenadas como um array de bytes, todas elas começarão de forma semelhante e pertencerão à região #1 que armazena esse intervalo de chaves. Existem várias estratégias de particionamento:
HexStringSplit – Converte a chave em uma string com codificação hexadecimal no intervalo de "00000000" => "FFFFFFFF" e preenche à esquerda com zeros.
UniformSplit – Converte a chave em um array de bytes com codificação hexadecimal no intervalo de "00" => "FF" e preenche à direita com zeros.
Além disso, é possível especificar qualquer intervalo ou conjunto de chaves para particionamento e configurar o auto-partitioning. No entanto, uma das abordagens mais simples e eficazes é o UniformSplit e o uso de concatenação do hash, por exemplo, o par mais significativo de bytes ao passar a chave pela função CRC32(rowkey) e a própria chave:
hash + rowkey
Assim, todos os dados serão distribuídos uniformemente entre as regiões. Ao ler, os primeiros dois bytes são simplesmente descartados e a chave original permanece. Além disso, o RS controla a quantidade de dados e chaves na região e, ao ultrapassar os limites, divide automaticamente em partes.
7. Tolerância a falhas e localidade dos dados
Como cada conjunto de chaves é responsabilidade de apenas uma região, a solução para problemas relacionados a falhas do RS ou desativação é armazenar todos os dados necessários no HDFS. Quando um RS falha, o mestre detecta isso pela ausência de heartbeat no nó do ZooKeeper. Em seguida, ele atribui a região problemática a outro RS, e como os HFiles são armazenados em um sistema de arquivos distribuído, o novo proprietário os lê e continua a servir os dados. No entanto, como parte dos dados pode estar no MemStore e não ter sido gravada nos HFiles, para a recuperação do histórico de operações utiliza-se o WAL, que também é armazenado no HDFS. Após a aplicação das alterações, o RS pode responder a solicitações, no entanto, a realocação resulta em que parte dos dados e os processos que os atendem estejam em diferentes nós, ou seja, a localidade diminui.
A solução para o problema é a major compaction – este procedimento move arquivos para os nós que são responsáveis por eles (onde suas regiões estão localizadas), resultando em um aumento repentino na carga sobre a rede e os discos durante esse procedimento. No entanto, o acesso aos dados torna-se significativamente mais rápido posteriormente. Além disso, a major_compaction realiza a fusão de todos os HFiles em um único arquivo dentro da região, além de limpar dados de acordo com as configurações da tabela. Por exemplo, é possível definir o número de versões do objeto a serem mantidas ou o tempo de vida, após o qual o objeto é excluído fisicamente.
Este procedimento pode ter um impacto muito positivo na operação do HBase. Na imagem abaixo, é possível ver como o desempenho degradou devido à gravação ativa de dados. Aqui, 40 threads estavam gravando em uma tabela e 40 threads estavam lendo dados simultaneamente. As threads de gravação formam cada vez mais HFiles, que são consumidos por outras threads. Como resultado, mais dados precisam ser removidos da memória e, eventualmente, o GC começa a operar, o que praticamente paralisa todo o trabalho. A execução da major compaction levou à limpeza dos acúmulos formados e à recuperação do desempenho.
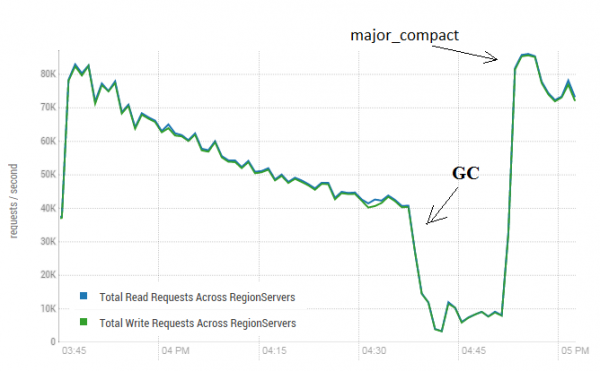
O teste foi realizado em 3 DataNodes e 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads). Versão HBase 1.2.0-cdh5.14.2
Vale ressaltar que a execução da compactação major foi realizada em uma tabela "viva", onde dados estavam sendo ativamente escritos e lidos. Nas redes, havia afirmações de que isso poderia levar a respostas incorretas ao ler dados. Para verificar, foi iniciado um processo que gerava novos dados e os escrevia na tabela. Em seguida, imediatamente lia e verificava se o valor obtido coincidia com o que havia sido gravado. Durante a execução desse processo, a compactação major foi iniciada cerca de 200 vezes sem que nenhum erro fosse registrado. Pode ser que o problema ocorra raramente e apenas durante alta carga, portanto, é mais seguro realmente parar os processos de leitura e escrita de forma planejada e realizar a limpeza, evitando tais quedas no GC.
Além disso, a compactação major não afeta o estado do MemStore, para liberá-lo no disco e compactá-lo é necessário usar flush (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Configurações e desempenho
Como já mencionado, o HBase tem o maior sucesso onde não precisa fazer nada durante a execução do BulkLoad. No entanto, isso é aplicável à maioria dos sistemas e pessoas. Entretanto, essa ferramenta é mais adequada para o carregamento em massa de dados em grandes blocos, enquanto que, se o processo exige a realização de múltiplas requisições concorrentes de leitura e gravação, são utilizadas os comandos Get e Put descritos acima. Para determinar os parâmetros ideais, foram realizados testes com diferentes combinações de parâmetros de tabelas e configurações:
- 10 threads foram executados simultaneamente 3 vezes consecutivas (vamos chamar isso de bloco de threads).
- O tempo de operação de todos os threads no bloco foi calculado como uma média e representava o resultado final do desempenho do bloco.
- Todos os threads trabalhavam com a mesma tabela.
- Antes de cada execução do bloco de threads, uma compactação major era realizada.
- Cada bloco executou apenas uma das seguintes operações:
— Put
— Get
— Get+Put
- Cada bloco realizou 50.000 repetições de sua operação.
- O tamanho da gravação no bloco era de 100 bytes, 1000 bytes ou 10.000 bytes (aleatório).
- Os blocos foram executados com diferentes números de chaves solicitadas (ou uma chave ou 10).
- Os blocos foram executados sob diferentes configurações de tabela. As seguintes variáveis foram alteradas:
— BlockCache = ativado ou desativado
— BlockSize = 65 KB ou 16 KB
— Partições = 1, 5 ou 30
— MSLAB = ativado ou desativado
Assim, o bloco é configurado da seguinte forma:
a. O modo MSLAB foi ativado/desativado.
b. Uma tabela foi criada, para a qual os seguintes parâmetros foram definidos: BlockCache = true/none, BlockSize = 65/16 Kb, Partições = 1/5/30.
c. A compressão GZ foi ativada.
d. 10 threads foram iniciadas simultaneamente realizando 1/10 operações put/get/get+put nesta tabela com registros de 100/1000/10000 bytes, executando 50.000 solicitações consecutivas (as chaves eram aleatórias).
e. O item d foi repetido três vezes.
f. O tempo de execução de todas as threads foi calculado como uma média.
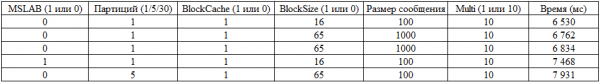
Todas as combinações possíveis foram testadas. É previsível que, ao aumentar o tamanho do registro, a velocidade caia ou que a desativação do cache cause lentidão. No entanto, o objetivo era entender a magnitude e a importância do impacto de cada parâmetro, por isso os dados coletados foram fornecidos como entrada para uma função de regressão linear, que permite avaliar a confiabilidade usando a estatística t. Abaixo estão os resultados das operações Put. O conjunto completo de combinações é 2*2*3*2*3 = 144 variantes + 72, pois algumas foram executadas duas vezes. Portanto, no total, foram 216 execuções:
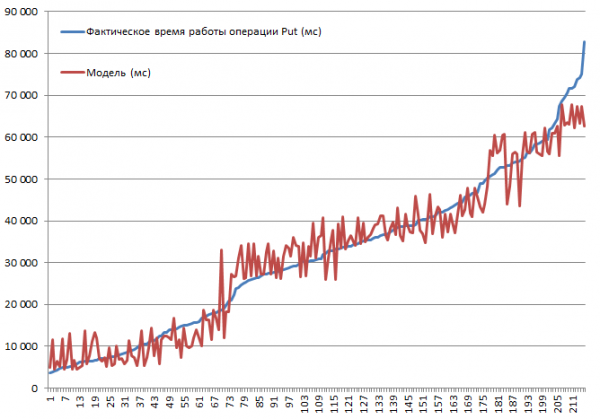
Os testes foram realizados em um mini-cluster composto por 3 DataNodes e 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads). Versão do HBase 1.2.0-cdh5.14.2.
A maior velocidade de inserção de 3,7 segundos foi obtida com o modo MSLAB desligado, em uma tabela com uma partição, com o BlockCache ativado, BlockSize = 16, registros de 100 bytes em pacotes de 10.
A menor velocidade de inserção de 82,8 segundos foi obtida com o modo MSLAB ativado, em uma tabela com uma partição, com o BlockCache ativado, BlockSize = 16, registros de 10000 bytes um único.
Agora vamos olhar para o modelo. Observamos uma boa qualidade do modelo em R2, mas é bastante claro que a extrapolação aqui é desaconselhável. O comportamento real do sistema com a mudança dos parâmetros será não linear; este modelo não é para previsões, mas para entender o que aconteceu dentro dos parâmetros definidos. Por exemplo, aqui vemos pelo critério de Student que, para a operação Put, os parâmetros BlockSize e BlockCache não têm relevância (o que é, no geral, bastante previsível):
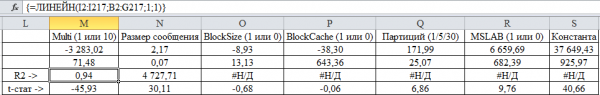
Aumentar o número de partições levando a uma diminuição no desempenho é um tanto inesperado (já vimos o impacto positivo do aumento do número de partições durante o BulkLoad), embora explicável. Primeiro, para processar é necessário gerar consultas para 30 regiões em vez de uma, e o volume de dados não é suficiente para que isso traga vantagens. Em segundo lugar, o tempo total de execução é determinado pelo RS mais lento, e como o número de DataNodes é menor que o número de RS, algumas regiões têm localidade zero. Agora, vamos olhar para os cinco líderes:
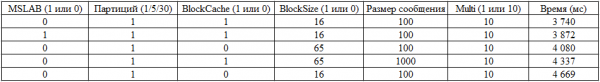
Agora vamos avaliar os resultados da execução dos blocos Get:
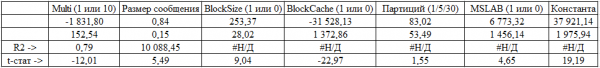
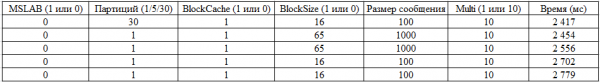
O número de partições perdeu relevância, o que provavelmente se explica pelo fato de os dados serem bem armazenados em cache e o cache para leitura ser o parâmetro mais significativo (estatisticamente). Naturalmente, o aumento no número de mensagens na consulta também é bastante benéfico para o desempenho. Os melhores resultados:
E finalmente, vamos analisar o modelo de bloco que primeiro executou o get e depois o put:
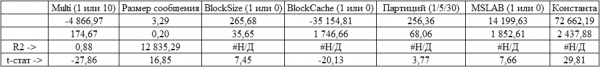
Aqui todos os parâmetros são significativos. E os resultados dos líderes:
9. Teste de carga
E finalmente, vamos rodar uma carga mais ou menos decente, mas é sempre mais interessante quando há algo para comparar. No site da DataStax - o principal desenvolvedor do Cassandra, há Um benchmark de várias soluções NoSQL, incluindo HBase versão 0.98.6-1. O carregamento foi feito com 40 threads, tamanho dos dados 100 bytes, discos SSD. O resultado do teste de operações Read-Modify-Write mostrou os seguintes resultados.
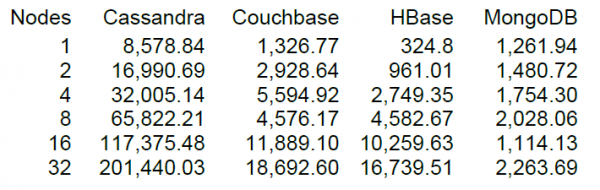
Pelo que entendi, a leitura foi realizada em blocos de 100 registros e para 16 nós HBase, o teste da DataStax mostrou um desempenho de 10 mil operações por segundo.
É bom que em nosso cluster também haja 16 nós, mas não é tão "bom" que cada um tenha 64 núcleos (threads), enquanto no teste da DataStax são apenas 4. Por outro lado, eles têm discos SSD, enquanto nós temos HDD e uma versão mais nova do HBase, e a utilização da CPU durante a carga praticamente não aumentou significativamente (visualmente entre 5 a 10 por cento). No entanto, vamos tentar iniciar nesta configuração. As configurações das tabelas estão no padrão, a leitura é realizada no intervalo de chaves de 0 a 50 milhões, aleatoriamente (ou seja, basicamente a cada vez é uma nova). A tabela tem 50 milhões de registros, divididos em 64 partições. As chaves são hashadas por crc32. As configurações das tabelas são padrão, MSLAB está ativado. Iniciando 40 threads, cada thread lê um conjunto de 100 chaves aleatórias e imediatamente escreve 100 bytes gerados por essas chaves de volta.
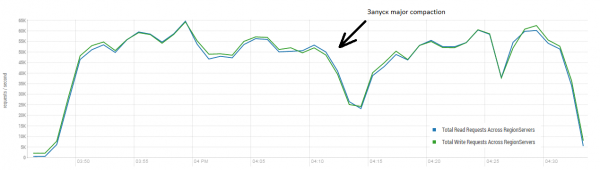
Stand: 16 DataNodes e 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads). Versão do HBase 1.2.0-cdh5.14.2.
O resultado médio está mais próximo de 40 mil operações por segundo, o que é significativamente melhor do que no teste da DataStax. No entanto, para fins experimentais, podemos alterar um pouco as condições. É bastante improvável que todo o trabalho seja realizado exclusivamente em uma única tabela, assim como apenas com chaves únicas. Suponhamos que há um conjunto "quente" de chaves que gera a maior carga. Portanto, tentaremos criar uma carga com registros maiores (10 KB), também em lotes de 100, em 4 tabelas diferentes, limitando o intervalo de chaves solicitadas a 50 mil. O gráfico abaixo mostra a execução de 40 threads, cada thread lê um conjunto de 100 chaves e imediatamente escreve aleatoriamente 10 KB de volta por essas chaves.
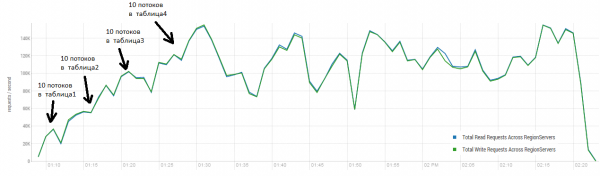
Stand: 16 DataNodes e 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads). Versão do HBase 1.2.0-cdh5.14.2.
Durante a carga, várias vezes foi executada a major compaction, como foi mostrado acima, sem este procedimento a performance gradualmente irá degradar, porém durante a execução também ocorre carga adicional. As quedas de desempenho são causadas por diferentes razões. Às vezes, as threads terminavam o trabalho e enquanto eram reiniciadas ocorria uma pausa, às vezes aplicativos externos criavam carga no cluster.
A leitura e escrita simultânea é um dos cenários de operação mais exigentes para o HBase. Se você realizar apenas requisições put de pequeno tamanho, como 100 bytes, agrupando-as em pacotes de 10-50 mil, é possível alcançar centenas de milhares de operações por segundo, e o mesmo se aplica a requisições de leitura. Vale ressaltar que os resultados são radicalmente melhores do que os obtidos pela DataStax, principalmente devido às requisições em blocos de 50 mil.
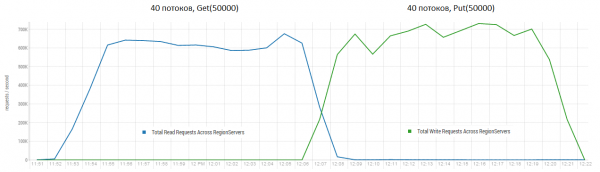
Stand: 16 DataNodes e 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads). Versão do HBase 1.2.0-cdh5.14.2.
10. Conclusões
Este sistema é bastante flexível, mas o impacto de muitos parâmetros ainda é desconhecido. Parte deles foi testada, mas não foi incluída no conjunto de testes resultante. Por exemplo, experimentos preliminares mostraram a baixa relevância de um parâmetro como DATA_BLOCK_ENCODING, que codifica informações utilizando valores de células vizinhas, o que faz sentido para dados gerados aleatoriamente. No caso de um grande número de objetos repetidos, o ganho pode ser significativo. De modo geral, pode-se afirmar que o HBase parece ser um banco de dados sério e bem pensado, que pode ser bastante eficiente em operações com grandes blocos de dados, especialmente se houver a possibilidade de distribuir no tempo os processos de leitura e escrita.
Se algo não estiver suficientemente abordado, estou à disposição para explicar mais detalhadamente. Sinta-se à vontade para compartilhar sua experiência ou discutir se você discorda de algo.
Fonte: habr.com
