

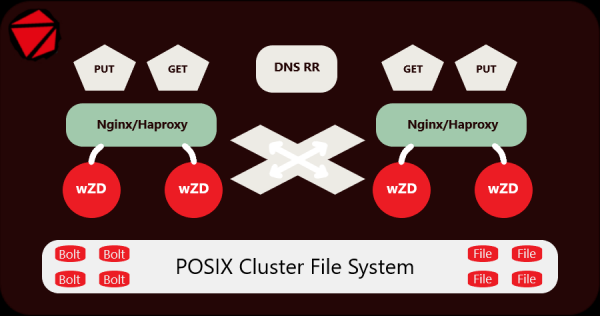
Prezada comunidade, este artigo será dedicado ao armazenamento e à entrega eficientes de centenas de milhões de pequenos arquivos. Neste estágio, apresentamos uma solução final para sistemas de arquivos compatíveis com POSIX, com suporte completo a bloqueios, incluindo cluster, e parece que até mesmo sem gambiarras.
Por isso, para esse fim, escrevi meu próprio servidor especializado.
Ao longo da implementação dessa tarefa, consegui resolver o problema principal, ao mesmo tempo que economizei espaço em disco e memória RAM, que nossa sistema de arquivos de cluster consumia desenfreadamente. Tal quantidade de arquivos é prejudicial para qualquer sistema de arquivos de cluster.
A ideia é a seguinte:
De forma simples, por meio do servidor, pequenos arquivos são carregados, são salvos diretamente em um arquivo de arquivamento, e assim também são lidos dele, enquanto arquivos grandes são armazenados ao lado. Esquema: 1 pasta = 1 arquivo de arquivamento, resultando em vários milhões de arquivos de arquivamento com pequenos arquivos, em vez de várias centenas de milhões de arquivos. E tudo isso é implementado de forma completa, sem quaisquer scripts e sem a distribuição de arquivos em arquivos tar/zip.
Tentarei ser breve, peço desculpas antecipadamente se o post for extenso.
Tudo começou porque não consegui encontrar um servidor adequado que pudesse armazenar dados recebidos via protocolo HTTP diretamente em arquivos de arquivamento, de modo que não houvesse as desvantagens típicas dos arquivos de arquivamento comuns e dos armazenamentos de objetos. O motivo da busca foi o Origin, um cluster que cresceu para grandes proporções com 10 servidores, que já acumulou 250.000.000 pequenos arquivos, e a tendência de crescimento não parecia ter fim.
Para aqueles que não gostam de ler artigos e preferem uma documentação mais simples:
e .
E docker junto, atualmente há a opção apenas com nginx dentro, por precaução:
docker run -d --restart=always -e host=localhost -e root=\/var\/storage
-v \/var\/storage:\/var\/storage --name wzd -p 80:80 eltaline\/wzd
Próximo:
Se houver muitos arquivos, são necessários recursos significativos e, o mais frustrante, parte deles é desperdiçada. Por exemplo, ao usar um sistema de arquivos em cluster (neste caso, o MooseFS), cada arquivo, independentemente do tamanho real, ocupa sempre no mínimo 64 KB. Ou seja, para arquivos de 3, 10 ou 30 KB, no disco, cada um requer 64 KB. Se houver um quarto de bilhão de arquivos, perdemos entre 2 a 10 terabytes. Não conseguiremos criar novos arquivos indefinidamente, pois no MooseFS há uma limitação: não mais de 1 bilhão, com uma réplica de cada arquivo.
À medida que o número de arquivos aumenta, é necessária uma grande quantidade de memória RAM para os metadados. Além disso, grandes dumps de metadados frequentes aceleram o desgaste dos SSDs.
Servidor wZD. Organizando os discos.
O servidor é escrito na linguagem Go. Antes de tudo, eu precisava reduzir a quantidade de arquivos. Como fazer isso? Através da arquivação, mas neste caso sem compressão, pois meus arquivos são apenas imagens comprimidas. O BoltDB foi útil, embora eu tivesse que corrigir algumas deficiências, o que está refletido na documentação.
Assim, em vez de um quarto de bilhão de arquivos, fiquei apenas com 10 milhões de arquivos Bolt. Se eu tivesse a oportunidade de mudar a estrutura atual de preenchimento de diretórios com arquivos, poderia reduzir para cerca de 1 milhão de arquivos.
Todos os pequenos arquivos são empacotados em arquivos Bolt, que automaticamente recebem os nomes das pastas em que estão, enquanto todos os arquivos grandes permanecem próximos aos arquivos, pois não há sentido em empacotá-los, isso é personalizável. Arquivamos os pequenos e deixamos os grandes inalterados. O servidor funciona de forma transparente com ambos.
Arquitetura e características do servidor wZD.
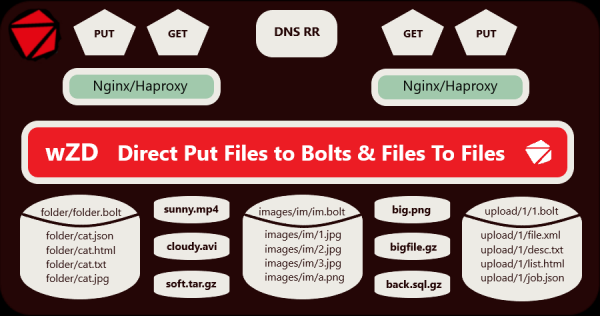
O servidor funciona sob os sistemas operacionais Linux, BSD, Solaris e OSX. Eu testei apenas para a arquitetura AMD64 sob Linux, mas ele deve funcionar também para ARM64, PPC64, MIPS64.
Principais características:
- Multithreading;
- Multi-servidor, garantindo resiliência e balanceamento de carga;
- Máxima transparência para o usuário ou desenvolvedor;
- Métodos HTTP suportados: GET, HEAD, PUT e DELETE;
- Gerenciamento de comportamento de leitura e escrita através de cabeçalhos do cliente;
- Suporte a hosts virtuais configuráveis de forma flexível;
- Suporte de integridade de dados CRC ao gravar/ler;
- Buffers semi-dinâmicos para consumo mínimo de memória e otimização do desempenho da rede;
- Compactação de dados adiada;
- Além disso, oferece-se o arquivador multithread wZA para migração de arquivos sem interrupção do serviço.
Experiência real:
Desenvolvi e testei o servidor e o arquivador em dados reais por um longo período, e agora ele funciona com sucesso em um cluster que inclui 250.000.000 de pequenos arquivos (imagens), localizados em 15.000.000 diretórios em discos SATA separados. O cluster é composto por 10 servidores atuando como servidor de origem, instalado atrás da rede CDN. Para seu suporte, são utilizados 2 servidores Nginx + 2 servidores wZD.
Para aqueles que decidirem usar este servidor, faz sentido planejar a estrutura de diretórios antes do uso, se aplicável. Devo esclarecer que o servidor não foi projetado para empacotar tudo em um único arquivo Bolt.
Teste de desempenho:
Quanto menor o tamanho do arquivo compactado, mais rápidas são as operações GET e PUT realizadas com ele. Vamos comparar o tempo total de gravação de um cliente HTTP em arquivos normais e em arquivos Bolt, assim como a leitura. Vamos comparar o desempenho com arquivos de tamanhos de 32 KB, 256 KB, 1024 KB, 4096 KB e 32768 KB.
Ao trabalhar com arquivos Bolt, a integridade de dados de cada arquivo é verificada (usando CRC), sendo feita a leitura no ato e recalculo após a gravação, o que, naturalmente, traz atrasos, mas o principal é a segurança dos dados.
Realizei os testes de desempenho em unidades SSD, pois em discos SATA os testes não mostraram uma diferença clara.
Gráficos dos resultados dos testes:
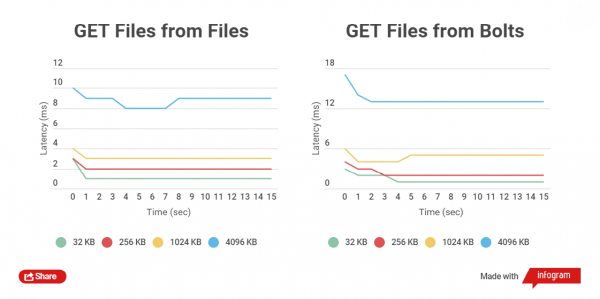
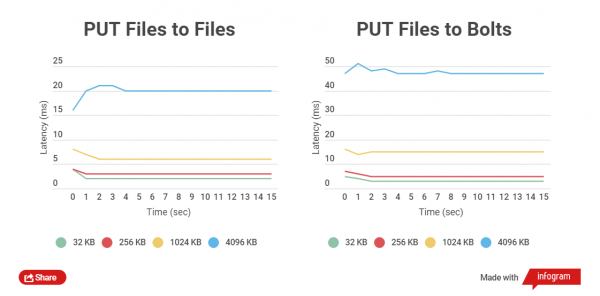
Como pode ser visto, para arquivos pequenos a diferença de tempo de leitura e gravação entre arquivos compactados e não compactados é pequena.
Uma imagem completamente diferente é obtida ao testar a leitura e gravação de arquivos de 32 MB:
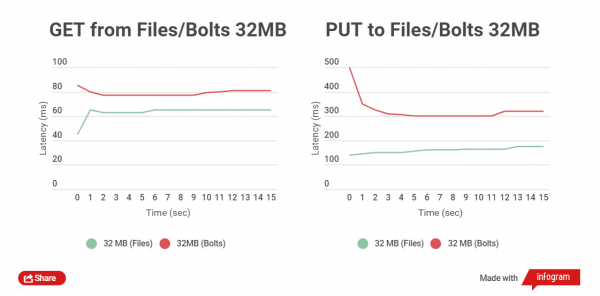
A diferença de tempo entre a leitura dos arquivos está na faixa de 5-25 ms. A gravação é mais problemática, a diferença é de cerca de 150 ms. Mas neste caso, não é necessário carregar grandes arquivos, não faz sentido, eles podem viver separadamente dos arquivos compactados.
*Tecnicamente, este servidor também pode ser usado para tarefas que exigem NoSQL.
Métodos principais de operação com o servidor wZD:
Carregamento de um arquivo normal:
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgCarregamento de arquivo para o Bolt archive (se o parâmetro do servidor fmaxsize, que determina o tamanho máximo do arquivo que pode ser incluído no archive, não for excedido; caso contrário, o arquivo será carregado normalmente ao lado do archive):
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgDownload de arquivo (se houver arquivos com o mesmo nome no disco e no archive, durante o download, a prioridade padrão é dada ao arquivo não compactado):
curl -o test.jpg http://localhost/test/test.jpgDownload forçado de arquivo do Bolt archive:
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgA descrição de outros métodos está na documentação.
O servidor atualmente suporta apenas o protocolo HTTP, o HTTPS ainda não está funcionando. O método POST também não é suportado (ainda não foi decidido se é necessário ou não).
Quem investigar o código-fonte encontrará um caramelinho, que nem todos gostam, mas eu não liguei o código principal às funções do framework web, exceto o manipulador de interrupções, então posso reescrever rapidamente em quase qualquer motor no futuro.
ToDo:
- Desenvolvimento de um replicador e distribuidor próprio + geolocalização para possibilitar o uso em grandes sistemas sem sistemas de arquivos clusterizados (tudo de forma séria).
- Possibilidade de recuperação reversa completa de metadados em caso de perda total (caso use o distribuidor).
- Protocolo nativo para possibilitar o uso de conexões de rede permanentes e drivers para diferentes linguagens de programação.
- Recursos avançados para o uso da componente NoSQL.
- Compressão de diferentes tipos (gzip, zstd, snappy) para arquivos ou valores dentro de archives Bolt e para arquivos comuns.
- Criptografia de diferentes tipos para arquivos ou valores dentro de archives Bolt e para arquivos comuns.
- Conversão de vídeo no servidor com atraso, inclusive utilizando GPU.
Isso é tudo, espero que este servidor seja útil para alguém, licença BSD-3, copyright duplo, pois se não fosse pela empresa onde trabalho, eu não teria escrito este servidor. Sou o único desenvolvedor. Agradeço por bugs encontrados e solicitações de funcionalidades.
Fonte: habr.com
