

Continuamos a série de artigos dedicados à exploração de métodos pouco conhecidos para melhorar o desempenho de consultas que parecem simples no PostgreSQL:
Não pense que eu não gosto de JOIN tanto assim... 🙂
Mas muitas vezes uma consulta resulta ser significativamente mais eficiente sem ele. Portanto, hoje vamos tentar nos livrar completamente de um JOIN que consome muitos recursos – com a ajuda de um dicionário. A partir do PostgreSQL 12, algumas das situações descritas abaixo podem se comportar de maneira um pouco diferente devido à
não materialização de CTE por padrão Muitos 'fatos' sobre o dicionário limitado
MATERIALIZED.
Vamos pegar um problema prático bastante real — precisamos gerar uma lista
de mensagens recebidas 25.01 | Ivanov I.I. | Preparar a descrição do novo algoritmo. 22.01 | Ivanov I.I. | Escrever um artigo no Habr: vida sem JOIN. 20.01 | Petrov P.P. | Ajudar a otimizar a consulta. 18.01 | Ivanov I.I. | Escrever um artigo no Habr: JOIN considerando a distribuição dos dados. 16.01 | Petrov P.P. | Ajudar a otimizar a consulta.
No mundo abstrato, os autores das tarefas deveriam se distribuir uniformemente entre todos os funcionários da nossa organização, mas na realidade
as tarefas geralmente vêm de um número relativamente limitado de pessoas — 'da gerência' para cima na hierarquia ou 'de colegas' de departamentos vizinhos (analistas, designers, marketing, ...). Vamos assumir que na nossa organização, de 1000 pessoas, apenas 20 autores (geralmente até menos) colocam tarefas para cada executor específico e
usaremos esse conhecimento específico Gerador de script
Gerador de script
-- funcionários
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- tarefas com a distribuição especificada
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Vamos mostrar as últimas 100 tarefas para um executor específico:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 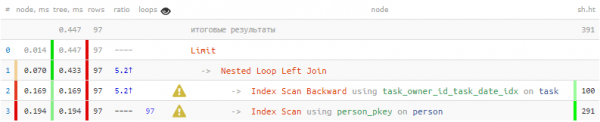
Assim, 1/3 do tempo total e 3/4 das leituras páginas de dados foram feitas apenas para buscar 100 vezes por um autor - para cada tarefa exibida. Mas sabemos que entre esses cem há apenas 20 diferentes — não poderíamos usar esse conhecimento?
dicionário hstore
Vamos utilizar para gerar um "dicionário" chave-valor:
CREATE EXTENSION hstoreNo dicionário, precisamos apenas colocar o ID do autor e seu nome, para poder extrair por essa chave depois:
-- formamos a seleção alvo
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- formamos o dicionário para valores únicos
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- obtemos os valores relacionados do dicionário
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> chave
FROM
T; 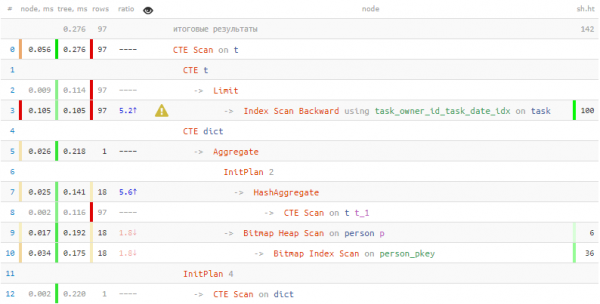
Foi gasto 2 vezes menos tempo e 7 vezes menos dados lidos! Além da "dicionarização", esses resultados também foram ajudados por extração em massa de registros da tabela em uma única passagem usando = ANY(ARRAY(...)).
Registros de tabela: serialização e desserialização
Mas o que fazer se precisarmos armazenar no dicionário não apenas um campo de texto, mas um registro inteiro? Nesse caso, a capacidade do PostgreSQL de trabalhar com um registro de tabela como um único valor:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- mágica #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- mágica #2
FROM
  T;
Vamos analisar o que está acontecendo aqui:
- Pegamos p como um alias para o registro completo da tabela person e reunimos deles um array.
- Este array de registros foi convertido em um array de strings de texto (person[]::text[]), para que pudesse ser colocado em um dicionário hstore como um array de valores.
- Ao receber o registro relacionado, nós o extraímos do dicionário pela chave como uma string de texto.
- Precisamos transformar o texto em um valor do tipo tabela person (para cada tabela, um tipo correspondente é automaticamente criado).
- Desdobramos o registro tipado em colunas usando
(...).*.
dicionário json
Mas essa manobra, como aplicamos acima, não funcionará se não houver um tipo de tabela correspondente para fazer o 'cast'. A mesma situação ocorrerá se tentarmos usar uma string CTE, em vez de uma tabela 'real'.
Neste caso, poderão nos ajudar :
...
, p AS ( -- isso já é CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- agora isso já é json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- e dentro do json para cada linha
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- extraído do dicionário como json
      ) AS j(name text, birth_date date) -- preenchemos a estrutura que precisamos
  ) j;
É importante notar que, ao descrever a estrutura alvo, podemos listar nem todos os campos da linha de origem, mas apenas aqueles que realmente precisamos. Se tivermos uma tabela 'nativa', é melhor usar a função json_populate_record.
O acesso ao dicionário ainda é feito uma única vez, mas os custos de [de]serialização json são bastante altos, por isso esse método é sensato de usar apenas em alguns casos, quando um CTE 'honesto' se revela pior.
Testando o desempenho
Assim, conseguimos duas maneiras de serializar dados em um dicionário — hstore / json_object. Além disso, os próprios arrays de chaves e valores também podem ser gerados de duas maneiras, com conversão interna ou externa para texto: array_agg(i::text) / array_agg(i)::text[].
Vamos verificar a eficácia de diferentes tipos de serialização em um exemplo puramente sintético — serializando diferentes quantidades de chaves:
COM dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Script avaliativo: serialização
COM C T COMO (
  SELECIONE
    *
  , (
      SELECIONE
        regexp_replace(ea[array_length(ea, 1)], '^Tempo de Execução: (d+.d+) ms$', '1')::real et
      DE
        (
          SELECIONE
            array_agg(el) ea
          DE
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              COM dict COMO (
                SELECIONE
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                DE
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABELA dict
            $$) T(el text)
        ) T
    ) et
  DE
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECIONE
  v
, avg(et)::numeric(32,3)
DE
  T
GROUP BY
  1
ORDER BY
1; 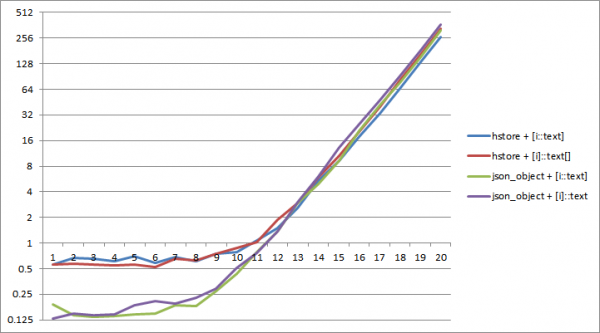
No PostgreSQL 11, aproximadamente até um dicionário de 2^12 chaves a serialização em json requer menos tempo. A combinação de json_object e a conversão 'interna' de tipos é a mais eficiente array_agg(i::text).
Agora, vamos tentar ler o valor de cada chave 8 vezes — afinal, se você não acessar o dicionário, para que ele serve?
Script de avaliação: leitura do dicionário
COM C T COMO (
  SELECIONE
    *
  , (
      SELECIONE
        regexp_replace(ea[array_length(ea, 1)], '^Tempo de Execução: (d+.d+) ms$', '1')::real et
      DE
        (
          SELECIONE
            array_agg(el) ea
          DE
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              COM dict COMO (
                SELECIONE
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                DE
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              SELECIONE
                (TABELA dict) -> (i % ($$ || (1 << v) || $$) + 1)::text
              DE
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  DE
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECIONE
  v
, avg(et)::numeric(32,3)
DE
  T
GROUP BY
  1
ORDER BY
1; 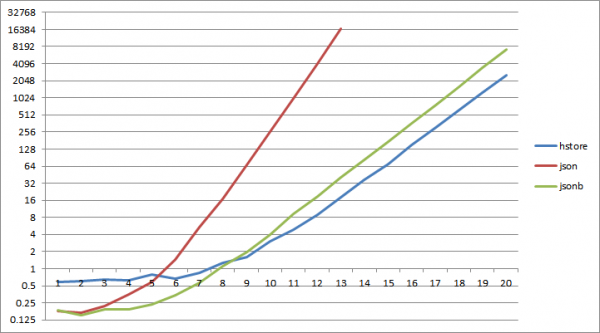
E… já aproximadamente com 2^6 chaves, a leitura do dicionário json começa a ser consideravelmente mais lenta do que a leitura do hstore, para jsonb o mesmo acontece em 2^9.
Conclusões finais:
- se precisar fazer JOIN com registros repetidos múltiplas vezes — é melhor usar 'dicionarização' da tabela
- se o seu dicionário for previsivelmente pequeno e você vai ler pouco dele — pode usar json[b]
- em todos os outros casos hstore + array_agg(i::text) será mais eficiente
Fonte: habr.com
