

Periodicamente surge a tarefa de procurar dados relacionados por um conjunto de chaves, até que alcancemos a quantidade total necessária de registros.
O exemplo mais 'vivo' é listar as 20 tarefas mais antigas, que constam na lista de funcionários (por exemplo, dentro de um mesmo departamento). Para diversos 'painéis' gerenciais com resumos breves sobre áreas de trabalho, esse tema é requerido com bastante frequência.
Neste artigo, discutiremos a implementação em PostgreSQL de uma versão 'ingênua' de solução para tal tarefa, um algoritmo 'mais inteligente' e o totalmente complexo 'ciclo' em SQL com uma condição de saída dos dados encontrados, que pode ser útil tanto para o desenvolvimento geral quanto para aplicação em outros casos semelhantes.
Vamos usar um conjunto de dados de teste de . Para que os registros exibidos não 'pulassem' de uma vez para outra ao coincidir os valores classificados, abriremos o índice de assunto adicionando a chave primária. Isso também conferirá imediatamente uma unicidade ao índice, garantindo a ordem de classificação.
CREATE INDEX ON task(owner_id, task_date, id);
-- e o antigo - removeremos
DROP INDEX task_owner_id_task_date_idx;
Como se ouve, assim se escreve
Primeiro, vamos esboçar a versão mais simples da consulta, passando o ID dos executores :
SELECT
  *
FROM
  task
WHERE
  owner_id = ANY('{1,2,4,8,16,32,64,128,256,512}'::integer[])
ORDER BY
  task_date, id
LIMIT 20; 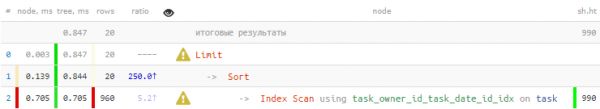
É um pouco triste — pedimos apenas 20 registros, mas o Index Scan nos retornou 960 linhas, que ainda tivemos que ordenar… Que tal tentarmos ler menos.
unnest + ARRAY
A primeira consideração que nos ajudará — se precisamos de apenas 20 registros classificados , então é suficiente ler no máximo 20 classificados na mesma ordem para cada chave. Felizmente, temos um índice apropriado (owner_id, task_date, id) disponível.
Usaremos o mesmo mecanismo de extração e 'desdobramento em colunas' da gravação integral da tabela, assim como em . Também aplicaremos a compactação em array através da função ARRAY():
WITH T AS (
  SELECT
    unnest(ARRAY(
      SELECT
        t
      FROM
        task t
      WHERE
        owner_id = unnest
      ORDER BY
        task_date, id
      LIMIT 20 -- limitamos aqui...
    )) r
  FROM
    unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
)
SELECT
  (r).*
FROM
  T
ORDER BY
  (r).task_date, (r).id
LIMIT 20; -- ... e aqui também 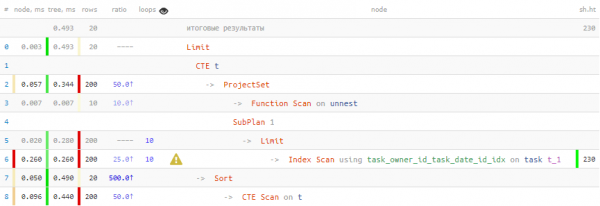
Oh, já está muito melhor! 40% mais rápido, e 4.5 vezes menos dados precisamos ler.
Materialização de registros de tabela através de CTEGostaria de destacar que em alguns casos tentar trabalhar com os campos da gravação imediatamente após sua busca em uma subconsulta, sem "envolvê-los" em um CTE pode levar a multiplicação de InitPlan proporcionalmente ao número desses campos:
SELECT
  ((
    SELECT
      t
    FROM
      task t
    WHERE
      owner_id = 1
    ORDER BY
      task_date, id
    LIMIT 1
  ).*);
Resultado (custo=4.77..4.78 linhas=1 largura=16) (tempo real=0.063..0.063 linhas=1 loops=1)
Buffers: compartilhado hit=16
InitPlan 1 (retorna $0)
-> Limite (custo=0.42..1.19 linhas=1 largura=48) (tempo real=0.031..0.032 linhas=1 loops=1)
Buffers: compartilhado hit=4
-> Varredura de Índice usando task_owner_id_task_date_id_idx em task t (custo=0.42..387.57 linhas=500 largura=48) (tempo real=0.030..0.030 linhas=1 loops=1)
Condição do Índice: (owner_id = 1)
Buffers: compartilhado hit=4
InitPlan 2 (retorna $1)
-> Limite (custo=0.42..1.19 linhas=1 largura=48) (tempo real=0.008..0.009 linhas=1 loops=1)
Buffers: compartilhado hit=4
-> Varredura de Índice usando task_owner_id_task_date_id_idx em task t_1 (custo=0.42..387.57 linhas=500 largura=48) (tempo real=0.008..0.008 linhas=1 loops=1)
Condição do Índice: (owner_id = 1)
Buffers: compartilhado hit=4
InitPlan 3 (retorna $2)
-> Limite (custo=0.42..1.19 linhas=1 largura=48) (tempo real=0.008..0.008 linhas=1 loops=1)
Buffers: compartilhado hit=4
-> Varredura de Índice usando task_owner_id_task_date_id_idx em task t_2 (custo=0.42..387.57 linhas=500 largura=48) (tempo real=0.008..0.008 linhas=1 loops=1)
Condição do Índice: (owner_id = 1)
Buffers: compartilhado hit=4"
InitPlan 4 (retorna $3)
-> Limite (custo=0.42..1.19 linhas=1 largura=48) (tempo real=0.009..0.009 linhas=1 loops=1)
Buffers: compartilhado hit=4
-> Varredura de Índice usando task_owner_id_task_date_id_idx em task t_3 (custo=0.42..387.57 linhas=500 largura=48) (tempo real=0.009..0.009 linhas=1 loops=1)
Condição do Índice: (owner_id = 1)
Buffers: compartilhado hit=4
O mesmo registro foi "buscado" 4 vezes... Até o PostgreSQL 11, esse comportamento ocorria regularmente, e a solução era "envolver" em um CTE, que é um limite absoluto para o otimizador nessas versões.
Acumulador recursivo
Na versão anterior, lemos no total 200 linhas para obter as necessárias 20. Já não são 960, mas ainda menos — é possível?
Vamos tentar usar o conhecimento de que precisamos apenas 20 registros. Ou seja, vamos iterar a leitura dos dados apenas até alcançarmos a quantidade necessária.
Passo 1: lista inicial
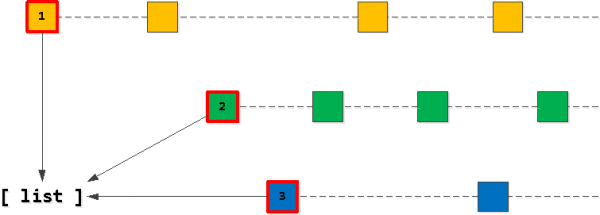
É óbvio que nossa lista "alvo" de 20 registros deve começar com os "primeiros" registros de uma das nossas chaves owner_id. Portanto, vamos primeiro encontrar tais "primeiros" para cada uma das chaves e adicioná-los à lista, ordenando-a na ordem que desejamos — (task_date, id).
Passo 2: encontramos os "próximos" registros
Agora, se pegarmos o primeiro registro de nossa lista e começarmos a "avançar" mais no índice mantendo a chave owner_id, todos os registros encontrados são precisamente os seguintes na seleção resultante. Claro, apenas até que cruzemos a chave aplicada do segundo registro na lista.
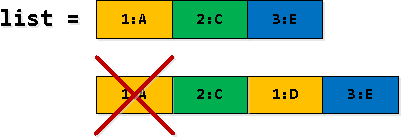
Se ocorreu que cruzamos o segundo registro, então o último registro lido deve ser adicionado à lista em vez do primeiro (com o mesmo owner_id), após o que a lista será reordenada novamente.
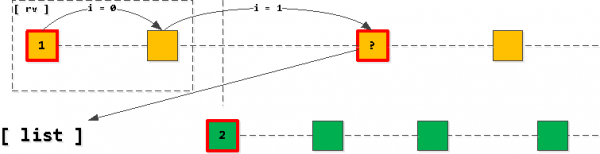
Ou seja, temos o tempo todo que na lista há no máximo um registro para cada uma das chaves (se os registros acabarem e não cruzarmos, o primeiro registro da lista simplesmente desaparecerá e nada será adicionado), e eles estão sempre ordenados em ordem crescente da chave aplicada (task_date, id).
Passo 3: filtramos e 'desdobramos' os registros
Em parte das linhas de nossa seleção recursiva, alguns registros rv são duplicados — primeiro encontramos aqueles como 'cruzando a fronteira do 2º registro da lista', e depois inserimos como o 1º da lista. Assim, a primeira aparição deve ser filtrada.
Aterradora consulta final
COM CTE RECURSIVO T AS (
  -- #1 : armazenamos as "primeiras" gravações por cada uma das chaves do conjunto
  COM wrap AS ( -- "materializamos" os registros, para que o acesso aos campos não cause multiplicação do InitPlan/SubPlan
    COM T AS (
      SELECIONE
        (
          SELECIONE
            r
          DE
            task r
          ONDE
            owner_id = unnest
          ORDENAR POR
            task_date, id
          LIMITE 1
        ) r
      DE
        unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
    )
    SELECIONE
      array_agg(r ORDENAR POR (r).task_date, (r).id) lista -- ordenamos a lista na ordem desejada
    DE
      T
  )
  SELECIONE
    lista
  , lista[1] rv
  , FALSE not_cross
  , 0 tamanho
  DE
    wrap
UNION ALL
  -- #2 : lemos os registros da 1ª chave em ordem, até ultrapassarmos o registro da 2ª
  SELECIONE
    CASO
      -- se nada foi encontrado para a chave do 1º registro
      QUANDO X._r É NÃO DISTINTO DE NULO ENTÃO
        T.lista[2:] -- removemos do lista
      -- se NÃO cruzamos a chave da 2ª gravação
      QUANDO X.not_cross ENTÃO
        T.lista -- apenas prolongamos a mesma lista sem modificações
      -- se já não há 2ª gravação na lista
      QUANDO T.lista[2] É NULO ENTÃO
        -- apenas retornamos uma lista vazia
        '{}'
      -- reordenamos o dicionário, removendo a 1ª gravação e adicionando a última encontrada
      OUTRO (
        SELECIONE
          coalesce(T.lista[2] || array_agg(r ORDENAR POR (r).task_date, (r).id), '{}')
        DE
          unnest(T.lista[3:] || X._r) r
      )
    FIM
  , X._r
  , X.not_cross
  , T.tamanho + X.not_cross::integer
  DE
    T
  , LATERAL(
      COM wrap AS ( -- "materializamos" o registro
        SELECIONE
          CASO
            -- se "cruzamos" a 2ª gravação
            QUANDO NÃO T.not_cross
              -- então o registro necessário é o primeiro da lista
              ENTÃO T.lista[1]
            OUTRO ( -- se não cruzamos, a chave permaneceu como no registro anterior - partimos dela
              SELECIONE
                _r
              DE
                task _r
              ONDE
                owner_id = (rv).owner_id E
                (task_date, id) > ((rv).task_date, (rv).id)
              ORDENAR POR
                task_date, id
              LIMITE 1
            )
          FIM _r
      )
      SELECIONE
        _r
      , CASO
          -- se a 2ª gravação já não está na lista, mas encontramos algo
          QUANDO lista[2] É NULO E _r É DISTINTO DE NULO ENTÃO
            VERDADEIRO
          OUTRO -- nada encontrado ou "cruzamos"
            coalesce(((_r).task_date, (_r).id) < ((lista[2]).task_date, (lista[2]).id), FALSO)
        FIM not_cross
      DE
        wrap
    ) X
  ONDE
    T.tamanho < 20 E -- limitamos aqui a quantidade
    T.lista É NÃO DISTINTO DE '{}' -- ou enquanto a lista não acabar
)
-- #3 : "desdobramos" os registros - a ordem é garantida pela construção
SELECIONE
  (rv).*
DE
  T
ONDE
not_cross; -- pegamos apenas registros "não cruzados" 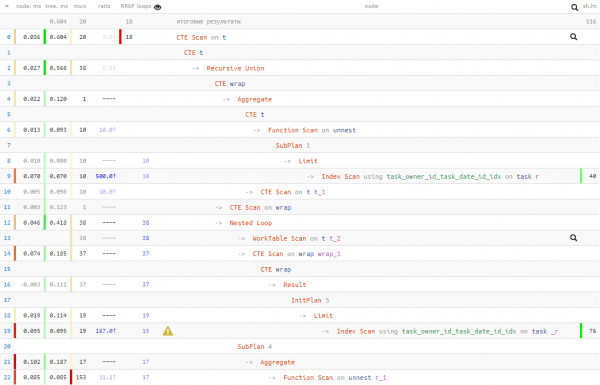
Dessa forma, nós trocamos 50% das leituras de dados por 20% do tempo de execuçãoOu seja, se você tiver razões para acreditar que a leitura pode ser longa (por exemplo, os dados geralmente não estão armazenados em cache e é necessário acessá-los no disco), esse método pode reduzir a dependência da leitura.
De qualquer forma, o tempo de execução foi melhor do que na primeira versão "ingênua". Mas qual desses 3 métodos utilizar — fica a seu critério.
Fonte: habr.com
