

Nota do tradutor.: Neste artigo, a Banzai Cloud compartilha um exemplo do uso de suas ferramentas especiais para facilitar a operação do Kafka dentro do Kubernetes. As instruções apresentadas ilustram como determinar o tamanho ideal da infraestrutura e configurar o próprio Kafka para alcançar a capacidade de throughput desejada.
Apache Kafka é uma plataforma de streaming distribuída para construir sistemas de processamento de dados em tempo real que são confiáveis, escaláveis e de alto desempenho. Suas impressionantes capacidades podem ser ampliadas com o Kubernetes. Para isso, desenvolvemos e uma ferramenta chamada . Elas permitem executar o Kafka no Kubernetes e usar várias de suas funcionalidades, como ajuste fino da configuração do broker, escalonamento baseado em métricas com rebalanceamento, consciência sobre rack (rack awareness), rollout de atualizações de forma (graciosa) , etc.
Experimente o Supertubes em seu cluster:
curl https://getsupertubes.sh | sh e supertubes install -a --no-democluster --kubeconfigOu entre em contato com . Também é possível ler sobre algumas funcionalidades do Kafka, cujo funcionamento foi automatizado com o uso do Supertubes e do operador Kafka. Já escrevemos sobre isso no blog:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Ao decidir implantar um cluster Kafka no Kubernetes, você seguramente enfrentará o desafio de determinar o tamanho ideal da infraestrutura básica e a necessidade de ajustar a configuração do Kafka para atender aos requisitos de throughput. O máximo desempenho de cada broker é definido pelo desempenho dos componentes da infraestrutura subjacente, como memória, processador, velocidade do disco, largura de banda da rede, etc.
Idealmente, a configuração do broker deve ser tal que todos os elementos da infraestrutura sejam utilizados ao máximo de suas capacidades. No entanto, na vida real, essa configuração é bastante complexa. É mais provável que os usuários ajustem a configuração dos brokers de forma a maximizar o uso de um ou dois componentes (disco, memória ou processador). Em geral, um broker mostra desempenho máximo quando sua configuração permite explorar ao máximo o componente mais lento. Assim, podemos ter uma ideia do tipo de carga que um único broker pode suportar.
Teoricamente, também podemos estimar o número de brokers necessários para lidar com uma carga específica. No entanto, na prática, as opções de configuração em diferentes níveis são tantas que avaliar o desempenho potencial de uma configuração específica é bastante difícil (se não impossível). Em outras palavras, é muito complicado planejar uma configuração com base em um desempenho desejado.
Para os usuários do Supertubes, geralmente adotamos a seguinte abordagem: começamos com uma configuração (infraestrutura + ajustes), medimos seu desempenho, ajustamos as configurações do broker e repetimos o processo. Isso continua até que o potencial do componente mais lento da infraestrutura seja totalmente utilizado.
Dessa forma, conseguimos ter uma ideia mais clara de quantos brokers o cluster precisa para lidar com uma carga específica (o número de brokers também depende de outros fatores, como o número mínimo de réplicas de mensagens para garantir a resiliência, o número de líderes de partição, etc.). Além disso, obtemos uma compreensão de qual componente de infraestrutura é desejável para escalonamento vertical.
Neste artigo, falaremos sobre as etapas que tomamos para "extrair o máximo" dos componentes mais lentos nas configurações iniciais e medir a largura de banda do cluster Kafka. Uma configuração de alta resiliência requer pelo menos três brokers em funcionamento (min.insync.replicas=3), distribuídos em três zonas de disponibilidade diferentes. Para configuração, escalabilidade e monitoramento da infraestrutura do Kubernetes, utilizamos nossa própria plataforma de gerenciamento de contêineres para nuvens híbridas — . Ela suporta on-premise (bare metal, VMware) e cinco tipos de nuvens (Alibaba, AWS, Azure, Google, Oracle), além de qualquer combinação delas.
Reflexões sobre a infraestrutura e a configuração do cluster Kafka
Para os exemplos abaixo, escolhemos a AWS como fornecedor de serviços de nuvem e o EKS como a distribuição do Kubernetes. Uma configuração semelhante pode ser realizada usando — uma distribuição do Kubernetes da Banzai Cloud, certificada pela CNCF.
Disco
A Amazon oferece diferentes . A base gp2 e io1 consiste em discos SSD, no entanto, para garantir alta taxa de transferência gp2 consome créditos acumulados (- I/O credits), por isso preferimos o tipo io1, que oferece alta taxa de transferência estável.
Tipos de instâncias
O desempenho do Kafka depende muito do cache de página do sistema operacional, portanto, precisamos de instâncias com memória suficiente para os brokers (JVM) e cache de página. A instância c5.2xlarge é um bom começo, pois possui 16 GB de memória e . Sua desvantagem é que consegue fornecer desempenho máximo por no máximo 30 minutos a cada 24 horas. Se a carga de trabalho exigir desempenho máximo por mais tempo, devemos considerar outros tipos de instâncias. Foi exatamente isso que fizemos, optando por c5.4xlarge. Ela oferece uma taxa de transferência máxima de 593,75 MB/s. A taxa de transferência máxima do volume EBS io1 é superior à da instância c5.4xlarge, portanto, o elemento mais lento da infraestrutura, aparentemente, é a taxa de transferência de I/O desse tipo de instância (o que também deve ser confirmado pelos resultados de nossos testes de carga).
Rede
A largura de banda da rede deve ser suficientemente alta em comparação ao desempenho da instância VM e do disco; do contrário, a rede se torna um gargalo. No nosso caso, a interface de rede c5.4xlarge suporta uma velocidade de até 10 Gb/s, o que é significativamente superior à taxa de transferência de I/O da instância VM.
Desdobramento dos brokers
Os brokers devem ser implantados (planejados no Kubernetes) em nós dedicados para evitar competição com outros processos por recursos de CPU, memória, rede e disco.
Versão do Java
A escolha lógica é o Java 11, pois ele é compatível com Docker na medida em que a JVM identifica corretamente os processadores e a memória disponíveis para o contêiner em que o broker está sendo executado. Sabendo que os limites de CPU são importantes, a JVM define internamente e de forma transparente o número de threads do GC e threads do compilador JIT. Utilizamos a imagem Kafka banzaicloud/kafka:2.13-2.4.0, incluindo a versão Kafka 2.4.0 (Scala 2.13) em Java 11.
Se você deseja saber mais sobre Java/JVM no Kubernetes, confira nossas publicações:
- ;
- .
Configurações de memória do broker
Existem dois aspectos fundamentais na configuração de memória do broker: as configurações para a JVM e para o pod do Kubernetes. O limite de memória definido para o pod deve ser maior do que o tamanho máximo do heap, para que a JVM tenha espaço para o metaspácio do Java, que reside na própria memória, e para o cache de página do sistema operacional, que o Kafka usa ativamente. Em nossos testes, executamos brokers Kafka com os parâmetros -Xmx4G -Xms2G, enquanto o limite de memória para o pod era de 10 Gi. Note que as configurações de memória para a JVM podem ser obtidas automaticamente com -XX:MaxRAMPercentage e -X:MinRAMPercentage, com base no limite de memória do pod.
Configurações de CPU do broker
De modo geral, é possível aumentar o desempenho aumentando o paralelismo com o aumento do número de threads utilizadas pelo Kafka. Quanto mais processadores disponíveis para o Kafka, melhor. Em nosso teste, começamos com um limite de 6 processadores e, gradualmente (em iterações), aumentamos esse número para 15. Além disso, configuramos num.network.threads=12 nas configurações do broker, para aumentar o número de threads que recebem dados da rede e os enviam. Imediatamente percebemos que os brokers seguidores não conseguiam replicar as mensagens rapidamente o suficiente, então aumentamos num.replica.fetchers para 4, a fim de aumentar a velocidade com que os brokers seguidores replicavam mensagens dos líderes.
Ferramenta de geração de carga
É necessário garantir que o potencial do gerador de carga escolhido não se esgote antes que o cluster Kafka (cujo benchmark está sendo realizado) alcance sua capacidade máxima. Em outras palavras, é preciso realizar uma avaliação prévia das capacidades da ferramenta de geração de carga e selecionar tipos de instâncias com processadores e memória suficientes. Desta forma, nossa ferramenta produzirá mais carga do que o cluster Kafka pode processar. Após vários testes, decidimos por três instâncias c5.4xlarge, em cada uma das quais foi iniciado um gerador.
Benchmarking
A medição de desempenho é um processo iterativo que inclui as seguintes etapas:
- configuração da infraestrutura (cluster EKS, cluster Kafka, ferramenta de geração de carga, além de Prometheus e Grafana);
- geração de carga por um determinado período para filtrar variações aleatórias nas métricas de desempenho coletadas;
- ajuste da infraestrutura e da configuração do broker com base nas métricas de desempenho observadas;
- repetição do processo até que o nível desejado de throughput do cluster Kafka seja alcançado. Este deve ser reproducível de forma estável e demonstrar variações mínimas no throughput.
Na próxima seção, descrevemos as etapas realizadas durante o benchmarking do cluster de teste.
Ferramentas
Para uma rápida implementação da configuração básica, geração de carga e medição de desempenho, foram utilizadas as seguintes ferramentas:
- para a organização do cluster EKS da Amazon com (para coleta de métricas do Kafka e da infraestrutura) e (para visualização dessas métricas). Utilizamos serviços integrados em que oferecem monitoramento federado, coleta centralizada de logs, varredura de vulnerabilidades, recuperação de desastres, segurança de nível corporativo e muito mais.
- é uma ferramenta para testes de carga do cluster Kafka.
- Painéis Grafana para visualização das métricas do Kafka e da infraestrutura: , .
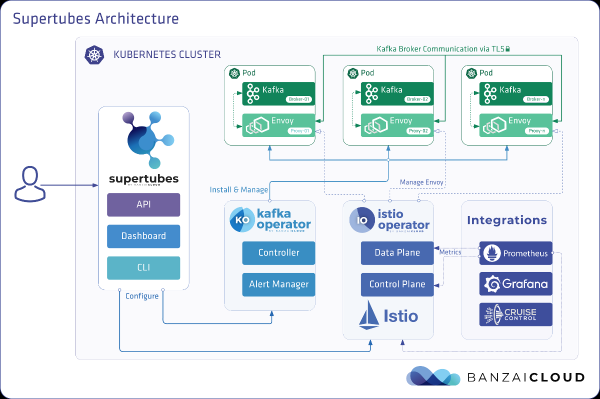
- Supertubes CLI para a configuração mais simples de um cluster Kafka no Kubernetes. Zookeeper, Kafka operator, Envoy e muitos outros componentes são instalados e corretamente configurados para executar um cluster Kafka pronto para produção no Kubernetes.
- Para a instalação supertubes CLI siga as instruções fornecidas .
Cluster EKS
Prepare o cluster EKS com nós de trabalho dedicados c5.4xlarge em várias zonas de disponibilidade para pods com brokers Kafka, além de nós dedicados para o gerador de carga e a infraestrutura de monitoramento.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonQuando o cluster EKS estiver funcionando, ative o seu — ele implantará o Prometheus e o Grafana no cluster.
Componentes do Kafka
Instale os componentes do Kafka (Zookeeper, kafka-operator) no EKS usando o supertubes CLI:
supertubes install -a --no-democluster --kubeconfigCluster Kafka
Por padrão, EKS utiliza volumes EBS do tipo gp2, portanto, é necessário criar uma classe de armazenamento separada baseada em volumes io1 para o cluster Kafka:
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Defina para os brokers o parâmetro min.insync.replicas=3 e implemente os pods dos brokers em nós em três zonas de disponibilidade diferentes:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Tópicos
Executamos paralelamente três instâncias do gerador de carga. Cada uma delas grava em seu próprio tópico, ou seja, precisamos de três tópicos no total:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
Para cada tópico, o fator de replicação é 3 — o valor mínimo recomendado para sistemas de produção de alta disponibilidade.
Ferramenta de geração de carga
Lançamos três instâncias do gerador de carga (cada uma escrevendo em um tópico separado). Para os pods do gerador de carga, é necessário definir a afinidade de nó para que sejam agendados apenas nos nós designados para eles:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Alguns pontos a serem observados:
- O gerador de carga gera mensagens de 512 bytes e as publica no Kafka em lotes de 500 mensagens.
- Com o argumento
-required-acks=alla publicação é considerada bem-sucedida quando todas as réplicas sincronizadas da mensagem são recebidas e confirmadas pelos brokers do Kafka. Isso significa que, no benchmark, medimos não apenas a velocidade dos líderes que recebem mensagens, mas também a de seus seguidores, que replicam as mensagens. O propósito deste teste não é avaliar a velocidade de leitura dos consumidores (consumers) de mensagens recém-recebidas, que ainda permanecem no cache de páginas do SO, e sua comparação com a velocidade de leitura das mensagens armazenadas no disco. - O gerador de carga inicia 20 workers em paralelo (
-workers=20). Cada worker contém 5 produtores, que compartilham a conexão do worker com o cluster Kafka. No total, cada gerador conta com 100 produtores, todos enviando mensagens para o cluster Kafka.
Monitoramento do estado do cluster
Durante os testes de carga do cluster Kafka, também monitoramos sua saúde para garantir que não houvesse reinicializações de pods, réplicas desincronizadas e para maximizar a capacidade de throughput com mínimas flutuações:
- O gerador de carga registra estatísticas padrão sobre o número de mensagens publicadas e o nível de erros. A porcentagem de erros deve permanecer em
0,00%. - , implantado pelo kafka-operator, fornece um painel de monitoramento, onde também podemos observar o estado do cluster. Para visualizar este painel, execute:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - Nível de ISR (número de réplicas "in-sync") shrink e expansion são iguais a 0.
Resultados das medições
3 brokers, tamanho das mensagens — 512 bytes
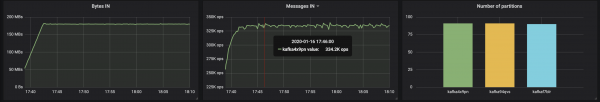
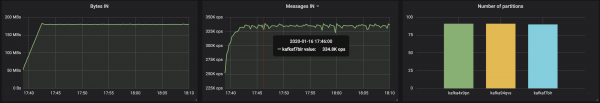
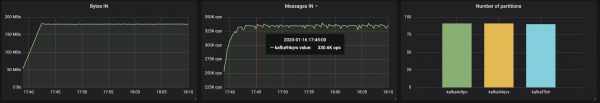
Com as partitions uniformemente distribuídas entre três brokers, conseguimos alcançar uma performance ~500 Mb/s (aproximadamente 990 mil mensagens por segundo):
O consumo de memória pela JVM não excedeu 2 Gb:
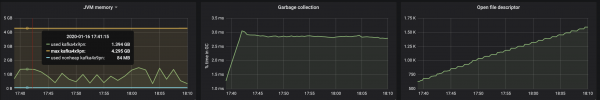
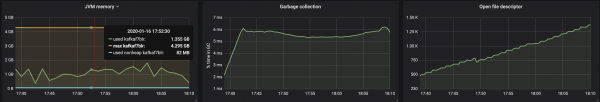
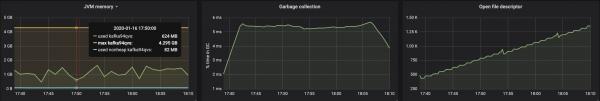
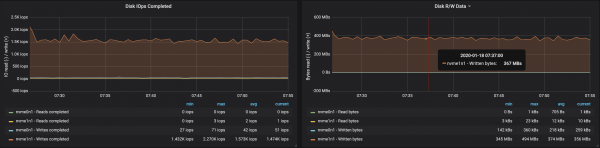
A capacidade de throughput do disco atingiu a capacidade máxima de I/O do nó em todas as três instâncias onde os brokers estavam funcionando:
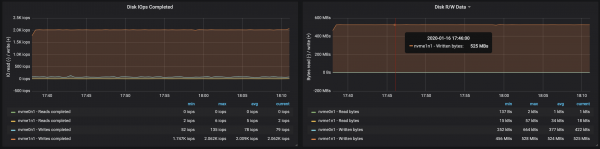
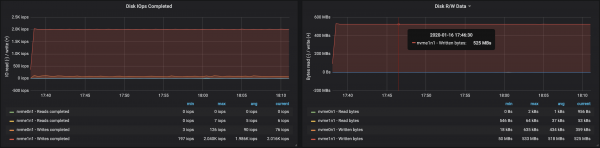
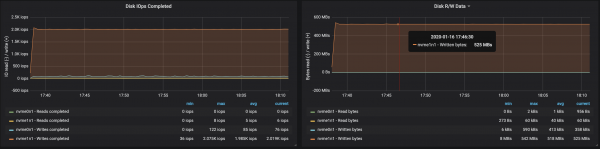
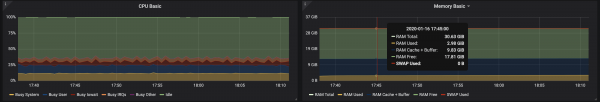
Dos dados sobre o uso de memória pelos nós, pode-se observar que o buffering do sistema e caching ocuparam cerca de 10-15 Gb:
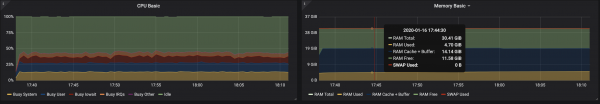
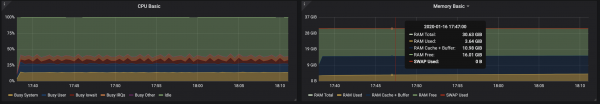
3 brokers, tamanho das mensagens — 100 bytes
Com a redução no tamanho das mensagens, a capacidade de throughput cai cerca de 15-20%: impacta o tempo gasto no processamento de cada mensagem. Além disso, a carga no CPU aumentou quase duas vezes.
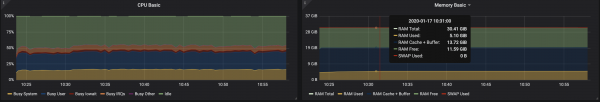
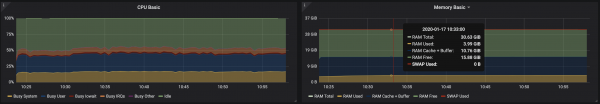
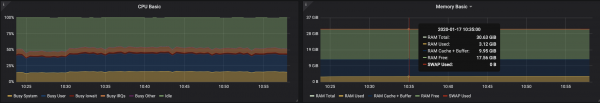
Como ainda há núcleos não utilizados nos nós dos brokers, a performance pode ser melhorada ajustando a configuração do Kafka. Esta é uma tarefa complexa, portanto, para aumentar a capacidade de throughput, é melhor trabalhar com mensagens de maior tamanho.
4 brokers, tamanho das mensagens — 512 bytes
Pode-se facilmente aumentar a performance do cluster Kafka simplesmente adicionando novos brokers e mantendo o balanceamento das partitions (o que garante uma distribuição uniforme da carga entre os brokers). No nosso caso, após a adição de um broker, a capacidade de throughput do cluster aumentou para ~580 Mb/s (~1,1 milhão de mensagens por segundo). O aumento foi menor do que o esperado: principalmente devido ao desequilíbrio das partitions (nem todos os brokers estão operando em sua capacidade máxima).
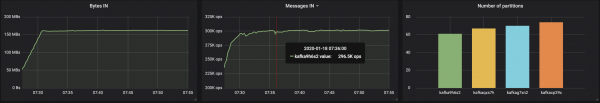
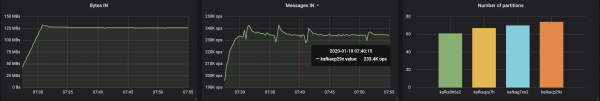
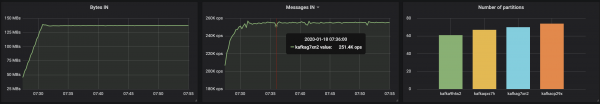
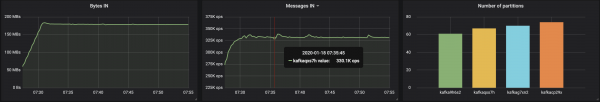
O consumo de memória da máquina JVM permaneceu abaixo de 2 GB:
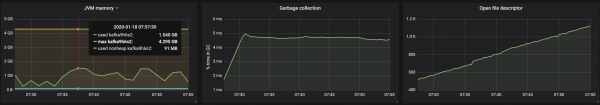
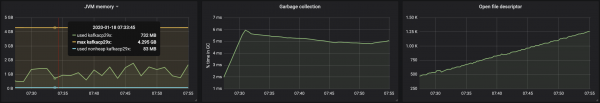
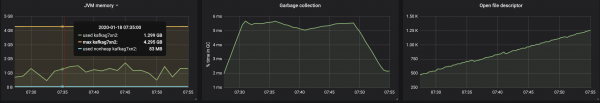
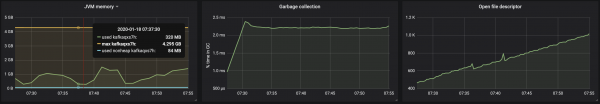
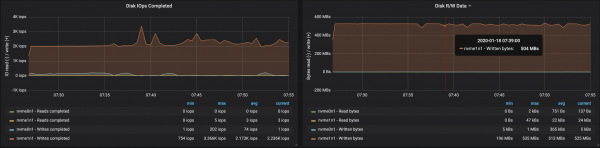
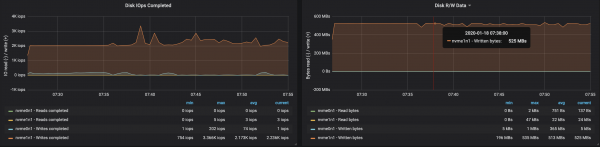
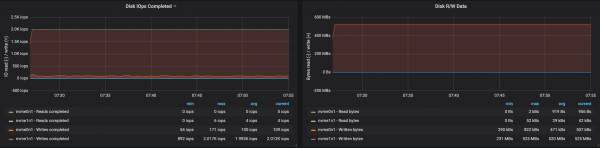
O trabalho dos brokers com os armazenadores foi afetado por um desbalanceamento das partições:
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
A abordagem iterativa apresentada acima pode ser expandida para cobrir cenários mais complexos, envolvendo centenas de consumidores, reparticionamento, atualizações incrementais, reinicializações de pods, etc. Tudo isso nos permite avaliar os limites das capacidades do cluster Kafka em diferentes condições, identificar gargalos em seu funcionamento e encontrar maneiras de superá-los.
Desenvolvemos o Supertubes para uma implantação rápida e fácil do cluster, sua configuração, adição/removal de brokers e tópicos, resposta a alertas e garante o funcionamento adequado do Kafka em Kubernetes como um todo. Nosso objetivo é ajudar a focar na tarefa principal ('gerar' e 'consumir' mensagens Kafka), enquanto toda a parte pesada é deixada para o Supertubes e o operador Kafka.
Se você está interessado em tecnologias e projetos Open Source da Banzai Cloud, siga a empresa em , ou .
P.S. do tradutor
Confira também em nosso blog:
- «»;
- «»;
- «».
Fonte: habr.com
