

Saudações, e primeiro um pouco de reflexão. Às vezes, eu invejo colegas que trabalham remotamente — é maravilhoso ter a possibilidade de trabalhar de qualquer canto do mundo conectado à Internet, férias a qualquer momento, responsabilidade por projetos e prazos, em vez de estar no escritório das 8 às 17. Minha posição e responsabilidades de trabalho praticamente excluem a possibilidade de longas ausências no data center. No entanto — periodicamente ocorrem casos interessantes, como o descrito abaixo — e eu entendo que existem poucas posições onde há tanto espaço para a expressão criativa do troubleshoot interno.
Uma pequena observação — no momento em que escrevo este artigo, o caso não está totalmente resolvido, mas considerando a velocidade de resposta dos fornecedores, a solução completa pode levar meses, e eu gostaria de compartilhar minhas descobertas já. Espero que, respeitáveis leitores, vocês me perdoem pela pressa. Mas chega de conversa — o que está acontecendo com o caso?
Primeiro, uma introdução: há uma empresa (onde trabalho como engenheiro de redes) que hospeda soluções de clientes na nuvem privada VMWare. A maioria das novas soluções é conectada a segmentos VXLAN, que são gerenciados pelo NSX-V — não vou avaliar quanto tempo isso me poupou, em resumo — muito. Consegui até treinar colegas na configuração do NSX ESG, e pequenas soluções de clientes estão sendo implantadas sem a minha participação. Uma observação importante — nosso plano de controle é com replicação unicast. Os hipervisores estão conectados de forma redundante por duas interfaces a diferentes switches físicos Juniper QFX5100 (montados em Virtual Chassis) e com a política de roteamento baseada na porta virtual de origem — isso para completar o quadro.
As soluções de clientes são muito diversas: desde Windows IIS, onde todos os componentes do servidor web estão instalados em uma única máquina, até soluções bastante grandes — como front-ends Apache balanceados por carga + LB MariaDB em Galera + servidores de compartilhamento, sincronizados através do GlusterFS. Praticamente cada servidor precisa ser monitorado separadamente, e nem todos os componentes têm endereços públicos — se você já enfrentou essa tarefa e tem uma solução mais elegante, ficarei feliz com suas sugestões.
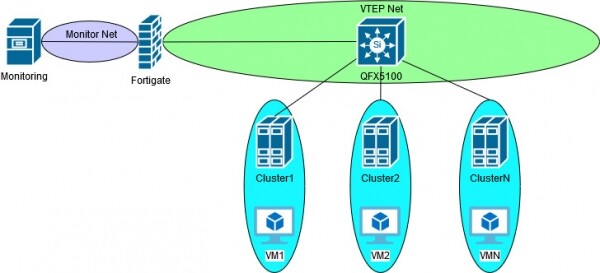
A minha solução de monitoramento consiste em «conectar» o firewall (Fortigate) a cada rede interna do cliente (+SNAT e, claro, restrições rígidas quanto ao tipo de tráfego permitido) e monitorar os endereços internos — dessa forma, conseguimos uma certa unificação e simplificação do monitoramento. O monitoramento ocorre a partir de um cluster de servidores PRTG. O esquema de monitoramento é aproximadamente assim:
Enquanto operávamos apenas com VLAN, tudo funcionava de forma bastante normal e previsível, como um relógio. Após a implementação do NSX-V e VXLAN, nos deparamos com a questão — podemos continuar monitorando da maneira antiga? No momento em que esta pergunta surgiu, a solução mais «rápida» era implantar o NSX ESG e conectar a interface trunk VXLAN na rede VTEP. Rápida entre aspas — pois usar a interface gráfica para configurar redes de clientes, SNAT e regras de firewall pode unificar a gestão em uma única interface vSphere, mas, na minha opinião, é bastante pesada e, além disso, limita o conjunto de ferramentas para solução de problemas. Aqueles que usaram o NSX ESG como substituto de um firewall «real», creio que concordarão. Embora, provavelmente, essa solução seria mais estável — afinal, tudo acontece dentro de um único fornecedor.
Uma outra solução é usar o NSX DLR no modo bridge entre VLAN e VXLAN. Aqui acredito que tudo esteja claro — a vantagem da aplicação de VXLAN se perde, uma vez que ainda é necessário puxar a VLAN para a instalação de monitoramento. A propósito, durante o desenvolvimento dessa solução, enfrentei o problema em que o DLR-bridge não enviava pacotes para a VM com a qual estava no mesmo host. Eu sei, eu sei — nos livros e guias sobre NSX-V, está claramente mencionado que um cluster separado deve ser alocado para o NSX Edge, mas isso está nos livros... De qualquer forma, após alguns meses com o suporte, não conseguimos resolver o problema. Em princípio, entendi a lógica do funcionamento — o módulo do kernel do hypervisor responsável pela encapsulação de VXLAN não era ativado quando o DLR e o servidor monitorado estavam no mesmo host, pois o tráfego não saía do host e, logicamente, deveria estar conectado ao segmento VXLAN — a encapsulação não é necessária. Com o suporte, nos concentramos na interface virtual vdrPort, que logicamente une os uplinks e também realiza o bridging/encapsulação — foi lá que notamos a discrepância no tráfego de entrada, que tomei como foco para resolver nesse caso atual. Mas, como foi dito, não finalizei esse caso, pois fui transferido para outro projeto e essa ramificação era originalmente sem saída e não havia muita vontade de desenvolvê-la. Se não me engano, o problema foi observado nas versões NSX 6.1.4 e 6.2.
E aqui — bingo! A Fortinet anuncia suporte nativo . E não apenas point-to-point ou VXLAN-over-IPSec, e sim o bridging de VLAN-VXLAN — tudo isso começou a ser implementado desde a versão 5.4 (e apresentado por outros ), e o verdadeiro suporte foi o controle do plano de controle unicast. Durante a implementação da solução, enfrentei outro problema — os servidores monitorados frequentemente
Após passar pelo tráfego de teste, decidimos implementar essa solução. E em produção, descobrimos que, após um ou dois dias, tudo que era monitorado via VXLAN gradualmente parava de funcionar. A desativação/reativação da interface ajudava, mas apenas por um tempo. Lembrando da lentidão do suporte do fabricante, fui eu mesmo que comecei a resolver o problema — afinal, minha empresa, minha rede — minha responsabilidade.
Abaixo, o progresso da solução de problemas. Quem está cansado de letras e fanfarronices — pode pular e ir direto para a análise pós-implementação.
Progresso da solução de problemasObrigado por continuar a leitura — vamos em frente!
Então, o monitoramento funciona por algum tempo, depois para por conta própria. Isso significa que provavelmente não há problemas nas políticas do firewall. No entanto, como já enfrentei problemas com processos de sistema travados no Fortigate versões 5.6+, primeiro conferimos o "diagnose debug flow" — como esperado, o tráfego é permitido e sai pela interface, e nada volta em resposta. Portanto, temos que investigar mais a fundo. Infelizmente, terei que ocultar endereços, mesmo que sejam RFC1918, mas espero fornecer informações suficientes para entendimento. O servidor dentro do VXLAN tem o endereço x.x.x.15, a interface do Fortigate x.x.x.254, todos os outros endereços pertencem à rede VTEP.
Para a transmissão bem-sucedida de pacotes encapsulados em VXLAN, é necessário ter informações corretas em várias tabelas. Para o overlay, isso é ARP e OVSDB, e para o underlay, é ARP e CAM. No caso do Fortigate, VXLAN FDB é OVSDB. Vamos começar por aí:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=у.у.у.47 port=4789 vni=5008 ifindex=7
Aqui tudo é bastante simples — o endereço MAC da VM deve estar no VTEP com o endereço у.у.у.47. Ao olhar o conteúdo e as configurações do cluster ESXI, encontro que o MAC da VM está correto, e o endereço do VTEP também. Verifico a tabela CAM/ARP no FortiGate — tudo confere com as configurações do host ESXI:
fortigate (root) #get sys arp | grep у.у.у.47
у.у.у.47 0 00:50:56:65:f6:2c dmz
As tabelas estão corretas e o tráfego está saindo — talvez o problema não esteja no Fortigate? Eu deliberadamente pulei a análise de comutação de tráfego no Juniper — logicamente, esse seria o próximo passo na resolução de problemas, mas minha rede é simples — apenas um VLAN para o VTEP e todos os componentes estão conectados diretamente. Além disso, lembro de um caso com o DLR-bridge, VDR e tráfego desaparecido — vou monitorar no host ESXI, além de abrir um chamado para a VMWare. Abaixo, o MAC "97:6e" pertence ao FortiGate, vmnic1 — esta é a interface que possui o VTEP com o endereço у.у.у.47, monitorando em ambas as direções "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
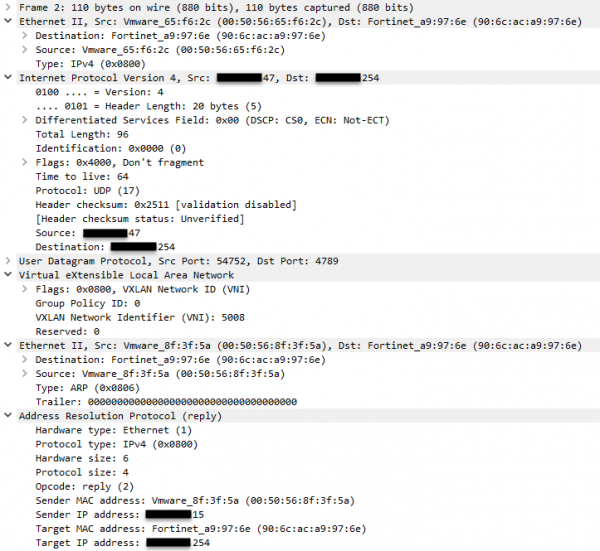
Progresso — no monitoramento vejo a solicitação ARP e a resposta recebida. Apresento apenas a resposta ARP e está tudo correto. Não mencionei, mas durante todo esse tempo, o servidor de monitoramento está pingando o endereço х.х.х.15 — onde está o tráfego ICMP? Lembro que tenho dois uplinks. Aqui pode-se argumentar que a porta virtual do fonte é a mesma (minha política de team), ou seja, para o mesmo vNIC deve ser escolhido o mesmo uplink, mas já que estou no host, verificar outro uplink não é problema:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
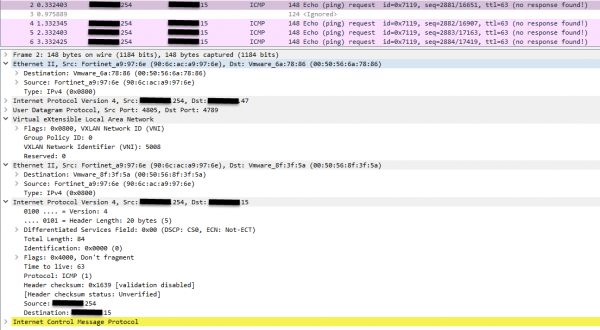
Estão chegando solicitações do Fortigate, mas não há resposta. Ou seja, o problema não está no Fortigate. Bom, acho que novamente estou enfrentando o mesmo problema de tráfego desaparecendo no VDR, e novamente terei que direcionar o caso na direção certa por alguns meses. Após alguns dias de reflexão e não querendo aceitar a situação pendente, decidi coletar mais pacotes de sniffer para o suporte, a fim de acelerar o processo. E aqui, por 'acaso', meu olhar cai na encapsulação Ethernet underlay. O rei não é verdadeiro e o endereço MAC do VTEP não corresponde ao seu IP. Zerei, fiz sniffer, investiguei — era verdade, mas não era. Apresentarei a tabela ARP ao lado para facilitar a comparação. Observe a primeira encapsulação Ethernet na imagem acima:
fortigate (root) #get sys arp | grep 0.0.0.47
0.0.0.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep 0.0.0.42
0.0.0.42 0 00:50:56:6a:78:86 dmz
Então, o que temos no final — após a migração da máquina virtual, o Fortigate tenta enviar tráfego para o VTEP a partir do (correto) VXLAN FDB, mas usa o MAC DST incorreto, e o tráfego é, como esperado, descartado pela interface receptora do hipervisor. Em um dos quatro casos, esse MAC pertencia ao hipervisor original, de onde a migração da máquina começou.
Recebi ontem um e-mail do suporte técnico da Fortinet — abriram um bug 615586 sobre o meu caso. Não sei se fico feliz ou triste: por um lado, o problema não está nas configurações; por outro lado, a correção virá apenas com a atualização do firmware, provavelmente na próxima versão. Meu ego é aquecido por mais um bug que identifiquei no mês passado, embora desta vez na GUI HTML5 do vSphere. É quase como um departamento de QA local dos fornecedores...
Arrisco-me a supor o seguinte:
1 — o plano de controle multicast provavelmente não será suscetível ao problema descrito — pois os endereços MAC do VTEP são obtidos a partir do endereço IP do grupo ao qual a interface está assinada.
2 — o problema com o Fortigate provavelmente está no descarregamento de sessões no Processador de Rede (aproximadamente análogo ao CEF) — se todos os pacotes forem processados pelo CPU, serão utilizadas tabelas contendo informações corretas — pelo menos visualmente. A favor dessa suposição está o fato de que ajudar a fechar/abrir a interface ou esperar um certo tempo — mais de 5 minutos — realmente ajuda.
3 — a alteração da política de agrupamento, por exemplo, para failover explícito, ou a implementação de LAG não resolverá o problema, já que observei o 'emperramento' do MAC do hipervisor original em pacotes encapsulados.
À luz disso, posso compartilhar que recentemente descobri , onde um dos artigos afirmava que firewalls stateful e métodos de transmissão de dados em cache são soluções improvisadas. Bem, não sou tão experiente em TI para fazer tal afirmação, além disso, não concordo de imediato com todas as afirmações dos artigos do blog. No entanto, algo me diz que há uma certa verdade nas palavras do Ivan.
Agradeço pela atenção! Ficarei feliz em responder a perguntas e ouvir críticas construtivas.
Fonte: habr.com
