

Apresento a vocês a transcrição do relatório de 2017 de Igor Strychar «ClickHouse – análise de dados visualmente rápida e clara no Tabix».
Interface web para ClickHouse no projeto Tabix.
Principais funcionalidades:
- Funciona com ClickHouse diretamente do navegador, sem necessidade de instalação de software adicional;
- Editor de consultas com destaque de sintaxe;
- Autocompletar comandos;
- Ferramentas de análise gráfica da execução de consultas;
- Esquemas de cores à escolha.

Sou o diretor técnico do СМИ2. Nós somos um agregador de notícias. Armazenamos muitos dados que recebemos de nossos parceiros e os registramos no ClickHouse – cerca de 30.000 consultas por segundo.
Esses dados incluem:
- Cliques em notícias.
- Exibições de notícias no agregador.
- Exibições de banners na nossa rede.
- E registramos eventos do nosso próprio contador, que é semelhante ao Yandex.Metrica. Essa é nossa própria microanálise.
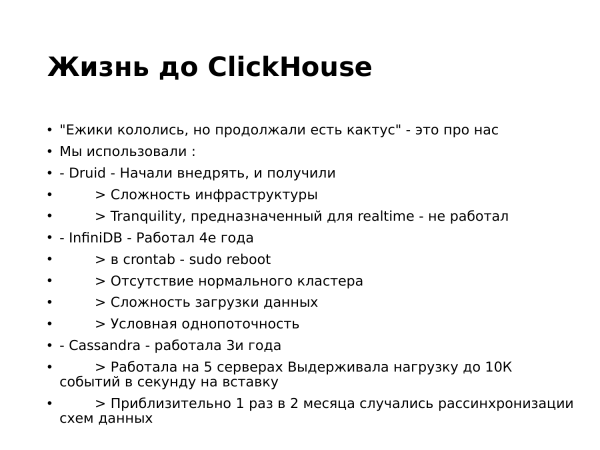
Tivemos uma vida muito agitada antes do ClickHouse. Sofremos muito tentando armazenar esses dados em algum lugar e analisá-los de alguma forma.
Vida antes do ClickHouse — infiniDB
A primeira coisa que tivemos foi a infiniDB. Ela ficou conosco por 4 anos. Lançamos com dificuldades.
- Ela não suporta clusterização ou sharding. Nenhuma dessas funcionalidades avançadas já vinha configurada por padrão.
- Ela tinha dificuldades para carregar dados. Apenas uma utilidade de console específica, que só podia carregar arquivos CSV e de forma bastante confusa.
- O banco de dados era single-threaded. Podia-se escrever ou ler. Mas permitia processar grandes volumes de dados.
- Além disso, havia um truque curioso. A cada noite, precisávamos reiniciar o servidor, caso contrário ele não funcionava.
Ela funcionou conosco até o final de 2016, quando fizemos a transição completa para o ClickHouse.
Vida antes do ClickHouse — Cassandra
Como a infiniDB era single-threaded, decidimos que precisaríamos de algum banco de dados multi-threaded, onde pudéssemos escrever muitos fluxos simultaneamente.
Experimentamos muitas coisas interessantes. Depois decidimos testar o Cassandra. Com o Cassandra, tudo estava perfeito. 10.000 consultas por segundo ao inserir. Cerca de 2.000 consultas ao ler.
Mas também havia suas peculiaridades. Uma vez por mês ou de dois em dois meses, ocorria uma desincronização do banco de dados. Era preciso acordar e correr para consertar o Cassandra. Reiniciávamos os servidores um por um. E tudo ficava suave e bonito.
A Vida Antes do ClickHouse – Druid
Depois percebemos que precisávamos escrever ainda mais dados. Em 2016, começamos a considerar o Druid.
Druid é um banco de dados aberto, escrito em Java. Muito específico. E se adequava ao clickstream, quando precisávamos armazenar algum fluxo de eventos e depois realizar agregações ou gerar relatórios analíticos.
O Druid tinha a versão 0.9.X.
Por si só, o banco de dados é muito difícil de implementar. Essa é a complexidade da infraestrutura. Para instalá-lo, era necessário colocar muitos servidores. E cada servidor tinha seu próprio papel.
Para carregar dados nele, era necessário aplicar um certo 'shamanismo'. Existe um projeto Open Source – Tranquility, que perdia dados no fluxo. Quando carregávamos dados nele, ele os perdia.
Mas de alguma forma começamos a implementá-lo. Fomos como porcos-espinhos que se espetavam, mas continuavam a comer cacto, começamos a implementá-lo. Levamos cerca de um mês para preparar toda a infraestrutura para ele, ou seja, encomendar servidores, configurar funções e realizar uma automação completa de implantação. Ou seja, em caso de queda do cluster, um segundo cluster seria implantado automaticamente.
Mas então aconteceu um milagre. Eu estava de férias e meus colegas me enviaram um link para , onde dizia que a Yandex decidiu abrir o ClickHouse. Eu disse que vamos experimentar.
E em apenas 2 dias implantamos um cluster de teste do ClickHouse. Começamos a carregar dados nele. Comparado ao infiniDB – é simples, comparado ao Druid – é simples. Comparado ao Cassandra também é simples. Porque se você carregar dados no Cassandra a partir do php, isso não é simples.
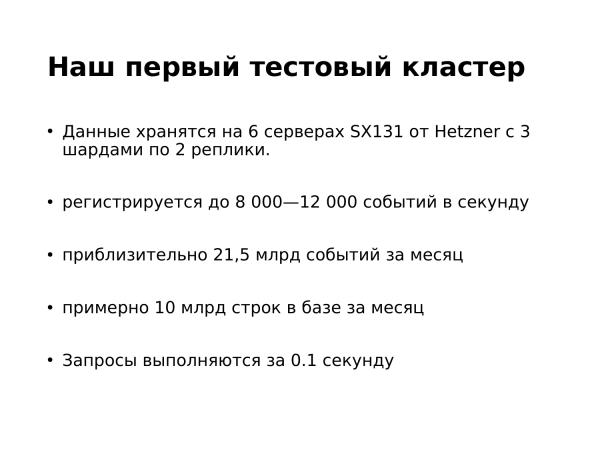
O que obtivemos? Desempenho em velocidade. Desempenho no armazenamento de dados. Ou seja, é utilizado muito menos espaço em disco. O ClickHouse é rápido, ele é muito rápido em comparação com outros produtos.
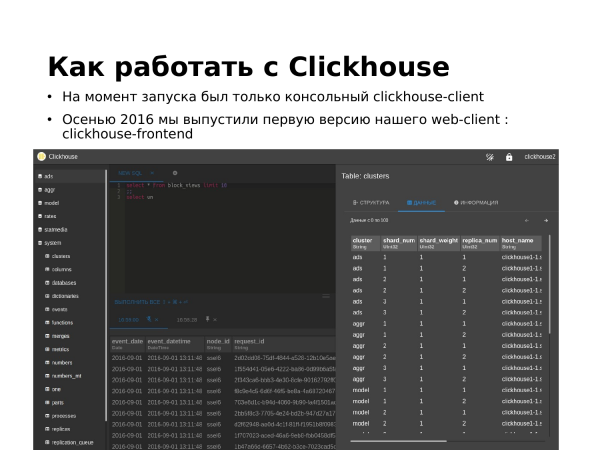
No momento do lançamento, quando a Yandex publicou o ClickHouse como Open Source, havia apenas um cliente de console. Nós, na nossa empresa, o СМИ2, decidimos tentar criar um cliente nativo para web, para que pudéssemos abrir uma página no navegador, escrever uma consulta e obter o resultado, porque começamos a escrever muitas consultas. Escrever no console é difícil. E fizemos nossa primeira versão.
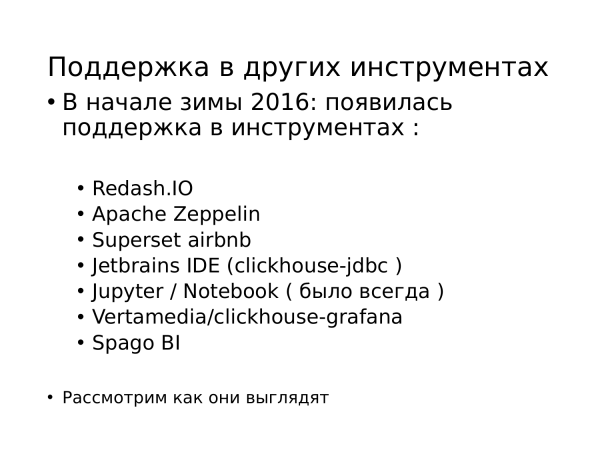
E mais perto do inverno do ano passado, começaram a aparecer ferramentas de terceiros para trabalhar com o ClickHouse. Essas ferramentas incluem:
- .
- .
- . (Agora )
- .
- .
Vou considerar algumas dessas ferramentas, ou seja, aquelas com as quais trabalhei.
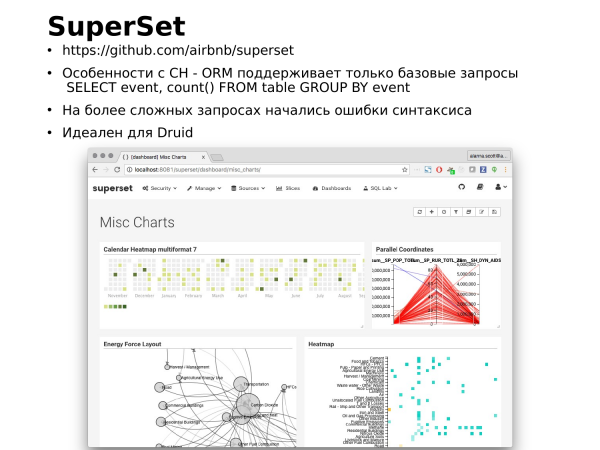
É uma boa ferramenta, mas para Druid. Quando implementamos o Druid, experimentei o SuperSet. Gostei dele. Funciona muito rapidamente para Druid.
Não é adequado para ClickHouse. Ou seja, ele funciona e é capaz de rodar, mas só consegue processar consultas elementares como: SELECT event, GROUP BY event. Não suporta sintaxe mais complexa do ClickHouse.
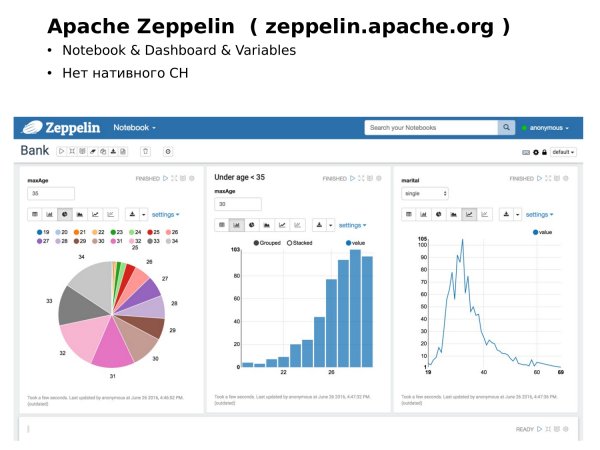
A próxima ferramenta é o Apache Zeppelin. É uma coisa boa e interessante. Funciona bem. Suporta notebooks, dashboards e variáveis. Sei que alguém da comunidade ClickHouse o utiliza.
Mas não há suporte para a sintaxe do ClickHouse, ou seja, você terá que escrever as consultas no console ou em outro lugar. Depois, verificar se tudo funciona. Isso é simplesmente inconveniente. Mas o suporte para dashboards é bom.
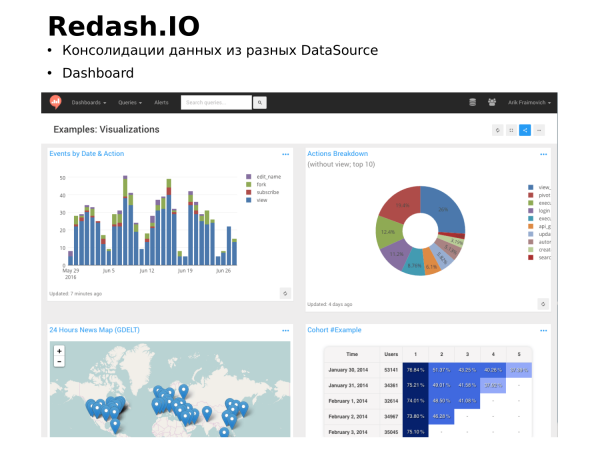
A próxima ferramenta é o Redash.IO. O Redash é hospedado na internet. Ou seja, ao contrário das ferramentas anteriores, não precisa ser instalado. É um sistema de dashboard com a capacidade de consolidar dados de diferentes DataSources. Ou seja, você pode extrair de ClickHouse, MySQL, PostgreSQL e outros bancos de dados.
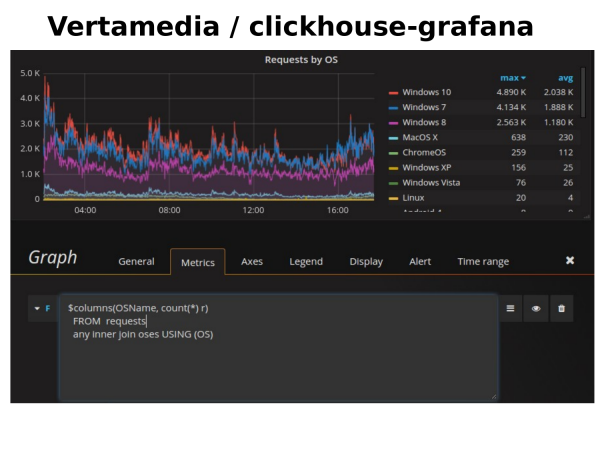
Literalmente, há um mês (em março de 2017) foi adicionada a suportar no Grafana. Quando você constrói relatórios no Grafana, por exemplo, sobre o estado do seu hardware ou algumas métricas, agora é possível criar o mesmo gráfico ou um painel a partir dos dados do ClickHouse diretamente. Isso é muito conveniente, e estamos usando aqui. Isso permite encontrar anomalias. Ou seja, se algo está acontecendo e algum hardware falha ou fica sobrecarregado, você pode verificar a razão, se esses dados já chegaram ao ClickHouse.
Foi muito inconveniente escrever nessas ferramentas ou no console. Então, decidi aprimorar nossa primeira interface. E peguei a ideia do EventSQL, SeperSet, Zeppelin.
O que eu queria? Queria obter gráficos, um editor aprimorado, e implementar o suporte para dicionários de sugestões. Porque o ClickHouse tem uma função ótima – dicionários. Mas é difícil trabalhar com dicionários, porque você precisa lembrar o formato dos valores armazenados, ou seja, se é um número ou uma string, etc. Como usamos dicionários em suas várias versões com frequência, era bastante difícil escrever as consultas.
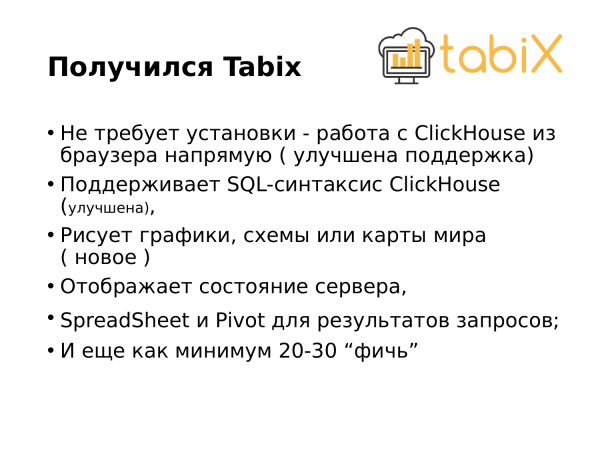
Passaram-se 3 meses desde o lançamento da nossa primeira versão. Fiz cerca de 330 commits na branch privada e surgiu o Tabix.
Diferente da versão anterior, que se chamava ClickHouse-Frontend, eu decidi renomeá-lo para um nome simples. E assim surgiu o Tabix.
O que há de novo?
Desenha gráficos. Suporta a sintaxe SQL do ClickHouse. Oferece sugestões de funções e tem muitas outras funcionalidades interessantes.
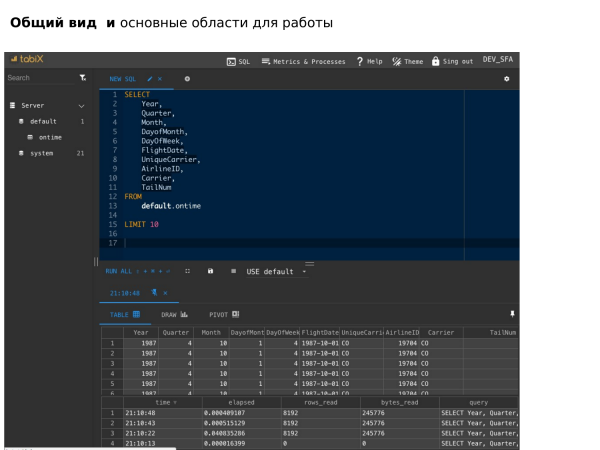
Assim é como o esquema geral do Tabix se apresenta. À esquerda está a árvore. No centro – o editor de consultas. E embaixo – o resultado dessa consulta.
Agora vou mostrar como funciona o editor de consultas.
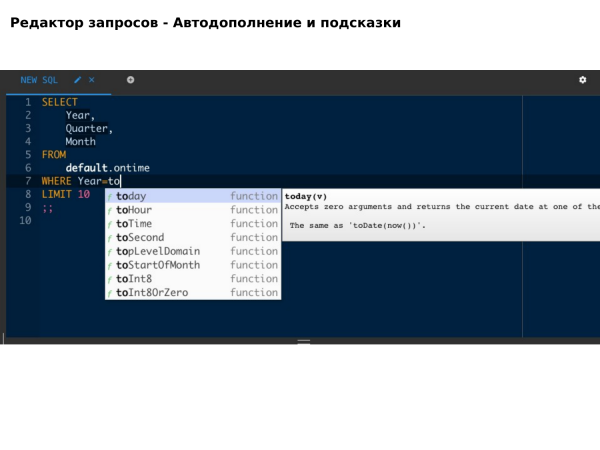
Aqui o autocompletar foi acionado automaticamente na tabela, oferecendo sugestões relacionadas aos campos e às funções. Se você pressionar ctrl e enter, a consulta será executada ou exibirá um erro. A consulta mais simples é enviada ao Tabix e retorna o resultado, ou seja, é possível trabalhar rapidamente com o ClickHouse.
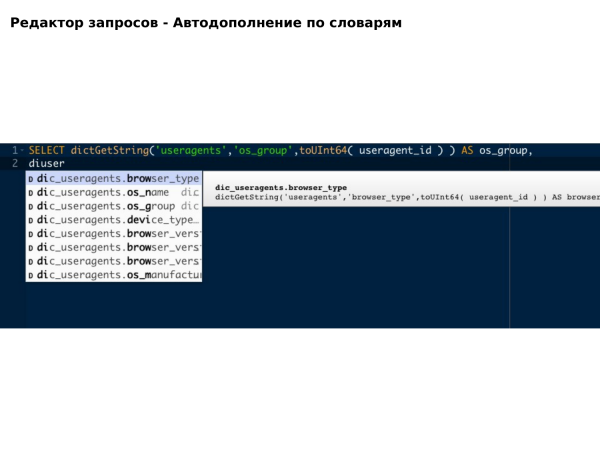
Os dicionários, como já mencionei, são uma coisa muito interessante com a qual trabalhamos bastante. E que permitiu realizar muitas tarefas. Por exemplo, nos dicionários armazenamos todas as cidades. Guardamos o identificador da cidade e o nome da cidade, sua latitude e longitude. E no banco, armazenamos apenas o identificador da cidade. Dessa forma, comprimimos os dados significativamente.
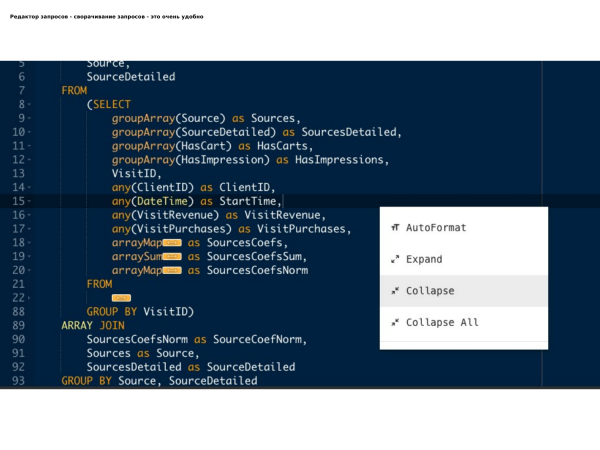
Parece uma coisa simples, mas no ClickHouse isso ajuda de forma bastante interessante. Como o ClickHouse suporta apenas joins aninhados, a consulta se expande significativamente tanto em profundidade quanto em largura. E quando a chave abre e surge uma expressão longa, uma coisa simples como dobrar a consulta torna mais fácil trabalhar com ela mesma. Porque quando a consulta tem 200-300 linhas e sua largura é enorme, essa função de reduzir a consulta é realmente uma salvação, ajudando a encontrar um lugar ou localizá-la de outra forma.
Árvore de objetos, múltiplas consultas e guias (Vídeo 13:46 )
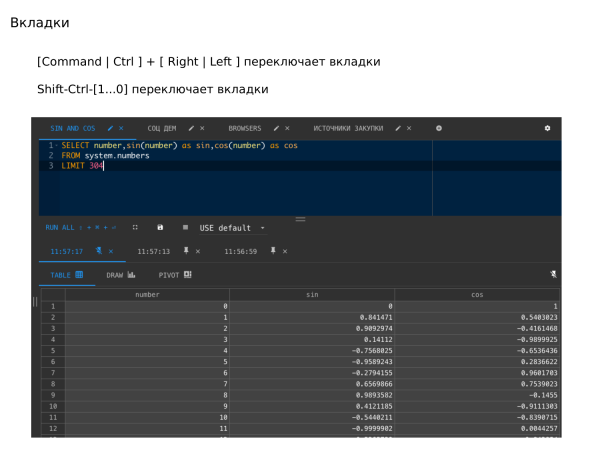
A seguir, irei mostrar a árvore e as guias. À esquerda – está a árvore, e em cima você pode criar várias guias. As guias funcionam como um espaço de trabalho. Você pode criar várias guias e nomeá-las de forma específica. É como um mini-sistema para a construção de relatórios.
As guias são salvas automaticamente. Se você recarregar o navegador, fechar ou abrir o Tabix, tudo isso será mantido.
Tecla de atalho – prático (Vídeo 14:39 )
Existem teclas de atalho e são bem numerosas. Aqui estão alguns exemplos que selecionei. Isso inclui alternar entre guias, executar consultas ou executar várias consultas.
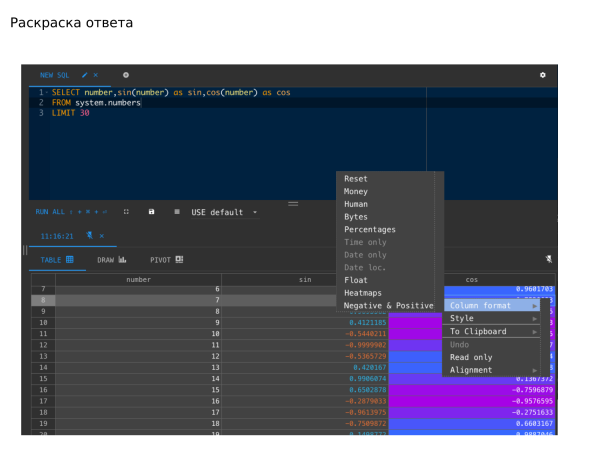
Vou mostrar como trabalhar com o resultado. Enviamos a solicitação. Aqui eu desenho sin, cos e tg. É possível destacar o resultado, ou seja, desenhar um gráfico típico em uma coluna. Podemos realçar os valores positivos ou negativos. Ou simplesmente colorir um elemento específico da tabela. Isso é útil quando a tabela é enorme e precisamos encontrar alguma anomalia visualmente. Quando procurei anomalias, destaquei algumas linhas e elementos em verde ou vermelho.
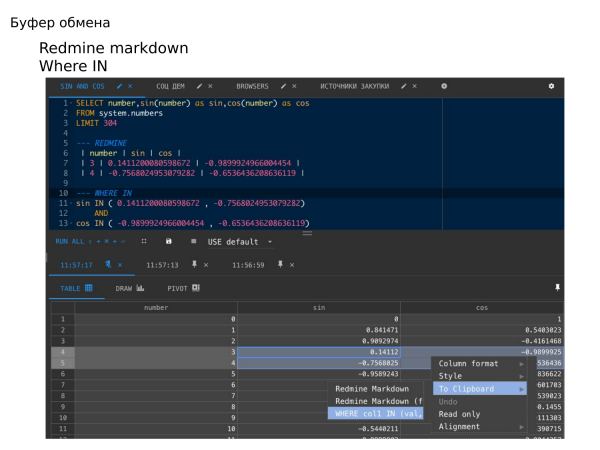
Há muitas coisas interessantes lá. Por exemplo, como copiar para o Redmine em Markdown. Se você precisa copiar o resultado para algum lugar, isso é muito conveniente. Basta selecionar a área, dizer "Copiar para o Redmine" e ele copiará em Markdown ou criará uma solicitação Where.
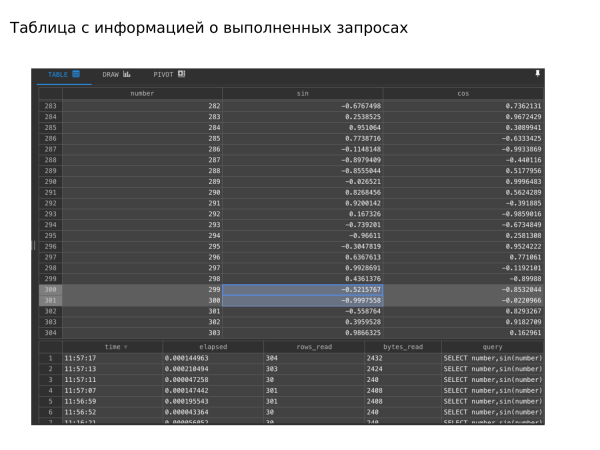
Em seguida, vem a otimização de consultas. Uma vez, esqueci de especificar o campo "date". E minha consulta no ClickHouse foi processada não muito rápido, mas rapidamente, ou seja, em menos de um segundo. Quando vi quantas linhas ele percorreu, fiquei assustado. Não escrevemos tantas linhas nesta tabela em um dia. Comecei a analisar a consulta e percebi que havia esquecido de um ponto: que precisava dos dados não de toda a tabela, mas de um período específico.
No Tabix, há uma aba "Stats", onde fica todo o histórico de solicitações enviadas, ou seja, lá você pode ver quantas linhas foram lidas por essa consulta e quanto tempo levou para ser executada. Isso permite otimizar.
Você pode construir uma tabela resumo com o resultado da consulta. Você enviou uma consulta para o ClickHouse, obteve alguns dados. E depois, esses dados podem ser arrastados com o mouse para construir alguma tabela resumo.
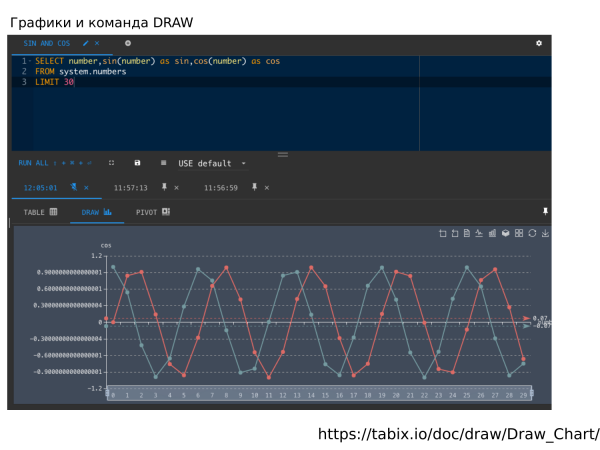
Outra coisa interessante é a construção de gráficos. Suponha que temos essa consulta: para sin, cos de 0 a 299. E para desenhá-la, é preciso selecionar a aba "Draw" e você receberá o gráfico com seus sin e cos.
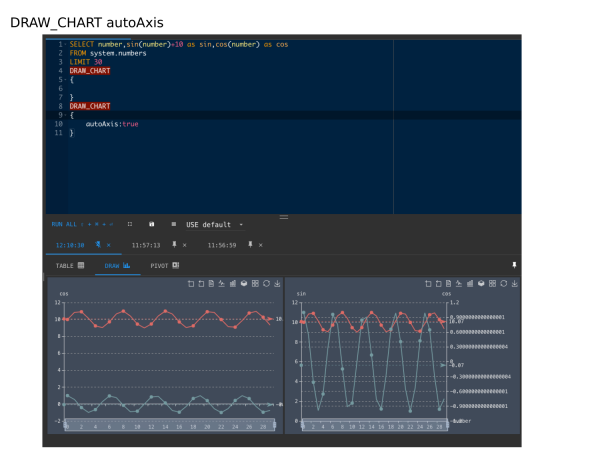
É possível dividir isso em eixos diferentes, ou seja, é possível desenhar dois gráficos lado a lado. Escreva um comando e o segundo comando.
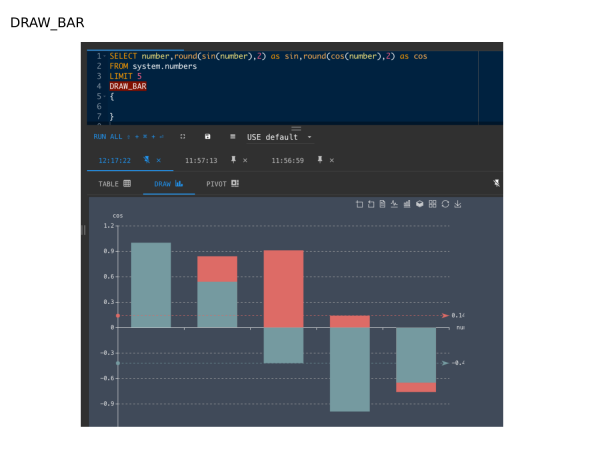
É possível desenhar histogramas.
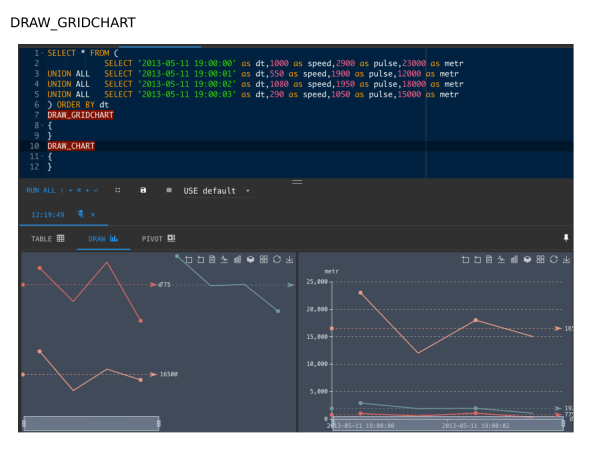
É possível dividir isso em uma matriz de gráficos.
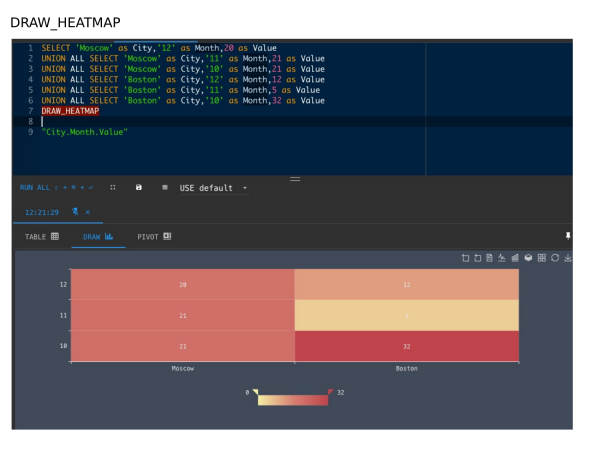
Você pode construir um mapa de calor.
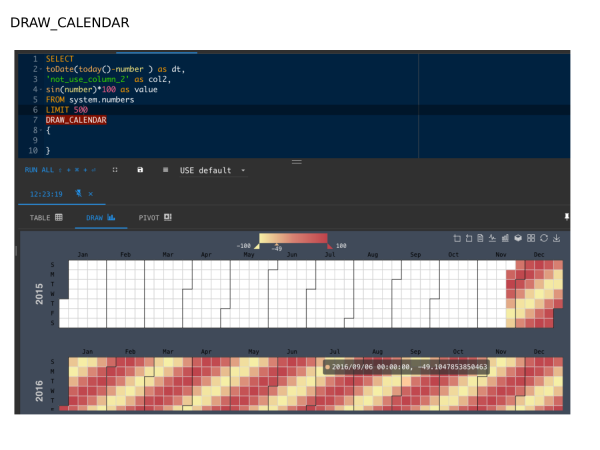
Você pode construir um calendário de calor. Aliás, é uma coisa muito conveniente quando se precisa analisar anomalias ao longo de um ano, ou seja, encontrar picos ou quedas. Essa visualização de dados me ajudou muito.
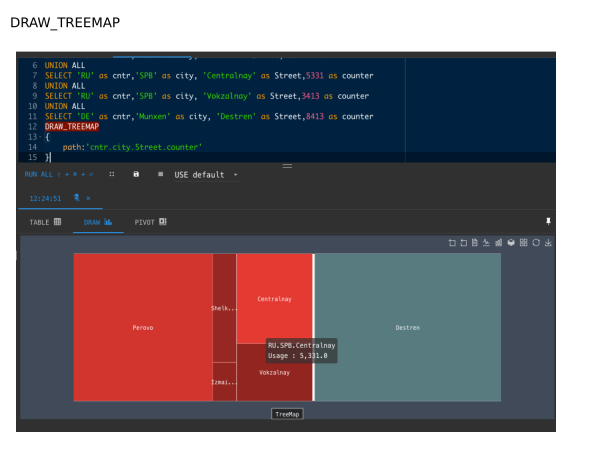
O próximo é o Treemap.
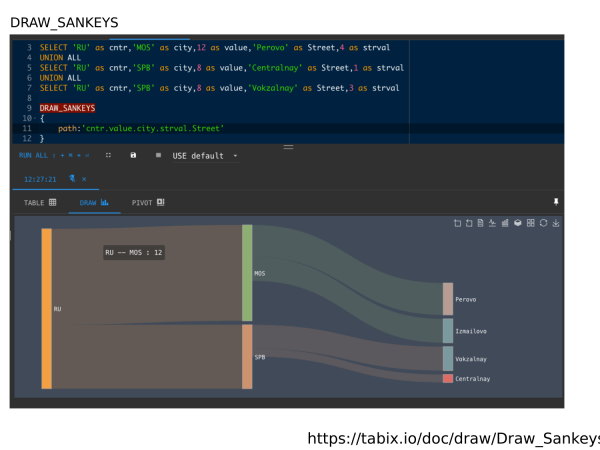
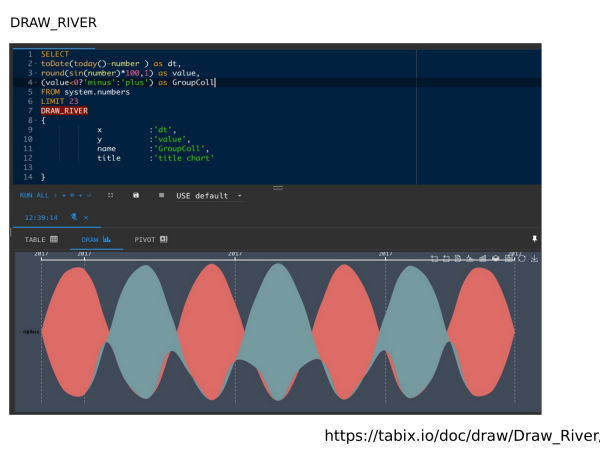
Sankeys – um gráfico interessante. Ele é ou Streamgraphs ou River. Mas eu o chamo de River. Ele também permite buscar anomalias. É muito conveniente. Recomendo usá-lo para buscas.
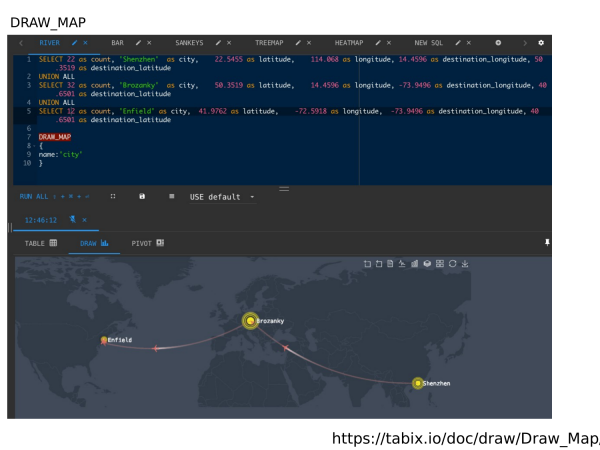
A próxima coisa interessante é a renderização de um mapa dinâmico. Se você armazena latitude, longitude e, por exemplo, um destino em seu banco de dados, se você está, por exemplo, com transporte rodoviário ou voos de avião, pode traçar os caminhos dos destinos. Também é possível definir a velocidade e o tamanho desses objetos que eles chegam.
Mas o problema com este mapa é que ele desenha apenas o mapa do mundo, sem detalhes.
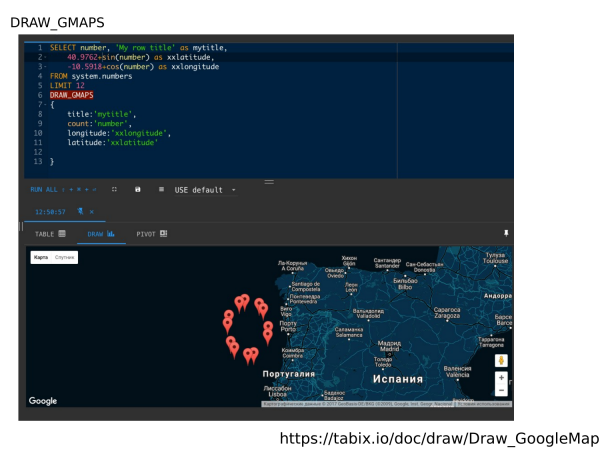
Posteriormente, adicionei o Google Map. Se você armazena latitude e longitude, pode apresentar o resultado no Google Map, mas sem suporte a aviões.
Nós discutimos as funções principais para trabalhar com o resultado, com a consulta no Tabix.
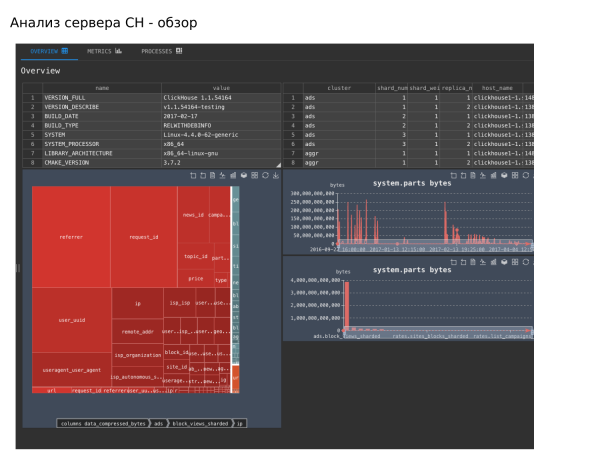
O próximo ponto é a análise do seu servidor ClickHouse. Há uma aba separada chamada 'Métricas', onde você pode ver o tamanho dos dados armazenados por cada coluna. Na captura de tela, é mostrado que o campo 'referrer' ocupa cerca de 730 GB. Se desistirmos desse campo, economizaremos três shards de 700 GB, ou seja, cerca de 2 TB que não precisamos.
Também temos o campo 'request_id', que armazenamos em formato de string. Mas se começarmos a armazená-lo em formato numérico, isso reduzirá significativamente o tamanho desse campo.
Aqui também está configurado o servidor e a lista de nós do seu cluster.
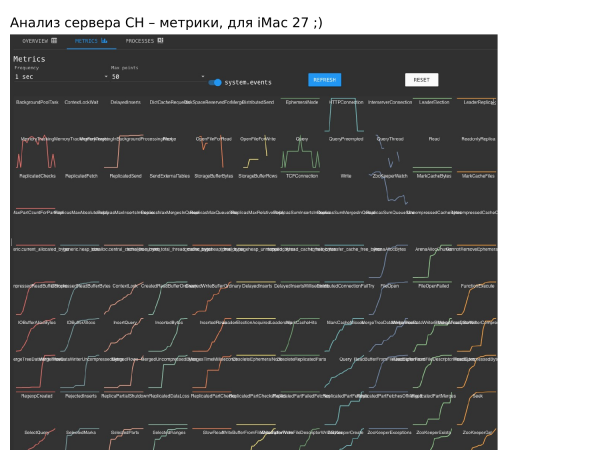
A próxima aba são as métricas. Elas são coletadas em tempo real do ClickHouse e simplesmente permitem analisar o estado do servidor e entender o que está acontecendo com ele. Isso não é uma substituição completa do Grafana. É necessário para uma análise rápida.
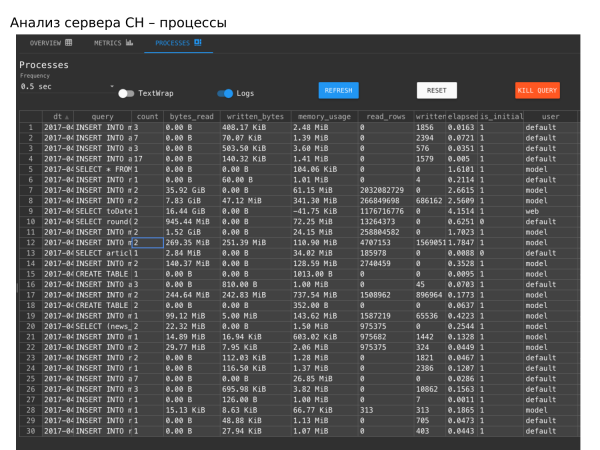
A próxima aba são os processos. Através deles é possível entender o que está acontecendo no servidor. Compreender o que está em curso. Eu tive uma consulta que consumia 200 GB de leitura a cada vez. Eu percebi isso graças a essa interface. Identifiquei e ajustei, e o resultado foi cerca de 30 GB, ou seja, um desempenho muito melhor.
Obrigado! E isso está em OpenSource.
Terminei. E, a propósito, isso está em OpenSource, é gratuito e você nem precisa baixar. Abra no navegador e tudo funcionará.
Perguntas
Igor, o que vem a seguir? Para onde você vai desenvolver esta ferramenta?
A seguir, haverá um dashboard, ou seja, pode ser que um dashboard apareça. Integração com outros bancos de dados. Eu fiz isso, mas ainda não publiquei como OpenSource. Isso é MySQL e, possivelmente, PostgreSQL. Ou seja, será possível enviar consultas do Tabix não apenas para o ClickHouse, mas também para outras ferramentas.
É evidente que um enorme volume de trabalho foi realizado. A ideia acabou sendo bastante completa. Foi feito no navegador, provavelmente para evitar soluções improvisadas em várias dimensões e rapidamente juntar tudo isso. Eu ouvi que você está php trabalhando, então é mais fácil colocar no navegador e funcionará em toda parte. Não há dúvida quanto a isso. A pergunta é: muito foi realmente feito lá. Quantas pessoas trabalharam nisso? E quanto tempo tudo isso levou? Porque ferramentas personalizadas geralmente não têm um funcionalidade tão ampla.
De verão a outono, trabalhou uma pessoa da nossa equipe. Essa foi a primeira versão. Depois, fiz 330 commits sozinho. O que você vê, fizemos eu e um colega em conjunto. Em 3 meses, da primeira versão até a última, eu fiz a maior parte sozinho. Mas eu conheço muito pouco de Javascript. Este foi meu único e, espero, último projeto em Javascript que trabalhei. Ele caiu nas minhas mãos, eu olhei – oh, horror. Mas eu realmente queria finalizar o produto e aqui está o resultado.
Muito obrigado pela apresentação! É uma ferramenta excelente. A Tableau compararam?
Obrigado. É por isso que chamamos de Tabix, porque as primeiras letras coincidem.
Porque competem?
Haverá muitos investimentos, vamos competir.
Como sugeriria vender para os analistas internos que essa ferramenta substituirá totalmente *Tableau*? Какие будут аргументы?
Funciona nativamente com o ClickHouse. Eu experimentei o Tableau, mas lá não é possível escrever suporte a dicionários e assim por diante. Eu sei como as pessoas usam o Tabix. Elas escrevem consultas, exportam para CSV e carregam no BI. E já lá fazem algo. Mas eu mal consigo imaginar como elas fazem isso, porque – é uma ferramenta gráfica. Ela pode exportar 5.000 linhas, no máximo 6.000 linhas, mas não mais do que isso, caso contrário, o navegador não suporta.
Ou seja, há restrições significativas em relação ao volume de dados, não é?
Sim. Eu não consigo imaginar que você queira exportar 10.000 linhas para a tabela na tela do navegador. Por que?
Presume-se que esta é uma interface para uma rápida visualização de dados? Rotacionar um pouco, folhear?
Sim, é rápido ver como funciona e só construir um gráfico consolidado. Depois, enviá-lo para algum lugar. Temos nosso próprio sistema de relatórios, de onde simplesmente pego essa consulta. Faço o desenho no Tabix e envio para nosso report.
E mais uma pergunta. Análise de coorte?
Se houver solicitações, adicionaremos.
Quando começamos a usar ClickHouse, quanto tempo demorou para a implementação ClickHouse e colocá-lo em estado de produção?
Como eu disse, implementamos um cluster de testes em um tempo muito curto. Levou apenas dois dias para configurá-lo. E mais algumas semanas o testamos. Chegamos à produção em cerca de 3 meses. Mas tínhamos nosso próprio ETL, ou seja, uma ferramenta para gravação de dados. Ele conseguia gravar em tudo que fosse possível. Ele pode gravar em MongoDB, Cassandra, MySQL. Ensinar ele a gravar no ClickHouse foi simples. Tínhamos uma infraestrutura pronta para uma implementação rápida. Após 3 meses, começamos a remover o primeiro componente. Em 6 meses, abrimos mão de todo o resto. Ficou apenas o ClickHouse.
Igor, muito obrigado pela apresentação. Gostei muito da funcionalidade de construção de caminhos em mapas. Está prevista a integração com o Yandex.Maps, e em particular com os mapas personalizados do Yandex?
Eu tentei me integrar em vez do Google Maps, mas não encontrei o modo escuro nos Yandex.Maps. Eu não contei uma parte. Vou voltar para complementar.
O slide – Google Maps. Lá existe o comando "DRAW_GMAPS", que desenha o mapa. Existe o comando "DRAW_YMAPS", ou seja, pode desenhar o Yandex.Map. E, na verdade, sob esse comando, existe Javascript, ou seja, os dados que você obtém do ClickHouse podem ser passados para o Javascript que você escrever aqui. E você tem uma área de saída onde isso deve ser desenhado. Qualquer gráfico pode ser desenhado, ou seja, qualquer gráfico, mapa, você pode desenhar seu próprio componente. Antes disso, eu tinha outra biblioteca para desenhar os gráficos.
Ou seja, existe uma ferramenta para personalizar a funcionalidade de exibição?
Qualquer um. Você pode pegar e mudar a cor desses pontos, tornando-os não vermelhos, mas azuis, verdes.
Obrigado pela apresentação! Você tinha um slide que apresentava ferramentas alternativas para consultas ClickHouse para construção de dashboards, relatórios analíticos. Entendi que, no momento em que você começou a trabalhar com ClickHouse, para essas ferramentas não foram escritos adaptadores. E eu me pergunto, por que você decidiu criar sua própria ferramenta, em vez de escrever um adaptador para alguma ferramenta existente? Eu penso que ajustar o editor de testes é rápido. Por que você decidiu fazer tanto trabalho?
Aqui há um ponto interessante – o fato é que sou diretor técnico, e não cientista de dados. Na época em que começamos a implementar o Druid, eu tinha cerca de 50% das tarefas no meu roadmap – vamos calcular isso ou vamos calcular aquilo, ou vamos analisar isso. E acabou que implementamos o ClickHouse. E comecei a construir tudo rapidamente, calcular, finalizei rapidamente meu roadmap. E nesse momento percebi que me faltavam conhecimentos em Data Science e visualização de dados. Tabix é uma espécie de meu dever de casa para aprender sobre visualização de dados. Eu observei como complementar o Zeppelin. Eu tenho uma leve aversão à sua programação. Redash eu observei como complementar, mas me faltava um editor decente. E o SuperSet também foi escrito na linguagem que eu não gosto muito. Então decidi inventar a roda, e aqui está o que resultou.
Igor, você aceita Pull requests?
Sim.
Muito obrigado pela apresentação! E duas perguntas. Primeiro – você não fala muito bem sobre Javascript. Você programou em Javascript puro ou foi algum framework?*
Melhor em Javascript puro.
Então, qual framework?
Angular.
Entendi. E a segunda pergunta. Você não considerou R e *Shiny**?*
Eu considerei. Brinquei com isso.
Poderia também apenas escrever um adaptador.
Ele existe. Parece que a comunidade o fez, mas, como respondi à pergunta anterior, eu queria experimentar por conta própria.
*Não, em relação à visualização, há sim.
Você diz que existe essa coisa e ela vai desenhar um gráfico para você. Eu abri um livro sobre visualização de dados. E pensei: "Vou tentar visualizar esses dados. Vou escrever eu mesmo, para que ele estruture os dados". E comecei a entender melhor a tecnologia de apresentação de dados. E se eu tivesse pegado um componente pronto, eu pessoalmente aprenderia a usá-lo pior, ou seja, especificamente a visualização. Mas sim – eu gostei do R, mas ainda não li o livro "R para leigos".
Obrigado!
Pergunta simples. Existem maneiras de exportar rapidamente uma tabela, um gráfico?
É possível exportar para CSV, para Excel.
Não os dados, mas uma tabela pronta, um gráfico pronto? Por exemplo, para mostrar para a gerência.
Há um botão "Exportar" e um botão "Exportar gráfico em png, em jpg".
Obrigado!
P.S. Mini-instruções para instalar o tabix
- Baixar
- Descompactar, copiar o diretório
buildpara o root_path do nginx - Configurar o nginx
Fonte: habr.com
