

Condição típica ao implementar CI/CD no Kubernetes: a aplicação deve ser capaz de não aceitar novas solicitações de clientes antes de parar completamente, e o mais importante - encerrar com sucesso as já existentes.
Atender a essa condição permite alcançar um tempo de inatividade zero durante o deployment. No entanto, mesmo ao utilizar combinações muito populares (como NGINX e PHP-FPM), podem surgir dificuldades que resultarão em um aumento de erros a cada deployment...
Teoria. Como vive um pod
Já publicamos detalhes sobre o ciclo de vida de um pod . No contexto do tema em discussão, nos interessa o seguinte: no momento em que o pod entra no estado Terminating, novas solicitações param de ser enviadas para ele (o pod da lista de endpoints para o serviço). Assim, para evitar inatividade durante o deployment, precisamos resolver o problema de parar a aplicação corretamente.
Também devemos lembrar que o período de grace é por padrão de : após isso, o pod será terminado e a aplicação deve ter tempo para processar todas as solicitações até o final desse período. Nota: embora qualquer solicitação que leve mais de 5-10 segundos já seja problemática, e uma finalização graciosa não ajudará mais...
Para entender melhor o que acontece quando o pod termina seu trabalho, basta estudar o seguinte esquema:
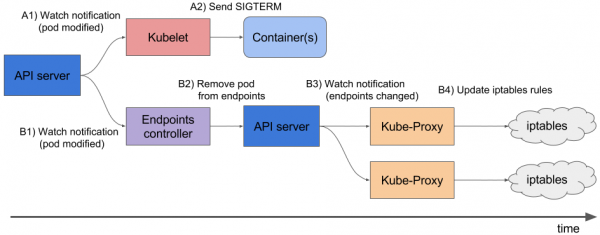
A1, B1 — Recebendo atualizações sobre o estado do pod
A2 — Enviando SIGTERM
B2 — Removendo o pod dos endpoints
B3 — Recebendo mudanças (a lista de endpoints foi alterada)
B4 — Atualizando regras do iptables
Observe: a remoção do endpoint do pod e o envio do SIGTERM não ocorrem sequencialmente, mas paralelamente. E devido ao fato de que o Ingress não recebe imediatamente a lista atualizada de Endpoints, novas solicitações de clientes serão enviadas ao pod, o que resultará em erros 500 durante a terminação do pod. (material mais detalhado sobre este assunto nós ). Para resolver esse problema, devemos utilizar as seguintes abordagens:
- Enviar no cabeçalho da resposta Connection: close (se se tratar de uma aplicação HTTP).
- Se não houver como fazer alterações no código, a seguir, o artigo descreve uma solução que permitirá processar as solicitações até o final do período gracioso.
Teoria. Como o NGINX e o PHP-FPM finalizam seus processos
NGINX
Vamos começar com o NGINX, pois com ele tudo é mais ou menos claro. Mergulhando na teoria, descobrimos que o NGINX possui um processo mestre e vários "workers" — que são processos filhos que lidam com as solicitações dos clientes. Existe uma opção conveniente: por meio do comando nginx -s finalizar processos ou em modo de fechamento rápido (fast shutdown) ou em shutdown gracioso (graceful shutdown). É evidente que estamos interessados na última opção.
Depois, tudo é simples: precisamos adicionar ao o comando que enviará o sinal para o shutdown gracioso. Isso pode ser feito no Deployment, na seção do contêiner:
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Agora, no momento em que o pod é encerrado, nos logs do contêiner NGINX veremos o seguinte:
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) received, shutting down
2018/01/25 13:58:31 [notice] 11#11: gracefully shutting down
E isso significará o que precisamos: o NGINX aguarda a conclusão das solicitações antes de encerrar o processo. No entanto, abaixo será discutido um problema comum que, mesmo com o comando nginx -s quit resulta em um encerramento incorreto do processo.
Nesse ponto, terminamos com o NGINX: pelo menos nos logs podemos ver que tudo está funcionando como deveria.
Como estão as coisas com o PHP-FPM? Como ele lida com o graceful shutdown? Vamos descobrir.
PHP-FPM
No caso do PHP-FPM, as informações são um pouco mais limitadas. Se nos basearmos no do PHP-FPM, ele explica que os seguintes sinais POSIX são aceitos:
-
SIGINT,SIGTERM— fechamento rápido (fast shutdown); -
SIGQUIT— fechamento gracioso (graceful shutdown, que é o que precisamos).
Os outros sinais não são necessários nessa tarefa, então passaremos a análise deles. Para encerrar o processo corretamente, será necessário escrever o seguinte preStop-hook:
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
À primeira vista, isso é tudo que é necessário para realizar o graceful shutdown em ambos os contêineres. No entanto, a tarefa é mais complexa do que parece. A seguir, examinaremos dois casos em que o graceful shutdown não funcionou, causando uma breve indisponibilidade do projeto durante o deploy.
Prática. Possíveis problemas com o graceful shutdown
NGINX
Antes de mais nada, é útil lembrar: além de executar o comando nginx -s quit há mais um aspecto que merece atenção. Enfrentamos o problema em que o NGINX, em vez de enviar o sinal SIGQUIT, ainda enviava SIGTERM, resultando em requisições que não eram finalizadas corretamente. Casos semelhantes podem ser encontrados, por exemplo, . Infelizmente, não conseguimos identificar a causa específica desse comportamento: havia suspeitas sobre as versões do NGINX, mas isso não se confirmou. A sintomatologia consistia em que, nos logs do contêiner NGINX, observámos as mensagens «open socket #10 left in connection 5», após o que o pod parava.
Podemos observar esse problema, por exemplo, nas respostas do Ingress que nos interessa:
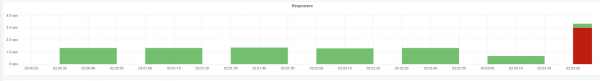
Os indicadores de status de código no momento do deploy
Neste caso, recebemos exatamente o código de erro 503 do próprio Ingress: ele não consegue acessar o contêiner NGINX, pois este já não está disponível. Se olharmos nos logs do contêiner com NGINX, encontraremos o seguinte:
[alert] 13939#0: *154 open socket #3 left in connection 16
[alert] 13939#0: *168 open socket #6 left in connection 13
Após a mudança do sinal de parada, o contêiner começa a parar corretamente: isso é confirmado pelo fato de que não observamos mais o erro 503.
Se você se deparar com um problema semelhante, vale a pena investigar qual sinal de parada está sendo utilizado no contêiner e como é o preStop hook. É bem possível que a causa esteja exatamente nisso.
PHP-FPM… e não só
O problema com PHP-FPM é descrito de forma trivial: ele não aguarda a conclusão dos processos filhos, os termina, resultando em erros 502 durante o deploy e outras operações. No bugs.php.net, desde 2005, existem várias postagens sobre erros (por exemplo, e ), que descrevem esse problema. E nos logs, você provavelmente não verá nada: o PHP-FPM anunciará a finalização de seu processo sem erros ou notificações externas.
Vale ressaltar que o próprio problema pode depender mais ou menos do próprio aplicativo e não se manifestar, por exemplo, na monitoração. Se você se deparar com isso, a princípio vem à mente uma solução simples: adicionar um preStop hook com sleep(30). Isso permitirá concluir todas as requisições que estavam pendentes (e não aceitamos novas, pois o pod já está em estado Terminating), e após 30 segundos o pod será finalizado com o sinal SIGTERM.
Assim, lifecycle para o contêiner ficará da seguinte forma:
    lifecycle:
      preStop:
        exec:
          command:
          - /bin/sleep
          - "30"
No entanto, devido à indicação de 30 segundos dormir nós realmente aumentaremos o tempo de implantação, uma vez que cada pod será terminado pelo menos 30 segundos, o que não é bom. O que pode ser feito a respeito?
Vamos nos voltar para a parte responsável pela execução direta do aplicativo. No nosso caso, isso é PHP-FPM, que por padrão não monitora a execução de seus processos filhos: o processo mestre é terminado imediatamente. Esse comportamento pode ser alterado usando a diretiva process_control_timeout, que especifica limites de tempo para a espera de sinais do mestre por processos filhos. Se um valor de 20 segundos for definido, isso cobrirá a maioria das requisições executadas no contêiner, e após a conclusão, o processo mestre será interrompido.
Com esse conhecimento, vamos voltar ao nosso último problema. Como mencionado, o Kubernetes não é uma plataforma monolítica: a interação entre seus diferentes componentes leva algum tempo. Isso é especialmente relevante quando consideramos a operação de Ingress e outros componentes relacionados, uma vez que, devido a esse atraso, é fácil obter um pico de erros 500 no momento da implantação. Por exemplo, um erro pode ocorrer na fase de envio de uma solicitação ao upstream, mas o "atraso temporal" na interação entre os componentes é bastante curto — menos de um segundo.
Portanto, em conjunto com a diretiva já mencionada process_control_timeout pode-se usar a seguinte construção para lifecycle:
lifecycle:
  preStop:
    exec:
      command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"]
Nesse caso, compensamos o atraso com o comando dormir e não aumentamos tanto o tempo de implantação: afinal, há uma diferença perceptível entre 30 segundos e um?.. Na verdade, o "trabalho principal" é feito justamente por process_control_timeout, e lifecycle é utilizado apenas como um "backup" em caso de atrasos.
De modo geral, o comportamento descrito e a solução correspondente não se aplicam apenas ao PHP-FPM. Uma situação semelhante pode ocorrer de alguma forma ao usar outras linguagens de programação/frameworks. Se não for possível corrigir o fechamento gracioso de outras maneiras — por exemplo, reescrevendo o código para que o aplicativo lide corretamente com os sinais de término — pode-se aplicar o método descrito. Embora não seja o mais bonito, funciona.
Prática. Teste de carga para verificar o funcionamento do pod.
Os testes de carga são uma das maneiras de verificar como um contêiner funciona, já que esse procedimento se aproxima das condições reais de operação, quando os usuários acessam o site. Para testar as recomendações acima, você pode utilizar : ele atende perfeitamente a todas as nossas necessidades. A seguir, apresentamos dicas e recomendações sobre como realizar os testes, com um exemplo prático — graças aos gráficos do Grafana e do próprio Yandex.Tank, com base na nossa experiência.
O mais importante aqui é verificar as mudanças de forma gradual. Após adicionar uma nova correção, inicie o teste e observe se os resultados mudaram em comparação com a execução anterior. Caso contrário, será difícil identificar soluções ineficazes e, a longo prazo, isso pode até trazer prejuízos (por exemplo, aumentar o tempo de deployment).
Outro ponto é observar os logs do contêiner durante sua terminação. Há registros de shutdown gracioso? Existem erros nos logs ao acessar outros recursos (por exemplo, ao contatar o contêiner PHP-FPM vizinho)? Erros do próprio aplicativo (como no caso mencionado acima com NGINX)? Espero que as informações introdutórias deste artigo ajudem a entender melhor o que acontece com o contêiner durante sua terminação.
Assim, a primeira execução do teste foi realizada sem lifecycle e sem diretivas adicionais para o servidor de aplicativos (process_control_timeout no PHP-FPM). O objetivo deste teste era identificar a quantidade aproximada de erros (e se eles existiam). Também é importante saber que o tempo médio de deployment de cada pod era de cerca de 5 a 10 segundos até atingir a condição de plena prontidão. Os resultados foram:
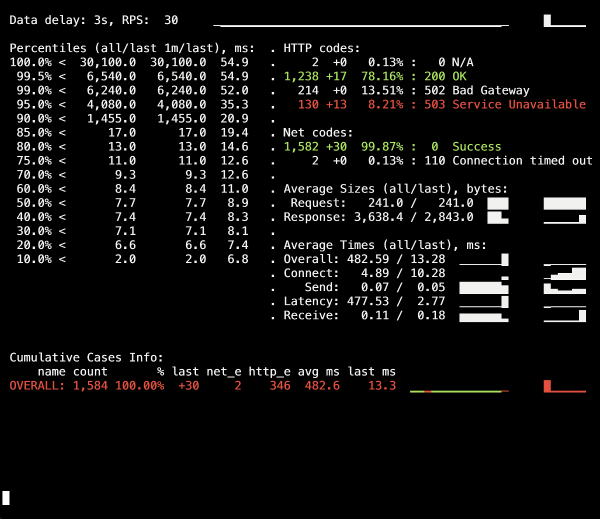
No painel informativo do Yandex.Tank, é visível um pico de erros 502, que ocorreu no momento do deployment e durou em média 5 segundos. Presumivelmente, isso se deveu a interrupções nas solicitações existentes para o pod antigo, enquanto ele estava sendo encerrado. Após isso, surgiram erros 503, resultado da parada do contêiner NGINX, que também interrompeu as conexões devido ao backend (fazendo com que o Ingress não conseguisse se conectar).
Vamos ver como process_control_timeout no PHP-FPM pode nos ajudar a esperar a conclusão dos processos filhos, ou seja, a corrigir esses erros. O redeployment já usando essa diretiva:
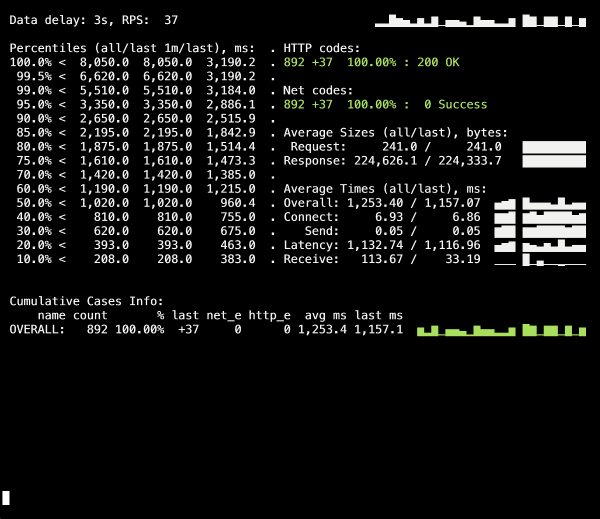
Durante o deploy, não há mais erros 500! O deploy é realizado com sucesso, e o graceful shutdown funciona.
No entanto, é importante lembrar o momento com os contêineres Ingress, onde podemos ter uma pequena porcentagem de erros devido a um atraso temporário. Para evitá-los, é necessário adicionar uma estrutura com dormir e repetir o deploy. Por outro lado, em nosso caso específico, não houve mudanças visíveis (novamente, sem erros).
Conclusão
Para que o processo seja concluído corretamente, esperamos que a aplicação apresente o seguinte comportamento:
- Esperar alguns segundos, após os quais deve parar de aceitar novas conexões.
- Aguardar a conclusão de todas as requisições e fechar todas as conexões keepalive que não estão sendo executadas.
- Encerrar seu processo.
No entanto, nem todas as aplicações sabem trabalhar dessa forma. Uma das soluções para o problema na realidade do Kubernetes é:
- adicionar um hook pre-stop que aguardará alguns segundos;
- analisar o arquivo de configuração do nosso backend em busca de parâmetros relevantes.
Um exemplo com NGINX permite entender que mesmo uma aplicação que originalmente deveria responder corretamente aos sinais de encerramento pode não fazê-lo, portanto, é crítico verificar a presença de erros 500 durante o deploy da aplicação. Isso também permite olhar para o problema de forma mais ampla e não focar em um único pod ou contêiner, mas sim na infraestrutura como um todo.
Como ferramenta para testes, pode-se usar o Yandex.Tank em conjunto com qualquer sistema de monitoramento (neste caso, os dados foram obtidos do Grafana com o backend em Prometheus). Problemas com graceful shutdown são bem visíveis sob grandes cargas que podem ser geradas pelo benchmark, e o monitoramento ajuda a detalhar a situação durante ou após o teste.
Respondendo ao feedback sobre o artigo: vale a pena esclarecer que os problemas e as soluções descritas aqui se aplicam ao NGINX Ingress. Para outros casos, há soluções diferentes, que talvez abordemos em futuros materiais da série.
P.S.
Outro da série K8s tips & tricks:
- «»;
- «»;
- «»;
- «».
Fonte: habr.com
