

Olá! Meu nome é Alexey Pyankov, sou desenvolvedor na empresa Sportmaster. Neste falei sobre como começou o trabalho no site da Sportmaster em 2012, quais iniciativas conseguimos "impulsionar" e, ao contrário, quais dificuldades encontramos.
Hoje eu quero compartilhar reflexões que acompanham uma outra história – a escolha do sistema de cache para o backend Java na administração do site. Essa história tem um significado especial para mim – embora tenha se desenrolado em apenas 2 meses, nesses 60 dias trabalhamos de 12 a 16 horas por dia, sem um único dia de folga. Nunca havia pensado ou imaginado que seria possível trabalhar tanto.
Por isso, dividi o texto em 2 partes, para não sobrecarregar demais. Ao contrário, a primeira parte será muito leve — uma preparação, uma introdução, algumas considerações sobre o que é caching. Se você já é um desenvolvedor experiente ou trabalhou com caches — do lado técnico, provavelmente não haverá nada de novo neste artigo. Mas para um júnior, uma pequena visão geral pode indicar a direção certa a seguir, se ele se encontrar em uma encruzilhada dessas.
Quando a nova versão do site da Sportmaster foi lançada em produção, os dados chegavam de uma maneira, digamos, não muito conveniente. A base era composta por tabelas preparadas para a versão anterior do site (Bitrix), que precisavam ser carregadas no ETL, convertidas para um novo formato e enriquecidas com várias adições de mais de uma dezena de sistemas. Para que uma nova imagem ou descrição do produto aparecesse no site, era necessário aguardar até o dia seguinte — a atualização ocorria apenas à noite, uma vez por dia.
No início, havia tantas preocupações nas primeiras semanas após o lançamento em produção que esses inconvenientes para os gerentes de conteúdo eram detalhes. Mas, assim que tudo se estabilizou, o desenvolvimento do projeto continuou — alguns meses depois, no início de 2015, começamos a desenvolver ativamente a administração. Em 2015 e 2016 tudo ia bem, fizemos lançamentos regularmente, a administração cobria uma parte cada vez maior da preparação dos dados e nos preparávamos para o que em breve nossa equipe receberia a tarefa mais importante e desafiadora – o fluxo de produtos (preparação completa e gestão de dados para todos os produtos). Mas no verão de 2017, logo antes do lançamento do fluxo de produtos, o projeto se encontrou em uma situação muito complicada – precisamente devido a problemas com o caching. Sobre esse episódio, quero falar na segunda parte desta publicação em duas partes.
Mas neste post, irei começar de longe, reunindo algumas ideias sobre caching, que discutir antes de um grande projeto seria uma boa abordagem.
Quando surge a necessidade de caching
A necessidade de caching não surge por acaso. Nós, desenvolvedores, criamos produtos de software e queremos que eles sejam procurados. Se o produto é desejado e bem-sucedido, os usuários começam a chegar. E eles continuam a chegar, e chegar, e então há muitos usuários, e o produto se torna de alta carga.
Nos primeiros estágios, não pensamos em otimização e desempenho de código. O que importa é a funcionalidade, lançar rapidamente uma versão piloto e testar hipóteses. E se a carga aumenta, melhoramos o hardware. Aumentamos duas, três, cinco, ou até dez vezes. Em algum ponto, as finanças não permitirão mais. E em quanto tempo o número de usuários crescerá? Não será apenas 2-5-10, mas no caso de sucesso, pode ser de 100 a 1000 e até 100 mil vezes. Ou seja, mais cedo ou mais tarde, será necessário lidar com a otimização.
Suponha que uma parte do código (vamos chamar essa parte de função) esteja levando um tempo inaceitável para ser executada, e queremos reduzir esse tempo. A função pode ser o acesso a um banco de dados, pode ser a execução de uma lógica complexa - o essencial é que o tempo de execução seja longo. Até onde podemos reduzir o tempo de execução? Em teoria, podemos reduzi-lo a zero, mas não além disso. E como podemos reduzir o tempo de execução a zero? A resposta: excluindo completamente a execução. Em vez disso, retornamos imediatamente o resultado. E como sabemos qual é o resultado? A resposta: ou calculamos, ou olhamos em algum lugar. Calcular é demorado. E olhar, por exemplo, é memorizar o resultado que a função retornou da última vez que foi chamada com os mesmos parâmetros.
Ou seja, a implementação da função não é importante para nós. Basta saber de quais parâmetros o resultado depende. Assim, se representarmos os valores dos parâmetros na forma de um objeto que pode ser usado como chave em algum armazenamento — podemos salvar o resultado do cálculo e na próxima vez que precisarmos, podemos recuperá-lo. Se essas operações de gravação e leitura do resultado forem mais rápidas do que a execução da função – obtemos lucro em termos de velocidade. O valor do lucro pode atingir 100, 1000 ou até 100 mil vezes (10^5 – isso é mais uma exceção, mas em caso de um banco de dados que está realmente lento – é bastante possível).
Requisitos principais para um sistema de cache
A primeira exigência que pode surgir para um sistema de cache é a rápida velocidade de leitura e, em menor medida, a velocidade de gravação. Isso é verdade, mas apenas até o momento em que colocamos o sistema em produção.
Vamos considerar um caso.
Suponha que já garantimos que o hardware suportaria a carga atual e agora estamos lentamente implementando o cache. O número de usuários aumenta um pouco, a carga cresce – adicionamos um pouco de cache, ajustamos aqui e ali. Isso continua por um tempo, e então funções pesadas já quase não são chamadas – toda a carga principal recai sobre o cache. O número de usuários aumentou N vezes nesse período.
E se a reserva inicial de hardware poderia ser de 2 a 5 vezes, então, com a ajuda do cache, poderíamos aumentar o desempenho em até 10 vezes ou, no melhor dos casos, até 100, em alguns casos, talvez até 1000. Ou seja, com o mesmo hardware – processamos 100 vezes mais requisições. Maravilha, merecemos um doce!
Mas agora, em um belo momento, acidentalmente, o sistema falhou e o cache colapsou. Nada de mais – afinal, escolhemos o cache com o requisito de "alta velocidade de leitura e gravação, o restante não é importante".
Em relação à carga inicial, a reserva de hardware era de 2-5 vezes, enquanto a carga aumentou de 10 a 100 vezes. Com o cache, eliminamos as chamadas para funções pesadas e, por isso, tudo funcionava perfeitamente. E agora, sem o cache – quão mais nossa sistema vai cair? O que acontecerá? O sistema vai travar.
Mesmo que nosso cache não tenha colapsado, mas apenas limpado por um tempo, ele precisará ser reaquecido, e isso levará algum tempo. E durante esse tempo – a carga principal recairá sobre a funcionalidade.
Resultado: projetos de alta carga em produção exigem um sistema de cache não apenas com alta velocidade de leitura e gravação, mas também com integridade de dados e resistência a falhas.
As dores da escolha
No projeto com o painel administrativo, a escolha foi assim: inicialmente instalamos o Hazelcast, pois já estávamos familiarizados com este produto pela experiência do site principal. Mas, essa escolha se mostrou infeliz - sob o nosso perfil de carga, o Hazelcast não apenas funciona lentamente, mas horrivelmente devagar. E quanto aos prazos de entrega em produção, já estávamos comprometidos na época.
Spoiler: como as circunstâncias se desenrolaram, que nos fez passar por esse percalço e chegar a uma situação crítica e tensa - conto na segunda parte - e como chegamos a isso, e como saímos. Mas agora - posso apenas dizer que foi um estresse grande, e "pensar - não se pensa, sacudimos a garrafa". "Sacudimos a garrafa" - isso também é um spoiler, sobre isso mais adiante.
O que fizemos:
- Elaboramos uma lista de todos os sistemas sugeridos pelo google e StackOverflow. Um pouco mais de 30.
- Escrevemos testes com uma carga característica de produção. Para isso, gravamos os dados que atravessam o sistema em um ambiente de produção - uma espécie de sniffer de dados não na rede, mas dentro do sistema. Nos testes, usamos exatamente esses dados.
- Toda a equipe, cada um escolhe o próximo sistema da lista, configura, roda os testes. Se o teste não passar, não suportar a carga - descartamos, passamos para o próximo da fila.
- Na 17ª sistema, ficou claro que tudo estava sem esperança. Chega de "sacudir a garrafa", é hora de pensar sério.
Mas essa é uma opção quando é preciso escolher um sistema que "passe na velocidade" nos testes previamente organizados. E se esses testes ainda não existem e queremos decidir mais rapidamente?
Modelaremos essa opção (é difícil imaginar que um desenvolvedor mid-level + viva em um vácuo, e no momento da escolha ainda não tenha decidido qual produto experimentar primeiro - portanto, as considerações seguintes são mais uma teoria / filosofia / sobre um júnior).
Depois de definir os requisitos, começaremos a escolher uma solução pronta. Por que reinventar a roda: vamos pegar um sistema de cache pronto.
Se você está começando e vai pesquisar, a ordem pode ser mais ou menos essa, mas, em geral, as referências serão as seguintes. Primeiro, você encontrará o Redis, que está em toda parte. Depois, saberá que existe o EhCache, como o sistema mais antigo e comprovado. Em seguida, será mencionado o Tarantool — um desenvolvimento local, que tem um aspecto único na solução. E também o Ignite, pois atualmente está em ascensão e recebe apoio do SberTech. Por fim, o Hazelcast, que aparece com frequência no mundo corporativo entre grandes empresas.
Essa lista não é exaustiva, existem dezenas de sistemas. Mas nós vamos nos concentrar apenas em um. Vamos pegar 5 sistemas selecionados para um 'concurso de beleza' e faremos uma seleção. Quem será o vencedor?
Redis
Vamos ler o que está escrito no site oficial.
— projeto opensource. Oferece um armazenamento de dados em memória, a possibilidade de salvar no disco, divisão automática em partições, alta disponibilidade e recuperação após quedas de rede.
Parece que está tudo ótimo, pode-se pegar e integrar — tudo o que é necessário, ele faz. Mas vamos olhar, apenas por curiosidade, para os outros candidatos.
EhCache
— 'o cache mais amplamente utilizado para Java' (tradução do slogan do site oficial). Também opensource. E aqui entendemos que o Redis não é específico para Java, mas é geral, e para interagir com ele é necessário um wrapper. O EhCache será mais conveniente. O que mais o sistema promete? Confiabilidade, veracidade, funcionalidade completa. E também é o mais comum. E ele cacheia terabytes de dados.
O Redis foi esquecido, estou pronto para escolher o EhCache.
Mas o sentimento de patriotismo me leva a olhar o que há de bom no Tarantool.
Tarantool
— se apresenta como 'Plataforma de Integração de Dados em Tempo Real'. Soa muito complicado, então vamos ler a página detalhadamente e encontramos uma declaração impressionante: 'Cacheia 100% dos dados na memória'. Isso deve levantar questões — pois os dados podem ser significativamente maiores do que a memória. A explicação é que, para gravar dados no disco a partir da memória, o Tarantool não passa pela serialização. Em vez disso, utiliza recursos de baixo nível do sistema, onde a memória é simplesmente mapeada no sistema de arquivos com índices de I/O muito bons. Em geral, foi feito de forma incrível e excelente.
Vamos olhar as implementações: Mail.ru, linha corporativa, Avito, Beeline, MegaFon, Alfa-Bank, Gazprom...
Se ainda havia alguma dúvida sobre o Tarantool, o caso de implementação no Mastercard me convenceu. Vou optar pelo Tarantool.
Mas mesmo assim…
Ignite
… ainda há , anunciado como uma «plataforma de computação in-memory… com velocidades in-memory em petabytes de dados». Aqui também há muitos benefícios: cache in-memory distribuído, o repositório de chave-valor e cache mais rápido, escalabilidade horizontal, alta disponibilidade, rigorosa integridade. No geral, o mais rápido é o Ignite.
Implementações: Sberbank, American Airlines, Yahoo! Japan. E depois descubro que o Ignite não está apenas implementado no Sberbank, mas a equipe do SberTech envia seus membros para a equipe do Ignite para aprimorar o produto. Isso realmente me convence e estou pronto para adotar o Ignite.
Totalmente incompreensível por que, vejo o quinto ponto.
Hazelcast
Acesso ao site , leio. E parece que a solução mais rápida para cache distribuído é o Hazelcast. Ele é várias vezes mais rápido que todas as outras soluções e, de fato, é o líder na área de grid de dados in-memory. Em comparação a isso, escolher outra coisa seria uma falta de respeito. Além disso, utiliza armazenamento redundante para operação contínua do cluster sem perda de dados.
Pronto, estou decidido a optar pelo Hazelcast.
Comparação
Mas ao observar, todos os cinco candidatos estão tão bem descritos que cada um deles é o melhor. Como escolher? Podemos verificar qual deles é o mais popular, procurar comparações e acabar com a dor de cabeça.
Encontramos um , escolhemos nossos 5 sistemas.
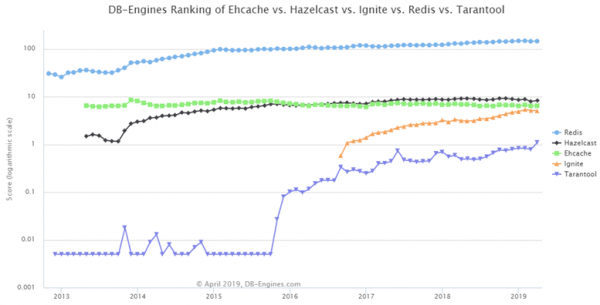
Aqui eles estão classificados: no topo está o Redis, em segundo lugar — Hazelcast, Tarantool e Ignite estão ganhando popularidade, e o EhCache permanece como estava.
Mas vamos olhar para o : links para websites, interesse geral no sistema, ofertas de emprego — ótimo! Ou seja, quando meu sistema falhar, direi: «Não, ele é confiável! Existem muitas ofertas de emprego…». Essa comparação simples não servirá.
Todos esses sistemas não são apenas sistemas de cache. Eles também possuem muitas funcionalidades, incluindo – quando não são os dados que são transferidos para o cliente para processamento, mas, ao contrário: o código que precisa ser executado sobre os dados é enviado ao servidor, é executado lá, e o resultado é retornado. Como sistemas separados de cache, não são frequentemente considerados.
Bem, não vamos desistir, vamos encontrar uma comparação direta dos sistemas. Vamos pegar as duas principais opções — Redis e Hazelcast. Estamos interessados na velocidade, e esse parâmetro será utilizado para a comparação.
Hz vs Redis
Encontramos um assim :
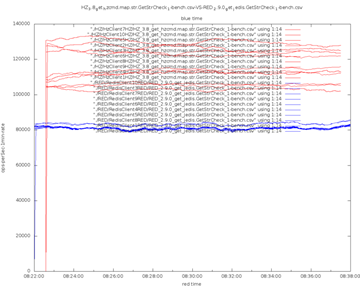
Azul é Redis, vermelho é Hazelcast. Hazelcast vence em todos os aspectos, e isso tem uma justificativa: é multithreaded, altamente otimizado, cada thread trabalha com sua partição, portanto não há bloqueios. Já Redis é single-threaded, não consegue aproveitar os modernos CPUs multicore. Hazelcast utiliza I/O assíncrono, enquanto Redis-Jedis usa sockets bloqueantes. No fim das contas, Hazelcast utiliza um protocolo binário, enquanto Redis é orientado a texto, ou seja, é ineficiente.
Para garantir, vamos consultar mais uma fonte de comparação. O que ela nos mostrará?
Redis vs Hz
Mais um :
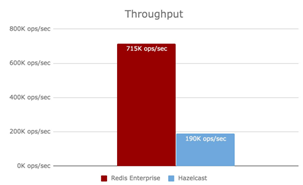
Aqui, ao contrário, vermelho é Redis. Ou seja, Redis tem melhor desempenho que Hazelcast. No primeiro comparação, Hazelcast venceu, na segunda, Redis. explicaram muito bem por que Hazelcast venceu na comparação anterior.
Aparentemente, o resultado do primeiro foi realmente manipulado: Redis foi utilizado na versão básica, enquanto Hazelcast foi otimizado para o caso de teste. Portanto, fica claro que: em primeiro lugar, não se pode confiar em ninguém, e em segundo lugar, quando finalmente escolhermos um sistema, ainda precisamos configurá-lo corretamente. Essas configurações envolvem dezenas, quase centenas de parâmetros.
Agitamos a garrafa
E todo o processo que acabamos de realizar, posso explicar com a metáfora "Agitamos a garrafa". Ou seja, neste momento, não é necessário programar, o principal é saber ler stackoverflow. E eu tenho em minha equipe uma pessoa, um profissional, que trabalha exatamente assim em momentos críticos.
O que ele faz? Ele vê algo que não está funcionando, percebe o stack trace, pega algumas palavras dele (quais, exatamente, isso é seu conhecimento no programa), busca no Google, encontra stackoverflow entre as respostas. Sem ler, sem refletir, entre as respostas à pergunta — ele escolhe algo que pareça mais com a frase "fazer isso e aquilo" (escolher essa resposta é seu talento, pois nem sempre é a resposta com mais curtidas), aplica, e observa: se algo mudou, ótimo. Se não mudou — retrocede. E repetimos a execução-verificação-busca. E, assim, de forma intuitiva, ele consegue que, após algum tempo, o código funcione. Ele não sabe por quê, não sabe o que fez, não consegue explicar. Mas! Essa coisa funciona. E o "incêndio foi apagado". Agora vamos entender o que fizemos. Quando o programa funciona — é muito mais fácil. E economiza significativamente tempo.
Este método é bem explicado através deste exemplo.
Há muito tempo, era muito popular montar um barco à vela dentro de uma garrafa. O barco é grande e frágil, e o pescoço da garrafa é muito estreito, não dá para empurrá-lo para dentro. Como montar isso?
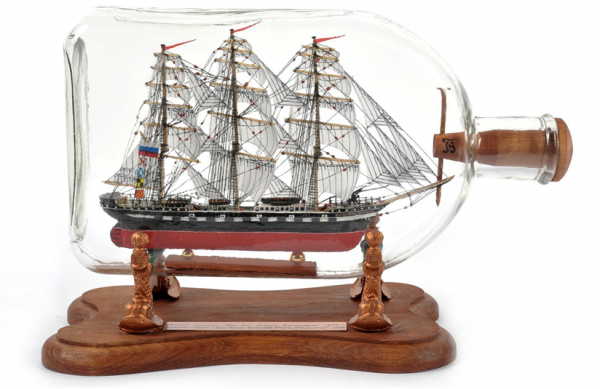
Existe um método, muito rápido e muito eficaz.
O barco consiste em várias pequenas partes: palitos, cordas, velas, cola. Colocamos tudo isso na garrafa.
Seguramos a garrafa com as duas mãos e começamos a chacoalhar. Agitamos, agitamos. E geralmente – acaba parecendo um desastre, claro. Mas às vezes. Às vezes parece um barco! Mais exatamente, algo que se assemelha a um barco.
Mostramos essa coisa para alguém: "Olha, Serguei, você vê!?". E de fato, à distância – parece um barco. Mas não podemos deixar isso assim.
Há outro método. Os caras mais avançados, os hackers, usam isso.
Dei uma tarefa para um desses caras, ele fez tudo e saiu. E você olha – parece estar feito. Mas depois de um tempo, quando é necessário aprimorar o código — começam a surgir problemas por causa dele... Felizmente, ele já tinha se afastado. Esse tipo de gente, que em exemplo da garrafa, faz assim: vê que onde fica o fundo – o vidro se curva. E não está tão claro se é transparente ou não. Então, os "hackers" cortam esse fundo, colocam o barco dentro, colam o fundo de volta, e parece que assim estava certo.
Do ponto de vista da formulação do problema, parece que tudo está certo. Mas no exemplo dos barcos: para que fazer esse barco, quem realmente precisa dele? A funcionalidade que ele oferece é nenhuma. Normalmente, esses barcos são presentes para pessoas de alto escalão, que os colocam em uma prateleira, como um símbolo, como um sinal. E se para uma dessas pessoas, um chefe de um grande negócio ou um funcionário de alta patente, estiver pendurado como bandeira uma coisa tão mal feita, onde o pescoço foi cortado? É melhor que ele nunca descubra isso. Então, como são feitos esses barcos que podem ser dados a uma pessoa importante?
O único aspecto, crucial, sobre o qual realmente não se pode fazer nada, é o casco. E o casco do navio passa exatamente pela boca da garrafa. Enquanto isso, o navio é montado fora da garrafa. Mas não é apenas montar o navio, é um verdadeiro trabalho artesanal. São adicionados componentes especiais que permitem levantá-los depois. Por exemplo, as velas são dobradas, cuidadosamente colocadas dentro e, em seguida, com a ajuda de pinças, são levantadas e ajustadas com precisão. O resultado é uma obra de arte que pode ser dada com a consciência tranquila e orgulhosamente.
E se quisermos que o projeto seja bem-sucedido, deve haver pelo menos uma pessoa-joalheiro na equipe. Alguém que se preocupa com a qualidade do produto e considera todos os aspectos, não sacrificando nada, mesmo em momentos de estresse, quando as circunstâncias exigem que se faça algo urgente em detrimento do importante. Todos os projetos bem-sucedidos, que são sustentáveis e resistiram ao teste do tempo, foram construídos com esse princípio. Há algo muito preciso e único neles, algo que utiliza todas as possibilidades disponíveis. No exemplo do navio na garrafa, brinca-se com o fato de que o casco do navio passa pela boca da garrafa.
Voltando à tarefa de escolher nosso servidor de cache, como esse método poderia ser aplicado? Eu sugiro uma maneira de escolha entre todos os sistemas disponíveis — não balançar a garrafa, não escolher, mas observar o que, em princípio, eles têm que deve ser considerado ao escolher um sistema.
Onde procurar o bottleneck
Vamos tentar não balançar a garrafa, não revisar tudo que temos um por um, mas observar quais problemas surgirão se, de repente, para a nossa tarefa — projetarmos um sistema assim por conta própria. Não construiremos uma bicicleta, mas utilizaremos este esquema para nos orientar sobre quais pontos observar nas descrições dos produtos. Vamos esboçar esse esquema.
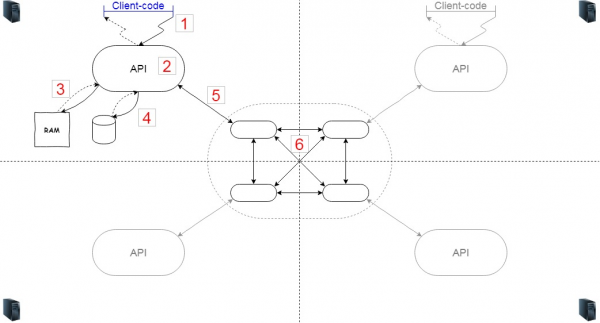
Se o sistema for distribuído, então teremos vários servidores (6). Suponhamos que quatro (é conveniente representá-los na imagem, mas, claro, pode haver quantos forem necessários). Se os servidores estão em diferentes nós, então um certo código está executado em todos eles, responsável por fazer esses nós formarem um cluster e, em caso de falha, se reconectarem e se reconhecerem.
Ainda precisamos de uma lógica de código (2) que se concentre no cache. Com este código, os clientes interagem através de uma determinada API. O código do cliente (1) pode estar dentro da mesma JVM ou se conectar a ele pela rede. A lógica implementada internamente decide quais objetos manter no cache e quais descartar. Para armazenar o cache, usamos a memória (3), mas se necessário, algumas informações também podem ser armazenadas em disco (4).
Vamos observar em quais partes a carga será gerada. Na verdade, cada conexão e cada nó sofrerão sobrecarga. Em primeiro lugar, entre o código do cliente e a API, caso haja interação pela rede, a latência pode ser bastante perceptível. Em segundo lugar, dentro da própria API – se exagerarmos na lógica complexa, podemos ter problemas de CPU. É melhor que a lógica não acesse a memória desnecessariamente. E ainda temos a interação com o sistema de arquivos – no caso normal, isso envolve serializar / restaurar e gravar / ler.
Em seguida, a interação com o cluster. Muito provavelmente, ele estará no mesmo sistema, mas também pode estar separado. Aqui também é necessário considerar a transferência de dados para ele, a velocidade de serialização de dados e a interação entre o cluster.
Agora, de um lado – podemos visualizar “quais engrenagens estarão girando” no sistema de cache ao processar solicitações do nosso código e, do outro lado – podemos estimar quantas e quais solicitações nosso código gerará para esse sistema. Isso é suficiente para fazer uma escolha mais ou menos racional – escolher um sistema que se adeque ao nosso caso de uso.
Hazelcast
Vamos ver como tal decomposição pode ser aplicada à nossa lista. Por exemplo, Hazelcast.
Para armazenar / buscar dados do Hazelcast, o código do cliente se dirige (1) à API. Hz permite iniciar o servidor como embutido, e nesse caso, a chamada à API é uma invocação de método dentro da JVM, podendo ser considerada gratuita.
Para que a lógica em (2) funcione, Hz se baseia no hash do array de bytes da chave serializada – ou seja, a serialização da chave ocorrerá de qualquer forma. Este é um overhead inevitável para Hz.
As estratégias de exclusão estão bem implementadas, mas para casos especiais – é possível conectar as suas próprias. Não é necessário se preocupar com essa parte.
O armazenamento (4) pode ser conectado. Excelente. A interação (5) para embarcados pode ser considerada instantânea. A troca de dados entre os nós no cluster (6) – sim, existe. Isso contribui para a resiliência em troca de velocidade. O recurso Hz Near-cache permite reduzir o custo – os dados obtidos de outros nós do cluster serão armazenados em cache.
O que pode ser feito nessas condições para aumentar a velocidade?
Por exemplo, para evitar a serialização da chave em (2) – adicionar mais um cache sobre o Hazelcast, para os dados mais quentes. A Sportmaster escolheu o Caffeine para esse fim.
Para ajustes no nível (6), o Hz oferece dois tipos de armazenamento: IMap e ReplicatedMap.
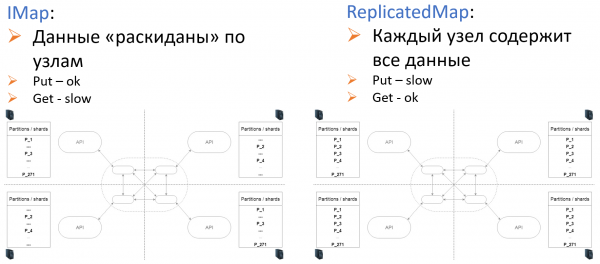
Vale a pena mencionar como o Hazelcast entrou na pilha de tecnologias da Sportmaster.
Em 2012, quando estávamos trabalhando no primeiro piloto do futuro site, o Hazelcast foi exatamente o primeiro link que o buscador retornou. O encontro aconteceu 'de cara' – ficamos impressionados que, apenas duas horas após integrar o Hz ao sistema, ele já estava funcionando. E funcionando bem. No final do dia, completamos alguns testes e ficamos satisfeitos. Essa energia foi suficiente para superar as surpresas que o Hz apresentou com o tempo. Atualmente, a equipe da Sportmaster não tem motivos para se afastar do Hazelcast.
Mas argumentos como 'primeiro link no buscador' e 'rápido para montar um HelloWorld' são, claro, exceções e características do momento em que a escolha foi feita. Os verdadeiros desafios para o sistema escolhido começam ao entrar em produção, e é exatamente nessa fase que devemos prestar atenção ao escolher qualquer sistema, incluindo caches. Na verdade, podemos dizer que escolhemos o Hazelcast por acaso, mas depois percebemos que fizemos a escolha certa.
Para produção, é muito mais importante: monitoramento, tratamento de falhas em nós individuais, replicação de dados, custo de escalonamento. Ou seja, devemos prestar atenção às tarefas que surgirã durante a manutenção do sistema – quando a carga exceder em dezenas de vezes o planejado, quando acidentalmente carregarmos algo errado e em um lugar errado, quando for necessário implementar uma nova versão do código, substituir dados e fazer isso de forma transparente para os clientes.
Para todas essas exigências, o Hazelcast é, sem dúvida, adequado.
Continua
Mas Hazelcast não é uma panaceia. Em 2017, escolhemos o Hazelcast para o cache no painel administrativo, simplesmente baseando-nos na boa impressão da experiência anterior. Isso teve um papel crucial em uma situação muito complicada, da qual conseguimos nos recuperar 'heroicamente' após 60 dias. Mas sobre isso, na próxima parte.
E por enquanto… Feliz Novo Código!
Fonte: habr.com
