

Eu publiquei no Github .
Esta é uma tabela hash simples para GPU, capaz de processar centenas de milhões de inserções por segundo. No meu laptop com NVIDIA GTX 1060, o código insere 64 milhões de pares chave-valor gerados aleatoriamente em cerca de 210 ms e remove 32 milhões de pares em cerca de 64 ms.
Ou seja, a velocidade no laptop é de aproximadamente 300 milhões de inserções/segundo e 500 milhões de remoções/segundo.
A tabela é escrita em CUDA, embora a mesma metodologia possa ser aplicada a HLSL ou GLSL. A implementação possui algumas limitações que garantem um alto desempenho na placa gráfica:
- Apenas chaves de 32 bits e valores de 32 bits são processados.
- A tabela hash tem um tamanho fixo.
- E esse tamanho deve ser uma potência de dois.
Para chaves e valores, é necessário reservar um marcador delimitador simples (no código fornecido, é 0xffffffff).
Tabela hash sem bloqueios
Na tabela hash, é usada endereçamento aberto com , ou seja, é simplesmente um array de pares chave-valor que é armazenado na memória e tem um desempenho de cache excepcional. Isso não pode ser dito sobre a vinculação em cadeia (chaining), que implica na busca de um ponteiro em uma lista encadeada. A tabela hash é um simples array que armazena elementos KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
O tamanho da tabela é uma potência de dois e não um número primo, porque para aplicar a máscara pow2/AND é suficiente uma única instrução rápida, enquanto o operador de módulo opera muito mais lentamente. Isso é importante no caso de sondagem linear, pois ao pesquisar linearmente na tabela, o índice do slot deve ser embrulhado em cada slot. E como resultado, o custo da operação de módulo é adicionado em cada slot.
A tabela armazena apenas a chave e o valor para cada elemento, e não o hash da chave. Como a tabela armazena apenas chaves de 32 bits, o hash é calculado muito rapidamente. O código fornecido utiliza o hash Murmur3, que realiza apenas alguns deslocamentos, XORs e multiplicações.
Na tabela hash, aplica-se uma técnica de proteção contra bloqueios que não depende da ordem de alocação na memória. Mesmo que algumas operações de escrita violem a sequência de outras operações desse tipo, a tabela hash ainda manterá um estado correto. Falaremos sobre isso abaixo. A técnica funciona muito bem com placas gráficas, onde milhares de threads são executadas de forma concorrente.
As chaves e valores na tabela hash são inicializados como vazios.
O código pode ser modificado para processar chaves e valores de 64 bits. Para as chaves, são necessárias operações atômicas de leitura, escrita e comparação com troca (compare-and-swap). Para os valores, são necessárias operações atômicas de leitura e escrita. Felizmente, no CUDA, as operações de leitura-escrita para valores de 32 e 64 bits são atômicas desde que estejam alinhadas naturalmente (veja ), e as placas gráficas modernas suportam operações atômicas de comparação com troca de 64 bits. Claro que, ao passar para 64 bits, o desempenho diminui um pouco.
Estado da tabela hash
Cada par chave-valor na tabela hash pode ter um dos quatro estados:
- A chave e o valor estão vazios. Neste estado, a tabela hash é inicializada.
- A chave foi gravada, mas o valor ainda não. Se outro fluxo de execução lê os dados nesse momento, ele retornará um valor vazio. Isso é normal; o mesmo aconteceria se outro fluxo de execução tivesse terminado um pouco antes, e estamos falando de uma estrutura de dados concorrente.
- Tanto a chave quanto o valor foram gravados.
- O valor está disponível para outros fluxos de execução, mas a chave ainda não. Isso pode acontecer porque o modelo de programação no CUDA implica um modelo de memória fracamente ordenado. É normal; em qualquer caso, a chave ainda está vazia, mesmo que o valor já não esteja.
Um ponto importante é que, assim que a chave for gravada em um slot, ela não se move mais — mesmo que a chave seja removida, falaremos sobre isso abaixo.
O código da tabela hash funciona mesmo com modelos de memória fracamente ordenados, onde não se conhece a ordem de leitura e escrita na memória. Quando analisarmos a inserção, busca e remoção na tabela hash, lembre-se de que cada par chave-valor está em um dos quatro estados descritos acima.
Inserção na tabela hash
A função CUDA que insere pares chave-valor na tabela hash é assim:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
Para inserir a chave, o código itera pelo array da tabela hash começando pelo hash da chave a ser inserida. Em cada slot do array, uma operação atômica de comparação e troca é realizada, onde a chave nesse slot é comparada com o vazio. Se houver uma discrepância, a chave no slot é atualizada para a chave a ser inserida, e então a chave original do slot é retornada. Se essa chave original era vazia ou correspondia à chave inserida, isso significa que o código encontrou um slot apropriado para inserção e insere o valor no slot.
Se em uma chamada do núcleo gpu_hashtable_insert() existem vários elementos com a mesma chave, então qualquer um dos seus valores pode ser gravado no slot da chave. Isso é considerado normal: uma das operações de gravação chave-valor durante a chamada será bem-sucedida, mas como tudo isso acontece em paralelo dentro de vários threads de execução, não podemos prever qual operação de gravação na memória será a última.
Busca na tabela hash
Código para buscar chaves:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
Para encontrar o valor de uma chave armazenada na tabela, iteramos pelo array começando pelo hash da chave procurada. Em cada slot, verificamos se a chave é a que estamos procurando e, se sim, retornamos seu valor. Também verificamos se a chave é vazia e, se sim, interrompemos a busca.
Se não conseguimos encontrar a chave, o código retorna um valor vazio.
Todas essas operações de busca podem ser realizadas concorrentemente durante inserções e deleções. Cada par na tabela terá um dos quatro estados descritos acima para o thread.
Remoção na tabela hash
Código para remover chaves:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
A remoção de uma chave é feita de forma incomum: deixamos a chave na tabela e marcamos seu valor (não a própria chave) como vazio. Este código é muito semelhante a lookup(), exceto que ao encontrar uma correspondência para a chave, ele torna seu valor vazio.
Como mencionado anteriormente, uma vez que a chave é registrada na slot, ela não se move mais. Mesmo ao remover um elemento da tabela, a chave permanece no lugar, apenas seu valor se torna vazio. Isso significa que não precisamos usar uma operação atômica para gravar o valor da slot, pois não importa se o valor atual é vazio ou não — ele se tornará vazio de qualquer forma.
Redimensionamento da tabela hash
O redimensionamento da tabela hash pode ser feito criando uma tabela maior e inserindo nela os elementos não vazios da tabela antiga. Eu não implementei essa funcionalidade porque queria manter o código simples. Além disso, em programas CUDA, a alocação de memória é frequentemente realizada no código host, não no núcleo CUDA.
No artigo descreve como modificar essa estrutura de dados protegida contra bloqueios.
Concorrência
Nos fragmentos de código acima, as funções gpu_hashtable_insert(), _lookup() e _delete() processam um par chave-valor por vez. Abaixo gpu_hashtable_insert(), _lookup() e _delete() processam um array de pares em paralelo, cada par em um fluxo de execução de GPU separado:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Uma tabela hash com proteção contra bloqueios suporta inserções, buscas e remoções concorrentes. Como os pares chave-valor sempre estão em um dos quatro estados, e as chaves não se movem, a tabela garante a correção mesmo durante o uso simultâneo de operações de diferentes tipos.
No entanto, se processarmos em paralelo um conjunto de inserções e remoções, e se o array de entrada contiver chaves duplicadas, não conseguiremos prever quais pares 'vencerão' — serão gravados na tabela hash por último. Digamos que chamamos o código de inserção com um array de pares A/0 B/1 A/2 C/3 A/4. Quando o código terminar, os pares B/1 e C/3 estarão garantidamente presentes na tabela, mas qualquer um dos pares A/0, A/2 ou A/4Isso pode ser um problema, ou pode não ser — tudo depende da aplicação. Você pode saber com antecedência que não há chaves duplicadas no array de entrada, ou pode não se importar com qual valor foi gravado por último.
Se isso for um problema para você, é necessário dividir os pares duplicados em diferentes chamadas de dispositivos CUDA. No CUDA, qualquer operação com uma chamada de kernel sempre é concluída antes da próxima chamada de kernel (pelo menos dentro do mesmo fluxo. Em fluxos diferentes, os kernels são executados em paralelo). Se no exemplo acima chamarmos um kernel com A/0 B/1 A/2 C/3, e outro com A/4, então a chave A receberá o valor 4.
Agora, vamos falar sobre se as funções lookup() e delete() devem usar um ponteiro simples (plain) ou um ponteiro variável (volatile) para o array de pares na tabela hash. afirma que:
O compilador pode otimizar operações de leitura e escrita na memória global ou compartilhada a seu critério... Essas otimizações podem ser desativadas usando a palavra-chave
volatile: ... qualquer referência a essa variável é compilada em uma instrução real de leitura ou escrita na memória.
Considerações de correção não exigem a aplicação de volatile. Se o fluxo de execução usar um valor em cache de uma operação de leitura anterior, isso significa que ele usará informações um pouco desatualizadas. Mas ainda assim, essas informações são do estado correto da tabela hash em um determinado momento da chamada do kernel. Se você precisa usar as informações mais recentes, pode aplicar um ponteiro volatile, mas então a performance diminuirá um pouco: pelos meus testes — ao remover 32 milhões de elementos, a velocidade caiu de 500 milhões de remoções/seg para 450 milhões de remoções/seg.
Desempenho
No teste de inserção de 64 milhões de elementos e remoção de 32 milhões deles, a competição entre std::unordered_map e a tabela hash para GPU é praticamente inexistente:
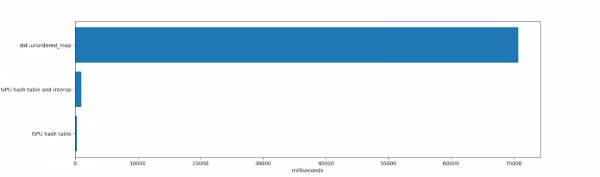
std::unordered_map levou 70.691 ms para inserir e remover elementos com subsequente liberação de unordered_map (a liberação de milhões de elementos leva tempo considerável, pois envolve várias alocações de memória). Honestamente, em unordered_map std:unordered_map std:unordered_map tudo diferentes limitações. É um único thread de execução de CPU, suporta chaves-valor de qualquer tamanho, funciona bem com altas taxas de utilização e mostra desempenho estável após múltiplas exclusões.
A duração da tabela hash para GPU e a interação entre programas foi de 984 ms. Isso inclui o tempo gasto para alocar a tabela na memória e sua exclusão (alocação única de 1 GB de memória, que leva algum tempo no CUDA), inserção e exclusão de elementos, bem como iteração sobre eles. Também foram considerados todas as cópias para a memória e da memória da placa de vídeo.
O funcionamento da própria tabela hash levou 271 ms. Isso inclui o tempo que a placa de vídeo gastou inserindo e excluindo elementos, e não considera o tempo de cópia para a memória e a iteração pela tabela resultante. Se a tabela GPU durar muito tempo, ou se a tabela hash estiver completamente na memória da placa de vídeo (por exemplo, para criar uma tabela hash que será usada por outro código GPU, e não pela CPU), então o resultado do teste é relevante.
A tabela hash para a placa de vídeo demonstra alto desempenho graças à grande largura de banda e ao paralelismo ativo.
Desvantagens
A arquitetura da tabela hash possui alguns problemas a serem lembrados:
- A agrupamento prejudica a sondagem linear, fazendo com que as chaves na tabela não sejam alocadas de forma ideal.
- As chaves não são removidas pela função
deletee com o tempo sobrecarregam a tabela.
Como resultado, o desempenho da tabela hash pode diminuir gradualmente, especialmente se existir por muito tempo e várias inserções e exclusões forem realizadas. Uma das formas de mitigar essas desvantagens é re-hashear para uma nova tabela com uma taxa de utilização suficientemente baixa e filtrar as chaves removidas durante o re-hashing.
Para ilustrar os problemas descritos, utilizarei o código acima para criar uma tabela com 128 milhões de elementos, inserindo ciclicamente 4 milhões de elementos até preencher 124 milhões de slots (taxa de utilização de cerca de 0,96). Aqui está a tabela de resultados, cada linha é uma chamada do kernel CUDA com a inserção de 4 milhões de novos elementos em uma tabela hash:
Taxa de utilização
Duração da inserção de 4 194 304 elementos
0,00
11,608448 ms (361,314798 milhões de chaves/seg.)
0,03
11,751424 ms (356,918799 milhões de chaves/seg.)
0,06
11,942592 ms (351,205515 milhões de chaves/seg.)
0,09
12,081120 ms (347,178429 milhões de chaves/seg.)
0,12
12,242560 ms (342,600233 milhões de chaves/seg.)
0,16
12,396448 ms (338,347235 milhões de chaves/seg.)
0,19
12,533024 ms (334,660176 milhões de chaves/seg.)
0,22
12,703328 ms (330,173626 milhões de chaves/seg.)
0,25
12,884512 ms (325,530693 milhões de chaves/seg.)
0,28
13,033472 ms (321,810182 milhões de chaves/seg.)
0,31
13,239296 ms (316,807174 milhões de chaves/seg.)
0,34
13,392448 ms (313,184256 milhões de chaves/seg.)
0,37
13,624000 ms (307,861434 milhões de chaves/seg.)
0,41
13,875520 ms (302,280855 milhões de chaves/seg.)
0,44
14,126528 ms (296,909756 milhões de chaves/seg.)
0,47
14,399328 ms (291,284699 milhões de chaves/seg.)
0,50
14,690304 ms (285,515123 milhões de chaves/seg.)
0,53
15,039136 ms (278,892623 milhões de chaves/seg.)
0,56
15,478656 ms (270,973402 milhões de chaves/seg.)
0,59
15,985664 ms (262,379092 milhões de chaves/seg.)
0,62
16,668673 ms (251,627968 milhões de chaves/seg.)
0,66
17,587200 ms (238,486174 milhões de chaves/seg.)
0,69
18,690048 ms (224,413765 milhões de chaves/seg.)
0,72
20,278816 ms (206,831789 milhões de chaves/seg.)
0,75
22,545408 ms (186,038058 milhões de chaves/seg.)
0,78
26,053312 ms (160,989275 milhões de chaves/seg.)
0,81
31,895008 ms (131,503463 milhões de chaves/seg.)
0,84
42,103294 ms (99,619378 milhões de chaves/seg.)
0,87
61,849056 ms (67,815164 milhões de chaves/seg.)
0,90
105,695999 ms (39,682713 milhões de chaves/seg.)
0,94
240,204636 ms (17,461378 milhões de chaves/seg.)
À medida que o coeficiente de utilização aumenta, o desempenho diminui. Isso é indesejável na maioria dos casos. Se o aplicativo insere elementos em uma tabela e depois os descarta (por exemplo, ao contar palavras em um livro), isso não é um problema. Mas se o aplicativo utiliza uma tabela hash de longa duração (por exemplo, em um editor gráfico para armazenar partes não vazias de imagens, quando o usuário frequentemente insere e remove informações), esse comportamento pode causar transtornos.
E medi a profundidade de sondagem da tabela hash após 64 milhões de inserções (coeficiente de utilização 0,5). A profundidade média foi de 0,4774, então a maioria das chaves estava em um dos melhores slots possíveis, ou em um slot de distância da melhor posição. A profundidade máxima de sondagem foi de 60.
Em seguida, medi a profundidade de sondagem em uma tabela com 124 milhões de inserções (coeficiente de utilização 0,97). A profundidade média já era de 10,1757, e o máximo foi 6474 (!!). O desempenho da sondagem linear cai drasticamente em altos coeficientes de utilização.
É melhor manter um baixo fator de utilização nesta tabela hash. Mas então aumentamos o desempenho em troca do consumo de memória. Felizmente, no caso de chaves e valores de 32 bits, isso pode ser justificado. Se, no exemplo acima, a tabela com 128 milhões de elementos mantiver um fator de utilização de 0,25, então poderemos armazenar não mais do que 32 milhões de elementos, e os outros 96 milhões de slots serão perdidos — a 8 bytes por par, 768 MB de memória perdida.
Observe que estamos falando sobre a perda de memória da placa de vídeo, que é um recurso mais valioso do que a memória do sistema. Embora a maioria das placas de vídeo modernas para desktops que suportam CUDA tenha pelo menos 4 GB de memória (neste momento, a NVIDIA 2080 Ti tem 11 GB), ainda assim perder esses volumes não será a melhor decisão.
Mais tarde, escreverei mais sobre a criação de tabelas hash para placas de vídeo que não têm problemas com profundidade de sondagem, bem como sobre maneiras de reutilizar slots removidos.
Medindo a profundidade de sondagem
Para determinar a profundidade de sondagem da chave, podemos extrair o hash da chave (seu índice ideal na tabela) de seu índice real na tabela:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
Devido à mágica de dois números binários em complemento de dois e ao fato de que a capacidade da tabela hash é igual a potência de dois, essa abordagem funcionará mesmo quando o índice da chave for transferido para o início da tabela. Vamos pegar uma chave que é hashed para 1, mas inserida no slot 3. Então, para uma tabela com capacidade 4, teremos (3 — 1) & 3, o que equivale a 2.
Conclusão
Se você tiver dúvidas ou comentários, escreva para mim em ou abra um novo tópico em.
Este código foi escrito sob a inspiração de ótimos artigos:
No futuro, continuarei a escrever sobre implementações de tabelas hash para placas de vídeo e analisarei seu desempenho. Estou planejando encadeamento, hashing de Robin Hood e hashing de cuco usando operações atômicas em estruturas de dados que são convenientes para placas de vídeo.
Fonte: habr.com
