

O canário é um pequeno pássaro que canta constantemente. Essas aves são sensíveis ao metano e ao monóxido de carbono. Mesmo com uma concentração baixa de gases desnecessários no ar, elas desmaiam ou morrem. Os garimpeiros e mineiros levavam pássaros para as minas: enquanto os canários cantavam, eles podiam trabalhar; se parassem de cantar, havia gás na mina e era hora de sair. Os mineiros sacrificavam o pequeno pássaro para conseguir escapar das minas vivos.
Essa prática também encontrou espaço na TI. Por exemplo, na tarefa padrão de implantar uma nova versão de serviço ou aplicativo em produção, com testes anteriores. O ambiente de testes pode ser muito caro, testes automatizados não cobrem tudo que gostaríamos e não testar e sacrificar a qualidade é arriscado. É exatamente em tais casos que a abordagem de Canary Deployment é útil, quando um pequeno tráfego real de produção é direcionado para a nova versão. A abordagem ajuda a verificar a nova versão em produção, sacrificando pouco por um grande objetivo. Mais detalhes sobre como a abordagem funciona, quais são seus benefícios e como implementá-la serão fornecidos por Andrey Markelov Andrey_V_Markelov (— engenheiro-chefe na Infobip, com 11 anos de experiência em desenvolvimento de aplicativos em Java nas áreas de finanças e telecomunicações. Desenvolve produtos de código aberto, participa ativamente da Atlassian Community e cria plugins para produtos da Atlassian. Evangelista do Prometheus, Docker e Redis.
Andrey_V_Markelov Sobre a empresa Infobip
É uma plataforma de telecomunicações global que permite a bancos, varejistas, lojas online e empresas de transporte enviar mensagens a seus clientes por meio de SMS, push, e-mails e mensagens de voz. Em um negócio como esse, a estabilidade e confiabilidade são essenciais para que os clientes recebam as mensagens em tempo hábil.
A infraestrutura de TI da Infobip em números:
15 data centers ao redor do mundo;
- 500 serviços únicos em operação;
- 2500 instâncias de serviços, muito mais do que equipes;
- 4,5 TB de tráfego mensal;
- 4,5 bilhões de números de telefone;
- Os negócios estão crescendo, assim como a quantidade de lançamentos. Realizamos cerca de
60 lançamentos por dia, porque os clientes desejam mais funcionalidades e capacidades. Mas isso é complicado — há muitos serviços e poucas equipes. Precisamos escrever código rapidamente, que deve funcionar em produção sem erros., porque os clientes desejam mais recursos e capacidades. Mas isso é difícil — há muitos serviços e poucas equipes. É necessário escrever rapidamente o código que deve funcionar em produção sem erros.
Lançamentos
Um lançamento típico para nós ocorre assim. Por exemplo, temos os serviços A, B, C, D e E, cada um deles desenvolvido por uma equipe separada.
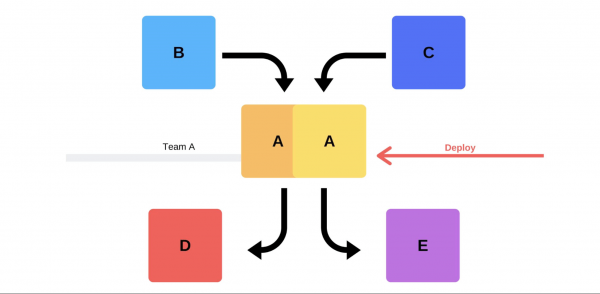
Em algum momento, a equipe do serviço A decide implantar uma nova versão, mas as equipes dos serviços B, C, D e E não sabem disso. Existem duas opções para a equipe do serviço A.
Fazer um lançamento incremental: primeiro substituir uma versão, depois a outra.
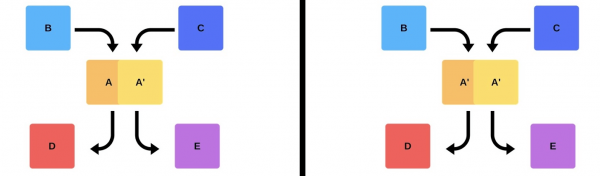
Mas há uma segunda opção: a equipe encontrará recursos adicionais e máquinas, implantará a nova versão e depois mudará o roteador, e a versão começará a funcionar em produção.
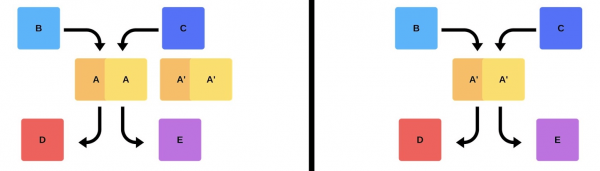
De qualquer forma, após a implantação, quase sempre surgem problemas, mesmo que a versão tenha sido testada. Os testes podem ser feitos manualmente, de forma automatizada, ou nem ser feitos — os problemas surgirão de qualquer maneira. A maneira mais simples e correta de resolvê-los é reverter para uma versão funcionando. Depois, podemos lidar com os danos, as causas e corrigi-los.
Então, o que queremos?
Não precisamos de problemas. Se os clientes os descobrirem mais rápido do que nós, isso afetará nossa reputação. Portanto, devemos identificar problemas mais rápido do que os clientes.Ao trabalhar proativamente, minimizamos os danos.
Ao mesmo tempo, queremos agilizar a implantação, para que isso aconteça de forma rápida, fácil, automática e sem estresse para a equipe. Devemos valorizar engenheiros, engenheiros DevOps e programadores — o lançamento de uma nova versão é estressante. A equipe não é um recurso descartável; buscamos utilizar os recursos humanos de forma racional..
Problemas na implantação
O tráfego de clientes é imprevisível.. É impossível prever quando o tráfego de clientes será o menor. Não sabemos onde e quando os clientes iniciarão suas campanhas — pode ser hoje à noite na Índia, e amanhã em Hong Kong. Considerando a grande diferença de fuso horário, implantar mesmo às 2 da manhã não garante que os clientes não serão afetados.
Problemas com provedores. Mensageiros e provedores são nossos parceiros. Às vezes, eles enfrentam falhas que causam erros durante a implantação de novas versões.
Equipes distribuídas.As equipes que desenvolvem a parte do cliente e o backend estão em diferentes fusos horários. Por causa disso, muitas vezes não conseguem se comunicar entre si.
Data centers não podem ser replicados em staging.. Em um data center há 200 racks — replicar isso no ambiente de testes nem de longe será possível.
Tempo de inatividadenão é aceitável! Temos um nível aceitável de disponibilidade (Error Budget), quando operamos 99,99% do tempo, por exemplo, e os restantes porcentagens são 'direitos ao erro'. Alcançar 100% de confiabilidade é impossível, mas é importante monitorar constantemente quedas e interrupções.
Opções clássicas de solução
Escrever código sem bugs. Quando eu era um jovem desenvolvedor, gerentes vinham até mim pedindo para fazer um release sem bugs, mas isso nem sempre é possível.
Escrever testes. Testes funcionam, mas às vezes não da maneira que o negócio deseja. Fazer dinheiro não é a tarefa dos testes.
Testar no estágio. Nos 3,5 anos em que trabalhei na Infobip, nunca vi o estado do estágio coincidir, nem que seja parcialmente, com a produção.
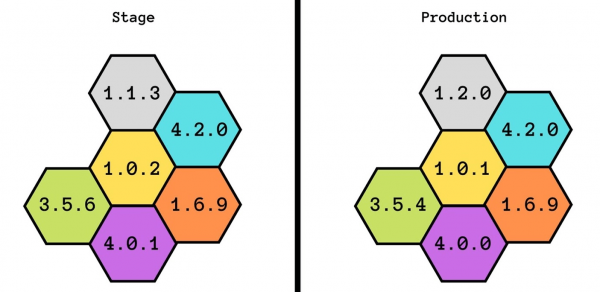
Até tentamos desenvolver essa ideia: primeiro tínhamos um estágio, depois pré-produção, e então pré-produção da pré-produção. Mas isso também não ajudou — eles não coincidiam nem em capacidade. Com o estágio, podemos garantir a funcionalidade básica, mas não sabemos como ela se comportará sob carga.
O release é feito por quem desenvolveu. É uma boa prática: mesmo que alguém mude o nome de um comentário, deve adicionar imediatamente na produção. Isso ajuda a desenvolver responsabilidade e não esquecer as mudanças feitas.
Existem também complexidades adicionais. Para o desenvolvedor, é estressante gastar muito tempo verificando tudo manualmente.
Lançamentos acordados. Esta opção é geralmente proposta pela gestão: 'Vamos concordar que todos os dias vocês vão testar e adicionar novas versões'. Isso não funciona: sempre há uma equipe que espera por todas as outras ou vice-versa.
Smoke-tests
Mais uma forma de resolver nossos problemas de deploy. Vamos considerar como os smoke-tests funcionam no exemplo anterior, quando a equipe A quer fazer o deploy de uma nova versão.
Primeiro, a equipe faz o deploy de uma instância na produção. Mensagens na instância de mocks simulam o tráfego real, para coincidir com o tráfego diário normal. Se tudo estiver bem, a equipe ativa a nova versão no tráfego real dos usuários.
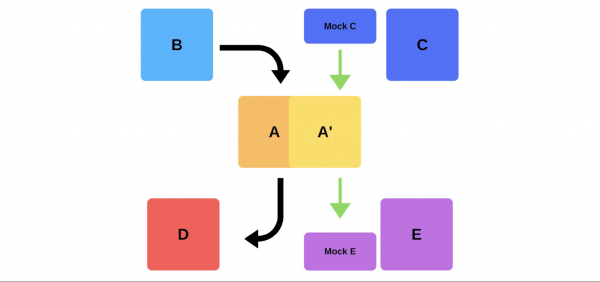
A segunda opção é fazer o deploy com hardware adicional. A equipe testa na produção, depois ativa, e tudo funciona.
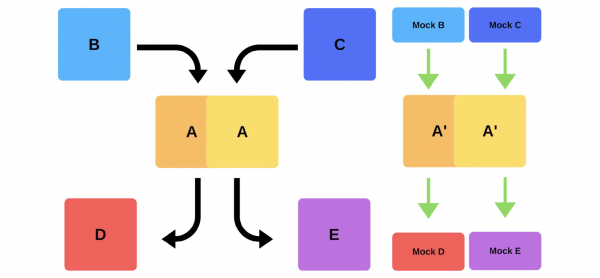
Desvantagens dos smoke-tests:
- Não se pode confiar em testes. Onde conseguir o mesmo tráfego que na produção? Pode-se usar o tráfego de ontem ou de uma semana atrás, mas nem sempre ele corresponde ao atual.
- Difícil de manter. Será necessário manter contas de teste, redefini-las constantemente antes de cada implementação, quando registros ativos são enviados para o armazenamento. Isso é mais complicado do que escrever um teste no seu próprio ambiente.
O único bônus aqui é que é possível verificar a performance.
Lançamentos canário
Devido às desvantagens dos testes smoke, começamos a usar lançamentos canário.
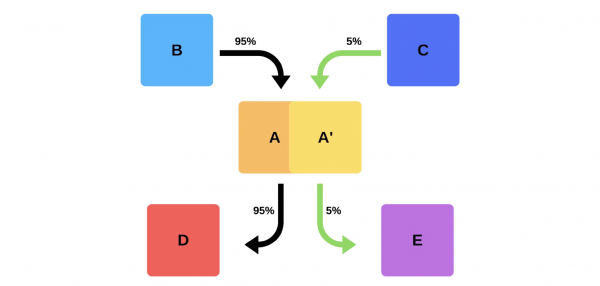
A prática, semelhante à forma como os mineiros usavam canários para indicar níveis de gases, também encontrou seu espaço na TI. Estamos lançando um pouco de tráfego real de produção na nova versão, enquanto tentamos manter o cumprimento do Service Level Agreement (SLA). O SLA é o nosso 'direito ao erro', que podemos utilizar uma vez por ano (ou em outro intervalo de tempo). Se tudo correr bem, adicionaremos mais tráfego. Se não, reverteremos para as versões anteriores.
Implementação e nuances
Como implementamos lançamentos canário? Por exemplo, um grupo de clientes envia mensagens através do nosso serviço.
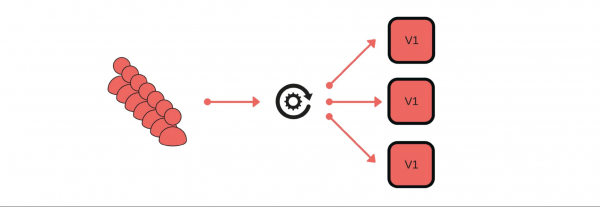
O deployment acontece assim: removemos um nó do balanceador (1), mudamos a versão (2) e, separadamente, enviamos um pouco de tráfego (3).
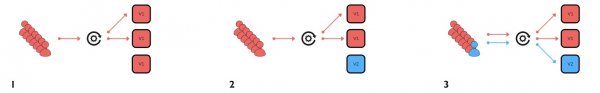
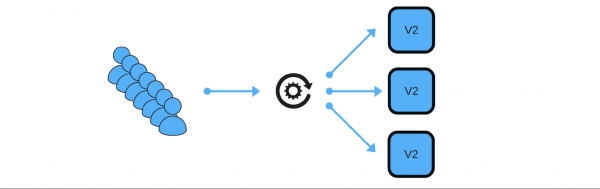
De modo geral, no grupo ficará todo mundo feliz, mesmo que um usuário não esteja satisfeito. Se tudo estiver bem, mudamos todas as versões.
Vou mostrar esquematicamente como isso se parece para microsserviços na maioria dos casos.
Há Service Discovery e mais dois serviços: S1N1 e S2. O primeiro serviço (S1N1) notifica o Service Discovery quando inicia, e o Service Discovery o registra. O segundo serviço, com dois nós (S2N1 e S2N2), também notifica o Service Discovery ao iniciar.
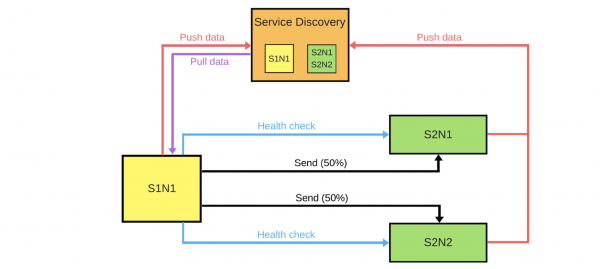
O segundo serviço para o primeiro atua como servidor. O primeiro solicita ao Service Discovery informações sobre seus servidores e, quando recebe, busca e verifica-os ('health check'). Após a verificação, envia mensagens para eles.
Quando alguém deseja implantar uma nova versão do segundo serviço, ele informa ao Service Discovery que o segundo nó será um nó canário: para ele será enviado menos tráfego, pois uma implantação acontecerá. Removemos o nó canário do balanceador e o primeiro serviço não envia tráfego para ele.
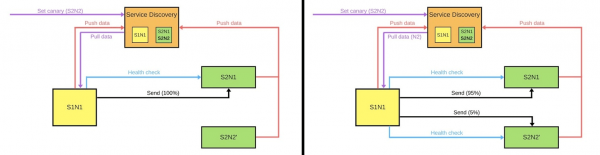
Alteramos a versão e o Service Discovery sabe que o segundo nó agora é canary — podemos dar a ele uma carga menor (5%). Se tudo correr bem, alteramos a versão, restauramos a carga e continuamos.
Para realizar tudo isso, precisamos:
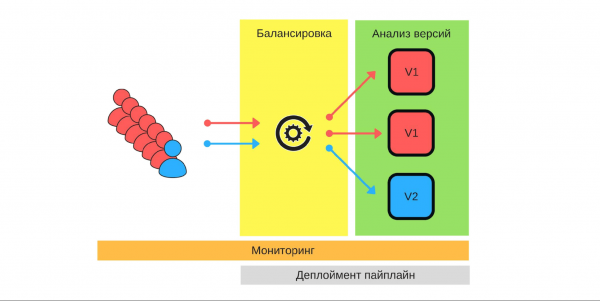
- balanceamento;
- monitoramento, pois é importante saber o que cada usuário espera e como nossos serviços funcionam detalhadamente;
- análise de versões, para entender quão bem a nova versão funcionará em produção;
- automação — escribemos a sequência de implantação (deployment pipeline).
Balanceamento
Esse é o primeiro ponto que devemos considerar. Existem duas estratégias de balanceamento.
A opção mais simples é quando um nó é sempre canary. Este nó sempre recebe menos tráfego e começamos a implantação por ele. Em caso de problemas, comparamos seu desempenho antes e durante a implantação. Por exemplo, se o número de erros dobrou, então o prejuízo também aumentou em duas vezes.
O nó canary é definido durante o processo de implantação. Quando a implantação terminar e removermos seu status de nó canary, o balanceamento de tráfego será restaurado. Com menos máquinas, teremos uma distribuição justa.
Monitoramento
Uma pedra angular dos lançamentos canary. Precisamos entender claramente por que estamos fazendo isso e quais métricas queremos coletar.
Exemplos de métricas que coletamos de nossos serviços.
- Número de erros, que são registrados nos logs. Este é um indicador óbvio de que tudo está funcionando como deveria. Em geral, é uma boa métrica.
- Tempo de execução das requisições (latência). Esta métrica é monitorada por todos, pois todos querem trabalhar rapidamente.
- Tamanho da fila (throughput).
- Número de respostas bem-sucedidas por segundo.
- Tempo de execução de 95% de todas as requisições.
- Métricas de negócios: quanto dinheiro o negócio ganha durante um determinado período ou a taxa de churn de usuários. Essas métricas para nossa nova versão podem ser mais importantes do que aquelas que os engenheiros adicionam.
Exemplos de métricas na maioria dos sistemas de monitoramento populares.
Contador. É um certo valor crescente, por exemplo, o número de erros. Essa métrica é fácil de interpolar e estudar no gráfico: ontem houve 2 erros e hoje 500, então algo deu errado.
O número de erros por minuto ou por segundo é uma métrica crucial que pode ser calculada usando o Counter. Esses dados fornecem uma visão clara do desempenho do sistema ao longo do tempo. Vamos considerar o gráfico do número de erros por segundo para duas versões do sistema em produção.
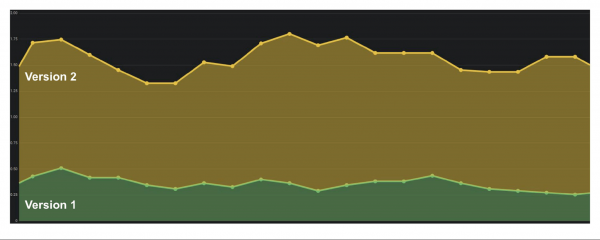
Na primeira versão, havia poucos erros, possivelmente porque a auditoria não estava funcionando. Na segunda versão, tudo piorou muito. Podemos afirmar com certeza que existem problemas e, portanto, precisamos reverter essa versão.
Gauge. As métricas são semelhantes ao Counter, mas registramos valores que podem aumentar ou diminuir. Por exemplo, o tempo de execução de consultas ou o tamanho da fila.
No gráfico, temos um exemplo do tempo de resposta (latência). O gráfico mostra que as versões são semelhantes e que podem ser trabalhadas. Mas se olharmos de perto, notamos como a magnitude muda. Se o tempo de execução das consultas aumenta com a adição de usuários, é evidente que há problemas — isso não acontecia antes.
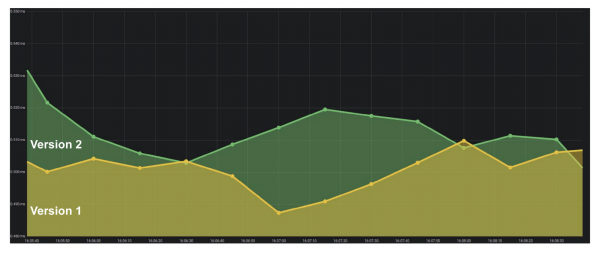
Resumo. Um dos indicadores mais importantes para os negócios são os percentis. A métrica mostra que em 95% dos casos o nosso sistema funciona como desejamos. Podemos aceitar que há problemas em alguns lugares porque entendemos a tendência geral, quão bem ou mal as coisas estão.
Ferramentas
ELK Stack. A canary pode ser implementada usando o Elasticsearch — registramos nele os erros quando ocorrem eventos. Com uma simples chamada de API, é possível obter o número de erros em qualquer momento e comparar com períodos anteriores: GET /applg/_cunt?q=level:errr.
Prometheus. Desempenhou bem na Infobip. Ele permite implementar métricas multidimensionais, pois utiliza labels.
Podemos usar level, instance, serviço, combiná-los em um único sistema. Com offset podemos verificar, por exemplo, o valor da magnitude uma semana atrás com apenas um comando GET /api/v1/query?query={query}, onde {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Análise de versões
Existem várias estratégias para análise de versões.
Monitorar métricas apenas da canary node. Uma das opções mais simples: implantamos uma nova versão e analisamos apenas seu desempenho. Mas se um engenheiro começa a verificar os logs constantemente, recarregando páginas com nervosismo, essa solução não é diferente das outras.
A canary node é comparada com qualquer outro node.Esta comparação é com outras instâncias que operam com tráfego total. Por exemplo, se com tráfego reduzido a situação é pior ou não melhor do que em instâncias reais, então algo está errado.
O nó canary é comparado a si mesmo no passado. Os nós designados para canary podem ser comparados com dados históricos. Por exemplo, se tudo estava bem há uma semana, podemos usar esses dados para entender a situação atual.
Automação
Queremos liberar os engenheiros da comparação manual, por isso é importante implementar a automação. O processo de deploy geralmente se parece com isto:
- começamos;
- removemos o nó do balanceador;
- colocamos o nó canary;
- ativamos o balanceador já com quantidade limitada de tráfego;
- comparamos.
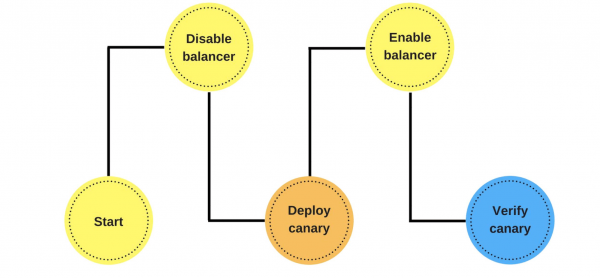
Neste estágio, implementamos a comparação automática. Como isso pode ser, e por que é melhor do que a verificação após o deploy, vamos considerar com um exemplo do Jenkins.
Este é um pipeline em Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary falhou, é necessário reverter"
        return false
    }
}
Aqui no loop estipulamos que iremos comparar o novo nó durante uma hora. Se o processo canary ainda não terminou — chamamos a função. Ela informa se está tudo bem ou não: def isOk = compare(srv, canary, time, base, offset, metrics).
Se tudo estiver bem — sleep DEFAULT SLEEP, por exemplo, por um segundo, e continuamos. Se não, saímos — o deploy falhou.
Descrição da métrica. Vamos ver como pode parecer a função compare como um exemplo de DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Suponha que estamos comparando a quantidade de erros e queremos saber a quantidade de erros por segundo nos últimos 5 minutos.
Temos dois valores: o base e o do nó canary. O valor do nó canary é o atual. O base é baseValue — este é o valor de qualquer outro nó que não seja canary. Comparamos os valores entre si pela fórmula que estabelecemos com base em nossa experiência e observações. Se o valor canaryValue for ruim, então o deploy falhou e fazemos o rollback.
Por que tudo isso é necessário?
Uma pessoa não pode verificar centenas e milhares de métricas., e ainda mais rápido. A comparação automática ajuda a verificar todas as métricas e avisa rapidamente sobre problemas. O tempo de notificação é crítico: se algo aconteceu nos últimos 2 segundos, o dano será menor do que se tivesse ocorrido 15 minutos atrás. Enquanto alguém percebe o problema, escreve para o suporte, e o suporte nos ajuda a reverter, podemos perder clientes.
Se o processo foi concluído e tudo funcionou bem, fazemos o deploy de todas as outras nos automaticamente. Nesse momento, os engenheiros não fazem nada. Somente quando eles iniciam o canary, decidem quais métricas considerar, quanto tempo levar a comparação e qual estratégia usar.
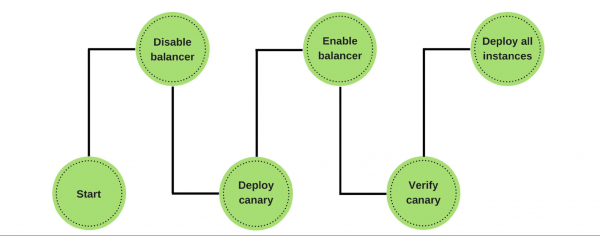
Se surgirem problemas — revertamos automaticamente o nó canary, trabalhamos com versões anteriores e corrigimos os erros que encontramos. Com as métricas, é fácil localizar e identificar o dano da nova versão.
Obstáculos
Implementar isso, é claro, não é simples. Primeiro de tudo, precisamos de uma sistema de monitoramento unificado. Os engenheiros têm suas métricas, o suporte e os analistas têm outras, e os negócios contam com um terceiro conjunto. Um sistema unificado é a linguagem comum entre negócios e desenvolvimento.
Precisamos testar na prática a estabilidade das métricas. A verificação ajuda a entender qual é o conjunto mínimo de métricas necessário para garantir a qualidade..
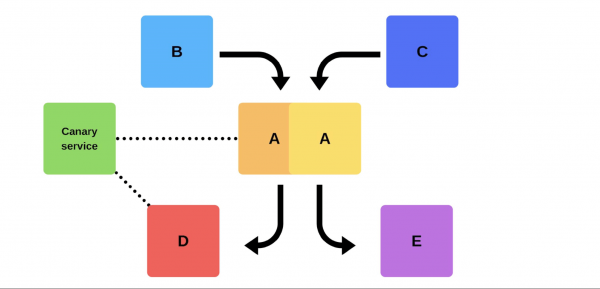
Como alcançar isso? Utilizar o serviço canary não no momento do deploy. Adicionamos um serviço na versão antiga que a qualquer momento pode assumir um nó dedicado, diminuir o tráfego sem fazer o deploy. Depois, comparamos: analisamos os erros e buscamos a linha em que alcançamos a qualidade.
Que benefícios obtivemos com lançamentos canary
Minimizamos a porcentagem de danos causados por bugs. A maioria dos erros de deploy ocorre devido à inconsistência de alguns dados ou prioridades. Esses erros diminuíram consideravelmente, porque conseguimos resolver o problema nos primeiros segundos.
Otimizaram o trabalho das equipes. Novatos têm o 'direito ao erro': podem fazer deploy em produção sem medo de cometer um engano, o que gera iniciativa e estímulo para trabalhar. Se eles quebram algo, não será crítico, e quem errou não será demitido.
Automatizamos o deploy. Agora não é mais um processo manual como antes, é realmente automatizado. Mas leva mais tempo.
Destacamos métricas importantes. Toda a empresa, desde os negócios até os engenheiros, entende o que é realmente importante em nosso produto, como as métricas, por exemplo, a rotatividade e a atração de usuários. Controlamos o processo: testamos métricas, introduzimos novas, observamos como as antigas funcionam, a fim de construir um sistema que ganhe dinheiro de forma mais eficiente.
Temos muitas práticas e sistemas legais que nos ajudam. Apesar disso, buscamos ser profissionais e fazer nosso trabalho com qualidade, independentemente de termos um sistema que nos ajude ou não.
Abordagens e práticas de engenharia — . Se você alcançou sucesso em sua jornada rumo à excelência técnica e está disposto a compartilhar o que o ajudou, — .
Estamos planejando realizar no dia 8 de junho. Entendemos que, neste momento, pode ser difícil decidir participar da conferência. Mas, ao mesmo tempo, acreditamos que a quarentena não é desculpa para interromper a comunicação e o desenvolvimento profissional. Portanto, de qualquer forma, encontraremos uma maneira de discutir as questões do líder técnico e as abordagens para resolvê-las — se necessário, migraremos para o online e promoveremos o networking lá!
Fonte: habr.com
