

Ao lidar com grandes conjuntos de dados complexos (diferentes : importações, conversões e sincronizações com fontes externas), muitas vezes surge a necessidade de "lembrar" temporariamente e processar rapidamente algo volumoso.
A tarefa típica desse tipo geralmente soa mais ou menos assim: "Aqui, os últimos pagamentos recebidos, precisamos carregá-los rapidamente no site e vinculá-los às contas"
Mas quando o volume desse "algo" começa a ser medido em centenas de megabytes, e o serviço precisa continuar funcionando com o banco de dados em modo 24×7, surgem muitos efeitos colaterais que podem dificultar sua vida.
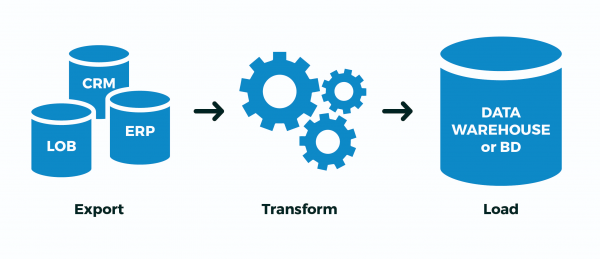
Para lidar com eles no PostgreSQL (e não apenas nele), podemos usar alguns recursos de otimização que permitirão processar tudo mais rapidamente e com menor consumo de recursos.
1. Onde carregar?
Primeiro, vamos definir onde podemos carregar os dados que queremos "processar".
1.1. Tabelas temporárias (TEMPORARY TABLE)
Basicamente, para o PostgreSQL, temporários são tabelas como qualquer outra. Portanto, não é verdade que existam superstições do tipo "tudo é armazenado apenas na memória, e ela pode acabar".Mas existem algumas diferenças significativas.
Seu "namespace" para cada conexão ao BD
Se duas conexões tentarem executar ao mesmo tempo CREATE TABLE x, então alguém definitivamente receberá um erro de não unicidade de objetos BD.
Mas se ambos tentarem executar CREATE TEMPORÁRIO TABELA x, ambos farão isso normalmente, e cada um receberá sua própria instância da tabela. E nada em comum entre elas.
"Auto-destruição" ao desconectar
Ao fechar a conexão, todas as tabelas temporárias são automaticamente removidas, então não faz sentido executar manualmente DROP TABLE x , exceto por…
Se você estiver trabalhando através do pgbouncer no modo de transação, o banco ainda acredita que essa conexão ainda está ativa, e nela essa tabela temporária ainda existe.
Portanto, a tentativa de criá-la novamente, já de outra conexão ao pgbouncer, resultará em erro. Mas isso pode ser contornado, usando CRIE UMA TABELA TEMPORÁRIA SE NÃO EXISTIR x.
Embora seja melhor não fazer isso, porque você pode "repentinamente" descobrir dados restantes do "proprietário anterior". Em vez disso, é muito melhor ler o manual e verificar que ao criar a tabela há uma opção para adicionar AO COMMIT DROP — ou seja, ao final da transação, a tabela será deletada automaticamente.
Não-replicação
Devido à sua associação a uma conexão específica, tabelas temporárias não são replicadas. No entanto, isso elimina a necessidade de gravar os dados duas vezes em heap + WAL, tornando as operações de INSERT/UPDATE/DELETE muito mais rápidas.
Mas como uma tabela temporária é, na verdade, uma tabela "quase normal", ela também não pode ser criada na réplica. Pelo menos, não ainda, embora o patch correspondente já esteja em circulação há muito tempo.
1.2. Tabelas não registradas (UNLOGGED TABLE)
Mas o que fazer, por exemplo, se você tem algum processo ETL complexo que não consegue ser realizado dentro de uma única transação, e você realmente do pgbouncer no modo de transação?..
Ou se o fluxo de dados é tão grande que não há largura de banda suficiente de uma única conexão com o banco de dados (leia-se, um único processo no CPU)?..
Ou se parte das operações ocorre assíncronamente em diferentes conexões?..
Aqui a única opção é — criar temporariamente uma tabela não temporária. Um trocadilho, sim. Ou seja:
- criei "minhas" tabelas com nomes o mais aleatórios possível, para não me confundir com ninguém
- Extrair: carreguei os dados de uma fonte externa
- Transformar: processei, preenchi os campos-chave de ligação
- Carga: transferi os dados prontos para as tabelas de destino
- deletei "minhas" tabelas
E agora — uma colher de destruição. Na verdade, toda gravação no PostgreSQL ocorre duas vezes — , depois nos corpos das tabelas/índices. Tudo isso é feito para suportar ACID e garantir a visibilidade correta dos dados entre COMMITtransações. ROLLBACKtransações.
Mas nós não precisamos disso! Todo o nosso processo ou foi concluído com sucesso como um todo, ou não foi.Não importa quantas transações intermediárias existam — não nos importa "continuar o processo do meio", especialmente quando não está claro onde ele parou.
Para isso, os desenvolvedores do PostgreSQL, desde a versão 9.1, implementaram algo como :
Com essa indicação, a tabela é criada como não registrada. Os dados gravados em tabelas não registradas não passam pelo diário de pré-gravação (veja o Capítulo 29), resultando em tabelas que funcionam muito mais rápido que as normais.No entanto, elas não estão protegidas contra falhas; em caso de falha ou desligamento abrupto do servidor, a tabela não registrada é automaticamente truncada.Além disso, o conteúdo da tabela não registrada não é replicado. em servidores secundários. Qualquer índice criado para uma tabela não registrada se torna automaticamente não registrado.
Em resumo, será muito mais rápido, mas se o servidor de banco de dados falhar, isso será desagradável. Mas com que frequência isso acontece, e seu processo ETL consegue corrigir isso corretamente "do meio" após a "ressurreição" do banco de dados?..
Se não, e o caso acima se parece com o seu, use UNLOGGED, mas nunca ative esse atributo em tabelas reais, os dados das quais são valiosos para você.
1.3. ON COMMIT { DELETE ROWS | DROP }
Essa construção permite definir o comportamento automático ao concluir a transação ao criar a tabela.
Sobre AO COMMIT DROP Eu já escrevi acima, ele gera DROP TABLE, mas aqui AO COMMIT EXCLUIR LINHAS a situação é mais interessante — aqui é gerado TRUNCATE TABLE.
Uma vez que toda a infraestrutura de armazenamento da metadescrição da tabela temporária é exatamente a mesma que a de uma tabela normal, a criação e exclusão constantes de tabelas temporárias levam a uma grande "expansão" das tabelas do sistema pg_class, pg_attribute, pg_attrdef, pg_depend,…
Agora imagine que você tem um trabalhador em uma conexão direta com o banco de dados, que a cada segundo abre uma nova transação, cria, preenche, processa e exclui uma tabela temporária… Haverá um acúmulo excessivo de lixo nas tabelas do sistema, o que causa lentidão em cada operação.
Em geral, não faça isso! Nesse caso, é muito mais eficaz CREATE TEMPORARY TABLE x ... ON COMMIT DELETE ROWS extrair para fora do ciclo de transações — assim, no início de cada nova transação, a tabela já existirá (economizamos chamadas CREATE), mas estará vazia, graças a TRUNCATE (também economizamos essa chamada) ao término da transação anterior.
1.4. LIKE… INCLUDING …
Mencionei no início que um dos casos típicos para tabelas temporárias é a importação de dados — e o desenvolvedor cansativamente copia e cola a lista de campos da tabela de destino na declaração de sua tabela temporária…
Mas a preguiça é o motor do progresso! Portanto, criar uma nova tabela "por modelo" pode ser muito mais simples:
CREATE TEMPORARY TABLE import_table(
  LIKE target_table
);
Uma vez que é possível gerar muitos dados nessa tabela posteriormente, as buscas nela se tornarão muito lentas. Mas há uma solução tradicional contra isso — índices! E sim, uma tabela temporária também pode ter índices.
Uma vez que, muitas vezes, os índices necessários coincidem com os índices da tabela de destino, basta escrever SEMELHANTE a target_table INCLUINDO ÍNDICES.
Se você também precisa de DEFAULT-valores (por exemplo, para preencher os valores da chave primária), você pode usar SEMELHANTE a target_table INCLUINDO PADRÕES. Ou simplesmente — SEMELHANTE a target_table INCLUINDO TODOS — copia os padrões, índices, restrições,…
Mas aqui já é preciso entender que se você criou a tabela de importação já com índices, os dados serão carregados mais lentamente, do que se você carregá-los primeiro e só depois aplicar os índices — veja como isso é feito, como exemplo, no .
Em geral, !
2. Como escrever?
Vou dizer simplesmente — use -fluxo em vez de "lote" INSERT, . Você pode até fazer isso diretamente de um arquivo previamente formado.
3. Como processar?
Então, vamos supor que nossa entrada seja algo assim:
- você tem uma tabela em seu banco de dados com os dados dos clientes com 1M registros
- todos os dias o cliente lhe envia um novo ‘imagem’ completa
- pela experiência você sabe que de uma vez para outra mudam não mais de 10K registros
Um exemplo clássico dessa situação é — são muitos endereços no total, mas em cada exportação semanal de mudanças (mudanças nos nomes das cidades, fusões de ruas, aparecimento de novos edifícios) há bem poucos, mesmo em escala nacional.
3.1. Algoritmo de sincronização total
Para simplificar, vamos supor que você não precise nem reestruturar os dados — apenas formatar a tabela conforme necessário, isto é:
- remover tudo o que já não existe
- atualizar tudo o que já existia e precisa ser atualizado
- inserir tudo o que ainda não existe
Por que as operações devem ser feitas exatamente nesta ordem? Porque assim o tamanho da tabela crescerá ao mínimo ().
DELETE FROM dst
Não, claro que é possível fazer tudo com apenas duas operações:
- remover (
DELETE) tudo em geral - inserir tudo a partir da nova imagem
Mas, nesse caso, graças ao MVCC, o tamanho da tabela aumentará exatamente ao dobro! Obter +1M imagens de registros na tabela devido à atualização de 10K — uma redundância nada agradável…
TRUNCATE dst
Um desenvolvedor mais experiente sabe que toda a tabela pode ser limpa de forma bastante barata:
- limpar (
TRUNCATE) toda a tabela - inserir tudo a partir da nova imagem
O método é eficaz, , mas há um problema… Injetar 1M de registros levará muito tempo, então não podemos nos dar ao luxo de deixar a tabela vazia todo esse tempo (o que acontece sem envolver em uma única transação).
E significa que:
- começamos uma transação longa
TRUNCATEimpõe AccessExclusive-bloqueio- estamos demorando para inserir, enquanto todos os outros nesse tempo não podem sequer
SELECT
Algo não parece certo...
ALTER TABLE… RENOMEAR… / DROPAR TABELA …
Uma opção é carregar tudo em uma nova tabela separada e depois simplesmente renomeá-la para o lugar da antiga. Algumas pequenas complicações:
- também AccessExclusive, embora substancialmente menos em tempo
- todas as estatísticas de consultas/tabela dessa tabela são redefinidas,
- todas as chaves estrangeiras (FK) na tabela
Havia um patch WIP de Simon Riggs, que propôs fazer ALTER-operação para substituir o corpo da tabela em nível de arquivo, sem tocar nas estatísticas e FK, mas não conseguiu reunir quórum.
DELETE, UPDATE, INSERT
Então, ficamos com a opção não bloqueante de três operações. Quase três… Como fazer isso da maneira mais eficiente?
-- fazemos tudo dentro de uma transação, para que ninguém veja os estados "intermediários"
BEGIN;

-- criamos uma tabela temporária com os dados importados
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- à semelhança, junto com índices
) ON COMMIT DROP; -- fora da transação, não precisamos dela

-- rapidamente inserimos a nova estrutura através do COPY
COPY tmp FROM STDIN;
-- ...
-- .

-- removemos os ausentes
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- campos da chave primária
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "antijoin"

-- atualizamos os restantes
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- não há necessidade de atualizar os coincidentes

-- inserimos os ausentes
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Pós-processamento da importação
Nas mesmas entradas do KAD, todos os registros alterados precisam ser processados novamente — normalizados, palavras-chave extraídas, estruturados conforme necessário. Mas como saber — o que exatamente foi alterado, sem complicar o código de sincronização, idealmente, não tocando nele de forma alguma?
Se o acesso para gravação no momento da sincronização está disponível apenas para seu processo, você pode usar um gatilho que coletará todas as alterações:
-- tabelas de destino
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- tabelas com histórico de modificações
CREATE TABLE kladr$log(
  ro kladr, -- aqui estão os registros antigos/novos
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- função geral para registrar mudanças
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- verificando a necessidade de registrar ao atualizar
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- criando o registro de log
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Agora podemos, antes de iniciar a sincronização, aplicar os gatilhos (ou ativá-los através de ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
E, a partir das tabelas de log, extraímos todas as mudanças necessárias e processamos com manipuladores adicionais.
3.3. Importação de conjuntos de dados relacionados
Acima, discutimos os casos em que as estruturas de dados da fonte e do receptor coincidem. Mas o que fazer se a exportação de um sistema externo estiver em um formato diferente da estrutura de armazenamento em nosso banco de dados?
Tomemos como exemplo o armazenamento de clientes e suas faturas, uma variante clássica de "muitos para um":
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
Mas a exportação de uma fonte externa chega para nós em forma de "tudo em um":
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
É óbvio que os dados dos clientes podem se duplicar nessa variante, e o registro principal é a "fatura":
0123456789;Vasya;A-01;2020-03-16;1000.00
9876543210;Petya;A-02;2020-03-16;666.00
0123456789;Vasya;B-03;2020-03-16;9999.00
Para o modelo, vamos simplesmente inserir nossos dados de teste, mas lembramos — COPY é mais eficiente!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Vasya', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Petya', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Vasya', 'B-03', '2020-03-16', 9999.00);
Primeiro, destacaremos aqueles "recortes" aos quais nossos "fatos" se referem. No nosso caso, as faturas se referem aos clientes:
CRIE UMA TABELA TEMPORÁRIA client_import AS
SELECIONE DISTINCT ON(client_inn)
-- pode ser apenas SELECT DISTINCT, se os dados forem garantidamente consistentes
  client_inn inn
, client_name "name"
DE
  invoice_import;
Para vincular corretamente as faturas aos IDs dos clientes, precisamos primeiro descobrir ou gerar esses identificadores. Adicionaremos campos para eles:
ALTER TABLE invoice_import ADD COLUMN client_id integer;
ALTER TABLE client_import ADD COLUMN client_id integer;
Usaremos o método de sincronização de tabelas descrito acima com uma pequena alteração — não iremos atualizar ou excluir nada na tabela de destino, uma vez que a importação de clientes é 'apenas adição':
-- inserindo na tabela de importação os IDs das gravações já existentes
ATUALIZAR
  client_import T
SET
  client_id = D.client_id
DE
  client D
ONDE
  T.inn = D.inn; -- chave única

-- inserindo registros ausentes e atribuindo seus IDs
COM ins AS (
  INSERIR EM client(
    inn
  , name
  )
  SELECIONE
    inn
  , name
  DE
    client_import
  ONDE
    client_id IS NULL -- se o ID não foi atribuído
  RETORNANDO *
)
ATUALIZAR
  client_import T
SET
  client_id = D.client_id
DE
  ins D
ONDE
  T.inn = D.inn; -- chave única

-- atribuirmos IDs de clientes aos registros das faturas
ATUALIZAR
  invoice_import T
SET
  client_id = D.client_id
DE
  client_import D
ONDE
  T.client_inn = D.inn; -- chave prática
Isso é tudo — em invoice_import agora temos o campo de vínculo preenchido client_id, com o qual inseriremos a fatura.
Fonte: habr.com
