

Um dos cenários típicos em todos os aplicativos que conhecemos é a busca de dados com base em critérios específicos e a apresentação desses dados de forma legível. Aqui também podem haver funcionalidades adicionais para ordenação, agrupamento e paginação. A tarefa, em teoria, é trivial, mas muitos desenvolvedores cometem uma série de erros ao resolvê-la, o que prejudica o desempenho. Vamos explorar várias opções de solução para essa tarefa e formular recomendações sobre a escolha da implementação mais eficaz.
Opção de paginação #1
A opção mais simples que vem à mente é a paginação dos resultados da busca de maneira clássica.
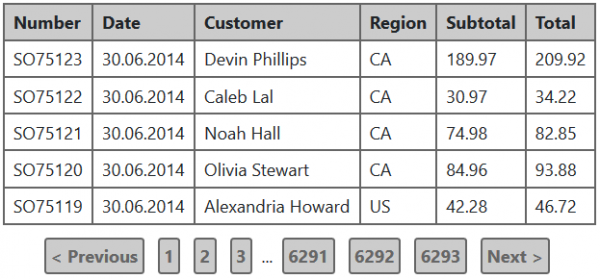
Suponha que uma base de dados relacional esteja em uso no aplicativo. Nesse caso, para apresentar a informação dessa forma, será necessário executar duas consultas SQL:
- Obter as linhas para a página atual.
- Contar o número total de linhas que atendem aos critérios de busca — isso é necessário para mostrar as páginas.
Vamos considerar a primeira consulta usando um banco de dados MS SQL de teste. para o servidor 2016. Para isso, usaremos a tabela Sales.SalesOrderHeader:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
A consulta acima retornará os 50 primeiros pedidos da lista, ordenados de forma decrescente pela data de adição, ou seja, os 50 pedidos mais recentes.
Ela é executada rapidamente na base de teste, mas vamos examinar o plano de execução e as estatísticas de entrada e saída:
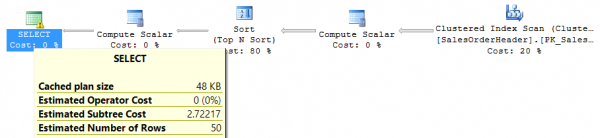
Tabela 'SalesOrderHeader'. Contagem de scans 1, leituras lógicas 698, leituras físicas 0, leituras antecipadas 0, leituras lógicas lob 0, leituras físicas lob 0, leituras antecipadas lob 0.A estatística de entrada/saída para cada consulta pode ser obtida executando o comando SET STATISTICS IO ON no ambiente de execução de consultas.
Como pode ser visto no plano de execução, a operação mais intensiva em recursos é a ordenação de todas as linhas da tabela original pela data de adição. E o problema é que quanto mais linhas aparecerem na tabela, mais "pesada" se tornará a ordenação. Na prática, essas situações devem ser evitadas, então vamos adicionar um índice na data de adição e verificar se o consumo de recursos mudou:
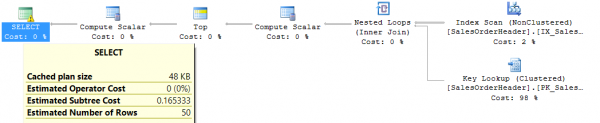
Tabela 'SalesOrderHeader'. Contagem de scans 1, leituras lógicas 165, leituras físicas 0, leituras antecipadas 5, leituras lógicas lob 0, leituras físicas lob 0, leituras antecipadas lob 0.
É evidente que melhorou muito. Mas será que todos os problemas foram resolvidos? Vamos alterar a consulta para buscar pedidos em que o valor total dos produtos ultrapasse 100 dólares:
SELECT * FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
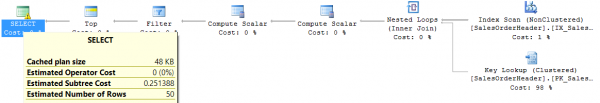
Tabela 'SalesOrderHeader'. Contagem de varreduras 1, leituras lógicas 1081, leituras físicas 0, leituras antecipadas 0, leituras lógicas lob 0, leituras físicas lob 0, leituras antecipadas lob 0.Temos uma situação curiosa: o plano da consulta não é muito pior que o anterior, mas a quantidade real de leituras lógicas é quase o dobro da que teria em uma varredura completa da tabela. A solução existe — se transformarmos o índice existente em composto e adicionarmos o campo de preço total dos produtos, novamente obteremos 165 leituras lógicas:
CREATE INDEX IX_SalesOrderHeader_OrderDate_SubTotal on Sales.SalesOrderHeader(OrderDate, SubTotal);
Podemos continuar essa série de exemplos por muito tempo, mas duas ideias principais que quero expressar aqui são as seguintes:
- Adicionar qualquer novo critério ou ordem de classificação à consulta pode impactar significativamente a velocidade de sua execução.
- Mas se precisarmos extrair apenas uma parte dos dados, e não todos os resultados que atendem às condições de busca — há várias maneiras de otimizar essa consulta.
Agora vamos para a segunda consulta mencionada no início — aquela que conta o número de registros que atendem ao critério de busca. Vamos usar o mesmo exemplo — buscar pedidos que custam mais de 100 dólares:
SELECT COUNT(1) FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
Com o índice composto mencionado acima, obtemos:
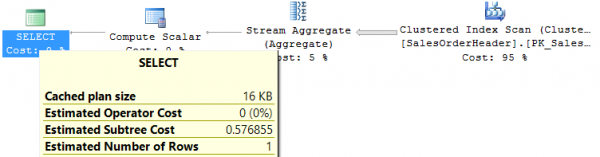
Tabela 'SalesOrderHeader'. Contagem de scans 1, leituras lógicas 698, leituras físicas 0, leituras antecipadas 0, leituras lógicas lob 0, leituras físicas lob 0, leituras antecipadas lob 0.O fato de a consulta percorrer todo o índice não é surpreendente, já que o campo SubTotal não está na primeira posição, portanto a consulta não pode se aproveitar disso. O problema é resolvido adicionando outro índice ao campo SubTotal, resultando em apenas 48 leituras lógicas.
Podemos apresentar mais alguns exemplos de consultas para contagem, mas a essência permanecerá a mesma: obter um conjunto de dados e contar a quantidade total — são duas consultas fundamentalmente diferentes, e cada uma requer suas próprias medidas de otimização. De maneira geral, não será possível encontrar uma combinação de índices que funcione igualmente bem para ambas as consultas.
Assim, uma das principais exigências a serem esclarecidas ao desenvolver uma solução de pesquisa como essa é se, de fato, é importante para a empresa ver o número total de objetos encontrados. Muitas vezes, isso não é necessário. E a navegação por números de página específicos, na minha opinião, é uma solução com um campo de aplicação muito restrito, uma vez que a maioria dos cenários de paginação se apresenta como 'ir para a próxima página'.
Opção de paginação #2
Suponha que os usuários não estejam interessados em saber o número total de objetos encontrados. Vamos tentar simplificar a página de pesquisa:
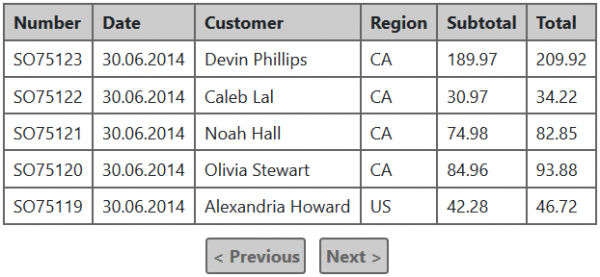
Na prática, a única diferença é que não é mais possível navegar para números de páginas específicas, e agora essa tabela de exibição não precisa saber quantas páginas existem ao todo. Mas surge a questão: como a tabela saberá se há dados para a próxima página (para exibir corretamente o link 'Próximo')?
A resposta é muito simples: podemos ler da base de dados uma entrada a mais do que o necessário para exibição, e a presença dessa 'entrada adicional' indicará se há um próximo lote disponível. Assim, para obter uma página de dados, será necessário executar apenas uma consulta, o que melhora significativamente o desempenho e facilita a manutenção dessa funcionalidade. Eu tive um caso na prática em que abrir mão do cálculo do número total de registros acelerou a entrega dos resultados em 4-5 vezes.
Para essa abordagem, existem várias opções de interface do usuário: comandos 'voltar' e 'avançar', como no exemplo acima, um botão 'carregar mais', que simplesmente adiciona um novo lote aos resultados exibidos, e 'rolagem infinita', que funciona no princípio de 'carregar mais', mas o sinal para obter o próximo lote é a rolagem do usuário até o final de todos os resultados mostrados. Qualquer que seja a solução visual, o princípio de amostragem de dados permanece o mesmo.
Nuances da implementação da paginação
Em todos os exemplos de consultas apresentados acima, usa-se a abordagem 'deslocamento + quantidade', onde na própria consulta é especificado de qual linha da resultante e quantas linhas precisam ser retornadas. Primeiramente, vamos considerar como organizar melhor a transmissão de parâmetros nesse caso. Na prática, encontrei várias maneiras:
- Número sequencial da página solicitada (pageIndex), tamanho da página (pageSize).
- Número sequencial do primeiro registro que deve ser retornado (startIndex), número máximo de registros no resultado (count).
- Número sequencial do primeiro registro que deve ser retornado (startIndex), número sequencial do último registro que deve ser retornado (endIndex).
À primeira vista, pode parecer tão elementar que não há diferença. Mas não é assim—o segundo (startIndex, count) é a opção mais conveniente e universal. Existem várias razões para isso:
- Para a abordagem de ler +1 registro, como mencionado acima, a primeira opção com pageIndex e pageSize é extremamente inconveniente. Por exemplo, queremos exibir 50 registros por página. De acordo com o algoritmo apresentado, é necessário ler um registro a mais do que o necessário. Se esse 'mais 1' não estiver configurado no servidor, obteremos que, para a primeira página, devemos solicitar registros de 1 a 51, para a segunda—de 51 a 101, e assim por diante. Se especificarmos o tamanho da página como 51 e aumentarmos o pageIndex, a segunda página retornará de 52 a 102 e assim por diante. Consequentemente, na primeira opção, a única maneira de implementar corretamente o botão para a próxima página seria preparar no servidor a leitura da 'linha extra', o que seria um detalhe muito obscuro.
- A terceira opção não faz sentido algum, uma vez que para executar consultas na maioria dos bancos de dados ainda será necessário passar a quantidade, e não o índice do último registro. A subtração de startIndex de endIndex e uma operação aritmética elementar, mas ela é desnecessária aqui.
Agora devemos descrever as desvantagens da implementação de paginação através de 'offset + quantidade':
- Obter cada próxima página será mais dispendioso e mais lento do que a anterior, porque o banco de dados ainda precisará percorrer todos os registros 'do princípio' de acordo com os critérios de busca e ordenação, e então parar na parte necessária.
- Nem todos os SGBDs podem suportar essa abordagem.
Existem alternativas, mas elas também não são ideais. A primeira dessas abordagens é chamada de 'keyset paging' ou 'método seek' e consiste no seguinte: após obter um lote, pode-se memorizar os valores dos campos do último registro da página, e depois utilizá-los para obter o próximo lote. Por exemplo, fizemos essa consulta:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Na última entrada, recebemos o valor da data do pedido '2014-06-29'. Portanto, para obter a próxima página, podemos tentar executar o seguinte:
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate < '2014-06-29'
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
O problema é que OrderDate não é um campo único e a condição mencionada acima provavelmente irá omitir muitas linhas necessárias. Para trazer clareza a essa consulta, é preciso adicionar um campo único à condição (suponha que 75074 é o último valor da chave primária do primeiro lote):
SELECT * FROM Sales.SalesOrderHeader
WHERE (OrderDate = '2014-06-29' AND SalesOrderID < 75074)
   OR (OrderDate < '2014-06-29')
ORDER BY OrderDate DESC, SalesOrderID DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Essa versão funcionará corretamente, mas, no geral, será difícil otimizá-la, pois a condição contém o operador OR. Se o valor da chave primária cresce com o aumento de OrderDate, a condição pode ser simplificada, mantendo apenas o filtro por SalesOrderID. Mas se entre os valores da chave primária e o campo que ordena o resultado não houver uma correlação estrita — na maioria dos SGBDs, evitar esse OR não será possível. Uma exceção conhecida para mim é o PostgreSQL, onde a comparação de tuplas é totalmente suportada, e a condição mencionada acima pode ser escrita como 'WHERE (OrderDate, SalesOrderID) < ('2014-06-29', 75074)'. Com uma chave composta contendo esses dois campos, tal consulta deve ser suficientemente leve.
Uma segunda abordagem alternativa pode ser encontrada, por exemplo, em ou — quando a consulta, além dos dados, retorna um identificador especial, que pode ser usado para obter o próximo lote de dados. Se esse identificador tiver um tempo de vida ilimitado (como no Cosmos DB), é uma ótima forma de implementar a paginação com transições sequenciais entre páginas (a opção #2 mencionada acima). Seus possíveis inconvenientes: não é suportado em todos os SGBDs; o identificador obtido para o próximo lote pode ter um tempo de vida limitado, o que, em geral, não é adequado para realizar interações com o usuário (como, por exemplo, na ElasticSearch scroll API).
Filtragem complexa
Complicamos um pouco mais a tarefa. Suponha que surge a necessidade de implementar uma chamada pesquisa facetada, muito familiar em lojas online. Os exemplos citados acima com base na tabela de pedidos não são muito representativos neste caso, então vamos mudar para a tabela Product do banco de dados AdventureWorks:
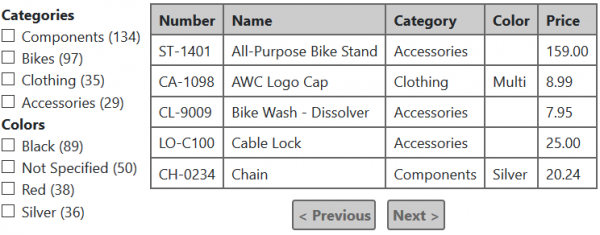
Qual é a ideia da pesquisa facetada? É que para cada elemento do filtro é exibido o número de registros que correspondem a esse critério considerando os filtros escolhidos nas demais categorias.
Por exemplo, se escolhêssemos neste caso a categoria Bikes e a cor Black, a tabela mostraria apenas bicicletas da cor preta, mas ao mesmo tempo:
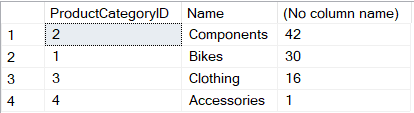
- Para cada critério do grupo 'Categories' será mostrado o número de produtos dessa categoria na cor preta.
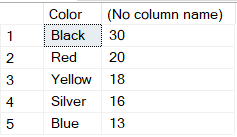
- Para cada critério do grupo 'Colors' será mostrado o número de bicicletas dessa cor.
Aqui está um exemplo de exibição do resultado para tais condições:
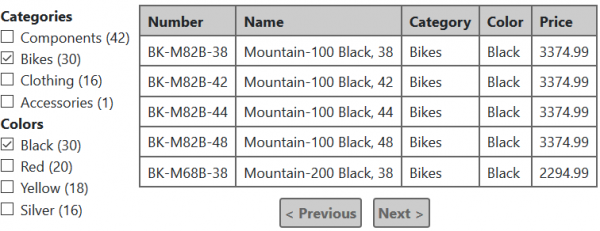
Se além disso marcarmos a categoria 'Clothing', a tabela mostrará também as roupas da cor preta que estão disponíveis. O número de produtos de cor preta na seção 'Color' também será recalculado de acordo com as novas condições, mas na seção 'Categories' nada mudará… Espero que esses exemplos sejam suficientes para compreender o algoritmo familiar da pesquisa facetada.
Agora vamos imaginar como isso pode ser implementado em um banco de dados relacional. Cada grupo de critérios, como Category e Color, exigirá uma consulta separada:
SELECT pc.ProductCategoryID, pc.Name, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
  INNER JOIN Production.ProductCategory pc ON ps.ProductCategoryID = pc.ProductCategoryID
WHERE p.Color = 'Black'
GROUP BY pc.ProductCategoryID, pc.Name
ORDER BY COUNT(1) DESC
SELECT Color, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.ProductCategoryID = 1 --Bikes
GROUP BY Color
ORDER BY COUNT(1) DESC
Qual é o problema com essa solução? É simples — ela não escala bem. Cada seção de filtro requer uma consulta separada para contar as quantidades e essas consultas não são das mais leves. Em lojas online, em algumas categorias, pode haver várias dezenas de seções de filtro, o que pode se tornar um sério problema de desempenho.
Normalmente, após essas afirmações, me são oferecidas algumas soluções, nomeadamente:
- Consolidar todas as contagens em uma única consulta. Tecnicamente, isso é possível usando a palavra-chave UNION, mas isso não ajuda muito em termos de desempenho — o banco de dados ainda precisará executar 'do zero' cada um dos fragmentos.
- Cachear quantidades. Isso é algo que me sugerem praticamente toda vez que descrevo o problema. A nuance é que, de maneira geral, isso é impossível. Suponha que temos 10 'facetados', cada um com 5 valores. Essa é uma situação muito 'modesta' em comparação com o que pode ser visto em lojas online. A escolha de um item facetado influencia as quantidades em 9 outros; em outras palavras, para cada combinação de critérios, as quantidades podem ser diferentes. No total, em nosso exemplo, existem 50 critérios que o usuário pode escolher, portanto, as combinações possíveis seriam 250. Não há memória ou tempo suficientes para preencher tal matriz de dados. Pode-se argumentar que nem todas as combinações são reais e que o usuário raramente escolhe mais de 5-10 critérios. Sim, é possível implementar o carregamento sob demanda e o cache de quantidades apenas para o que foi selecionado anteriormente, mas quanto mais opções de escolha houver, menos eficaz será esse cache e mais evidentes se tornarão os problemas de tempo de resposta (especialmente se o conjunto de dados mudar regularmente).
Felizmente, essa tarefa já possui soluções bastante eficazes que funcionam de maneira previsível em grandes volumes de dados. Para qualquer uma dessas opções, faz sentido separar o recálculo dos facets e a obtenção da página de resultados em duas solicitações paralelas ao servidor e organizar a interface do usuário de modo que o carregamento dos dados dos facets 'não atrapalhe' a exibição dos resultados da pesquisa.
- Chamar a recontagem completa de "facetas" com a menor frequência possível. Por exemplo, em vez de recalcular tudo a cada alteração nos critérios de pesquisa, encontre a contagem total dos resultados que atendem às condições atuais e sugira ao usuário exibi-los — "1425 registros encontrados, mostrar?" O usuário pode continuar alterando as condições de pesquisa ou clicar no botão "mostrar". Somente neste segundo caso serão executadas todas as consultas para obter os resultados e recalcular as quantidades em todas as "facetas". Nesse caso, como não é difícil perceber, será necessário lidar com uma solicitação para obter o total de resultados e sua otimização. Este método pode ser encontrado em muitas pequenas lojas online. É óbvio que isso não é uma panaceia para este problema, mas em casos simples pode ser um bom compromisso.
- Usar motores de busca para procurar resultados e contar facetas, como Solr, ElasticSearch, Sphinx e outros. Todos eles são projetados para construir "facetas" e fazem isso de forma bastante eficiente devido ao índice invertido. Como os motores de busca são estruturados, por que eles são mais eficazes nessas situações do que bancos de dados de uso geral, quais são as melhores práticas e armadilhas — este é um tema para um artigo separado. Aqui, quero chamar a atenção para o fato de que o motor de busca não pode substituir o armazenamento de dados principal, mas é utilizado como um complemento: quaisquer alterações na base principal, que são relevantes para a busca, são sincronizadas no índice de busca; o mecanismo de busca geralmente interage apenas com o motor de busca e não acessa a base principal. Um dos pontos mais importantes aqui é como organizar essa sincronização de forma confiável. Tudo depende dos requisitos para o "tempo de resposta". Se o tempo entre uma alteração na base principal e sua "aparição" na busca não for crítico, pode-se criar um serviço que a cada alguns minutos busca os registros recentemente alterados e os indexa. Se for necessário um tempo de resposta o mais curto possível, pode-se implementar algo como para enviar atualizações para o serviço de busca.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
- A implementação de paginação do lado do servidor é uma complicação séria e deve ser aplicada apenas a conjuntos de dados que estão crescendo rapidamente ou que são simplesmente grandes. Não há uma receita absolutamente precisa para avaliar o que é "grande" ou "em crescimento rápido", mas eu seguiria esta abordagem:
- Se a obtenção da coleção completa de dados, considerando o tempo do servidor e a transferência pela rede, se encaixar normalmente nos requisitos de desempenho, não faz sentido implementar a paginação do lado do servidor.
- Pode haver uma situação em que, pelo menos por um tempo, não se prevejam problemas de desempenho, pois há poucos dados, mas a coleção de dados está em constante crescimento. Se um determinado conjunto de dados pode, a longo prazo, deixar de atender ao ponto anterior — é melhor incluir a paginação desde o início.
- Se do lado dos negócios não houver uma exigência rígida para mostrar o número total de resultados ou exibir números de páginas, e além disso, seu sistema não possui um mecanismo de busca — é melhor não implementar esses aspectos e considerar a opção #2.
- Se houver uma exigência clara sobre busca facetada, você tem duas opções para não sacrificar o desempenho:
- Não recalcular todas as quantidades a cada alteração dos critérios de busca.
- Utilizar mecanismos de busca como Solr, ElasticSearch, Sphinx e outros. Mas é preciso entender que ele não pode substituir o banco de dados principal e deve ser utilizado como um complemento ao armazenamento principal para resolver questões de busca.
- Além disso, no caso de busca facetada, faz sentido dividir a obtenção da página de resultados de busca e a contagem de quantidades em duas requisições paralelas. A contagem de quantidades pode levar mais tempo do que a obtenção dos resultados, enquanto os resultados são mais importantes para o usuário.
- Se você estiver utilizando um banco de dados SQL para busca, qualquer alteração no código relacionada a essa parte deve ser bem testada em termos de desempenho com o volume correspondente de dados (superior ao volume em um banco de dados "vivo"). Também é desejável utilizar o monitoramento do tempo de execução das requisições em todas as instâncias do banco, e especialmente — no "vivo". Mesmo que na fase de desenvolvimento os planos de requisições estejam funcionando bem, com o crescimento do volume de dados, a situação pode mudar consideravelmente.
Fonte: habr.com
