

Muitos se deparam com o Elasticsearch. Mas o que acontece quando você quer usá-lo para armazenar logs em "grande volume"? E como sobreviver sem dor a falhas em qualquer um dos vários data centers? Como deve ser a arquitetura e quais armadilhas você pode encontrar?
Nós, do Odnoklassniki, decidimos resolver a questão da gestão de logs com o Elasticsearch e agora compartilhamos nossa experiência com o Habr: tanto sobre a arquitetura quanto sobre as armadilhas.
Eu sou Pyotr Zaytsev, trabalho como administrador de sistemas no Odnoklassniki. Antes disso, também fui administrador, trabalhei com Manticore Search, Sphinx Search e Elasticsearch. É provável que, se surgir mais algum ...search, eu também trabalhe com ele. Além disso, participo de vários projetos de código aberto de forma voluntária.
Quando entrei para o Odnoklassniki, eu imprudentemente disse na entrevista que sabia trabalhar com Elasticsearch. Depois que me familiarizei e fiz algumas tarefas simples, me deram uma grande tarefa de reformulação do sistema de gestão de logs existente até aquele momento.
Requisitos
Os requisitos do sistema foram formulados da seguinte forma:
- Como frontend, deveria ser utilizado o Graylog. Porque a empresa já tinha experiência com esse produto, os programadores e testadores já o conheciam e achavam conveniente.
- Volume de dados: em média, de 50 a 80 mil mensagens por segundo, mas se algo der errado, o tráfego não tem limites, isso pode ser de 2 a 3 milhões de linhas por segundo.
- Depois de discutir com os clientes os requisitos de velocidade de processamento de consultas, percebemos que o padrão típico de uso de um sistema assim é que as pessoas procuram logs de sua aplicação dos últimos dois dias e não querem esperar mais de um segundo para os resultados de sua consulta.
- Os administradores insistiram que o sistema deveria facilmente escalar, se necessário, sem exigir que eles aprofundassem no funcionamento interno.
- Para que a única tarefa de manutenção que esses sistemas precisavam periodicamente fosse trocar algum hardware.
- Além disso, no Odnoklassniki existe uma excelente tradição técnica: qualquer serviço que lançamos deve sobreviver à falha de um data center (repentina, não planejada e absolutamente a qualquer hora).
A última exigência na implementação deste projeto nos custou muito, sobre o que falarei mais em detalhes.
Ambiente
Trabalhamos em quatro data centers, com as nodos Elasticsearch podendo estar localizados apenas em três (por razões não técnicas).
Nestes quatro data centers, existem cerca de 18 mil diferentes fontes de logs — hardware, contêineres, máquinas virtuais.
Uma característica importante: o cluster é iniciado em contêineres não em máquinas físicas, mas na . Os contêineres têm garantidos 2 núcleos, equivalentes a 2.0Ghz v4, com a possibilidade de usar os outros núcleos em caso de inatividade.
Em outras palavras:
Topologia
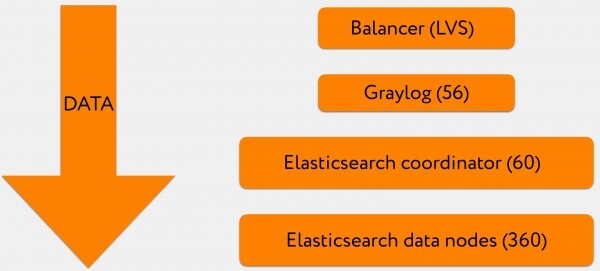
A visão geral da solução inicialmente me parecia da seguinte forma:
- 3-4 VIPs estão por trás do registro A do domínio Graylog, este é o endereço para onde os logs são enviados.
- cada VIP representa um balanceador LVS.
- Após isso, os logs vão para um conjunto de Graylog, parte dos dados é no formato GELF, parte no formato syslog.
- Em seguida, tudo isso é escrito em grandes lotes em um conjunto de coordenadores Elasticsearch.
- E estes, por sua vez, enviam solicitações de gravação e leitura para as nodos de dados relevantes.
Terminologia
Talvez nem todos estejam familiarizados com a terminologia, por isso gostaria de fazer uma pequena pausa sobre isso.
No Elasticsearch, há vários tipos de nodos — master, coordinator, data node. Existem outros dois tipos para diferentes transformações de logs e para a comunicação entre diferentes clusters, mas usamos apenas os mencionados.
Master
Monitora todos os nodos presentes no cluster, mantém o mapa do cluster atualizado e o distribui entre os nodos, processa a lógica de eventos e cuida da manutenção geral do cluster.
Coordinator
Realiza uma única tarefa: aceita solicitações de clientes para leitura ou gravação e roteia esse tráfego. Se for uma solicitação de gravação, provavelmente perguntará ao master em qual shard do índice relevante deve colocá-la e redirecionará a solicitação.
Data node
Armazena dados, executa as consultas de busca que chegam externamente e operações nos shards localizados nela.
Graylog
É algo como uma combinação do Kibana com o Logstash na pilha ELK. O Graylog combina a interface de usuário e o pipeline de processamento de logs. Por trás do Graylog, trabalham o Kafka e o Zookeeper, que garantem a conectividade do Graylog como um cluster. O Graylog é capaz de armazenar logs em cache (Kafka) caso o Elasticsearch esteja indisponível e repetir solicitações de leitura e gravação falhadas, agrupando e etiquetando logs de acordo com regras definidas. Assim como o Logstash, o Graylog possui funcionalidade para modificar strings antes de gravá-las no Elasticsearch.
Além disso, o Graylog possui uma descoberta de serviços embutida, permitindo, com base em um único nó acessível do Elasticsearch, obter todo o mapa do cluster e filtrá-lo por uma determinada tag, o que possibilita direcionar solicitações a contêineres específicos.
Visualmente, isso fica mais ou menos assim:

Esta é uma captura de tela de uma instância específica. Aqui, construímos um histograma a partir da consulta de pesquisa, mostrando as linhas relevantes.
Índices
Voltando à arquitetura do sistema, gostaria de discutir em mais detalhes como construímos o modelo de índices para que tudo funcionasse corretamente.
Na diagramação apresentada anteriormente, este é o nível mais baixo: os nós de dados do Elasticsearch.
Um índice é uma grande entidade virtual composta por shards do Elasticsearch. Cada shard é, na verdade, um índice do Lucene. E cada índice do Lucene, por sua vez, consiste de um ou mais segmentos.
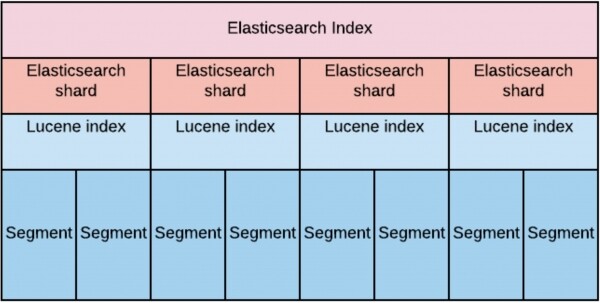
Na fase de projeto, consideramos que, para atender à demanda de velocidade de leitura em um grande volume de dados, era necessário "distribuir" esses dados uniformemente entre os nós de dados.
Isso resultou na necessidade de que o número de shards por índice (junto com as réplicas) fosse estritamente igual ao número de nós de dados. Em primeiro lugar, para garantir um fator de replicação igual a dois (ou seja, podemos perder metade do cluster). E, em segundo lugar, para que as solicitações de leitura e gravação fossem processadas, no mínimo, em metade do cluster.
Definimos o tempo de armazenamento inicialmente como 30 dias.
A distribuição dos shards pode ser representada graficamente da seguinte forma:
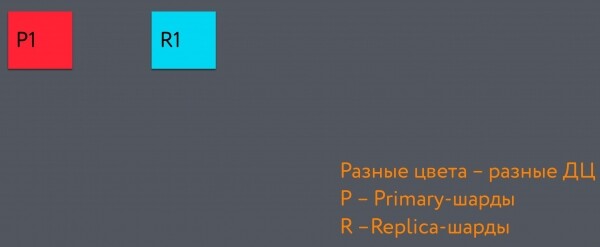
Todo o retângulo cinza escuro representa completamente o índice. O quadrado vermelho à esquerda é o shard primário, o primeiro do índice. E o quadrado azul é o shard de réplica. Eles estão localizados em diferentes data centers.
Quando adicionamos mais um shard, ele vai para o terceiro data center. E, no final, temos essa estrutura, que garante a possibilidade de perder um DC sem perder a consistência dos dados:
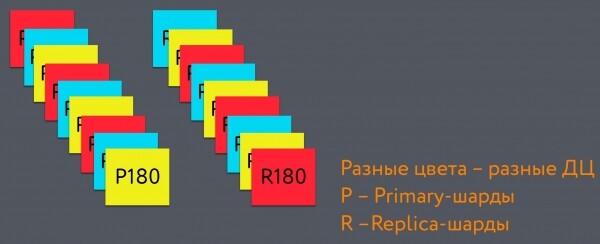
Fizemos a rotação de índices, ou seja, a criação de um novo índice e a remoção do mais antigo, igual a 48 horas (com base no padrão de uso do índice: os dados mais recentes são os mais frequentemente buscados).
Esse intervalo de rotação de índices está relacionado com os seguintes motivos:
Quando um nó de dados específico recebe uma consulta de busca, do ponto de vista de desempenho, é mais vantajoso consultar um único shard, se seu tamanho for comparável ao tamanho da memória do nó. Isso permite manter a parte "quente" do índice na memória e acessá-la rapidamente. Quando há muitas partes "quentes", a velocidade de busca no índice se degrada.
Quando um nó começa a processar uma consulta de busca em um shard, ele aloca um número de threads igual ao número de núcleos físicos da máquina com hyper-threading. Se a consulta de busca envolve um grande número de shards, o número de threads cresce proporcionalmente. Isso impacta negativamente na velocidade de busca e compromete a indexação de novos dados.
Para garantir a latência necessária na busca, decidimos usar SSDs. Para o processamento rápido de consultas, as máquinas que hospedam esses contêineres devem ter pelo menos 56 núcleos. O número 56 foi escolhido como uma quantidade condicionalmente suficiente, determinando o número de threads que o Elasticsearch irá gerar durante a operação. No Elasticsearch, muitos parâmetros do pool de threads dependem diretamente da quantidade de núcleos disponíveis, o que, por sua vez, impacta diretamente na quantidade necessária de nós no cluster, seguindo o princípio de "menos núcleos — mais nós".
No final, temos uma média de que cada shard pesa cerca de 20 gigabytes, e para 1 índice existem 360 shards. Portanto, se rotacionamos a cada 48 horas, temos 15 no total. Cada índice contém dados de 2 dias.
Esquemas de gravação e leitura de dados
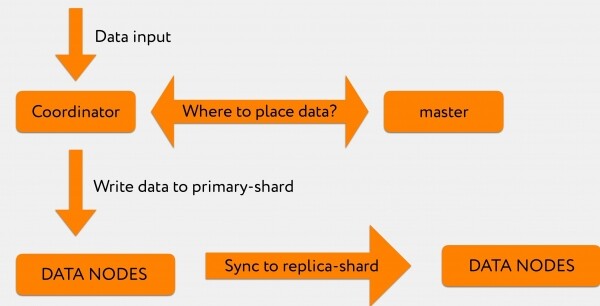
Vamos entender como os dados são gravados neste sistema.
Suponha que temos uma consulta vinda do Graylog para o coordenador. Por exemplo, queremos indexar de 2 a 3 mil linhas.
O Coordenador, ao receber um pedido do Graylog, questiona o mestre: "No pedido de indexação, especificamos claramente o índice, mas não foi indicado em qual shard isso deve ser escrito."
O Mestre responde: "Grave essa informação no shard número 71", após o que ela é enviada diretamente para o nó de dados relevante, onde está o primary-shard número 71.
Depois disso, o log de transações é replicado no replica-shard, que já está em outro data center.
Um pedido de busca chega do Graylog ao coordenador. O coordenador o redireciona pelo índice, enquanto o Elasticsearch distribui os pedidos entre o primary-shard e o replica-shard segundo o princípio round-robin.
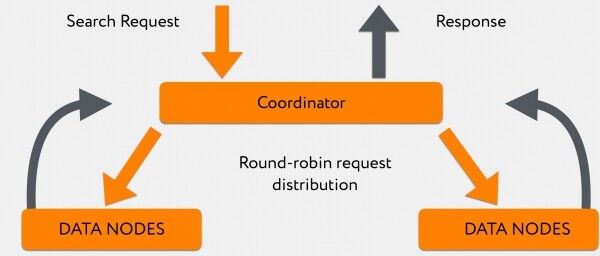
Os 180 nós respondem de forma desigual, e enquanto eles respondem, o coordenador acumula informações que já foram "expelidas" por nós de dados mais rápidos. Após isso, quando todas as informações chegam ou se o tempo limite do pedido é atingido, ele as entrega diretamente ao cliente.
Todo esse sistema, em média, processa os pedidos de busca dos últimos 48 horas em 300-400ms, excluindo os pedidos que usam wildcard à frente.
"FLores" com Elasticsearch: configuração do Java
Para que tudo funcionasse como inicialmente desejávamos, passamos muito tempo ajustando a mais diversas configurações no cluster.
A primeira parte dos problemas descobertos estava relacionada a como o Java é pré-configurado por padrão no Elasticsearch.
Primeiro problema
Observamos um grande número de mensagens indicando que, em nível do Lucene, quando as background jobs estão em execução, as mesclagens de segmentos do Lucene falham. Nos logs, foi visível que o erro era OutOfMemoryError. Pela telemetria, vimos que o heap estava livre, e não estava claro por que essa operação falhava.
Descobrimos que as mesclagens dos índices do Lucene ocorrem fora do heap. E os contêineres têm restrições severas quanto aos recursos consumidos. Esses recursos incluíam apenas o heap (o valor do heap.size era aproximadamente igual à RAM), e algumas operações off-heap falhavam com o erro de alocação de memória, caso por algum motivo não se enquadrassem nos ~500MB restantes até o limite.
A correção foi bastante trivial: aumentamos a quantidade de RAM disponível para o contêiner, após o que esquecemos que tais problemas já existiram.
Segundo problema
Cerca de 4-5 dias após o início do ciclo de vida do cluster, notamos que os nós de dados começavam a cair periodicamente do cluster e a entrar novamente após cerca de 10-20 segundos.
Ao investigarmos, descobrimos que a memória off-heap no Elasticsearch não é controlada de forma alguma. Quando fornecemos mais memória ao contêiner, conseguimos preencher os pools de buffer direto com várias informações, e ela só era limpa após a execução de um GC explícito por parte do Elasticsearch.
Em alguns casos, essa operação demorava bastante, e durante esse tempo o cluster acabava marcando esse nó como já fora do ar. Esse problema está bem descrito .
A solução foi a seguinte: limitamos a capacidade do Java de usar a maior parte da memória fora do heap para essas operações. Limitamos isso a 16 gigabytes (-XX:MaxDirectMemorySize=16g), conseguindo que o GC explícito fosse chamado com muito mais frequência e fosse executado muito mais rápido, evitando assim desestabilizar o cluster.
Terceiro problema
Se você pensa que os problemas com "nós saindo do cluster no momento mais inesperado" acabaram, você está enganado.
Ao configurar o trabalho com índices, escolhemos o mmapfs para em shards novos com alta segmentação. Essa foi uma escolha bastante equivocada, porque ao usar mmapfs o arquivo é mapeado para a memória RAM, e então trabalhamos com o arquivo mapeado. Isso resulta em que, ao tentar o GC parar as threads na aplicação, levamos muito tempo até chegar ao safepoint, e durante esse trajeto a aplicação deixa de responder às consultas do mestre sobre sua continuidade. Consequentemente, o mestre conclui que o nó não está mais presente no cluster. Após cerca de 5-10 segundos, o coletor de lixo é acionado, o nó revive, reentrou no cluster e começa a inicialização dos shards. Tudo isso lembrava muito "a produção que merecemos" e não servia para nada sério.
Para eliminar esse comportamento, primeiramente migramos para o padrão niofs, e depois, ao migrar das versões 5 do Elastic para as versões 6, experimentamos o hybridfs, onde esse problema não se reproduziu. Mais detalhes sobre os tipos de armazenamento podem ser lidos .
Quarto problema
Depois houve um problema muito interessante, que levamos um tempo recorde para resolver. Levamos de 2 a 3 meses para identificá-lo, pois seu padrão era absolutamente incompreensível.
Às vezes, nossos coordenadores entravam em Full GC, geralmente depois do almoço, e não voltavam mais. Ao registrar os atrasos do GC, isso aparecia assim: tudo ia bem, bem, bem, e de repente — tudo ficava muito mal.
No início, pensamos que tínhamos um usuário mal-intencionado que estava executando alguma consulta que tirava o coordenador do modo de operação. Registramos as consultas por muito tempo, tentando descobrir o que estava acontecendo.
No final, descobrimos que, no momento em que algum usuário lançava uma grande consulta e ela chegava a um coordenador específico do Elasticsearch, alguns nós respondiam mais devagar que os outros.
E durante o tempo em que o coordenador espera a resposta de todos os nós, ele acumula os resultados que foram enviados pelos nós que já responderam. Para o GC, isso significa que o padrão de uso do heap muda rapidamente. E o GC que usávamos não conseguia lidar com essa situação.
A única solução que encontramos para alterar o comportamento do cluster nessa situação foi migrar para o JDK13 e usar o coletor de lixo Shenandoah. Isso resolveu o problema, e os coordenadores pararam de falhar.
Com isso, os problemas com Java acabaram e começaram os problemas com a largura de banda.
Os ‘frutos’ do Elasticsearch: largura de banda
Os problemas com a largura de banda significam que nosso cluster opera de forma estável, mas durante picos na quantidade de documentos indexados e em momentos de manobras, o desempenho é insuficiente.
O primeiro sintoma observado: durante alguns ‘explosões’ em produção, quando um grande volume de logs é gerado rapidamente, o Graylog começa a apresentar com frequência o erro de indexação es_rejected_execution.
Isso acontecia porque o thread_pool.write.queue em um dos nós de dados, até que o Elasticsearch conseguisse processar a solicitação de indexação e enviar a informação para o shard no disco, por padrão armazena apenas 200 solicitações na fila. E na há muito pouco mencionado sobre esse parâmetro. Somente é indicado o número máximo de threads e o tamanho padrão.
Claro, fomos ajustar esse valor e descobrimos o seguinte: especificamente na nossa configuração, é possível armazenar com eficiência até 300 solicitações, mas um valor maior coloca a gente de volta no Full GC.
Além disso, como se trata de lotes de mensagens que chegam em uma única solicitação, foi necessário ajustar o Graylog para que ele registrasse não com frequência e em pequenos lotes, mas sim em grandes lotes ou a cada 3 segundos, se o lote ainda não estiver cheio. Dessa forma, a informação que escrevemos no Elasticsearch se torna acessível não em dois segundos, mas em cinco (o que nos satisfaz), mas o número de retrials que precisamos fazer para empurrar um grande lote de informações diminui.
Isso é especialmente importante em momentos em que algo falha e avisa insistentemente sobre isso, para que não tenhamos um Elastic completamente lotado e, após algum tempo, nós tenhamos nós do Graylog não funcionais devido a buffers lotados.
Além disso, quando ocorria essas explosões em produção, recebíamos reclamações de programadores e testadores: no momento em que eles mais precisavam desses logs, eles eram entregues muito lentamente.
Começamos a investigar. Por um lado, estava claro que tanto as consultas de busca quanto as consultas de indexação estavam sendo processadas, essencialmente, nas mesmas máquinas físicas, e, de alguma forma, haveria certas quedas.
Mas isso poderia ser contornado parcialmente, uma vez que nas versões seis do Elasticsearch surgiu um algoritmo que permite distribuir consultas entre nós de dados relevantes não de forma aleatória, round-robin (o container que lida com a indexação e mantém o primary-shard pode estar muito ocupado, não haverá possibilidade de responder rapidamente), mas direcionar essa consulta para um container menos carregado com replica-shard, que responderá significativamente mais rápido. Em outras palavras, chegamos a use_adaptive_replica_selection: true.
A situação de leitura começa a parecer assim:
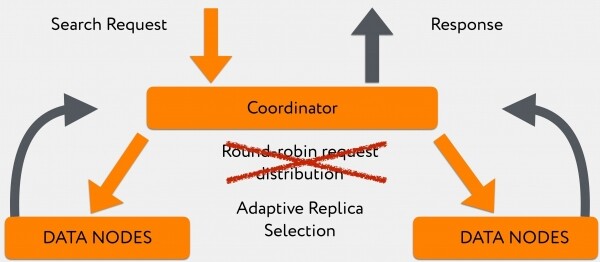
A transição para esse algoritmo melhorou significativamente o tempo de consulta nos momentos em que tínhamos um grande fluxo de logs para escrita.
Finalmente, o principal problema estava em desativar o data center sem dor.
O que desejávamos do cluster imediatamente após a perda de conexão com um DC:
- Se o master atual estiver no data center que falhou, ele será reeleito e mudará como função para outro nó em outro DC.
- O master rapidamente removerá todos os nós inacessíveis do cluster.
- Com base nos shards restantes, ele entenderá: no data center perdido, tivemos esses shards primários, rapidamente promoverá os shards replica complementares nos data centers restantes, e nossa indexação de dados continuará.
- Como resultado, teremos uma degradação suave na largura de banda do cluster para gravação e leitura, porém, de maneira geral, tudo funcionará, ainda que lentamente, mas de forma estável.
Como descobrimos, queríamos algo assim:
E recebemos o seguinte:
Como isso aconteceu?
No momento da queda do data center, o nosso gargalo foi o mestre.
Por quê?
O fato é que no mestre existe um TaskBatcher, responsável pela disseminação de certas tarefas e eventos no cluster. Qualquer saída de nó, qualquer promoção de shard de replica para primário, qualquer tarefa de criação de algum shard — tudo isso vai primeiro para o TaskBatcher, onde é processado de forma sequencial e em um único fluxo.
No momento da saída de um data center, acontecia que todos os data nodes nos data centers sobreviventes achavam que era seu dever informar ao mestre "perdemos esses shards e esses data nodes".
Enquanto isso, os data nodes sobreviventes enviavam todas essas informações para o mestre atual e tentavam aguardar a confirmação de que ele as recebeu. Eles não esperavam, pois o mestre recebia as tarefas mais rapidamente do que conseguia responder. Os nós repetiam as solicitações por tempo limite, enquanto o mestre, nesse meio tempo, já não tentava mais responder a elas, mas estava completamente absorvido pela tarefa de ordenar as solicitações por prioridade.
De uma forma terminal, acontecia que os data nodes spammavam o mestre a tal ponto que ele entrava em full GC. Após isso, o papel de mestre mudava para algum outro nó, com o qual acontecia exatamente a mesma coisa, e, no final, o cluster se desmoronava completamente.
Fizemos medições e até a versão 6.4.0, onde isso foi corrigido, bastava tirar simultaneamente apenas 10 data nodes de 360 para derrubar completamente o cluster.
Ele parecia algo assim:
Após a versão 6.4.0, onde esse bug terrível foi corrigido, os data nodes pararam de derrubar o mestre. Mas ele não se tornou "mais inteligente" por causa disso. Ou seja: quando retiramos 2, 3 ou 10 (qualquer número diferente de um) data nodes, o mestre recebe uma primeira mensagem, que informa que o nó A saiu, e tenta notificar sobre isso o nó B, o nó C, o nó D.
At the moment, the only way to address this issue is by setting a timeout of about 20-30 seconds for attempts to share information and thus manage the speed of removing the data center from the cluster.
In principle, this aligns with the initial requirements set for the end product within the project, but from the perspective of 'pure science,' it is a bug. This bug was successfully fixed by the developers in version 7.2.
Moreover, when a certain data node exited, it turned out that disseminating information about its exit was more important than informing the entire cluster that there were specific primary shards on it (to promote a replica shard in another data center to primary, allowing data writing).
Therefore, once everything has 'calmed down', the exited data nodes are not immediately marked as stale. Consequently, we have to wait for all pings to the exited data nodes to timeout, and only after that does our cluster start informing about the need to continue writing information at various locations. .
As a result, the operation of removing the data center takes us about 5 minutes during peak hours. For such a large and unwieldy system, this is quite a good result.
Ultimately, we arrived at the following solution:
- We have 360 data nodes with disks of 700 gigabytes.
- 60 coordinators for routing traffic across these data nodes.
- 40 masters, which we retained as some heritage from versions prior to 6.4.0 — to survive the removal of the data center, we were mentally prepared to lose a few machines to ensure a quorum of masters even in the worst-case scenario.
- Any attempts to combine roles on a single container faced the issue that, sooner or later, a node would fail under load.
- The entire cluster uses a heap size of 31 gigabytes: all attempts to reduce the size resulted in heavy search queries with leading wildcards either crashing some nodes or triggering the circuit breaker within Elasticsearch.
- Additionally, to maintain search performance, we tried to keep the number of objects in the cluster as minimal as possible to process as few events in the bottleneck we encountered with the master.
Lastly, regarding monitoring
Para que tudo funcione como planejado, monitoramos o seguinte:
- Cada data node comunica ao nosso cloud que ela está ativa e possui estes shards. Quando desligamos algo em algum lugar, o cluster relata em 2-3 segundos que no centro A desligamos os nodes 2, 3 e 4 — isso significa que em outros data centers não podemos desligar os nodes que têm shards únicos.
- Conhecendo o comportamento do master, observamos atentamente a quantidade de tarefas pendentes. Porque até mesmo uma única tarefa pendente, se não for timeout a tempo, pode teoricamente, em uma situação de emergência, ser a causa pela qual não conseguimos fazer, por exemplo, a promoção de um shard replica para primary, o que afetaria a indexação.
- Além disso, observamos de perto os atrasos do garbage collector, pois já tivemos grandes dificuldades com isso durante a otimização.
- Rejeições por threads, para entender antecipadamente onde está o "gargalo".
- E as métricas padrão, como heap, RAM e I/O.
Ao construir a monitorização, é imprescindível considerar as particularidades do Thread Pool no Elasticsearch. descreve as capacidades de configuração e os valores padrão para busca, indexação, mas omite completamente o thread_pool.management. Esses threads processam, em particular, solicitações do tipo _cat/shards e outras semelhantes, que são convenientes para escrever monitoramento. Quanto maior o cluster, mais tais solicitações são executadas em um único momento, e o thread_pool.management mencionado não só não é apresentado na documentação oficial, como ainda é limitado a 5 threads por padrão, o que se esgota rapidamente, após o que a monitorização deixa de funcionar corretamente.
O que gostaria de dizer em conclusão: conseguimos! Conseguimos fornecer aos nossos programadores e desenvolvedores uma ferramenta que, em praticamente qualquer situação, pode rapidamente e com precisão fornecer informações sobre o que está acontecendo na produção.
Sim, isso se tornou bastante complexo, mas, ainda assim, conseguimos encaixar nossas necessidades em produtos existentes, que não precisaram ser patchados ou reescritos para atendê-los.
Fonte: habr.com
