

Este artigo descreve a implementação de pipelines no núcleo do Unix. Fiquei um pouco decepcionado ao descobrir que um artigo recente intitulado "“ resultou ser não sobre a estrutura interna. Fiquei curioso e consultei fontes antigas para encontrar uma resposta.
Do que se trata?
Os pipelines — "provavelmente, a invenção mais importante do Unix" — são uma característica definidora que está na base da filosofia Unix de unir pequenos programas, além da conhecida notação no terminal:
$ echo hello | wc -c
6
Essa funcionalidade depende da chamada de sistema fornecida pelo núcleo pipe, que é descrita nas páginas da documentação e :
Os pipelines fornecem um canal unidirecional de comunicação entre processos. Um pipeline tem uma entrada (write end) e uma saída (read end). Os dados gravados na entrada do pipeline podem ser lidos na saída.
Um pipeline é criado com a chamada
pipe(2), que retorna dois descritores de arquivos: um se refere à entrada do pipeline e o outro à saída.
Os resultados do rastreamento do comando acima demonstram a criação de um pipeline e o fluxo de dados através dele de um processo para outro:
$ strace -qf -e execve,pipe,dup2,read,write
    sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4])                            = 0
[pid 2604795] dup2(4, 1)                = 1
[pid 2604795] write(1, "hellon", 6)    = 6
[pid 2604796] dup2(3, 0)                = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2)        = 2
O processo pai chama pipe(), para obter os descritores de arquivos conectados. Um processo filho grava em um descritor, enquanto o outro processo lê os mesmos dados de outro descritor. O shell, através de dup2, "renomeia" os descritores 3 e 4 para que correspondam a stdin e stdout.
Sem os pipelines, o shell teria que gravar o resultado de um processo em um arquivo e passá-lo para outro processo, para que este lesse os dados do arquivo. Como resultado, gastaríamos mais recursos e espaço em disco. No entanto, os pipelines são bons não apenas por evitarem o uso de arquivos temporários:
Se um processo tentar ler de um pipeline vazio, então
read(2)bloqueará até que os dados estejam disponíveis. Se um processo tentar gravar em um pipeline cheio, entãowrite(2)irá bloquear até que dados suficientes sejam lidos do pipeline para realizar a gravação.
Assim como a exigência POSIX, esta é uma característica importante: a gravação no pipeline até PIPE_BUF bytes (no mínimo 512) deve ser atômica, para que os processos possam interagir uns com os outros através do pipeline de uma maneira que arquivos normais (que não oferecem tais garantias) não conseguem.
Ao usar um arquivo normal, o processo pode escrever toda a sua saída e passá-la para outro processo. Ou os processos podem atuar em um modo de paralelismo rígido, usando um mecanismo de sinalização externo (como um semáforo) para informar uns aos outros sobre a conclusão da gravação ou leitura. Os pipelines nos livram de toda essa complicação.
O que estamos procurando?
Vou explicar de maneira simples, para que você possa visualizar como um pipeline pode funcionar. Você precisará alocar na memória um buffer e algum estado. Precisará de funções para adicionar e remover dados do buffer. Você precisará de algum meio para chamar funções durante as operações de leitura e gravação em descritores de arquivos. E precisará de locks para implementar o comportamento especial descrito acima.
Agora estamos prontos para interrogar sob a luz intensa das lâmpadas o código-fonte do núcleo, para confirmar ou refutar nosso vago modelo mental. Mas sempre esteja preparado para surpresas.
Onde estamos procurando?
Não sei onde está meu exemplar do famoso livro “” com o código-fonte do Unix 6, mas graças a podemos procurar online em de versões ainda mais antigas do Unix.
Navegar pelos arquivos da TUHS é como visitar um museu. Podemos olhar para nossa história compartilhada, e eu sinto um respeito pelas longas tentativas de recuperar todo esse material, bit a bit, de velhas fitas e impressões. E eu sou agudamente consciente dos fragmentos que ainda estão ausentes.
Saciando minha curiosidade sobre a antiga história dos pipelines, podemos comparar com os núcleos modernos.
A propósito, pipe é a chamada de sistema número 42 na tabela sysent[]. Coincidência?
Os núcleos tradicionais do Unix (1970–1974)
Não encontrei nenhum vestígio pipe(2) nem em (janeiro de 1970), nem na (novembro de 1971), nem no código-fonte incompleto (junho de 1972).
A TUHS afirma que (fevereiro de 1973) foi a primeira versão com pipes:
A terceira edição do Unix foi a última versão com um núcleo escrito em assembler, mas, ao mesmo tempo, a primeira versão com pipes. Durante 1973, foram feitos esforços para melhorar a terceira edição, reescrevendo o núcleo em C, resultando na quarta edição do Unix.
Um dos leitores encontrou uma digitalização do documento em que Doug McIlroy propôs a ideia de 'conectar programas de forma semelhante a uma mangueira de jardim'.
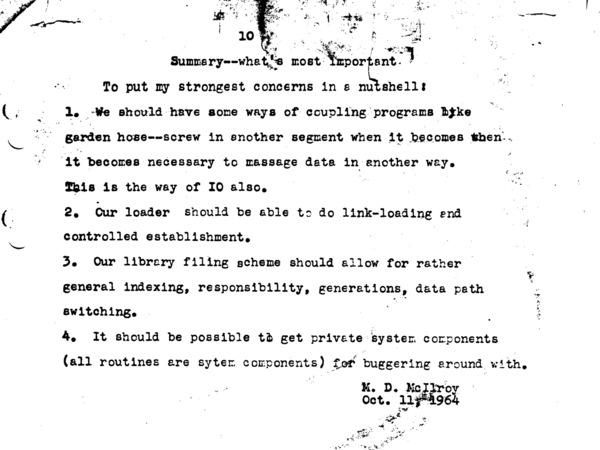
No livro de Brian Kernighan, "", a história do surgimento dos pipes também menciona esse documento: '... ele ficou pendurado na parede do meu escritório nos Bell Labs por 30 anos'. Aqui está , e mais uma história do :
Quando o Unix apareceu, minha paixão por corrotinas me levou a pedir ao criador do SO, Ken Thompson, que permitisse que os dados gravados em um processo fossem direcionados não apenas para o dispositivo, mas também para a saída de outro processo. Ken decidiu que isso era possível. No entanto, como minimalista, ele queria que cada função do sistema desempenhasse um papel significativo. Será que a gravação direta entre processos realmente tem uma grande vantagem em comparação com a gravação em um arquivo intermediário? E só quando eu apresentei uma proposta concreta com o título chamativo de 'pipe' e uma descrição da sintaxe de interação entre processos, Ken finalmente exclamou: 'Eu farei isso!'.
E ele fez. Em uma noite fatídica, Ken alterou o núcleo e o shell, corrigiu alguns programas padrão, padronizando seu processo de aceitação de entrada (que podia vir de pipes), além de mudar os nomes dos arquivos. No dia seguinte, pipes começaram a ser amplamente utilizados em aplicativos. No final da semana, secretárias já estavam enviando documentos de editores de texto para a impressora usando-os. Um pouco depois, Ken substituiu a API original e a sintaxe para o uso de pipes por convenções mais limpas que são utilizadas desde então.
Infelizmente, o código fonte do núcleo da terceira edição do Unix está perdido. E embora tenhamos o código fonte do núcleo escrito em C da , que foi lançada em novembro de 1973, ela saiu meses antes do lançamento oficial e não contém a implementação de pipes. É uma pena que o código fonte da lendária função do Unix esteja perdido, talvez para sempre.
Temos o texto da documentação sobre pipe(2) de ambas as versões, então podemos começar a busca na documentação (por palavras específicas, destacadas "manualmente", uma linha de literais ^H, após a qual vem um sublinhado!). Este proto-pipe(2) está escrito em assembler e retorna apenas um descritor de arquivo, mas já fornece a funcionalidade básica esperada:
A chamada de sistema pipe cria um mecanismo de entrada e saída chamado pipeline. O descritor de arquivo retornado pode ser usado para operações de leitura e gravação. Quando algo é gravado no pipeline, é armazenado em buffer até 504 bytes de dados, após o que o processo de gravação é suspenso. Ao ler do pipeline, os dados buffered são retirados.
No ano seguinte, o núcleo foi reescrito em C, e adquiriu sua forma moderna com o protótipo "pipe(fildes)»:
A chamada de sistema pipe cria um mecanismo de entrada e saída chamado pipeline. Os descritores de arquivo retornados podem ser usados em operações de leitura e gravação. Quando algo é gravado no pipeline, é utilizado o descritor retornado em r1 (correspondente a fildes[1]), que é armazenado em buffer até 4096 bytes de dados, após o que o processo de gravação é suspenso. Ao ler do pipeline, o descritor retornado em r0 (correspondente a fildes[0]) retira os dados.
Presume-se que, após a definição do pipeline, dois (ou mais) processos interagentes (criados por chamadas subsequentes de fork) irão transmitir dados do pipeline usando chamadas de write e exit.
Na shell, existe uma sintaxe para definir um array linear de processos conectados por meio de pipeline.
Chamadas para leitura de um pipeline vazio (que não contém dados buffered), que tem apenas uma extremidade (todos os descritores de arquivo de gravação estão fechados), retornam "fim de arquivo". Chamadas para gravação em uma situação semelhante são ignoradas.
A mais antiga remonta (junho de 1974), mas é quase idêntica àquela que apareceu na versão seguinte. Apenas foram adicionados comentários, portanto a quinta edição pode ser ignorada.
A sexta edição do Unix (1975)
Começamos a ler o código-fonte do Unix (maio de 1975). Em grande parte devido a Lions é muito mais fácil encontrá-lo do que o código-fonte de versões anteriores:
Muitos anos, o livro Lions era o único documento sobre o núcleo do Unix disponível fora dos muros da Bell Labs. Embora a licença da sexta edição permitisse que professores usassem seu código-fonte, a licença da sétima edição excluiu essa possibilidade, portanto, o livro foi distribuído em cópias datilografadas ilegais.
Hoje, é possível comprar uma cópia reimpressa do livro, cuja capa apresenta estudantes junto a uma fotocopiadora. E graças a Warren Toomey (que lançou o projeto TUHS), você pode baixar . Quero dar a você uma ideia de quanto trabalho foi necessário para criar esse arquivo:
Mais de 15 anos atrás, eu transcrevi uma cópia do código-fonte apresentada em Lions, porque não gostava da qualidade da minha cópia, que vinha de um número desconhecido de outras cópias. O TUHS ainda não existia, e eu não tinha acesso a fontes antigas. Mas em 1988, encontrei uma fita antiga de 9 trilhas, que tinha um backup do computador PDP11. Era difícil saber se funcionava, mas havia uma estrutura intacta em /usr/src/, na qual a maioria dos arquivos estava datada de 1979, o que já parecia uma antiguidade na época. Era a sétima edição ou alguma de suas variantes PWB, como eu acreditava.
Usei essa descoberta como base e editei manualmente os fontes até o estado da sexta edição. Parte do código permaneceu a mesma, enquanto outra parte precisou ser ligeiramente ajustada, trocando o token moderno += pelo obsoleto =+. Alguma coisa foi simplesmente removida, e outras precisaram ser reescritas completamente, mas não em excesso.
E hoje podemos ler online no TUHS o código-fonte da sexta edição do .
Por sinal, à primeira vista, a principal característica do código C antes da era de Kernighan e Ritchie é sua concisão. Não é tão comum eu conseguir inserir trechos de código sem amplas edições para que se ajustem a uma área de exibição relativamente estreita no meu site.
No início há um comentário explicativo (e sim, há mais ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
O tamanho do buffer não mudou desde a quarta edição. Mas aqui, sem qualquer documentação pública, vemos que em algum momento os pipelines usavam arquivos como armazenamento backup!
Quanto aos arquivos LARG, eles correspondem ao , que é usado pelo "algoritmo de endereçamento grande" para tratamento com o objetivo de suportar sistemas de arquivos maiores. Uma vez que Ken disse que não é melhor usá-los, eu fico feliz em acreditar nele.
Aqui está uma chamada de sistema real pipe:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
O comentário descreve claramente o que está acontecendo aqui. No entanto, entender o código não é tão simples, em parte devido ao uso de "" e dos registradores R0 e R1 que transmitem parâmetros de chamadas de sistema e valores retornados.
Vamos tentar usar para alocar no disco , e com — alocar na memória dois . Se tudo correr bem, então definiremos as flags para identificar esses arquivos como as duas extremidades de um pipeline, os indicaremos no mesmo inode (cujo contador de referências se tornará igual a 2), e marcaremos o inode como alterado e em uso. Note que há chamadas a em caminhos de erro para reduzir o contador de referências no novo inode.
pipe() deve retornar R0 e R1 números de descritores de arquivos para leitura e gravação. falloc() retorna um ponteiro para a estrutura do arquivo, mas também "retorna" por meio de u.u_ar0[R0] e o descritor de arquivo. Ou seja, o código salva em r descritor de arquivo para leitura e atribui o descritor para gravação diretamente de u.u_ar0[R0] após a segunda chamada falloc().
A bandeira FPIPE, que definimos ao criar o pipeline, controla o comportamento da função , chamando subprogramas específicos de entrada e saída I/O:
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
Então, a função readp() em pipe.c lê dados do pipeline. Mas é melhor rastrear a implementação começando com writep(). Reitero, o código complicou-se devido às particularidades do acordo sobre a passagem de argumentos, mas algumas informações podem ser deixadas de lado.
writep(fp)
{
    register *rp, *ip, c;

    rp = fp;
    ip = rp->f_inode;
    c = u.u_count;

loop:
    /* Se tudo estiver feito, retorne. */

    plock(ip);
    if(c == 0) {
        prele(ip);
        u.u_count = 0;
        return;
    }

    /*
     * Se não houver lados de leitura e gravação do
     * pipeline ativos, retorne erro e sinalize também.
     * */

    if(ip->i_count i_size1 == PIPSIZ) {
        ip->i_mode |= IWRITE;
        prele(ip);
        sleep(ip+1, PPIPE);
        goto loop;
    }

    /* Escreva o que for possível e volte ao loop. */

    u.u_offset[0] = 0;
    u.u_offset[1] = ip->i_size1;
    u.u_count = min(c, PIPSIZ-u.u_offset[1]);
    c =- u.u_count;
    writei(ip);
    prele(ip);
    if(ip->i_mode & IREAD) {
        ip->i_mode &= ~IREAD;
        wakeup(ip+2);
    }
    goto loop;
}
Queremos escrever bytes na entrada do pipeline u.u_count. Primeiro, precisamos bloquear o descritor de índice (ver abaixo plock/prele).
Em seguida, verificamos o contador de links inode. Enquanto ambas as extremidades do pipeline permanecerem abertas, o contador deve ser igual a 2. Mantemos um link (de rp->f_inode), então, se o contador for menor que 2, isso deve significar que o processo de leitura fechou sua extremidade do pipeline. Em outras palavras, estamos tentando escrever em um pipeline fechado, o que é um erro. O código de erro pela primeira vez EPIPE e o sinal SIGPIPE apareceram na sexta edição do Unix.
Mas mesmo que o pipeline esteja aberto, ele pode estar cheio. Nesse caso, removemos o bloqueio e vamos dormir esperando que outro processo leia do pipeline e libere espaço suficiente nele. Ao acordar, voltamos ao início, novamente removemos o bloqueio e iniciamos um novo ciclo de gravação.
Se houver espaço livre suficiente no pipeline, gravamos os dados nele usando . Parâmetro i_size1 do inode (quando o pipeline está vazio, pode ser igual a 0) indica o fim dos dados que já estão contidos nele. Se houver espaço suficiente para gravação, podemos encher o pipeline de i_size1 até PIPESIZ. Em seguida, removemos o bloqueio e tentamos despertar qualquer processo que esteja esperando para ler do pipeline. Voltamos ao início para verificar se conseguimos gravar a quantidade de bytes que precisávamos. Se não conseguimos, iniciamos um novo ciclo de gravação.
Geralmente, o parâmetro i_mode do inode é usado para armazenar permissões. r, w e xMas no caso dos pipelines, sinalizamos a espera de algum processo de gravação ou leitura usando os bits IREAD e IWRITE respectivamente. O processo define um sinalizador e chama sleep(), e espera-se que, no futuro, algum outro processo chame wakeup().
A verdadeira mágica acontece em sleep() e wakeup(). Eles estão implementados em , fonte do famoso comentário 'Você não é obrigado a entender isso' (You are not expected to understand this). Felizmente, não precisamos entender o código, apenas olharemos alguns comentários:
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
O processo que chama sleep() para um determinado canal pode ser mais tarde despertado por outro processo que chamar wakeup() para o mesmo canal. writep() e readp() Coordenam suas ações por meio de tais chamadas em pares. Observe que pipe.c sempre dá prioridade a PPIPE na chamada sleep(), portanto, todos sleep() podem ser interrompidos por sinal.
Agora temos tudo para entender a função readp():
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Bloqueio muito conservador. */

    plock(ip);

    /*
     * Se a cabeça (leitura) alcançou
     * a cauda (gravação), redefina ambos para 0.
     * /

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode &= ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * Se não houver leitores e
         * escritores ativos, retorne sem
         * satisfazer a leitura.
         * /

        prele(ip);
        if(ip->i_count i_mode |= IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Ler e retornar */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Pode ser mais fácil ler esta função de baixo para cima. O ramo "ler e retornar" é normalmente usado quando existem dados no pipeline. Neste caso, usamos para ler tantos dados quanto disponíveis a partir da posição atual f_offset de leitura, e depois atualizamos o valor do deslocamento correspondente.
Na leitura subsequente, o pipeline estará vazio se o deslocamento de leitura atingir o valor i_size1 do inode. Redefinimos a posição para 0 e tentamos despertar qualquer processo que deseje gravar no pipeline. Sabemos que, quando o pipeline estiver cheio, writep() dormirá em ip+1. E agora, quando o pipeline estiver vazio, podemos despertá-lo para retomar seu ciclo de gravação.
Se não houver nada para ler, então readp() pode definir uma flag IREAD e dormir em ip+2. Sabemos que será despertado writep(), quando gravar algum dado no pipeline.
Comentários sobre ajudarão a entender que, em vez de passar parâmetros através de "u", podemos tratá-los como funções normais de entrada/saída que recebem arquivo, posição, buffer na memória e contam o número de bytes para leitura ou gravação.
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
No que diz respeito ao bloqueio "conservador", readp() e writep() bloqueia o inode até que termine o trabalho ou receba o resultado (ou seja, chama wakeup). plock() e prele() funcionam simplesmente: com um conjunto diferente de chamadas dormir e wakeup nos permitem despertar qualquer processo que precise do bloqueio que acabamos de liberar:
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
No início, eu não conseguia entender por que readp() não chamava prele(ip) até chamar wakeup(ip+1). O primeiro queé chamado em seu ciclo é writep() plock(ip), que leva a um impasse, seainda não liberou seu bloqueio, portanto o código deve funcionar corretamente de alguma forma. Se olharmos para readp() ainda não desativei meu bloco, então o código de alguma forma deve funcionar corretamente. Se olharmos para wakeup(), fica claro que ele apenas marca o processo adormecido como pronto para execução, para o futuro sched() realmente o iniciou. Então readp() causa wakeup(), remove o bloqueio, define IREAD e chama sleep(ip+2)— tudo isso antes de writep() retomar o ciclo.
Com isso, a descrição dos pipes na sexta edição se encerra. Código simples, consequências profundas.
(janeiro de 1979) foi um novo lançamento principal (quatro anos depois), que trouxe muitos novos aplicativos e características do núcleo. Também houve mudanças significativas em relação ao uso de castings de tipo, unions e ponteiros tipados para estruturas. No entanto, praticamente não mudou. Podemos pular esta edição.
Xv6, um núcleo estilo Unix simples
A criação do núcleo foi influenciada pela sexta edição do Unix, porém é escrito em C moderno, para que possa ser executado em processadores x86. O código é fácil de ler, é compreensível. Além disso, ao contrário dos fontes do Unix com TUHS, você pode compilá-lo, modificá-lo e executá-lo em algo além do PDP 11/70. Por isso, esse núcleo é amplamente utilizado nas universidades como material didático em sistemas operacionais. Os fontes .
O código contém uma implementação clara e bem pensada , apoiada por um buffer na memória em vez de inode no disco. Aqui eu apresento apenas a definição de "pipe estrutural" e a função pipealloc():
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
pipealloc() define o estado de toda a implementação restante, que inclui as funções piperead(), pipewrite() e pipeclose(). A chamada de sistema real sys_pipe é uma camada, implementada em . Recomendo ler todo o seu código. A complexidade é no nível do código-fonte da sexta edição, mas é muito mais fácil e agradável de ler.
Linux 0.01
Você pode encontrar o código-fonte do Linux 0.01. Será instrutivo estudar a implementação dos pipes nele. fs/pipe.c. Aqui, para representação do pipe, um inode é usado, mas o próprio pipe é escrito em C moderno. Se você conseguiu passar pelo código da sexta edição, aqui você não terá dificuldades. Assim é a função write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* sem leitores */
        current->signal |= (1< 0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE( PIPE_HEAD(*inode) );
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
Mesmo sem olhar as definições das estruturas, é possível entender como o contador de referências do inode é usado para verificar se a operação de gravação resulta em SIGPIPE. Além do trabalho byte a byte, essa função é facilmente comparável às ideias acima descritas. Mesmo a lógica sleep_on/wake_up não parece tão estranha.
Núcleos modernos do Linux, FreeBSD, NetBSD, OpenBSD
Rapidamente revisitei alguns núcleos modernos. Nenhum deles ainda possui uma implementação baseada em disco (não é surpreendente). O Linux tem sua própria implementação. E embora os três núcleos modernos do BSD contenham implementações baseadas em código que foi escrito por John Dyson, ao longo dos anos eles se tornaram muito diferentes entre si.
Para ler fs/pipe.c (no Linux) ou sys/kern/sys_pipe.c (no *BSD), é necessária uma verdadeira dedicação. Hoje em dia, no código, o desempenho e o suporte a funcionalidades como operações de entrada e saída vetoriais e assíncronas são importantes. E os detalhes da alocação de memória, bloqueios e configurações do núcleo variam bastante. Isso não é algo que as universidades precisem para um curso introdutório sobre sistemas operacionais.
De qualquer forma, fiquei curioso em desenterrar alguns padrões antigos (como a geração SIGPIPE e retorno EPIPE ao gravar em um pipe fechado) em todos esses núcleos modernos tão diferentes. Provavelmente, nunca verei um computador PDP-11 ao vivo, mas ainda há muito o que aprender com o código que foi escrito anos antes de meu nascimento.
O artigo escrito por Divy Kapoor em 2011, "", é uma visão geral de como os pipes (ainda) funcionam no Linux. E ilustra o modelo de interação do pipe, cujas capacidades superam as de arquivos temporários; e mostra o quão longe os pipes se afastaram do "bloqueio muito conservador" no núcleo do Unix da sexta edição.
Fonte: habr.com
