

Bom dia, nos artigos anteriores, nós nos familiarizamos com o funcionamento do ELK Stack. Agora, vamos discutir as possibilidades que um especialista em segurança da informação pode implementar ao usar esses sistemas. Quais logs podem e devem ser armazenados no Elasticsearch? Vamos analisar quais estatísticas podem ser obtidas ao configurar painéis e se isso traz benefícios. Como podemos implementar a automação de processos de segurança da informação usando o stack ELK. Vamos compor a arquitetura de funcionamento do sistema. No total, a implementação de todas essas funcionalidades é uma tarefa bastante complexa, por isso, decidimos dar um nome diferente a essa solução: TS Total Sight.
Atualmente, soluções que consolidam e analisam incidentes de segurança da informação em um único local lógico estão se tornando cada vez mais populares, resultando em estatísticas e uma lista de ações para melhorar o estado da segurança da informação na organização. Essa é a meta que estabelecemos ao utilizar o stack ELK, dividindo suas funcionalidades principais em quatro seções:
- Estatísticas e visualização;
- Detecção de incidentes de segurança da informação;
- Priorização de incidentes;
- Automação de processos de segurança da informação.
A seguir, iremos examinar cada um deles em mais detalhes.
Detecção de incidentes de segurança da informação
A principal tarefa ao usar o Elasticsearch neste caso é coletar apenas incidentes de segurança da informação. Os incidentes de segurança podem ser coletados a partir de quaisquer meios de proteção, desde que suportem algum tipo de envio de logs, sendo o padrão o syslog ou o armazenamento em arquivo via scp.
Podemos mencionar exemplos padrão de ferramentas de proteção e não apenas, de onde devemos configurar o envio de logs:
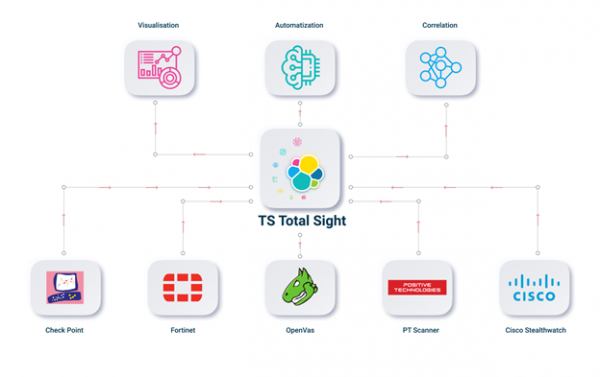
- Qualquer solução NGFW (Check Point, Fortinet);
- Qualquer scanner de vulnerabilidades (PT Scanner, OpenVas);
- Firewalls de Aplicação Web (PT AF);
- Analisadores de Netflow (Flowmon, Cisco StealthWatch);
- Servidor AD.
Após configurar o envio de logs e os arquivos de configuração no Logstash, é possível correlacionar e comparar os incidentes recebidos de diferentes meios de segurança. Para isso, é conveniente usar índices, onde armazenaremos todos os incidentes relacionados a um dispositivo específico. Em outras palavras, um índice contém todos os incidentes de um único dispositivo. Essa distribuição pode ser realizada de duas maneiras.
A primeira opção é configurar o log do Logstash. Para isso, é necessário duplicar o log por determinados campos em uma única unidade com um tipo diferente. Depois, use esse tipo posteriormente. No exemplo, os logs do blade IPS do firewall Check Point são clonados.
filter {
    if [product] == "SmartDefense" {
        clone {
	    clones => ["CloneSmartDefense"]
	    add_field => {"system" => "checkpoint"}
	}
    }
}
Para salvar em um índice separado esses eventos dependendo dos campos dos logs, como por exemplo o Destination IP da assinatura de ataque, pode-se usar a seguinte construção:
output {
    if [type] == "CloneSmartDefense"{
    {
         elasticsearch {
    	 hosts => [",:9200"]
    	 index => "smartdefense-%{dst}"
    	 user => "admin"
    	 password => "password"
  	 }
    }
}
E assim é possível salvar no índice todos os incidentes, por exemplo, pelo endereço IP ou pelo nome de domínio da máquina. Neste caso, salvamos no índice «smartdefense-%{dst}», pelo endereço IP do valor da assinatura.
No entanto, diferentes produtos terão campos diferentes para logs, o que resultará em caos e uso excessivo de memória. E aqui será necessário ou substituir cuidadosamente os campos nas configurações do Logstash por aqueles que serão idênticos para todos os tipos de incidentes, o que também é uma tarefa complexa.
A segunda opção de implementação — é escrever um script ou processo que acessará em tempo real o banco de dados Elasticsearch, buscará os incidentes necessários e os salvará em um novo índice, o que é uma tarefa difícil, mas permite trabalhar com logs conforme desejado e correlacionar diretamente com incidentes de outras ferramentas de segurança. Essa opção permite configurar o trabalho com logs da maneira mais útil para seu caso com máxima flexibilidade, mas surge o problema de encontrar um especialista que possa realizá-lo.
E, claro, a pergunta mais importante, o que realmente pode ser correlacionado e descoberto?
Aqui podem haver várias opções, e isso depende das ferramentas de segurança utilizadas em sua infraestrutura, alguns exemplos:
- A opção mais óbvia e, na minha perspectiva, a mais interessante para aqueles que possuem uma solução de NGFW e um scanner de vulnerabilidades. Isso envolve a comparação de logs do IPS e os resultados da varredura de vulnerabilidades. Se um ataque foi detectado (não bloqueado) pelo sistema IPS, e essa vulnerabilidade não foi corrigida na máquina final a partir dos resultados da varredura — é necessário soar todas as campainhas, pois há uma grande probabilidade de que a vulnerabilidade tenha sido explorada.
- Muitas tentativas de login de uma única máquina em lugares diferentes podem simbolizar atividade maliciosa.
- Download de arquivos maliciosos por parte do usuário devido à visita a uma grande quantidade de sites potencialmente perigosos.
Estatísticas e visualização
A coisa mais óbvia e compreensível para a qual o ELK Stack é utilizado — é o armazenamento e a visualização de logs, foi mostrado como é possível coletar logs de diversos dispositivos usando o Logstash. Após os logs serem enviados para o Elasticsearch, é possível configurar dashboards, que também foram mencionados , com as informações e estatísticas necessárias para você por meio da visualização.
Exemplos:
- Dashboard de eventos de Prevenção de Ameaças com os eventos mais críticos. Aqui é possível refletir quais assinaturas de IPS foram detectadas e de onde, territorialmente, elas se originaram.
- Dashboard sobre o uso das aplicações mais críticas, onde informações podem ser vazadas.
- Resultados de varredura de qualquer scanner de segurança.
- Logs do Active Directory por usuários.
- Dashboard sobre conexões VPN.
Neste caso, se os dashboards forem configurados para atualização a cada poucos segundos, é possível obter um sistema bastante conveniente para monitoramento de eventos em tempo real, que pode ser utilizado para respostas mais rápidas a incidentes de segurança da informação, se os dashboards forem apresentados em uma tela separada.
Priorização de incidentes
Em uma grande infraestrutura, o número de incidentes pode ser exorbitante, e os especialistas não conseguem lidar com todos os incidentes a tempo. Neste caso, é necessário priorizar apenas aqueles incidentes que representam uma ameaça significativa. Portanto, o sistema deve classificar os incidentes de acordo com seu nível de perigo para a sua infraestrutura. É recomendável configurar alertas por e-mail ou Telegram para esses eventos. A priorização pode ser realizada com as ferramentas padrão do Kibana, por meio da configuração de visualização. A configuração de alertas é mais complexa; por padrão, essa funcionalidade não está incluída na versão básica do Elasticsearch, apenas na versão paga. Portanto, você deve optar por adquirir a versão paga ou, novamente, desenvolver um processo que notifique os especialistas em tempo real por e-mail ou Telegram.
Automatização de processos de segurança da informação
E uma das partes mais interessantes é a automatização de ações em incidentes de segurança da informação. Anteriormente, implementamos essa funcionalidade para o Splunk; você pode ler mais sobre isso aqui. . A ideia principal é que a política de IPS nunca é verificada ou otimizadas, embora em alguns casos seja a parte mais crucial dos processos de segurança da informação. Por exemplo, um ano após a implementação do NGFW e na ausência de ações de otimização do IPS, você acumulará um grande número de assinaturas com a ação Detect, que não serão bloqueadas, o que diminui significativamente o estado de Segurança da Informação na organização. A seguir, alguns exemplos do que pode ser automatizado:
- Mudança da assinatura IPS de Detect para Prevent. Se não houver Prevent para assinaturas críticas, isso é um problema e uma séria falha no sistema de proteção. Alteramos a ação na política para essas assinaturas. Essa funcionalidade pode ser implementada se o dispositivo NGFW possuir a funcionalidade REST API. Isso é possível apenas com habilidades de programação; é necessário extrair as informações necessárias do Elasticsearch e fazer requisições API para o servidor de gerenciamento do NGFW.
- Se um IP na rede detectar ou bloquear um grande número de assinaturas, faz sentido bloquear temporariamente esse endereço IP na política de Firewall. A implementação também envolve o uso de REST API.
- Executar uma verificação de host com um scanner de vulnerabilidades, se houver um grande número de assinaturas no IPS ou em outros meios de segurança. No caso do OpenVas, você pode escrever um script que se conecte via SSH ao scanner de segurança e inicie a varredura.
TS Total Sight
A implementação de toda a funcionalidade é uma tarefa muito grande e pesada. Sem habilidades de programação, é possível configurar uma funcionalidade mínima, que pode ser suficiente para uso em produção. Mas se você está interessado em toda a funcionalidade, pode considerar o TS Total Sight. Você pode saber mais em nosso . Como resultado, todo o esquema de trabalho e a arquitetura parecerão assim:
Conclusão
Examinamos o que pode ser implementado usando o ELK Stack. Em artigos subsequentes, analisaremos mais detalhadamente a funcionalidade do TS Total Sight!
Então fiquem de olho nas atualizações (, , , ), .
Fonte: habr.com
